原始論文
STaR: Bootstrapping Reasoning With Reasoning
- 發表版本
- NeurIPS 2022會議
- arXiv 首次提交
- arXiv:2203.14465
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{modeltuningstar2022,
  title = {{STaR: Bootstrapping Reasoning With Reasoning}},
  author = {Eric Zelikman and Yuhuai Wu and Jesse Mu and Noah D. Goodman},
  year = {2022},
  eprint = {2203.14465},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2203.14465}
}
先寫推理再給答案,模型會答得比較好,這件事在 2022 年初已經有不少證據。問題是,要怎麼讓模型學會寫推理?
當時有兩條路。一條是準備一大批附推理過程的訓練資料,拿去微調。這需要人一題一題寫,例如 CommonsenseQA 的人工解釋資料集 CoS-E;或者用模板自動產生,但只有解法已知、能寫成規則的題目才行。
另一條是思維鏈提示,在提示裡放幾個附推理的範例,不用訓練。這很便宜,但效果通常比不上用大量資料直接訓練「只輸出答案」的模型。以這篇用的 GPT-J 6B 為例,CommonsenseQA 上少樣本思維鏈只有 36.6%,直接微調輸出答案則是 60.0%。
Stanford 的 Zelikman 等人想走中間的路。只準備十來個附推理的範例,加上一大批只有答案、沒有推理的題目,讓模型自己寫推理給自己學。
定義問題
手上有一個預訓練模型 、一個只有題目和答案的資料集 ,以及一小組附推理的範例 ,大約 10 個。
目標是訓練出一個先寫推理 、再寫答案 的模型,而且要比只輸出答案的模型更準。
整個方法都假設,能推出正確答案的推理,品質比推出錯誤答案的推理好。這個假設不見得每次都對,後面會再談。
解決問題
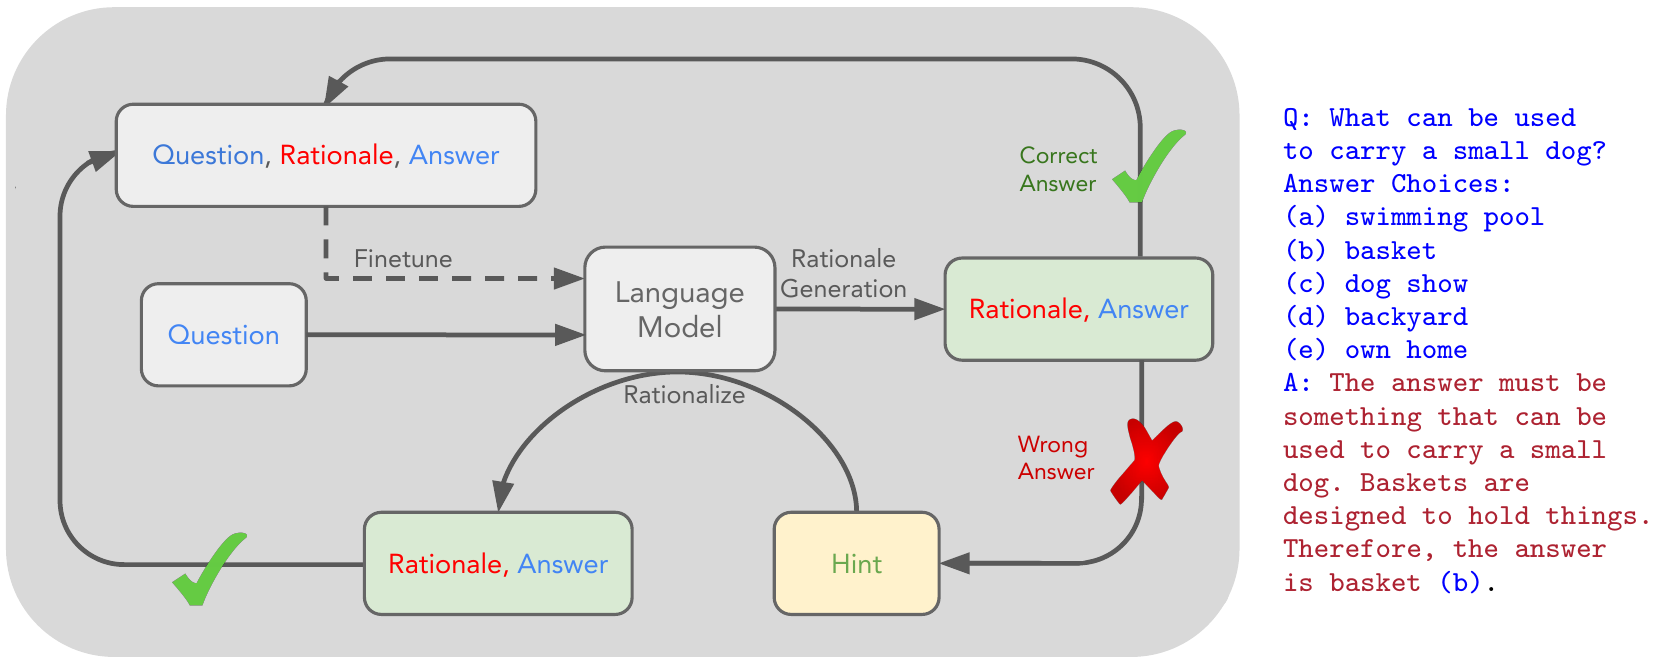
自己寫推理,只留答對的
第一步很直接。把那十來個範例當提示,請模型對資料集裡的每一題寫出推理和答案。答案和標準答案相同的,連同推理留下;答錯的丟掉。
接著用留下的資料微調模型,再用微調後的模型重新對所有題目寫一遍,篩選、微調,一直重複到成績不再進步。
每一輪都從原本的預訓練模型 開始微調,而不是接著上一輪的模型繼續訓練,避免過擬合。第一輪只訓練 40 步,之後每輪增加 20%,作者發現一開始訓練得慢一點,最後的成績比較好。
做不出來的題目,給它看答案
只留答對的題目,有一個明顯的問題。模型做不出來的題目永遠進不了訓練資料,等它把會做的都學完,就再也學不到新東西了。
作者的辦法叫 rationalization。對答錯的題目,在提示裡直接告訴模型正確答案,請它寫出推理:
Q: Where do you put your grapes just before checking out?
Answer Choices:
(a) mouth
(b) grocery cart (CORRECT)
(c) super market
(d) fruit basket
(e) fruit market
A: The answer should be the place where grocery items are placed before
checking out. Of the above choices, grocery cart makes the most sense for
holding grocery items. Therefore, the answer is grocery cart (b).
原論文 Figure 2 的提示範例;「(CORRECT)」就是給模型的提示。
知道答案之後,往回推出一段說得通的理由就容易多了。接著,這段推理放進訓練資料時,會把提示拿掉,訓練的輸入只有原本的題目,好像模型自己想出來的一樣。
這樣一來,原本做不出來的難題也能進入訓練資料,資料量也跟著變多。
完整的演算法是兩層迴圈:
- 用目前的模型 對每一題寫推理和答案。
- 答錯的題目,加上正確答案當提示,再寫一次。
- 留下第一步答對的,以及第二步在提示下推出正確答案的。
- 從原本的 開始,用這些資料微調出 ,回到第一步。
這其實是強化學習
作者指出,STaR 可以看成強化學習的近似。把推理 當成隱變數,答對得 1 分、答錯得 0 分,整個資料集的期望獎勵和梯度是:
這是標準的策略梯度。答錯的樣本獎勵是 0,梯度直接消失,等於 STaR 的「只留答對的」;答對的樣本,梯度就是一般的對數似然,等於拿它做監督式微調。
和真正的策略梯度相比,STaR 做了兩個簡化:用貪婪解碼取代隨機取樣,降低變異數,代價是探索得比較少;同一批資料上做很多步梯度更新。rationalization 則可以看成從另一個分布 取樣,也就是離策略(off-policy)的估計。
這段推導在當時只是附帶一提,後來卻成了理解推理模型訓練的一個方便角度。
實驗設定
- 模型:GPT-J 6B,因為權重和微調程式都公開,而且夠大,寫得出有一定品質的推理。batch 是 8 條長度 1024 的序列,學習率 ,在一個 TPU v3 節點上訓練和取樣。
- 加法:兩個 位數相加,照 Nye 等人的 scratchpad 格式寫出逐位相加的過程。先產生 5 萬題,每輪抽 1 萬題;1 到 5 位數各有 10 個範例。
- CommonsenseQA:五選一的常識問答,訓練集 9,741 題。提示用思維鏈論文的 10 題,作者修正了其中一題的錯誤答案,並讓推理更明確地引用相關知識。
- GSM8K:小學數學應用題,訓練集 7,473 題,測試集 1,319 題。
加法題的推理照原論文 Figure 3 的格式,從個位數開始逐位相加,C 是進位。以 624 + 259 為例:
<scratch>
6 2 4 + 2 5 9 , C: 0
2 + 5 , 3 C: 1
6 + 2 , 8 3 C: 0
, 8 8 3 C: 0
0 8 8 3
</scratch>
8 8 3
每一行是下一組要加的位數、目前累積的結果和進位。模型要學會自己寫出 <scratch> 到最後的答案;在 rationalization 時,正確答案會放在提示的「Target:」後面。
這種格式的推理和答案綁得很緊,推理中間錯一步,答案幾乎一定錯。這一點在後面很重要。
討論
加法:一位數一位數往上爬
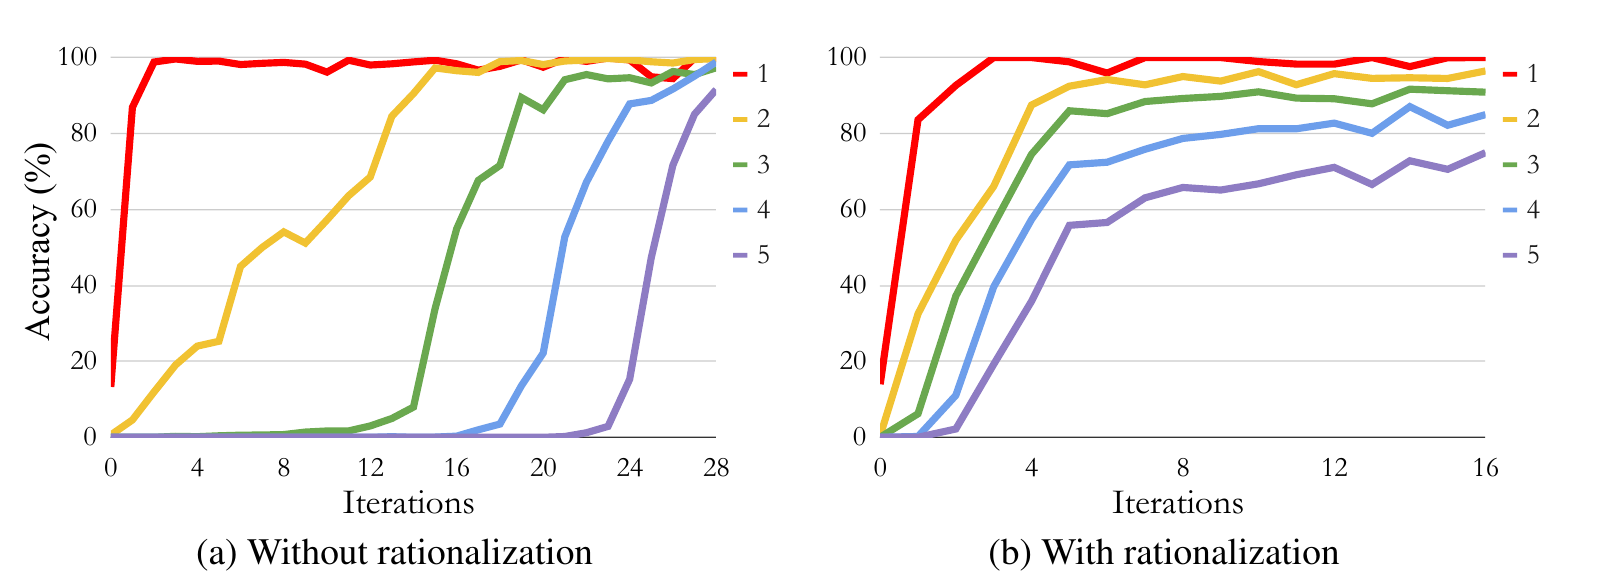
起點非常低。少樣本提示時,GPT-J 做兩位數加法的準確率不到 1%,更多位數幾乎是 0。
沒有 rationalization 時(左圖),進步是一階一階的。模型要先把 位數學好, 位數才開始有起色,5 位數要等到第 23 輪左右。這很合理,只有答對的題目能進訓練資料,模型得先偶爾答對幾題 位數,才有東西可學。
加上 rationalization 之後(右圖),各種位數幾乎一起進步,只是準確率不一樣。第一輪微調後,兩位數就從不到 1% 跳到 32%。因為有提示,很多題目在少樣本時就能做出來,所以這組從 300 步開始訓練,每輪加 20 步。
論文報告跑 16 輪之後,整體準確率是 89.5%。作為對照,不寫推理、直接用 1 萬題訓練 5,000 步的模型是 76.3%。
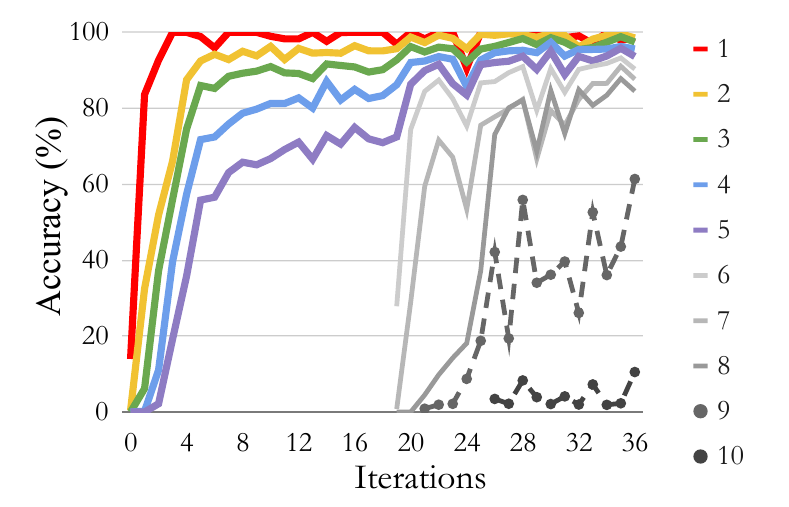
作者另外在第 20 輪左右加入更多位數的題目,總訓練題數不變。原本的 1 到 5 位數反而進步更快,而且從沒在訓練中出現過的 9、10 位數也能答對一部分。代價是訓練變得不穩定,原因作者也說不清楚。
CommonsenseQA:6B 追上 175B
| 方法 | 準確率 | 用到的訓練資料 |
|---|---|---|
| GPT-3 175B 直接微調輸出答案 | 73.0 | 100% |
| GPT-J 少樣本,直接回答 | 20.9 | 約 0 |
| GPT-J 少樣本思維鏈 | 36.6 | 約 0 |
| LaMDA 137B 少樣本思維鏈 | 55.6 | 約 0 |
| GPT-J 直接微調輸出答案 | 60.0 | 100% |
| STaR(無 rationalization) | 68.8 | 69.7% |
| STaR(有 rationalization) | 72.5 | 86.7% |
整理自原論文 Table 1;準確率為驗證集的 %。最後一行的 86.7%,有 78.2% 來自自己答對的題目,8.5% 來自 rationalization。
這張表有幾件事值得對照:
- 只用 GPT-J 自己寫的推理,就比拿全部資料直接微調高 8.8 個百分點,而 STaR 只用到七成的題目。
- 加上 rationalization 到 72.5%,和大將近 30 倍的 GPT-3 微調結果 73.0% 只差 0.5。
- 小模型少樣本思維鏈只有 36.6%,STaR 把它拉高了 35.9 個百分點,也超過 LaMDA 137B 的少樣本思維鏈。
五選一的題目亂猜就有 20%,作者也提到,只靠語意相似度這類簡單的經驗法則就能到 30% 左右。
另一個發現是,微調時把那幾個少樣本範例也放進訓練序列,對成績有明顯幫助。沒有 rationalization 時從 60.9% 到 68.8%,有 rationalization 時從 69.9% 到 72.5%。
推理的品質
推理寫得好不好,在加法題可以直接和標準過程比對,常識題就只能靠人看。作者隨機挑了 50 題,這些題目少樣本思維鏈和 STaR 都答對了,再找來 CoS-E 裡人寫的解釋。20 位群眾外包工作者各看 10 題,替三種推理排序。
結果 STaR 的推理排在少樣本推理前面的機率高了 30%(),排在人寫的解釋前面的機率高了 74%()。作者特別說明,這個結果反映的是要找人寫出高品質的解釋本來就很難,模型寫推理的能力還沒到人的水準。
不過,答案對了,推理也可能很空洞。附錄列了好幾種答案正確、推理卻站不住的類型,最常見的是把題目換句話說,就當成理由:
Q: What might someone get from learning about science?
Answer Choices:
(a) headache
(b) see things differently
(c) increased knowledge
(d) accidents
(e) appreciation of nature
A: The answer must be something that someone would get from learning about
science. Learning about science would increase knowledge. Therefore, the
answer is increased knowledge (c).
原論文附錄 A.1 的例子。
「學科學會增加知識,所以答案是增加知識」,這句話沒有錯,但也沒有解釋為什麼不是「appreciation of nature」。其他類型還有循環論證、乾脆不給理由,以及把題目裡的人名當成真實人物,說出「James 從高處會感到興奮」這種推理。
GSM8K:絕對分數很低,相對翻倍
| 方法 | 測試集準確率 | 用到的訓練資料 |
|---|---|---|
| GPT-J 少樣本,直接回答 | 3.0 | 約 0 |
| GPT-J 少樣本思維鏈 | 3.1 | 約 0 |
| GPT-J 直接微調輸出答案 | 5.8 | 100% |
| STaR(無 rationalization) | 10.1 | 25.0% |
| STaR(有 rationalization) | 10.7 | 28.7% |
整理自原論文 Table 2;單位為 %。
6B 的 GPT-J 做小學數學很吃力,STaR 也只到 10.7%,但比直接微調的 5.8% 多了將近一倍,而且只用了四分之一左右的題目。這裡 rationalization 幾乎沒有幫助,用到的 28.7% 資料裡,只有 0.5% 來自 rationalization。訓練步數也得設上限,否則太久,最後跑了 36 輪,再加上 10 輪 rationalization。
作者比對了模型和標準解答用的計算步數,一致的比例在 53% 到 57% 之間。不一致時,模型通常用比較少的步數。有時是跳步,有時是找到了不同的解法,附錄有一題標準解答用了 7 步,模型略過多餘的資訊,一步就解完。
為什麼不多取樣幾次
要擴充訓練資料,最直覺的做法是提高溫度、多取樣幾次,總會有幾次答對。作者試過,效果反而更差。
溫度一高,「推理錯了、答案卻碰巧對了」的樣本就變多,拿這種資料訓練,模型學不到能推廣的東西。加法題特別明顯,用高溫度取樣學出來的 scratchpad 會慢慢變得毫無意義,模型就卡住了。溫度 0.5 或 0.7 的版本,一律比不加 rationalization 的 STaR 還差。而且取樣 10 次大約慢 10 倍,比 rationalization 貴得多。
「碰巧答對」的比例,和題型的猜中機率有很大的關係。假設模型的推理真的正確的比例是 ,推理錯的時候仍有 的機率猜中答案,那通過「答案正確」這道過濾的資料裡,推理其實是錯的比例是
多位數加法幾乎不可能猜中, 接近 0,過濾很乾淨。五選一的 CommonsenseQA 若用隨機猜測的 估算,一開始 時,留下來的資料約有 64% 是碰巧猜對的; 升到 0.6 時降到約 12%。是非題的 ,情況更糟。模型越來越強之後,比例會下降,但起步階段的資料品質最差,偏偏又最關鍵。
限制
作者在結論和附錄提了這幾點:
- 起點不能太弱:第一輪要成功,少樣本的表現必須高於亂猜,模型得本來就有一點推理能力。作者試過 GPT-2,連加法都啟動不了。
- 猜中機率高的任務:是非題這類任務會留下很多爛推理,怎麼過濾還沒有答案。
- 偏誤會被放大:STaR 放大的是「能答對」的推理,如果資料集裡的偏見有助於答對,偏見也會被放大;rationalization 更會把模型原本不會主動給出的偏頗答案「拉」出來。
- 推理不一定忠實:模型可能先選好答案,再編一段理由,這種推理和模型實際的判斷依據無關,而 STaR 沒有辦法檢查這一點。
- 提示不一定好給:這裡的提示就是正確答案,但在其他情境,怎麼給提示未必那麼直接。
作者也提了一個延伸:用高溫度取樣多個推理,對答案投票,把多數決的答案當成標準答案,這樣連沒有答案的題目也能拿來訓練。
後來的事
STaR 的迴圈後來被放大了好幾次。2023 年 12 月,Google DeepMind 的 ReSTEM 把同樣的做法放到 PaLM 2 上,在 MATH 和程式題 APPS 上做:取樣、用答案對錯過濾、微調,重複幾輪,並從期望最大化(EM)的角度重新推導,結果勝過只用人寫的資料微調。
作者自己在 2024 年 3 月提出 Quiet-STaR,把「先想再說」搬進預訓練:在一般網路文字上,讓模型在每個 token 之後產生一小段內部推理,用它來預測後面的文字。在 OpenWebMath 和 C4 上繼續預訓練之後,Mistral 7B 在沒有任務微調的情況下,GSM8K 從 5.9% 升到 10.9%,CommonsenseQA 從 36.3% 升到 47.2%。
那段策略梯度的推導,則在推理模型身上變成了真正的強化學習。DeepSeek-R1 的獎勵就是「答案對不對」這類規則;它在強化學習之後收集監督式微調資料時,每個提示取樣多個回答,只保留答對的,共收集約 60 萬筆推理資料。這和 STaR 的篩選是同一件事,規模大了幾個數量級。
結論
STaR 只用 10 個附推理的範例,加上一批只有答案的題目,讓 GPT-J 6B 自己寫出數千條推理來訓練自己。在 CommonsenseQA 上拿到 72.5%,和大將近 30 倍、直接微調的 GPT-3 只差 0.5 個百分點。
最巧妙的是 rationalization。做不出來的題目先告訴模型答案,讓它倒推出理由,訓練時再把答案藏起來;難題因此也能進入訓練資料,加法題的各種位數可以一起進步,而不用一階一階等。
它的弱點也很清楚,篩選只看答案。答案容易猜中的題型,留下來的推理有一大半可能是湊出來的,而論文到最後也沒解決這件事。後來的推理模型改用更大的模型、更多的取樣和更嚴格的驗證,把這個迴圈越轉越大,最初那個問題仍然擺在那裡。