原始論文
Let's Verify Step by Step
- 發表版本
- ICLR 2024會議
- arXiv 首次提交
- arXiv:2305.20050
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{modeltuningletsverify2023,
  title = {{Let's Verify Step by Step}},
  author = {Hunter Lightman and Vineet Kosaraju and Yura Burda and Harri Edwards and Bowen Baker and Teddy Lee and Jan Leike and John Schulman and Ilya Sutskever and Karl Cobbe},
  year = {2023},
  eprint = {2305.20050},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2305.20050}
}
數學題的解答,常常是十幾步推導接成一長串。其中一步算錯,後面寫得再漂亮,答案也是錯的;更麻煩的是,有時候中間錯了,答案卻碰巧是對的。
要讓模型更可靠,一個常見的做法是訓練一個獎勵模型,分辨解答的好壞。它可以拿來做強化學習,也可以在推論時從很多個候選裡挑出最好的一個。不管哪一種用法,整個系統最多就跟獎勵模型一樣可靠。
獎勵模型要怎麼教?DeepMind 的 Uesato 等人在 2022 年比較過兩種做法:只看最後答案對不對的結果監督,以及逐步檢查每一步的過程監督。在小學數學 GSM8K 上,兩者的最終表現差不多。
OpenAI 的 Lightman 等人重做了一次比較,這次用的是更強的模型(GPT-4)、多得多的人工標註,以及難得多的題目(MATH,高中競賽程度)。結論不一樣了。
定義問題
兩種獎勵模型的差別在訓練訊號:
- 結果監督獎勵模型(ORM):學習預測一整份解答是對是錯。標籤可以自動產生,因為 MATH 的每一題都有能自動比對的最終答案。推論時,取模型在最後一個 token 的預測當成解答的分數。
- 過程監督獎勵模型(PRM):學習預測每一步是對是錯。這沒辦法自動判斷,得請人一步一步標。
ORM 的標籤有一個天生的漏洞,推理錯誤、答案碰巧正確的解答會被標成對的。
這篇只研究獎勵模型本身,不用它去強化學習產生解答的模型。評估方式是 best-of-N:固定一個產生解答的模型(generator),每題取樣 N 份解答,讓獎勵模型挑分數最高的那份,看答對的比例。獎勵模型越可靠,就越常挑到正確的那份。
解決問題
兩種規模的模型
大規模的模型全部從 GPT-4 的基礎模型微調而來。這個基礎模型只做過預測下一個 token 的預訓練,沒有經過 RLHF。目標是做出最好的 ORM 和 PRM。
小規模的模型結構類似 GPT-4,但預訓練的計算量大約少 200 倍,用來做大規模時負擔不起的對照實驗。
所有模型都先在 MathMix 上多訓練一輪,這是大約 15 億個 token 的數學相關資料,能提升數學推理能力。
產生解答的模型也經過微調。作者用少樣本提示讓模型解 MATH 的訓練題,留下答對的,用這些解答訓練一個 epoch,目的只是讓它學會一行一步的格式,方便切分步驟,不是要教它新技能。
一步一步標
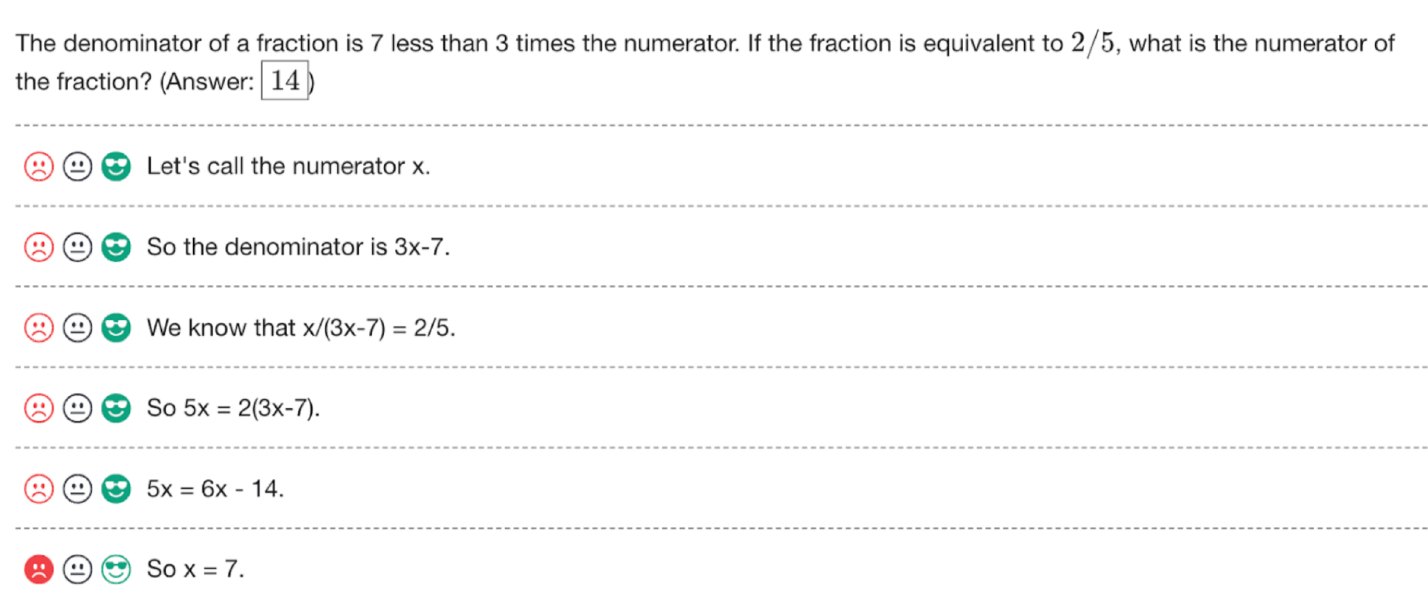
標註者看大規模 generator 寫的解答,替每一步標上三種標籤之一:
- 正面:這一步正確、合理,而且有往答案推進。
- 負面:這一步錯誤或不合理。
- 中性:模稜兩可,例如有點誤導,或者技術上正確但不是好的方向。
保留中性這個選項,是把怎麼處理模糊情況的決定延後,推論時可以把中性當成正面或負面。標註者會拿到正確的最終答案,但不會拿到參考解法,避免他們只認同某一種解題方式。
最後整理成 PRM800K:80 萬個步驟標籤,來自 1.2 萬題的 7.5 萬份解答。題目不夠用,作者把 MATH 測試集的 4,500 題也拿去當訓練題,評估只用剩下隨機抽出的 500 題。附錄確認了這 500 題的難度和科目分布,和整個測試集差不多。
挑哪些解答給人標
標註很貴,所以要挑資訊量大的解答。一份明顯寫錯的解答,標了也學不到多少東西。
作者的策略是挑「有說服力的錯誤答案」:目前最好的 PRM 給了高分,最終答案卻是錯的。既然答案錯了,PRM 至少看錯了其中一步,請人標出是哪一步,就是在補 PRM 的盲點。資料收集的過程中,PRM 會用最新的標註重新訓練幾次,再挑下一批。
PRM 怎麼訓練、怎麼打分
PRM 在每一步的最後一個 token 之後,預測一個代表對錯的 token,用一般語言模型的訓練方式最大化這個 token 的對數似然,不需要特別的架構。推論時,對整份解答做一次前向計算,就能拿到每一步的分數。
一份解答的總分,定義為「每一步都正確」的機率,也就是各步正確機率的乘積。以標註介面上那一題為例,前五步都對,從 5x = 6x − 14 應該得到 x = 14,最後一步卻寫成 x = 7。只要有一步的機率很低,乘起來的總分就很低,而且 PRM 能指出錯在哪一步。
乘積也有副作用,步驟越多,乘起來越小。十二步、每步 0.95 的解答,總分約 0.54,反而比兩步、每步 0.8 的解答(0.64)低。作者在附錄比較了四種打分方式(中性算正面或負面、取乘積或最小值),差距都很小:
| 中性步驟 | 乘積 | 最小值 |
|---|---|---|
| 算正面 | 78.2 | 77.6 |
| 算負面 | 77.4 | 77.8 |
整理自原論文附錄 Table 4;best-of-1860 的 % 答對。
全文用的是表現最好的那一格:中性算正面,取乘積。作者也承認,乘積對步驟多的解答稍有不利。
只標到第一個錯誤為止
過程監督只標到第一個錯誤的步驟,後面不標。這樣兩種監督的比較比較公平。
答對的解答,兩種監督給的資訊一樣,每一步都是對的。答錯的解答,兩者都知道裡面有錯,過程監督多知道錯在哪一步。如果第一個錯誤之後還繼續標,過程監督的資訊量就更占優勢了。
這也讓人工成本差不多。如果沒有現成的最終答案可以比對,判斷一份解答對不對,本來就等於找出它的第一個錯誤。MATH 的題目都有容易比對的答案,作者預期在更複雜的領域,這個條件不會一直成立。
討論
大規模:PRM 明顯勝出
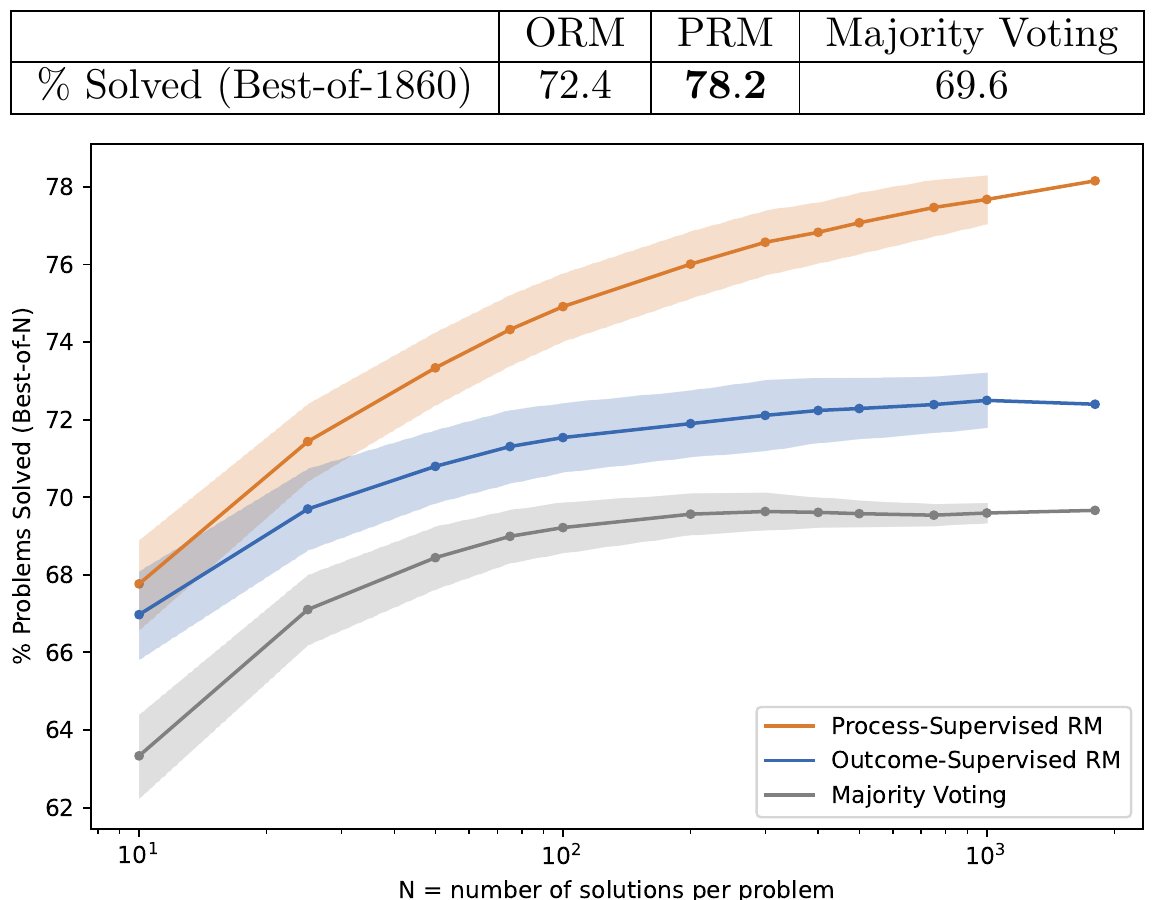
為了讓 ORM 盡可能強,作者每題均勻取樣 100 份解答來訓練它,資料量比 PRM800K 大一個數量級,兩份資料完全不重疊。
每題 1,860 份解答裡挑一份,PRM 答對 78.2%,ORM 72.4%,多數決 69.6%。ORM 只比多數決好一點,PRM 則明顯勝過兩者,而且 N 越大,差距越大。要從大量候選裡挑出正確的那份,PRM 最可靠。
作者也試過用獎勵模型的分數替多數決加權,希望兼得兩者的好處,結果沒有明顯幫助。
小規模:把干擾因素拆開
大規模的結果有兩個干擾因素。第一,兩者的訓練資料不同:PRM 的資料是主動挑過的,偏向錯誤答案,而且小了一個數量級。第二,用最終答案判斷對錯,會把「推理錯、答案對」的解答標成正確,拖累 ORM,這該不該算在結果監督頭上,見仁見智。
真人標註太貴,沒辦法拿來做這些對照。作者改用大規模的 PRM(以下稱 PRMlarge)當標註者,替小規模的模型產生標籤,用便宜的方式模擬大量的資料收集。
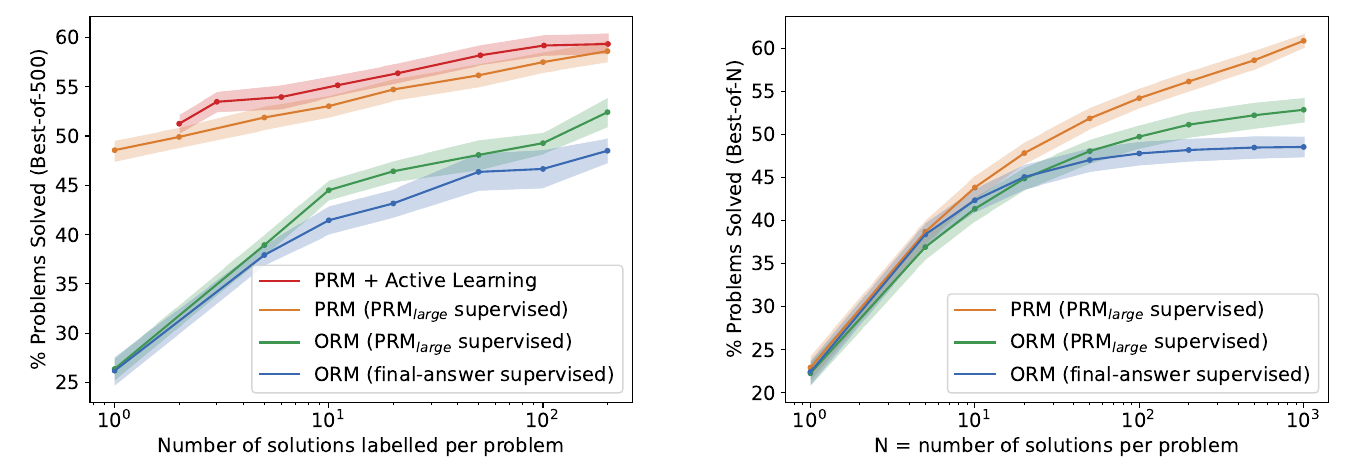
每題取樣 1 到 200 份解答,同一份資料給三種監督:PRMlarge 逐步標註的過程監督、PRMlarge 只判斷整份對錯的結果監督、用最終答案比對的結果監督。三組模型唯一的差別,就是監督的方式。
不管資料多少,過程監督都明顯勝過兩種結果監督。兩種結果監督之間,用 PRMlarge 判斷的比用最終答案比對的好,因為它能把「推理錯、答案對」的解答判成錯的。
作者認為用 PRMlarge 判斷的那組是比較合適的對照。在不容易出現這種假陽性的領域,結果監督會比較像它;MATH 的假陽性問題,可能被放大了。
主動學習:先用每題 1 份解答訓練一個小 PRM,請它替每題 1,000 份解答打分。接著每題挑 N 份,其中 80% 是它評分最高的錯誤答案,20% 是剩下評分最高的解答(不論對錯),再交給 PRMlarge 標註。比較兩條擬合線的斜率,這種主動學習的資料效率大約是均勻挑選的 2.6 倍。
每題挑到 200 份時,表現略低於趨勢線。作者的解釋是 200 份已經占了 1,000 份候選的五分之一,可選的多樣性不夠。他們也試過在收集過程中反覆重新訓練挑選用的 PRM,卻出現無法診斷的不穩定,結果沒有更好。
沒看過的新題目
MATH 的題目在網路上流傳很廣,可能出現在預訓練資料裡。作者另外找了最新的 AP 物理、AP 微積分、AP 化學、AMC10 和 AMC12 考題,這些都在預訓練資料收集完之後才公開。每題取樣 100 份解答:
| 考試 | ORM | PRM | 多數決 | 題數 |
|---|---|---|---|---|
| AP 微積分 | 68.9% | 86.7% | 80.0% | 45 |
| AP 化學 | 68.9% | 80.0% | 71.7% | 60 |
| AP 物理 | 77.8% | 86.7% | 82.2% | 45 |
| AMC10/12 | 49.1% | 53.2% | 32.8% | 84 |
| 合計 | 63.8% | 72.9% | 61.3% | 234 |
整理自原論文 Table 1。
結果和 MATH 上一致,PRM 勝過 ORM 和多數決。在 AMC 這類難題上,多數決只有 32.8%,PRM 是 53.2%。
為什麼過程監督比較好
作者的解釋是功勞分配。結果監督只告訴模型「這份解答錯了」,模型得自己猜錯在哪裡;題目越難,模型寫的解答幾乎都有錯,「錯了」這個標籤帶來的資訊就越少。過程監督直接告訴模型前面幾步是對的、錯在哪一步,訊號豐富得多。
作者也從對齊的角度討論。過程監督獎勵的是人認可的推理過程,而不是只看結果,比較容易解讀,也比較不容易讓模型學會鑽獎勵的漏洞。安全的做法常常要犧牲一點效能,這被稱為對齊稅(alignment tax);在這裡,比較安全的過程監督反而效果更好,作者稱之為負的對齊稅。他們也提醒,這個結論能不能推廣到數學以外,還不知道。
限制
- 測試集汙染:作者用字串比對,把 MATH 的題目從 MathMix 裡刪掉,但網路上可能有難以察覺的改寫版本,無法保證完全乾淨。他們檢查模型的解答,沒有看到明顯背答案的跡象;就算有少量汙染,也應該對所有方法有類似的影響,相對的比較大致不受影響。PRM 常常能挑出 generator 自己只有個位數百分比機率寫對的正確解答,也說明了這一點。
- 只研究獎勵模型:沒有用 PRM 去做強化學習、訓練 generator,作者把這留給後續研究。
- 人工成本:PRM800K 有 80 萬個步驟標籤,靠的是大量的人工標註,而且只在數學上做過。
後來的事
那 500 題測試題,後來被整理成 MATH-500,成了推理模型最常見的評測之一。DeepSeek-R1 在 MATH-500 上的 pass@1 是 97.3%。
人工標註太貴的問題,很快有人找到替代方案。2023 年 12 月的 Math-Shepherd 不請人標註,而是從每一步往下讓模型多寫幾份完整的解答,看有多少能走到正確答案,用這個比例當作這一步的品質。它的作者群和 DeepSeekMath 有重疊。
PRM 也成了推論時搜尋的主要工具,用來在每一步替候選打分、決定往哪裡展開。不過 DeepSeek-R1 在「失敗的嘗試」裡也記錄了 PRM 的三個問題:一般的推理任務很難明確定義每一步;中間步驟的對錯,自動標註不夠準,人工標註又難以擴大;把模型當成獎勵,在大規模強化學習中容易被鑽漏洞。最後他們用的是只看答案對錯的規則獎勵。
結論
在 MATH 這種難題上,逐步標註的過程監督訓練出的獎勵模型,明顯比只看答案的結果監督可靠。從 1,860 份解答裡挑一份,PRM 答對 78.2%,ORM 72.4%,多數決 69.6%;小規模的對照實驗也確認,在同樣的資料上,過程監督一路領先。
代價是 80 萬個人工標籤。主動學習能省下一些,挑「讓 PRM 看走眼的錯誤解答」來標,效率大約高 2.6 倍,但終究要有人一步一步看過。
這篇最後留下最多痕跡的,可能是兩樣附帶的東西:PRM800K 這份資料,以及那 500 題測試題。前者被拿去訓練了無數的獎勵模型,後者成了 MATH-500,至今還出現在每一份推理模型的成績單上。