原始論文
Tracking Objects as Points
- 發表版本
- ECCV 2020會議
- arXiv 首次提交
- arXiv:2004.01177
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{multiobjecttrackingcentertrack2020,
  title = {{Tracking Objects as Points}},
  author = {Xingyi Zhou and Vladlen Koltun and Philipp Krähenbühl},
  year = {2020},
  eprint = {2004.01177},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2004.01177}
}
2020 年 4 月初,arXiv 上相隔兩天出現了兩篇以 CenterNet 為基礎的追蹤論文。
一篇是 FairMOT,在 CenterNet 上加一個 re-ID 分支,讓偵測器順便輸出外觀特徵,再交給 DeepSORT 式的流程去配對。另一篇就是這篇 CenterTrack,第一作者 Xingyi Zhou 正是 CenterNet 的作者,合著者是他在德州大學奧斯汀分校的指導教授 Philipp Krähenbühl,以及 Intel Labs 的 Vladlen Koltun。他們走了另一個方向,不學外觀,直接讓偵測器看兩幀影像,順便告訴你每個物體從哪裡來。
同一個偵測器,兩種截然不同的改法。
定義問題
在電腦視覺的早期,追蹤指的是追蹤影像裡的興趣點,例如角點,看它在下一幀移到哪裡。這種方法簡單、快,但遇到沒有明顯角點或亮度峰值的地方就失靈。
深度偵測器變強之後,tracking-by-detection 成了主流,先在每一幀偵測,再把框連起來。作者認為這套流程有兩個麻煩。第一,最好的追蹤器往往依賴緩慢又複雜的關聯策略;用外觀特徵的,還要再跑一個昂貴的特徵網路。第二,偵測和追蹤是分開的,偵測器在第 幀找物體時,完全不知道第 幀發生過什麼。
Tracktor 已經把偵測和追蹤合在一起,但它把上一幀的框當成候選框交給 Faster R-CNN 回歸,前提是物體在相鄰兩幀之間的框還有足夠的重疊。在幀率低的影片裡,這個前提就站不住,Tracktor 必須另外加運動模型。
如果把物體表示成一個點,事情會簡單很多。CenterTrack 的出發點,就是讓物體的中心點在時間上被追蹤,回到早期「追點」的思路,但這個點是由偵測器找出來的。
作者也很早就劃下邊界。CenterTrack 只做局部追蹤,只關聯相鄰兩幀的物體;物體離開畫面或被擋住再出現,就給一個新的 ID。這是用長距離重新連接的能力,換取簡單、速度和局部的準確度。
解決問題
先複習 CenterNet
CenterNet 是一個以點表示物體的偵測器。輸入一張影像,輸出縮小 4 倍的熱圖 ,每個類別一個通道;熱圖上的每個局部最大值(在 鄰域中最強的點)就是一個物體的中心,峰值高度是信心分數。另外兩個輸出分支在同一個位置讀出框的寬高,以及補回取整誤差的局部偏移。
訓練時,每個物體的中心被畫成一個高斯峰,高斯的寬度隨物體大小調整;損失用 focal loss,、。框大小和局部偏移則只在中心點上用 L1 損失監督。
CenterTrack 多看了什麼
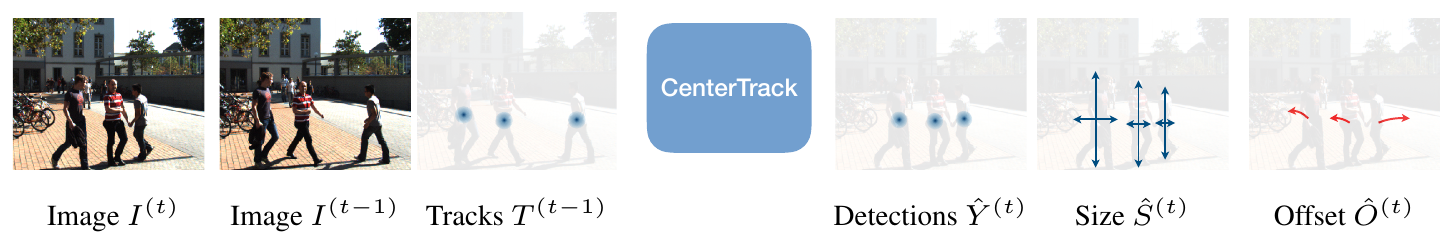
CenterTrack 的網路和 CenterNet 幾乎一樣,只多了四個輸入通道和兩個輸出通道。
多出來的輸入: 上一幀的影像 ,三個通道;上一幀已追蹤物體的中心,畫成一張單通道、不分類別的熱圖 ,一個通道。為了不讓誤報一路傳下去,只有信心分數高於門檻 的物體才會被畫進這張熱圖。
看到上一幀的影像,網路就能估計場景的變化;看到上一幀的物體在哪裡,就算這一幀某個人被擋住一半,網路也比較有機會把他找回來。
多出來的輸出: 一張兩通道的位移圖 。在每個偵測到的中心 上,讀出來的二維向量 代表這個物體從上一幀到這一幀的位移:
訓練方式和框大小一樣,在真實中心點上用 L1 損失回歸真實的位移。
跟著一輛車走一步
位移預測好了,關聯幾乎不用做什麼。我們用一個例子走一次。
假設上一幀有兩條軌跡,A 的中心在特徵圖上的 ,B 的中心在 。這一幀,網路偵測到一個信心分數 0.9 的中心 ,在這個位置讀出的位移是 。
把位移倒推回去,這個物體在上一幀應該在
離 A 的距離約 0.5,離 B 約 29.6。只要 A 還沒被別人配走,而且距離在半徑 之內,就把這個偵測接到 A 上,沿用 A 的 ID。 取預測框寬高的幾何平均 ,也就是大物體容許大一點的誤差。
所有偵測依信心分數由高到低,依序做這個貪婪配對。找不到半徑內的上一幀物體,就開一條新軌跡。
沒有卡爾曼濾波、沒有外觀距離,也沒有匈牙利演算法。
和 Tracktor 相比,差別在於上一幀的物體以熱圖的形式成為網路的輸入,而不是當成候選框。網路在整個感受野內推理兩幀物體的對應關係,就算兩幀的框完全不重疊,也能接得起來。
訓練的關鍵:別讓它抄答案
聽起來很簡單,但作者說細節很重要。
相鄰兩幀的物體幾乎一模一樣。訓練時,如果直接用真實標註畫出上一幀的熱圖 ,網路很快就會發現,把輸入的熱圖照抄一遍到輸出,損失就很低了。它學會的不是追蹤,而是複製。
但到了推論時, 來自網路自己上一幀的預測,會有漏掉的物體、位置偏掉的物體,也會有誤報。作者在訓練時刻意模擬這三種錯誤:
- 位置抖動。 每個上一幀的中心加上高斯雜訊,幅度是框寬高的 倍。
- 假的峰值。 以機率 在真實物體附近多畫一個雜訊峰。
- 漏掉的峰值。 以機率 隨機拿掉一些物體。
在 MOT17 上,、,也就是上一幀的熱圖平均有四成的物體會被故意拿掉。另外,上一幀不一定是真的前一幀,而是從前後兩幀以內隨機挑一幀(),避免網路過度適應特定幀率。
這套資料增強強到 CenterTrack 可以完全不用影片訓練。拿一張靜態影像,隨機縮放、平移,當成「上一幀」,用原本的偵測標註模擬出位移,就能訓練出追蹤器。
其他細節
- 3D 追蹤。 換成 CenterNet 的單目 3D 偵測版本,多加深度、旋轉和 3D 尺寸的輸出頭,就能做單目 3D 追蹤。
- 軌跡重生(track rebirth)。 沒配上的軌跡保留 幀,期間仍可被重新配對、拿回原 ID,但不畫進熱圖,也不輸出。只有 MOT17 測試集用到,;其他實驗都是 。
討論
作者在三個資料集上評估:
- MOT17: 擁擠場景的行人追蹤,幀率 25 到 30 FPS。沒有官方驗證集,消融實驗把每段訓練影片切成前後兩半。
- KITTI: 車載相機,幀率 10 FPS,幀間位移大,只評估汽車。
- nuScenes: 自駕場景的單目 3D 追蹤,評估的關鍵幀只有 2 FPS,幀間位移非常大。主指標是 AMOTA,也就是在不同信心門檻下 MOTA 的加權平均。
主要結果
MOT17 官方排行榜只開放 public detection。CenterTrack 預設會自己偵測,所以作者另外做了一個 public 版本,沿用 Tracktor 的規則,保留靠近上一幀已追蹤框的框,新軌跡只能在公用偵測框附近開啟。
在這個設定下,MOTA 是 61.5,比當時已發表的最佳方法 Tracktor v2(56.5)高了 5 分,FN 從 235449 降到 200672。作者認為原因有兩個,上一幀熱圖讓已追蹤的物體不容易漏掉,學出來的位移又讓關聯更穩。IDF1 是 59.6,低於離線方法 LSST17 的 62.3,但高於其他線上方法。
private 版本的 MOTA 是 67.8,IDF1 64.7,每幀 57 毫秒,包含偵測。
KITTI 上,MOTA 89.44,比排行榜上次一名的 MASS(85.04)高出 4 分多。nuScenes 測試集上,[email protected] 是 27.8,官方單目基準是 6.9。
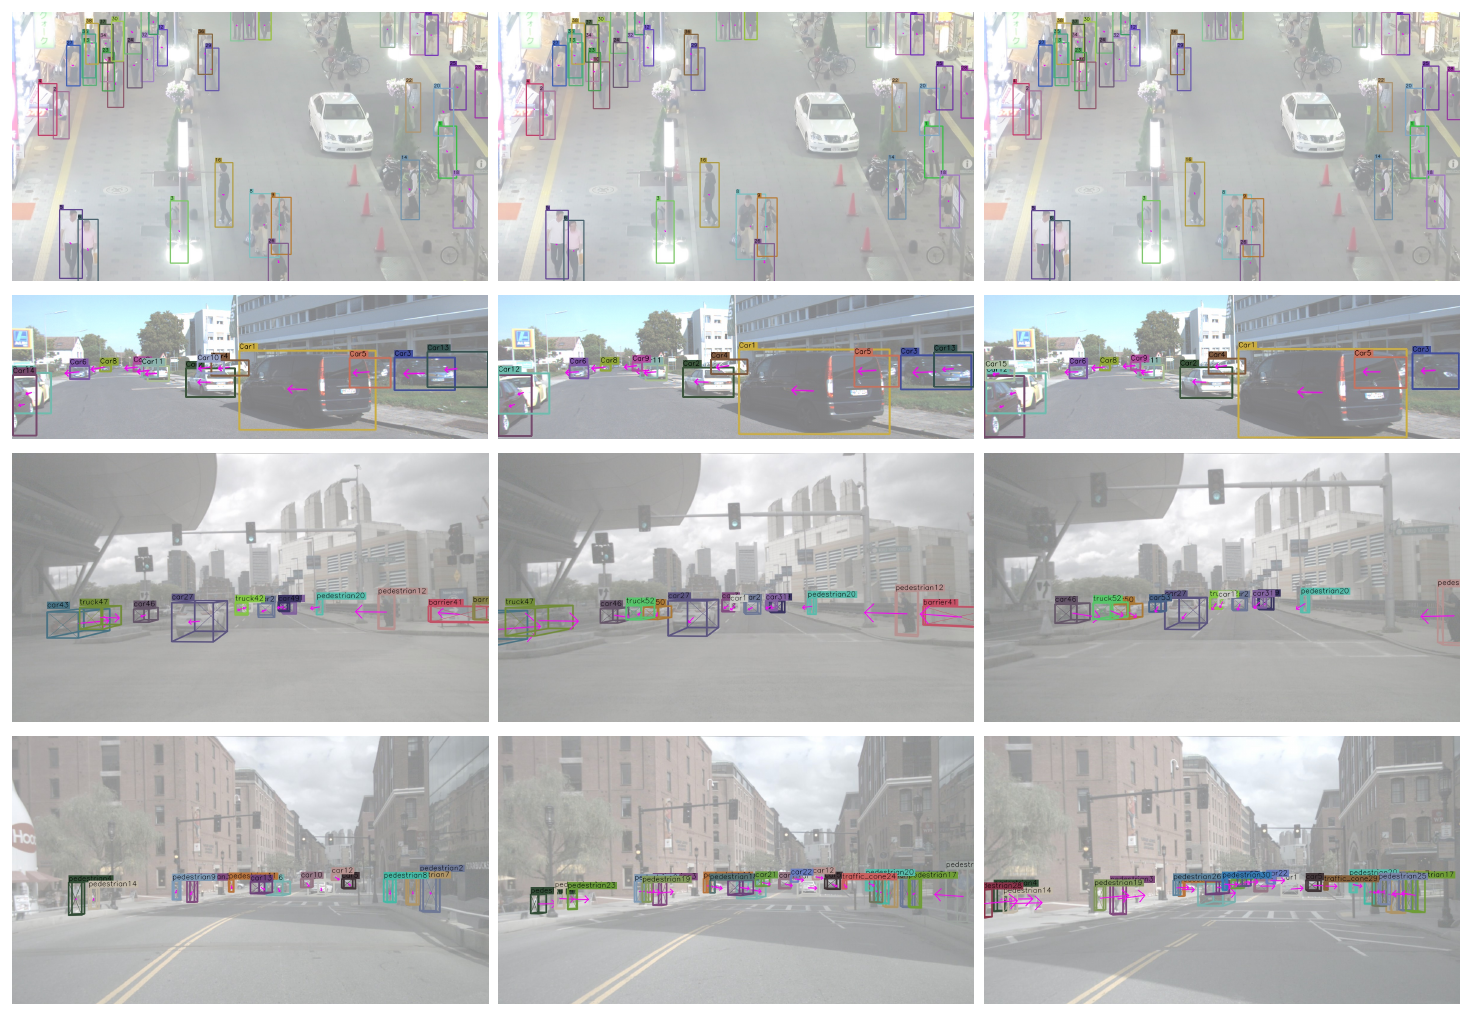
同一套網路,換個資料集訓練,就能處理行人、車輛和單目 3D 物體。
兩個設計各自貢獻多少
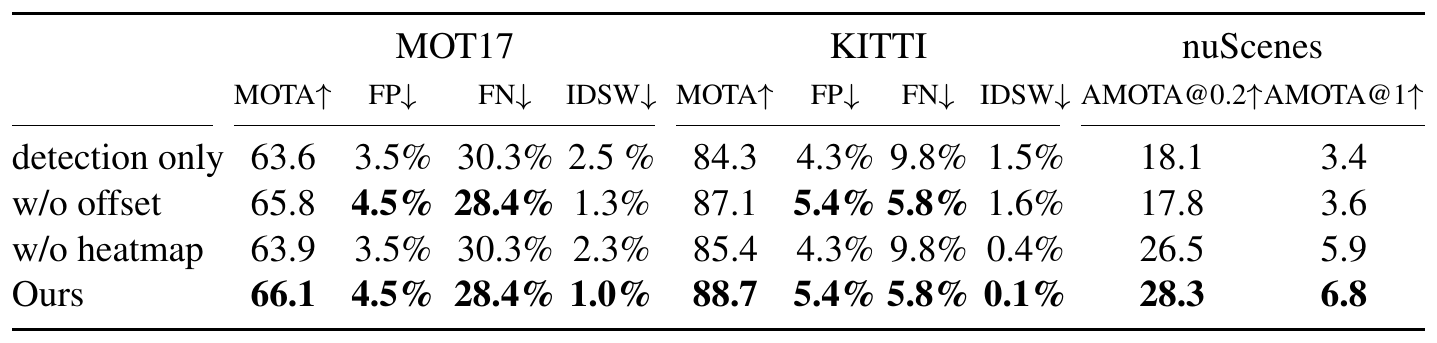
這張表比較四種設定:
- detection only: 每一幀各自跑 CenterNet,用中心點距離關聯。
- w/o offset: 有上一幀熱圖,但位移設為零,直接找上一幀最近的物體。
- w/o heatmap: 有位移預測,但不給上一幀熱圖。
- Ours: 兩者都有。
先看熱圖的效果。比較 detection only 和 w/o offset,或 w/o heatmap 和 Ours,加上熱圖後,MOT17 的 MOTA 多約 2 分,KITTI 多約 3 分。FN 下降、FP 上升。有了上一幀的提示,網路傾向在舊峰值附近多找出物體,有時是找回被擋住的人,有時則是被誤導。整體還是划算的。
再看位移的效果。在高幀率的 MOT17 和 KITTI 上,有沒有位移,MOTA 差不多,但 ID 切換明顯減少(MOT17 從 1.3% 到 1.0%,KITTI 從 1.6% 到 0.1%)。到了 2 FPS 的 nuScenes,差距就拉開了,沒有位移的 w/o offset 只有 17.8,完整模型是 28.3。幀率越低,物體在兩幀之間移動越多,「直接找最近的」就越不可靠。
雜訊、靜態影像、匹配演算法與重生
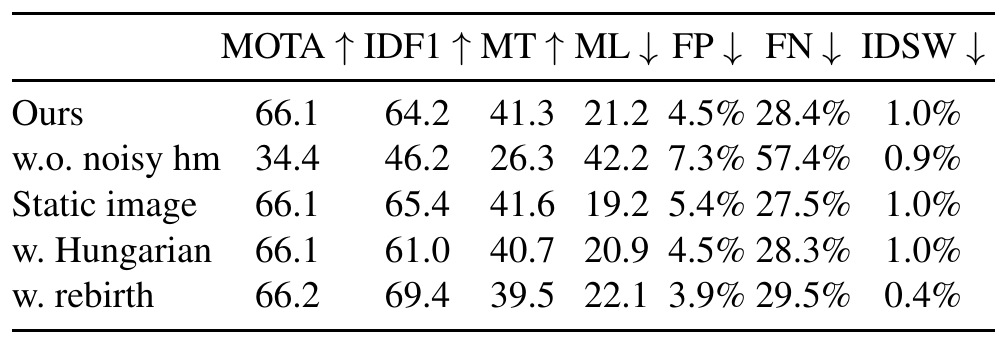
- 不加雜訊,模型就壞了。 訓練時不模擬熱圖錯誤,MOTA 從 66.1 掉到 34.4,FN 從 28.4% 暴增到 57.4%。作者指出的一個原因,是第一幀的輸入熱圖是空的,而這個模型只學過照著熱圖找人,熱圖上沒標的新物體,它很難自己發現。
- 靜態影像就夠了。 只用靜態影像訓練,MOTA 一樣是 66.1,IDF1 甚至略高。不過作者也提到,在低幀率的 nuScenes 上,靜態影像訓練的效果比較差。
- 匈牙利演算法沒有幫助。 換成全域最佳配對,MOTA 不變,IDF1 反而從 64.2 降到 61.0。作者因此保留簡單的貪婪配對。
- 重生大幅改善 ID。 加上 的軌跡重生,MOTA 幾乎不變,IDF1 從 64.2 升到 69.4,ID 切換從 1.0% 降到 0.4%。純局部追蹤丟掉的身分,在 MOT17 這種遮擋頻繁的場景裡,影響其實不小。
學出來的位移,比運動模型多做了什麼
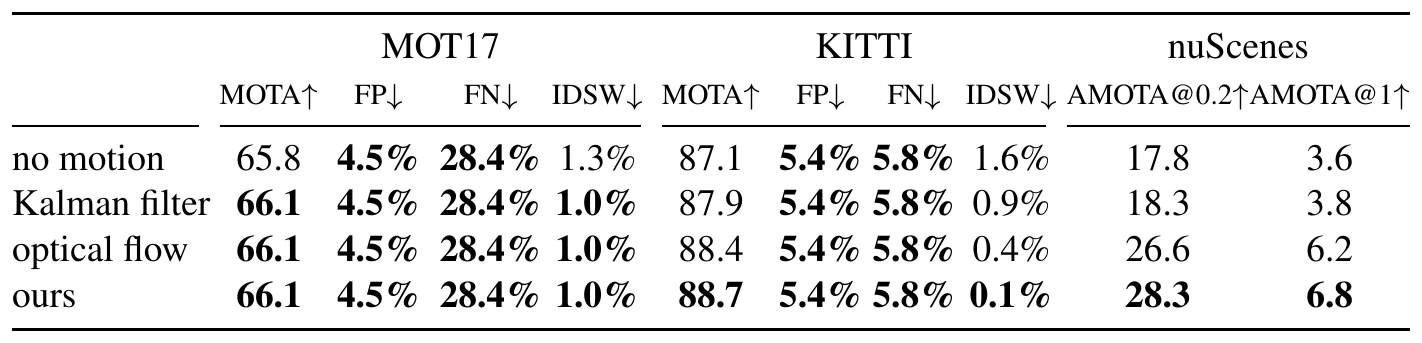
作者把學出來的位移換成三種運動模型:不動(位移為零)、SORT 的卡爾曼濾波、FlowNet2 的光流(在每個預測中心讀取光流向量)。偵測器完全相同。
在 MOT17 上,四者幾乎沒有差別,連不用運動模型都差不多。行人在 30 FPS 下每幀只移動一點點,怎麼猜都猜得到。
在 KITTI 和 nuScenes 上,卡爾曼濾波的手工運動規則就明顯不夠,在 nuScenes 只有 18.3,幾乎和不動一樣。光流好很多(26.6),但仍輸給 CenterTrack 的 28.3,而且 FlowNet2 每對影像要跑約 150 毫秒。
作者的解釋是,CenterTrack 的位移不只是在估計運動。網路看得到上一幀的物體在哪裡,訓練又一直逼它在有雜訊的熱圖上做對,所以它學會的是把位移「對齊」到上一幀確實存在的那個物體上。位移同時完成了運動估計和關聯。
後來
FairMOT 的論文評論 CenterTrack,說它不抽外觀特徵、只關聯相鄰的幀;FairMOT 自己則能用外觀做長距離關聯、處理遮擋。不重新初始化遺失的長距離軌跡,本來就是 CenterTrack 在引言裡自己劃下的邊界,前面的重生實驗也顯示了它的代價:保留遺失軌跡 32 幀,IDF1 就從 64.2 升到 69.4。作者在 MOT17 的結果討論裡也提到,把這種局部追蹤器和長距離的 re-ID 方法結合,是值得做的方向。
之後的 ByteTrack 把 CenterTrack 當成可以替換關聯方法的基準之一;在 KITTI 這類低幀率資料上,以 CenterTrack 為基礎延伸的方法也持續出現。用位移把兩幀的偵測接起來,成了「偵測與追蹤一體」這條路線的標準零件。
結論
把物體表示成點,讓偵測器多看一張上一幀影像和一張上一幀物體的熱圖,再多輸出一張位移圖。CenterTrack 的關聯只剩下「往回推、找最近的」,卻在 MOT17、KITTI 和 nuScenes 上都超過了當時已發表的方法。
那段訓練時故意弄壞熱圖的資料增強,可以直接帶進自己的專案。不加的話,MOTA 從 66 掉到 34;加了之後,連靜態影像都能拿來訓練追蹤器。
一年半後,ByteTrack 只拿 CenterTrack 的偵測框,換上自己的關聯、讓遺失的軌跡多留 30 幀,IDF1 就多了將近 10 分。