原始論文
Simple Online and Realtime Tracking
- 發表版本
- ICIP 2016會議
- arXiv 首次提交
- arXiv:1602.00763
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{multiobjecttrackingsort2016,
  title = {{Simple Online and Realtime Tracking}},
  author = {Alex Bewley and Zongyuan Ge and Lionel Ott and Fabio Ramos and Ben Upcroft},
  year = {2016},
  eprint = {1602.00763},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1602.00763}
}
2015 年,MOTChallenge 上線了。這個基準把多目標追蹤的影片、標註、公用偵測結果和評測程式放在一起,大家終於能在同一張排行榜上比較追蹤器。
榜單前段擠滿了精巧的系統。多重假設追蹤(Multiple Hypothesis Tracking, MHT)和聯合機率資料關聯(Joint Probabilistic Data Association, JPDA)這些源自雷達追蹤的老方法被重新搬出來,配上外觀模型、線上學習,以及各式處理遮擋的規則。準確度確實上去了,速度卻常常掉到每秒一、兩幀。
昆士蘭科技大學的 Alex Bewley 等人看著這張榜,注意到兩件事。第一,排名最高的追蹤器,正好是唯一沒有使用官方 ACF 偵測結果的方法。第二,最準的那幾個方法,都慢到無法即時運作。
如果偵測品質才是瓶頸,追蹤器還需要這麼複雜嗎?
這篇論文想知道,多目標追蹤可以簡單到什麼程度,又能做得多好。
定義問題
多目標追蹤(Multi-Object Tracking, MOT)的輸入是一段影片,輸出是每一幀裡每個物體的框,加上一個跨幀不變的 ID。
主流做法叫 tracking-by-detection。偵測器先在每一幀獨立找出所有的框,追蹤器再把這些框串成軌跡。偵測器只管「這一幀有誰」,追蹤器負責回答「這個框是上一幀的哪一個」。後者就是資料關聯(data association)問題。
這篇論文還加了一個限制,追蹤器必須是 online 的。也就是說,處理第 幀的時候,只能看到第 幀和之前的資訊,必須當下就給出 ID。另一類 batch 方法可以先看完整段影片,再回頭做全域最佳化,效果通常更好,卻無法用在自駕車或機器人這類必須即時反應的場景。
當時的排行榜長這樣:
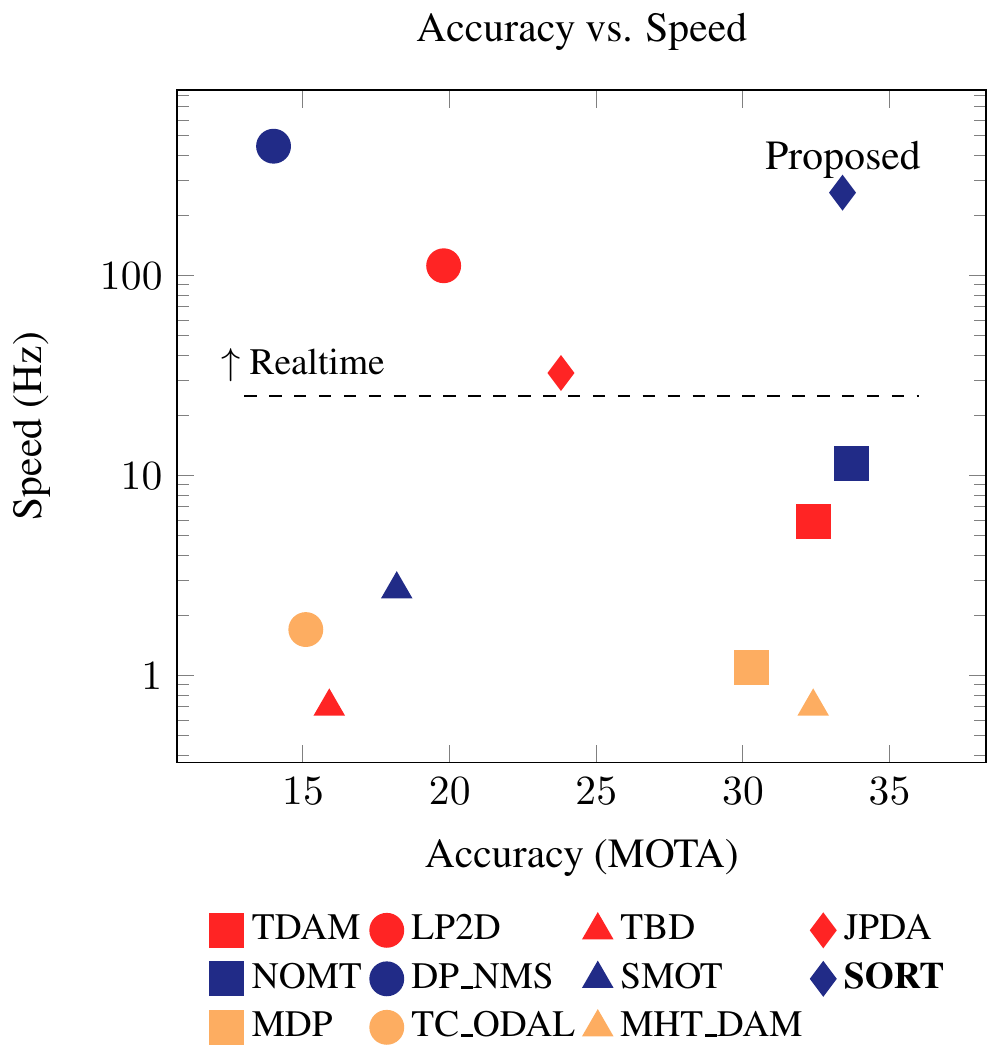
橫軸是準確度,縱軸是速度,越往右上越好。右下角是準但慢的方法,左上角是快但不準的方法,右上角原本是空的。
作者引用奧坎剃刀原則,替自己的追蹤器做了幾個很極端的取捨:
- 只用框的位置和大小。 偵測器之外,不抽任何外觀特徵,運動估計和資料關聯都只看框。
- 不處理遮擋。 作者認為短期與長期遮擋在這組資料裡很少發生,為它們寫專門的機制只會讓系統變複雜。(這個「很少發生」,後來的 MOT20 和 DanceTrack 大概都不同意。)
- 不做重新辨識。 物體離開畫面再回來,就當成新的物體。作者的理由是,重新辨識會帶來可觀的運算負擔,妨礙即時應用。
剩下要做好的,只有相鄰兩幀之間的配對。
解決問題
SORT 由四個部分組成:偵測、狀態估計、資料關聯,以及軌跡的建立與刪除。
偵測器
作者使用 Faster R-CNN,比較了較淺的 ZF 和較深的 VGG16 兩種骨幹。權重直接用 PASCAL VOC 上訓練好的預設參數,沒有針對行人重新訓練;輸出只保留「人」這一類,而且機率要高於 50%。
這一步看起來平凡,卻是整篇論文最重要的實驗變因,我們在討論段再回來看。
每個目標的狀態
每個被追蹤的物體,都用一個七維向量描述:
是框中心的像素座標, 是框的面積, 是寬高比,最後三項是前三者的速度。寬高比沒有速度項,作者假設它不會變。
運動模型是等速度模型:每過一幀,位置加上速度,速度不變。官方程式把它寫成一個 的狀態轉移矩陣 ,以及一個只取前四項的觀測矩陣 :
的前三列在說「新位置 = 舊位置 + 速度」; 在說偵測器只能直接看到 ,看不到速度。速度要靠卡爾曼濾波(Kalman filter)從連續幾幀的觀測裡推出來。
卡爾曼濾波每一幀做兩件事。第一步是預測,用運動模型把狀態往前推一幀,同時讓不確定性變大:
第二步是更新。如果這一幀有偵測框 配給它,就用偵測結果修正預測:
是狀態的共變異數,代表濾波器對自己有多沒把握; 是運動模型的雜訊, 是偵測框的雜訊。卡爾曼增益 決定要相信預測還是相信偵測:預測越不確定( 大),就越聽偵測的;偵測越不可靠( 大),就越聽預測的。
如果這一幀沒有偵測框配給它,就只做預測,不做更新。
怎麼配對
每一幀開始時,先讓所有既有軌跡做一次預測,得到它們在這一幀「應該」出現的框。接著計算每個偵測框和每個預測框之間的交併比(Intersection over Union, IoU),排成一個矩陣。
配對要求一對一,一個偵測框最多配給一條軌跡,一條軌跡最多拿一個偵測框。在這個限制下讓總 IoU 最大,就是經典的指派問題(assignment problem),用匈牙利演算法(Hungarian algorithm)可以求出最佳解。
為什麼不直接挑 IoU 最大的配一配就好?我們來看一個小例子。
假設有兩條軌跡 A、B,和兩個偵測框 1、2,IoU 矩陣如下:
| 偵測 1 | 偵測 2 | |
|---|---|---|
| 軌跡 A | 0.60 | 0.50 |
| 軌跡 B | 0.55 | 0.00 |
如果用貪婪法,先挑全表最大的 0.60,把偵測 1 配給 A。剩下 B 只能配偵測 2,IoU 是 0,配不上。結果 B 這一幀失去觀測,偵測 2 被當成新物體,總 IoU 是 0.60。
匈牙利演算法看的是整體。A 配偵測 2(0.50),B 配偵測 1(0.55),總 IoU 是 1.05,兩條軌跡都有著落。兩個人並肩走、框互相重疊的時候,這種情況很常見。
配對完成後,再把 IoU 低於門檻 的配對拆掉,避免兩個根本不重疊的框被硬湊成一對。官方程式的門檻是 0.3。
作者還注意到 IoU 有一個順帶的好處。當一個人從另一個人前面走過,偵測器通常只會框到前面那個人。這個框的大小和前面那個人的預測框比較接近,IoU 會偏向把它配給前面那個人;被擋住的人沒有配到偵測框,狀態只做預測,不會被錯誤的觀測拉走。短暫的交錯,就這樣在沒有任何遮擋處理規則的情況下撐過去了。
軌跡的生與死
一個偵測框如果和所有預測框的 IoU 都低於 ,就視為新出現的物體,建立一條新軌跡。位置直接取偵測框,速度設為零,速度的共變異數則設得很大,表示還不知道它往哪走。
新軌跡要先經過一段試用期,連續配對成功幾次才算數,用來過濾偵測器偶爾冒出來的誤報。論文沒有寫出次數,官方程式的 min_hits 是 3。
刪除的規則更乾脆。一條軌跡連續 幀沒有配到偵測框,就刪掉。作者在所有實驗中都把 設為 1,理由有兩個:等速度模型本來就預測不準,放著不管只會越漂越遠;而且這篇只處理相鄰幀的配對,重新辨識不在範圍內。
物體如果被擋住一陣子再出現,就會拿到一個新的 ID。
討論
作者在 MOTChallenge 2015(MOT15)上評估。調整卡爾曼濾波的初始共變異數、 和 時,用的是 MDP 這篇論文的訓練與驗證切分。
這裡需要先認識兩個指標:
- MOTA(Multi-Object Tracking Accuracy):把漏檢(FN)、誤報(FP)和 ID 切換(ID switch)三種錯誤加總,除以真實框的總數,再用 1 去減。三種錯誤一視同仁,但前兩種的數量通常比 ID 切換多出一兩個數量級,所以 MOTA 主要反映偵測品質。
- ID sw:一條真實軌跡被分配到的 ID 改變了幾次,直接反映配對做得好不好。
換一顆偵測器
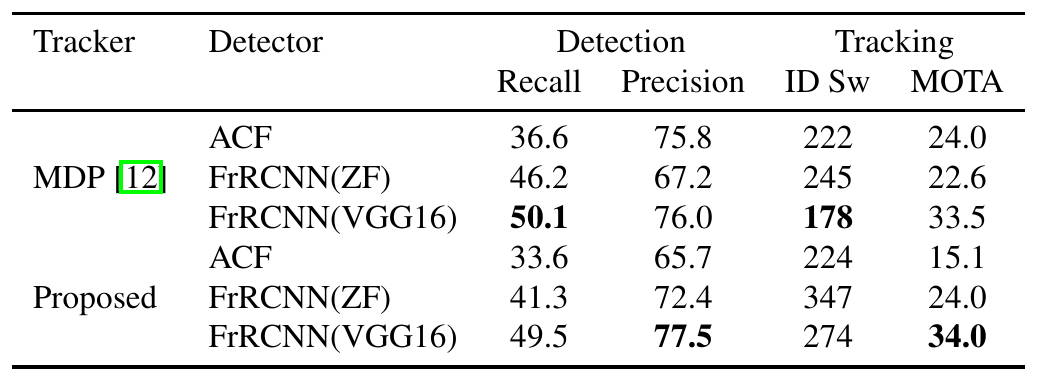
這張表在驗證集上,把兩個追蹤器各自搭配三種偵測器。MDP 是當時表現很好的線上追蹤器,有學習式的決策流程;SORT 是本文的方法。
先看 SORT 那三列。偵測器從 ACF 換成 FrRCNN(VGG16),MOTA 從 15.1 升到 34.0,差了 18.9 分。摘要裡「換偵測器最多可提升 18.9%」指的就是這個差距。追蹤演算法完全沒動。
再看 MDP。換成 FrRCNN(ZF) 之後,召回率從 36.6 升到 46.2,MOTA 卻從 24.0 降到 22.6。問題出在精確率。ZF 的精確率從 75.8 掉到 67.2,誤報增加,MOTA 一併扣分。偵測器「找得到更多」,不見得對追蹤有利,誤報也一樣要付出代價。
兩個追蹤器搭配最好的偵測器時,MOTA 分別是 33.5 和 34.0,相差很小。偵測器帶來的差距,比追蹤器之間的差距大得多。
MOT15 測試集
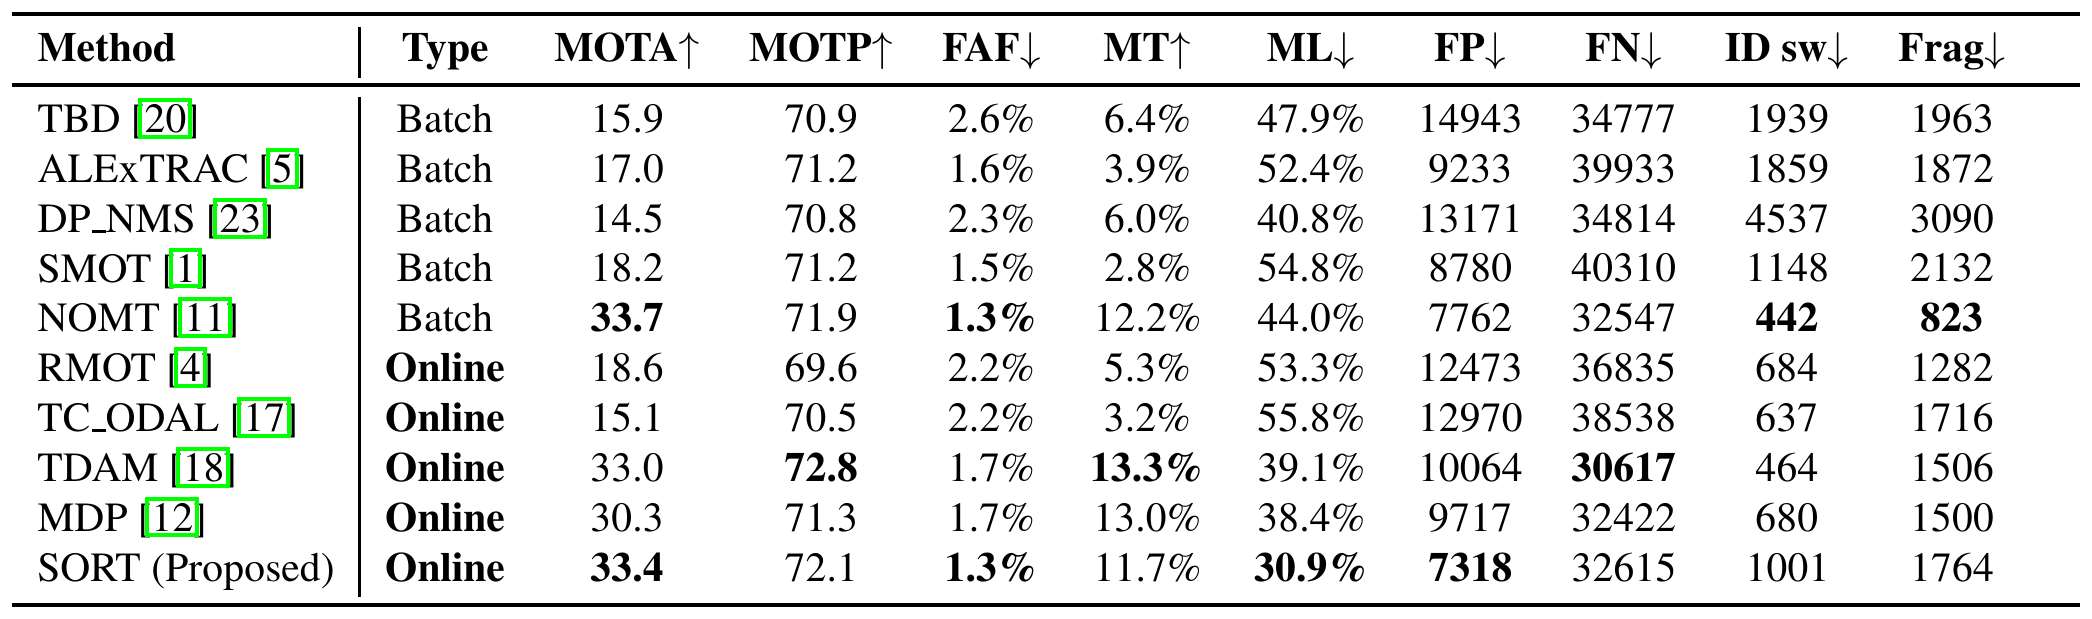
測試集有 11 段影片,真實標註不公開,結果由官方伺服器計算。
SORT 的 MOTA 是 33.4,在線上方法中最高,和會偷看未來幾幀的 NOMT(33.7)幾乎一樣。誤報數 7318 是全表最少,幾乎跟丟的軌跡比例(ML)30.9% 也是最低。
但 ID 切換那一欄就不太好看了。SORT 有 1001 次,而 MDP 是 680,TDAM 是 464,NOMT 只有 442。這就是 和不使用外觀資訊的代價:物體被擋住超過一兩幀,回來時就換了一個 ID。軌跡斷裂次數(Frag)1764,同樣偏高。
MOTA 因為偵測做得好而高,ID 切換卻因為配對太單純而多。這兩欄並列在一起,SORT 的強項和弱點就很清楚了。
速度
追蹤部分在單核 Intel i7 2.5GHz 上跑到 260 Hz,也就是每幀不到 4 毫秒,比表中其他方法快 20 倍以上。
不過,這個數字只算追蹤,不含偵測。SORT 用的 FrRCNN(VGG16),在 Faster R-CNN 原論文的 GPU 上大約每秒 5 幀。整套系統要即時運作,瓶頸其實在偵測器。這不影響論文的論點,它要說明的是追蹤這一步可以幾乎不花時間,把運算預算留給偵測器。
後來
官方程式的說明寫著,SORT 發表時是 MOT15 上排名最好的開源追蹤器,也提醒 SORT 的準確度有很大一部分要歸功於偵測結果。程式本身不到三百行,於是很快成了各種專案的預設基準。
它的參數也跟著四散。不同的移植版本裡,max_age 有 1,也有 30,min_hits 和 IoU 門檻各有調整。拿別人的 SORT 數字做比較時,最好先確認用的是哪一組設定。
作者在結論寫,簡單的框架很適合當基準,讓新方法專心處理長時間遮擋與重新辨識;未來則打算把偵測和追蹤更緊密地結合。一年後,Wojke、Bewley 等人發表的 DeepSORT,就在這副骨架上加回了外觀特徵;JDE、FairMOT 和 CenterTrack 這些把偵測與追蹤放進同一個網路的方法,則走了另一條路。
結論
卡爾曼濾波、IoU、匈牙利演算法,三樣教科書裡的東西,就讓 SORT 在 MOT15 上做到線上方法最高的 MOTA,追蹤本身每幀只花不到 4 毫秒。論文裡最有說服力的一組數字,是換偵測器讓 MOTA 從 15.1 跳到 34.0,而兩個追蹤器配上同一顆好偵測器時,只差 0.5 分。
要做新的追蹤系統,先把 SORT 跑起來當基準,再換一顆更好的偵測器,看看分數變了多少。剩下的差距,才輪到追蹤演算法去解決。
五年後的 ByteTrack 在 MOT17 上拿下第一,用的關聯方法仍然是卡爾曼濾波加 IoU,只是多撿了幾個低分框。