原始論文
ByteTrack: Multi-Object Tracking by Associating Every Detection Box
- 發表版本
- ECCV 2022會議
- arXiv 首次提交
- arXiv:2110.06864
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{multiobjecttrackingbytetrack2021,
  title = {{ByteTrack: Multi-Object Tracking by Associating Every Detection Box}},
  author = {Yifu Zhang and Peize Sun and Yi Jiang and Dongdong Yu and Fucheng Weng and Zehuan Yuan and Ping Luo and Wenyu Liu and Xinggang Wang},
  year = {2021},
  eprint = {2110.06864},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2110.06864}
}
這篇論文的引言,開頭引了一句黑格爾:「凡是合理的都是現實的,凡是現實的都是合理的。」
追蹤論文引哲學家,不太常見。作者想說的是,偵測器給出的低分框,有些其實是真的。
從 SORT 開始,幾乎所有的追蹤器都有一個習慣,先把偵測分數低於某個門檻的框丟掉,只拿高分框去配對。理由很合理,低分框裡有很多背景和誤報,留著只會干擾追蹤。
可是一個人被別人擋住一半時,偵測器的分數也會掉下來。把這些框丟掉,這個人的軌跡就斷了。
FairMOT 的第一作者張一夫,這次和華中科技大學、香港大學、字節跳動的團隊一起,把注意力從網路架構移到這個門檻上。
定義問題
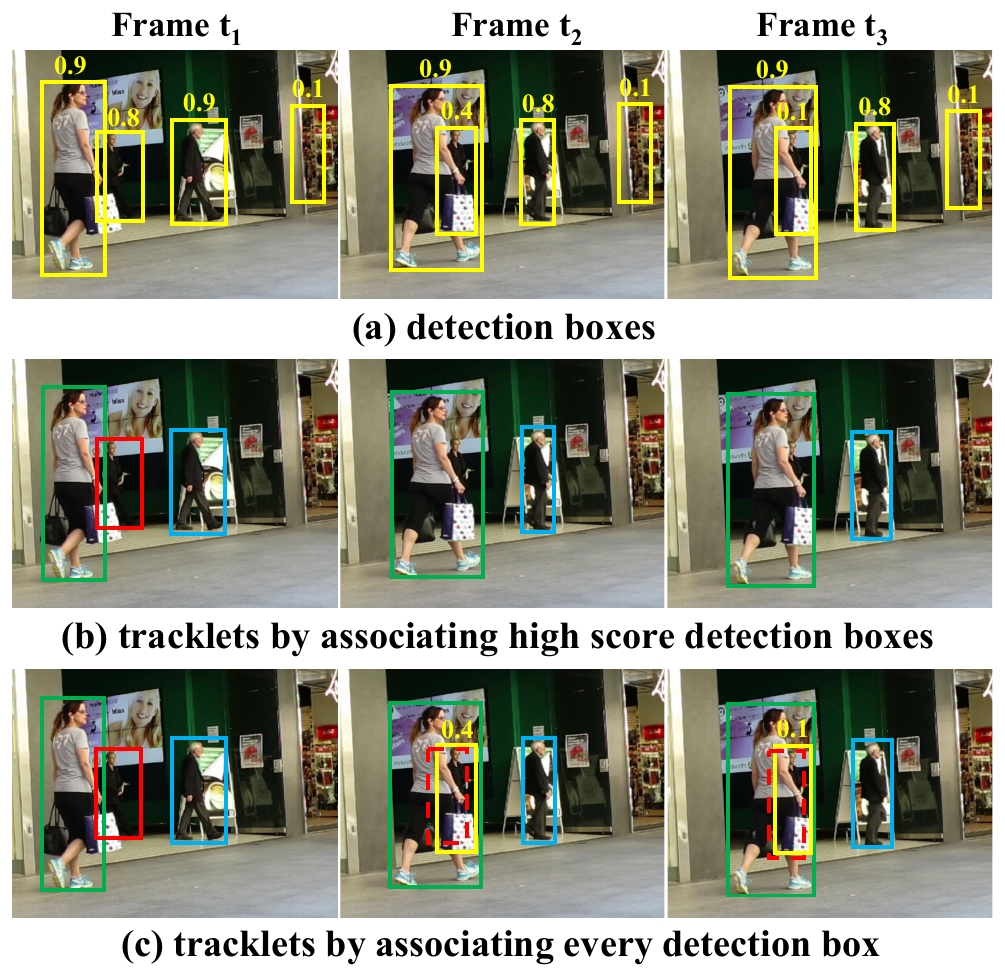
我們先看 (a) 這排。第一幀有四個框,其中三個人的分數都在 0.8 以上,最右邊那個 0.1 的框是背景。
到了第二幀,左邊的女子走到中間那個人前面,把他擋住了一部分,他的分數從 0.8 掉到 0.4;第三幀擋得更多,分數只剩 0.1。
(b) 是一般的作法,只用分數高於 0.5 的框去配對。被擋住的那個人在第二幀就失去了觀測,紅色軌跡跟著消失;等他從女子身後走出來,就會被當成一個新的人。
那全部留下來呢?最右邊那個 0.1 的背景框也會被留下來,變成一條假的軌跡。
這就是偵測門檻的兩難。門檻高,漏掉被遮擋的人;門檻低,引入背景誤報。作者指出,很少有方法真正處理這個兩難。
他們注意到的線索,是和既有軌跡的相似度。被擋住的那個人,雖然分數很低,但他的框和卡爾曼濾波預測的紅色軌跡位置高度重疊;最右邊的背景框,附近沒有任何軌跡。只要拿低分框去和「上一輪沒配上的軌跡」比對,就能把真物體撈回來,同時把背景過濾掉。
(c) 就是這樣做的結果。
解決問題
作者把這個關聯方法命名為 BYTE。名字來自電腦裡的位元組,每一個偵測框都是軌跡的一個基本單位,就像位元組是程式的基本單位。
整個流程只有兩次關聯:
準備: 用偵測分數門檻 把這一幀的偵測框分成兩組,高分框 和低分框 。用卡爾曼濾波預測每條軌跡在這一幀的位置。
第一次關聯: 拿高分框和所有軌跡配對,包括暫時遺失的軌跡。相似度可以用預測框和偵測框的 IoU,也可以用 re-ID 特徵的距離,用匈牙利演算法求解。沒配上的高分框記為 ,沒配上的軌跡記為 。
第二次關聯: 拿低分框和 配對,相似度只用 IoU。這一步結束後,仍然沒配上的低分框直接丟掉,當作背景。
收尾: 兩次都沒配上的軌跡移到遺失集合,保留 30 幀,期間如果在第一次關聯中被配上,就恢復原本的 ID;超過 30 幀才刪除。第一次關聯中沒配上的高分框,則開啟新的軌跡。遺失中的軌跡不輸出。
為什麼第二次關聯只用 IoU?低分框之所以低分,通常是因為嚴重遮擋或動態模糊,這時候的外觀特徵不可靠。位置反而比較可靠:被擋住的人不會在一幀內跑太遠。
BYTE 和偵測器無關,也不限定第一次關聯用什麼相似度,可以接到任何追蹤器的後面。
作者再把 BYTE 接上當時很強的偵測器 YOLOX,命名為 ByteTrack。在 MOT17、MOT20 這些行人資料集上,ByteTrack 兩次關聯都只用 IoU,沒有任何 re-ID 特徵。
討論
ByteTrack 的偵測器是 YOLOX-X,在 COCO 預訓練後,用 MOT17、CrowdHuman、CityPersons、ETHZ 一起訓練 80 個 epoch,輸入尺寸 ,8 張 V100 約 12 小時。速度以 V100、FP16、批次大小 1 量測。
消融實驗把 MOT17 訓練集每段影片切成前後兩半,前半訓練、後半驗證,訓練資料另外加上 CrowdHuman。
和其他關聯方法比
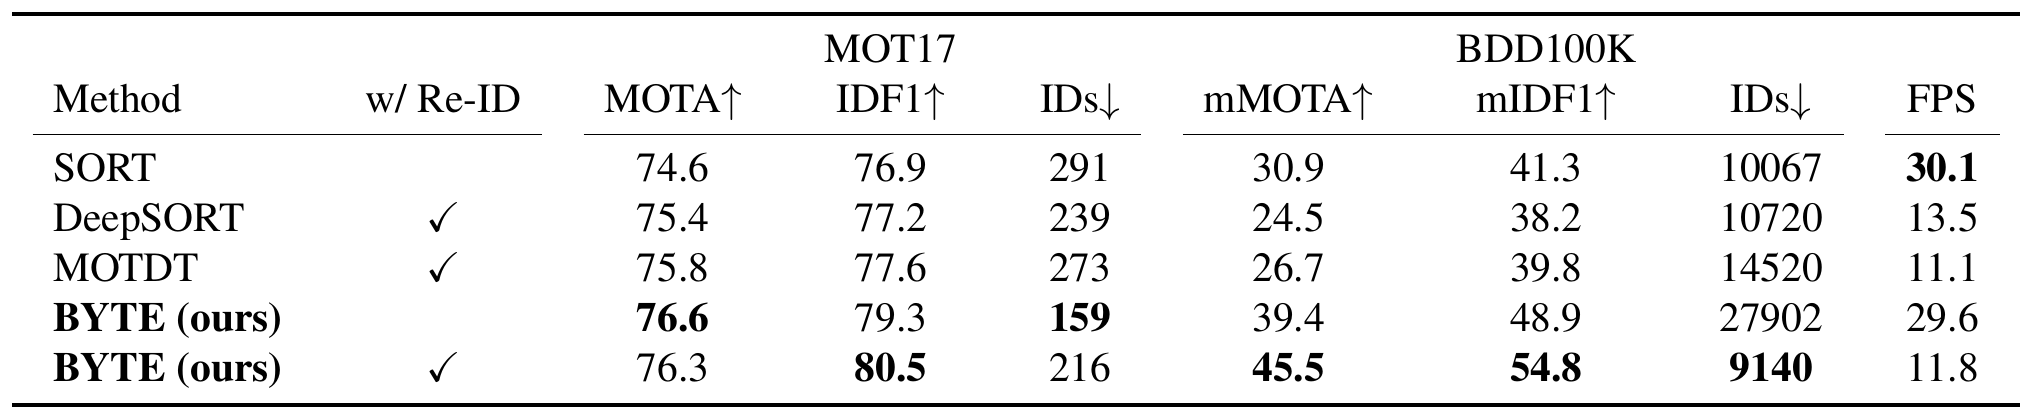
這張表的偵測器都一樣,差別只在關聯方法。
SORT 可以看成 BYTE 的基準,兩者都只用卡爾曼濾波和 IoU,差別只在有沒有第二次關聯。BYTE 把 MOTA 從 74.6 提升到 76.6,IDF1 從 76.9 提升到 79.3,ID 切換從 291 降到 159,速度幾乎不變(30.1 對 29.6 FPS)。這就是低分框的價值。
更讓作者意外的是 DeepSORT。它多了 re-ID 模型,但 MOTA、IDF1 和 ID 切換都輸給只用 IoU 的 BYTE,速度也只有一半不到。作者的解讀是,偵測框夠準的時候,簡單的卡爾曼濾波就能做好長距離的關聯;遇到嚴重遮擋,re-ID 特徵反而容易出錯,運動模型比較可靠。
BYTE 加上 re-ID 之後,IDF1 升到 80.5,但 MOTA 略降、ID 切換增加。
BDD100K 的情況則不同。這是車載影片,相機移動大、標註幀率低,卡爾曼濾波在這裡會失效,所以作者在 BDD100K 不用卡爾曼濾波。只用 IoU 的 BYTE 雖然比 SORT 高出很多(39.4 對 30.9),ID 切換卻高達 27902;加上 re-ID 後 mMOTA 升到 45.5,ID 切換降到 9140。
作者也比較了兩次關聯該用什麼相似度。在 MOT17 上,第一次用 IoU 或 re-ID 都可以,IoU 的 MOTA 和 ID 切換比較好,re-ID 的 IDF1 比較高;在 BDD100K 上,第一次關聯用 re-ID 好得多。但兩個資料集的第二次關聯都是 IoU 比較好,用 IoU 比用 re-ID 大約多 1 分 MOTA。這支持了低分框的外觀特徵不可靠的判斷。
對門檻不再那麼敏感
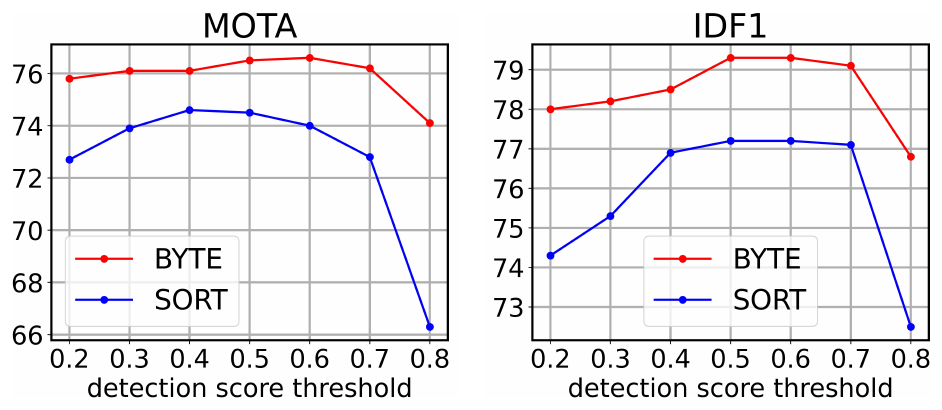
偵測門檻通常是追蹤器最敏感、最需要仔細調的超參數。作者把門檻從 0.2 調到 0.8。SORT 的 MOTA 在門檻變高後快速下滑,從 0.4 時的約 74.5 掉到 0.8 時的約 66;BYTE 則相對平穩。
道理很直接。BYTE 的第二次關聯會把低於門檻的框撈回來,門檻調高,被丟掉的框其實還有第二次機會。
作者也統計了低分框裡的真陽性與誤報。在所有分數介於下限和門檻之間的框中,有些影片(例如 MOT17-02)誤報遠多於真陽性;但 BYTE 從中撈回來的框,真陽性明顯多於誤報。和既有軌跡的相似度確實是一個有效的篩子。
接到別人的追蹤器上
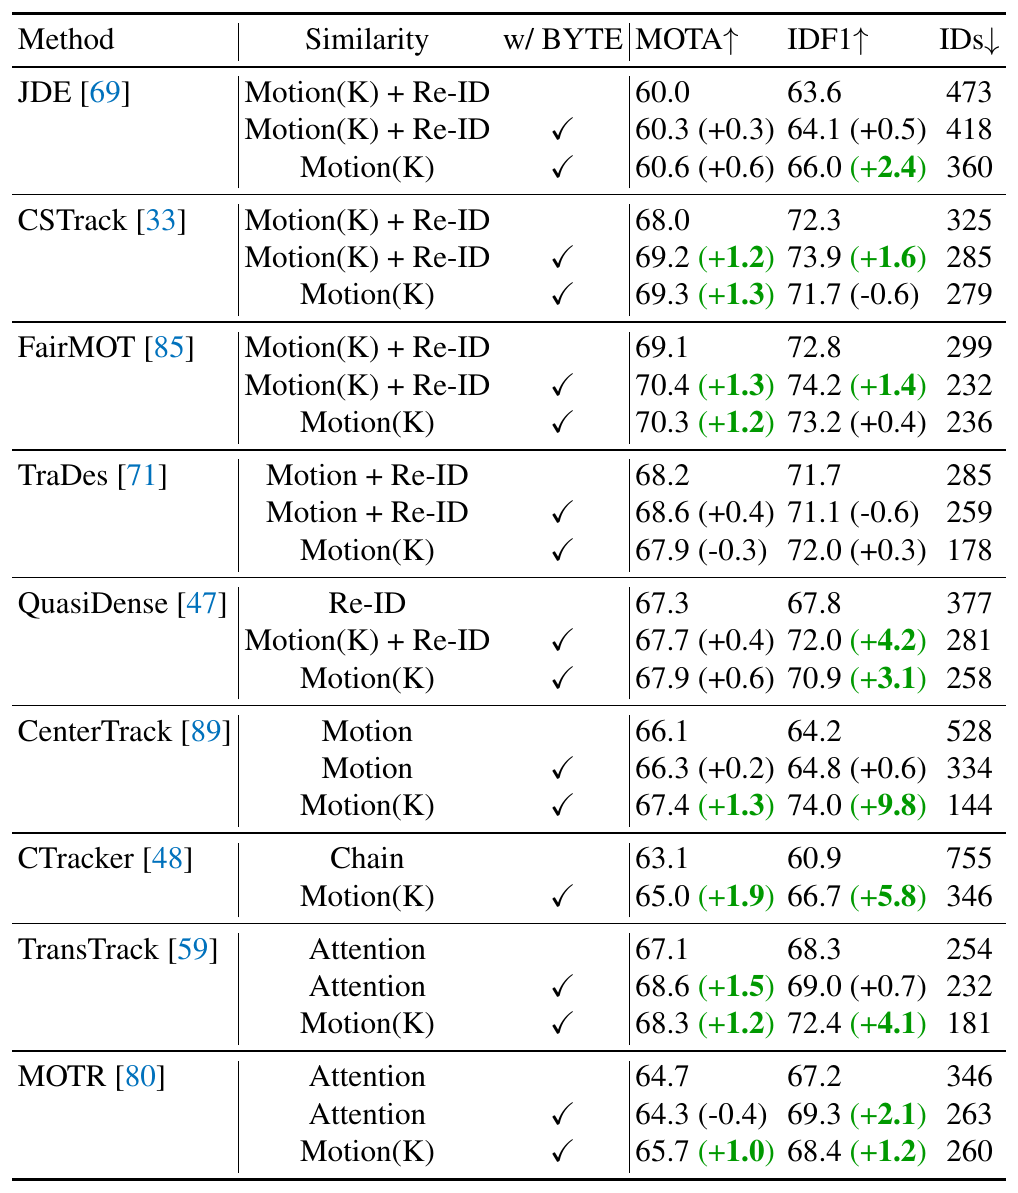
這是全篇最有說服力的一張表。作者把 BYTE 套到九個各式各樣的追蹤器上:JDE、CSTrack、FairMOT、TraDeS 這類運動加 re-ID 的方法;只用 re-ID 的 QDTrack;用學習式運動的 CenterTrack;鏈式結構的 Chained-Tracker;用注意力傳遞框的 TransTrack 和 MOTR。
套用的方式有兩種:
- 插入模式: 原本的關聯照做,結束後把沒配上的軌跡拿去和低分框做一次 IoU 配對。
- 替換模式: 只拿該追蹤器的偵測框,關聯全部換成 BYTE。
幾乎每一個追蹤器、每一項指標都有進步。最明顯的是 CenterTrack,替換模式下 MOTA 多 1.3、IDF1 多 9.8,ID 切換從 528 降到 144。CenterTrack 原本只靠位移倒推做局部配對,被擋住的人一斷就換 ID,BYTE 的遺失軌跡保留機制正好補上這一塊。
不過也不是全面進步。TraDeS 在替換模式下 MOTA 少了 0.3;MOTR 在插入模式下 MOTA 少了 0.4,IDF1 則多了 2.1。這張表比較的是同一個偵測器下關聯方法的差異,BYTE 的貢獻主要在 IDF1 和 ID 切換。
排行榜
| 基準 | MOTA | IDF1 | HOTA | ID 切換 | FPS |
|---|---|---|---|---|---|
| MOT17 | 80.3 | 77.3 | 63.1 | 2196 | 29.6 |
| MOT20 | 77.8 | 75.2 | 61.3 | 1223 | 17.5 |
整理自原論文 Table 4、Table 5 的 ByteTrack 列。
MOT17 測試集上,ByteTrack 比當時第二名的 ReMOT 高出 3.3 MOTA、5.3 IDF1、3.4 HOTA,速度也是全表最快。作者特別提到,ByteTrack 的訓練資料約 2.9 萬張影像,比許多方法用的 7.3 萬張少。
MOT20 平均每張測試影像有 170 個人,擁擠得多。論文寫,ByteTrack 把 MOTA 從 68.6 提升到 77.8,ID 切換從 4209 降到 1223,少了 71%。在 HiEve 上,MOTA 61.7、IDF1 63.1;在 BDD100K 測試集上,mMOTA 從 35.5 提升到 40.1。四個基準都排第一。
這裡要分清楚兩件事。ByteTrack 在排行榜上的大幅領先,有相當一部分來自 YOLOX-X 這顆強偵測器;BYTE 本身在同一個偵測器下的貢獻,要看前面那兩組消融:和 SORT 比是 MOTA 多 2 分、IDF1 多 2.4 分,套到其他追蹤器上則是 MOTA 約 1 到 2 分、IDF1 最多將近 10 分。附錄另外用 YOLOX 的小模型比較,BYTE 在每一種偵測器大小下都贏過 DeepSORT,在最小的 YOLOX-Nano 上 MOTA 高了 3 分。
後來
ByteTrack 很快成了工程上的預設選項。Ultralytics 的追蹤模組提供 ByteTrack 和 BoT-SORT 兩種追蹤器,並把 ByteTrack 定位成最快、最簡單的基準;OC-SORT 和 BoT-SORT 都直接沿用 ByteTrack 的 YOLOX 權重來比較,等於把它當成新一代的 SORT。
它的弱點也很早就被看見。DanceTrack 論文報告的 ByteTrack HOTA 只有 47.7,AssA 32.1。舞者穿著相似、動作非線性,卡爾曼濾波加 IoU 的配對頂不住,MOTR 和 OC-SORT 都在這個資料集上贏過它。只靠位置把人接起來,在人走直線的時候很好用,在人轉圈的時候就不夠了。
結論
被門檻丟掉的低分框,拿去和上一輪沒配上的軌跡再配一次,只用 IoU。ByteTrack 的方法就這一個改動,SORT 的 ID 切換少了將近一半,九個不同的追蹤器套上去幾乎都進步,配上 YOLOX 之後在四個基準拿下第一。
下次調追蹤器的偵測門檻調到心煩時,可以先試試 BYTE。它讓門檻從一刀切的生死線,變成只決定「誰先配」。
黑格爾大概沒想過,自己有一天會在追蹤論文裡替低分框背書。