原始論文
NOOUGAT: Towards Unified Online and Offline Multi-Object Tracking
- arXiv 首次提交
- arXiv:2509.02111
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{multiobjecttrackingnoougat2025,
  title = {{NOOUGAT: Towards Unified Online and Offline Multi-Object Tracking}},
  author = {Benjamin Missaoui and Orcun Cetintas and Guillem Brasó and Tim Meinhardt and Laura Leal-Taixé},
  year = {2025},
  eprint = {2509.02111},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2509.02111}
}
追蹤器向來分成兩派。線上追蹤器一幀一幀處理,只能看過去,自駕車、監視器都需要這種;離線追蹤器可以看整段影片,前後對照,適合標註資料、事後分析比賽。
兩派的方法也長得完全不一樣。線上這邊是 SORT、ByteTrack 這一路,關聯靠人寫的規則:先配高分框、再配低分框,外觀和運動各給多少權重。離線那邊則是 MPNTrack、SUSHI 這類圖神經網路,關聯是學出來的,成績也好,但只能處理固定長度的片段。
可是實際的應用,延遲需求不是只有「馬上」和「不限」兩種。遠距手術可以等兩百毫秒,空拍機一秒只拍一兩張,可以累積好幾十幀再一起處理。
這篇的作者群包括 SUSHI 的三位作者和 TrackFormer 的一作 Tim Meinhardt,一作是 Benjamin Missaoui,論文上的單位都是 NVIDIA。他們想做一個追蹤器,願意等多久都可以:等一幀就是線上追蹤,等兩百多幀就是離線追蹤,中間任何長度都行。名字取作 NOOUGAT,念起來就是牛軋糖。
定義問題
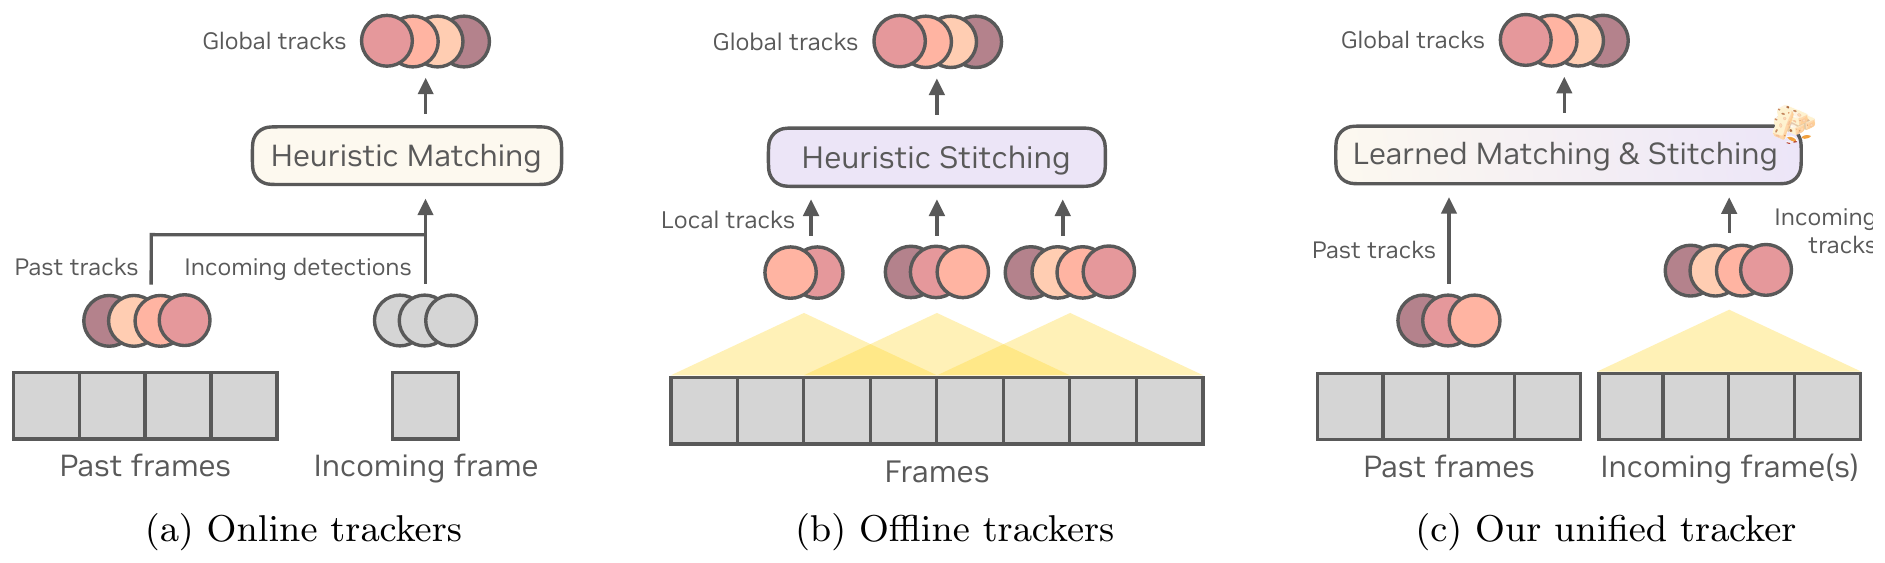
作者指出兩派各自的毛病。
線上追蹤器的關聯靠規則,規則的參數要依資料集調。HybridSORT 的外觀權重,在 DanceTrack 是 4.0,在 MOT17 是 1.3,在 MOT20 是 4.6,還會依偵測信心再變。這些規則也很難處理長時間的遮擋,大部分方法一條軌跡斷掉 30 幀就放棄了。
離線追蹤器的圖網路很強,但它假設一段影片可以一次處理完。影片太長時,只好切成彼此重疊的片段,各自處理後,在重疊區用匈牙利演算法或線性規劃縫起來。這一步又回到了規則,而且重疊的部分要算好幾次。
算一下就知道重複有多少。一段 1,024 幀的影片:
| 方法 | 每段長度 | 每次往前移 | 段數 | 總共處理的幀數 |
|---|---|---|---|---|
| MPNTrack | 15 | 1 | 1,010 | 15,150 |
| SUSHI | 512 | 256 | 3 | 1,536 |
| NOOUGAT | 256 | 256 | 4 | 1,024 |
本文整理的算例;MPNTrack 和 SUSHI 的設定取自論文第 4.1 節。
MPNTrack 每一幀幾乎要算 15 次,SUSHI 算 1.5 次,NOOUGAT 每幀只算一次。
解決問題
切成不重疊的段,一段一段接上去
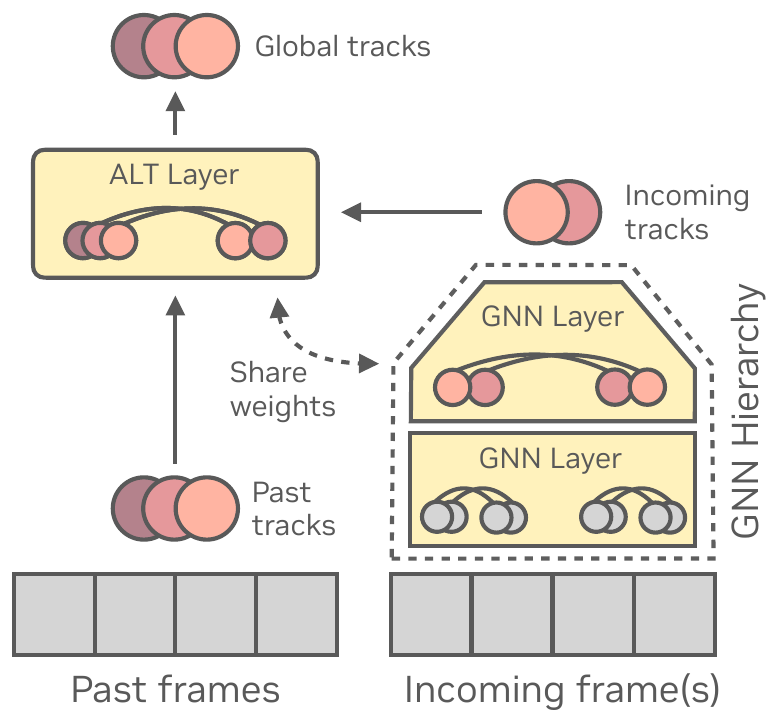
NOOUGAT 把影片切成彼此不重疊、每段 幀的子片段。每一段先用 SUSHI 那一套 GNN 階層處理,得到這一段內部的 tracklet。
接著,一個新的 ALT 層(autoregressive long-term tracking)把「到目前為止的軌跡」和「新來這一段的 tracklet」接起來:
接完的結果,再和下一段接,一路滾下去。
ALT 本身也是一層圖網路。過去的每條軌跡是一個節點,新來的每條 tracklet 也是一個節點,每條過去的軌跡連到最近的 10 條新 tracklet。和 SUSHI 的每一層一樣,網路判斷每條邊是不是同一個人,再取整成配對。
縫接這件事,從人寫的規則換成了學出來的圖網路。ALT 還和 GNN 階層共用權重,作者發現這讓訓練快了一倍多,大約 4 萬次迭代就收斂,原本要 9 萬次。
一個參數,從線上到離線
是 NOOUGAT 最重要的參數。
時,每段只有一幀,GNN 階層派不上用場,ALT 直接把過去的軌跡和這一幀的偵測接起來,這就是一個逐幀的線上追蹤器。這時作者還把圖限制成二部圖:只有過去的軌跡和新來的偵測之間有邊,過去已經做的決定不能再改,符合線上追蹤的規矩。
越大,每一段裡的 GNN 階層能看的時間越長,判斷越有把握,代價是要等更多幀才能輸出。離線設定用的是 ,而且允許修正過去的關聯。
以 30 FPS 的影片來說,每多等一幀,延遲就多 33 毫秒。作者對照了幾種應用:
| 應用 | 可接受的延遲 | 對應的 |
|---|---|---|
| 自動駕駛 | 100 毫秒以內 | 1–2 |
| 監視器 | 約 125 毫秒 | 3–4 |
| 遠距手術 | 200 毫秒最佳,300 毫秒上限 | 6–9 |
| 空拍追蹤 | 拍攝本身只有 1–2 FPS | 15–30 |
| 標註、運動分析 | 不限 | 任意 |
整理自原論文第 5.4 節。
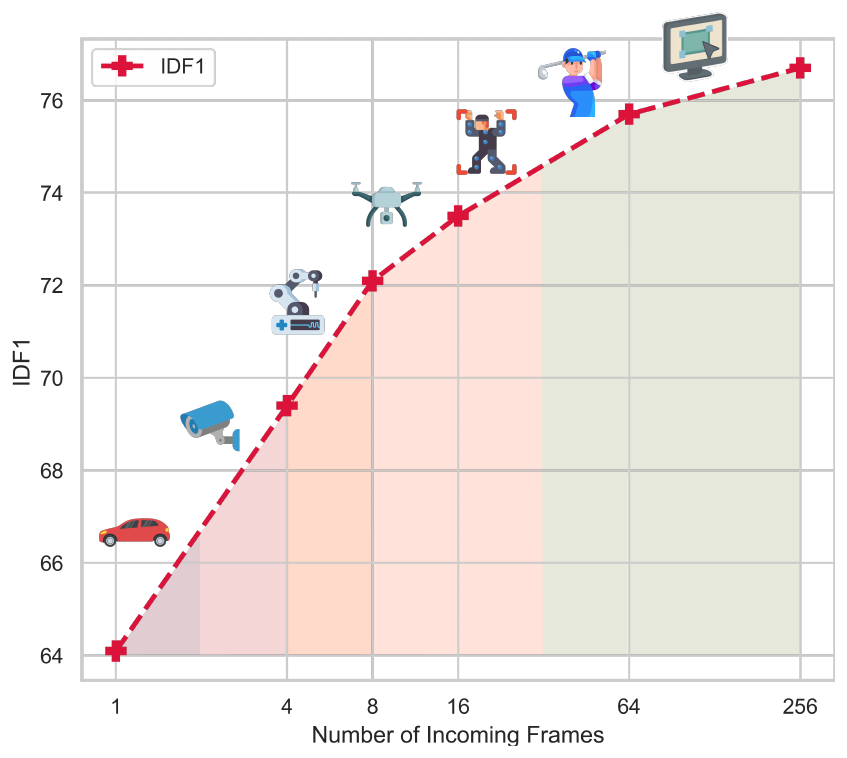
同一個模型架構,願意多等一點,就換到多一點準確度。 從 1 到 8,IDF1 漲了大約 8 分,之後漲勢趨緩,到 256 幀約 77。
特徵和訓練
輸入特徵沿用 SUSHI 的幾何、運動和外觀,另外加了兩樣線上追蹤器常用的東西。一是 OC-SORT 的速度方向一致性,原本是比較一條軌跡和一個偵測框,作者延伸成比較兩條 tracklet:前一條最後 12 個框的行進方向,和後一條前 12 個框反推回去的方向,夾角越小越可能是同一個人。二是偵測信心,放進節點的初始特徵。
訓練 ALT 的難處在於,推論時它要處理的「過去軌跡」千變萬化,有長有短、有斷有續。作者訓練時隨機截取一段過去的真值軌跡當輸入,長度和起點都隨機,再隨機刪掉一些軌跡和框;過去和新來之間還故意空幾幀,模擬短暫的遮擋。
討論
測試集
| 資料集 | 線上最強對手 | 對手 AssA | 線上 AssA | 離線 AssA |
|---|---|---|---|---|
| DanceTrack | Hybrid-SORT | 52.6 | 54.9 | 58.7 |
| SportsMOT | DiffMOT | 65.1 | 74.3 | 83.0 |
| MOT17 | DiffMOT | 64.6 | 65.3 | 68.5 |
| MOT20 | BoT-SORT | 62.9 | 67.5 | 70.7 |
DanceTrack 整理自原論文 Table 1,SportsMOT 整理自原論文 Table 2,MOT17 整理自原論文 Table 3,MOT20 整理自原論文 Table 4;皆為測試集,對手取表中與 NOOUGAT 使用同一組偵測、線上方法裡 AssA 最高者。
比較的對象都用 ByteTrack 的 YOLOX 偵測。線上版本在四個資料集的關聯分數都是最高的,離線版本再往上加 3 到 9 分。SportsMOT 的進步最大,球員常常跑出畫面又回來,這正是長時間關聯最能發揮的地方。
離線版本在 MOT17、MOT20 的 HOTA 並不一定最高。MOT17 上 CoNo-Link 的 HOTA 是 67.1,NOOUGAT 是 66.9;作者的解釋是 CoNo-Link 的偵測比較強,MOTA 高了 2 分,NOOUGAT 贏在 AssA 和 IDF1。
學出來的比規則好多少
作者做了兩個直接的對照。
- 配對。 線上設定下,把 ALT 換成匈牙利演算法,成本用 HybridSORT 的權重組合外觀、運動和速度方向,還在附近做了網格搜尋。DanceTrack 驗證集上,HOTA 從 64.6 掉到 62.1,IDF1 從 69.0 掉到 65.8。
- 縫接。 離線設定下,用和 NOOUGAT 相同的特徵和 ReID 重新訓練 SUSHI,保留它重疊片段加匈牙利縫接的做法。SUSHI 的 IDF1 是 72.0,NOOUGAT 是 76.6。
第二個對照特別有說服力,因為兩者的圖網路幾乎一樣,差別只在縫接是規則還是學出來的。
斷了多久還接得回來
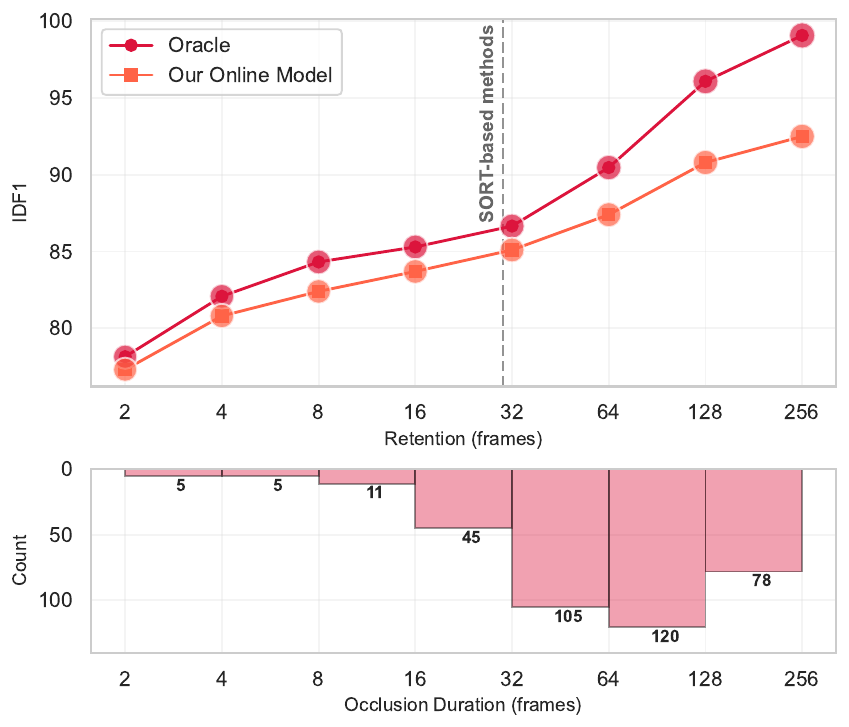
SportsMOT 裡,長於 30 幀的遮擋才是大宗。下半部的分布裡,超過 32 幀的遮擋加起來有 303 次,比短於 32 幀的 66 次多得多。
SORT 系的追蹤器通常 30 幀就把軌跡丟掉。NOOUGAT 讓軌跡保留得越久,IDF1 就越高,保留 256 幀時約 92。中間沒有任何特別為長期遮擋設計的規則,全靠 ALT 自己學。
特徵各自的作用
只給幾何特徵,HOTA 是 59.1;只給外觀,反而只有 57.9;幾何加運動 60.4;全部都給 64.6。DanceTrack 的舞者穿得一樣,外觀單獨用不太可靠,但和其他線索合起來,又能幫忙解決模稜兩可的情況。
速度和規模
在 V100 上、偵測和 ReID 都事先算好的情況下,線上版本只有 12 FPS,離線版本反而有 340 FPS。原因是線上版本每一幀都要建一張新圖,建圖就佔了將近一半的時間;離線版本一段 256 幀只要建 8 張圖。作者也承認線上的實作還有很大的最佳化空間。論文另外估了理想條件下的速度(oracle runtime), 時已經到 37 FPS。
在最擁擠的 MOT20-05(1,154 個人、61 萬個偵測框)上,離線版本仍有 74 FPS。在 DanceTrack 驗證集上,線上和離線()版本的顯示記憶體用量都不到 6 GB。
線上模型可訓練的參數只有 2.7 萬個,MeMOTR 有 5,100 萬個。NOOUGAT 只負責關聯,偵測交給現成的偵測器,所以在 MOT17 這種訓練資料很少的資料集上也不吃虧。
換到其他領域
作者另外在三個資料集上測試。蜜蜂追蹤的 BEE24,影片最長五千幀,NOOUGAT 的 HOTA 比次佳方法高 4.5。空拍車輛的 VETRA 一秒只有一幀,相鄰兩幀之間車子移動很遠,NOOUGAT 比 BoT-SORT 高了 17.2 HOTA,但仍落後專門為這個資料集設計、用了車速和車輛大小先驗的 Deep SR-SORT(82.2 對 68.0)。
在 MOT17 的公用偵測上,優勢則小了很多,離線版本的 IDF1 是 72.1,SUSHI 是 71.5。作者推測偵測框雜訊太多時,ALT 比較難學。
結論
NOOUGAT 做的事,是把 SUSHI 那套離線的圖網路,改造成可以接受任意延遲的追蹤器。影片切成不重疊的段,每段用圖網路處理,段與段之間再用另一層圖網路接起來。原本離線方法裡的縫接、線上方法裡的配對,都換成了學出來的關聯。
它的價值在於只要調 ,就能在延遲和準確度之間選一個點。等一幀,它是一個關聯分數領先的線上追蹤器;等兩百多幀,它是一個離線追蹤器;中間的每一個 ,也都是同一個模型。