原始論文
Learning a Neural Solver for Multiple Object Tracking
- 發表版本
- CVPR 2020會議
- arXiv 首次提交
- arXiv:1912.07515
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{multiobjecttrackingmpntrack2019,
  title = {{Learning a Neural Solver for Multiple Object Tracking}},
  author = {Guillem Brasó and Laura Leal-Taixé},
  year = {2019},
  eprint = {1912.07515},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1912.07515}
}
離線追蹤有一個很漂亮的老想法,把整段影片的偵測結果畫成一張圖。
每個偵測是一個節點,不同幀的兩個偵測之間連一條邊。如果兩個偵測屬於同一條軌跡、而且時間上前後相鄰,這條邊就是「啟用」的。追蹤就變成一個圖分割問題,找出哪些邊該啟用。
這套框架的標準作法分成兩步。先給每條邊算一個成本,表示兩個偵測是同一個人的可能性;再把成本丟進最佳化求解器,找出整體最好的分割。
到了 2019 年,這個方向的研究大致分成兩派。一派把功夫花在圖的形式上,設計越來越複雜的最佳化,納入高階關係,但成本多半還是手工設計的。另一派用孿生網路之類的深度模型學出更好的邊成本,再交給簡單的求解器,但成本只看兩兩配對,看不到整個場景。
慕尼黑工業大學的 Guillem Brasó 和 Laura Leal-Taixé 覺得兩條路都只走了一半。Leal-Taixé 是 MOT16 和 Tracktor 的作者之一。這次兩人想試試看,能不能讓網路連「解題」這一步也一起學。
定義問題
把追蹤寫成網路流
作者從經典的最小成本流(min-cost flow)出發,做了一點簡化。
給定一段影片的所有偵測 ,每個偵測 包含框內的影像、框的座標和時間戳。建一張無向圖,每個偵測是一個節點,任何兩個不同幀的偵測之間都連一條邊。允許跨幀連線,就能把中間漏偵測的軌跡接回來。
每條邊 有一個二元變數 。如果兩個節點屬於同一條軌跡、而且是軌跡上相鄰的兩個偵測,,否則為 0。
軌跡之間不能共用節點,所以 要滿足兩個條件。每個節點往過去最多連一條啟用的邊:
往未來也最多一條:
這是網路流守恆條件的簡化版。
傳統作法會給每條邊一個成本 ,求解
在上面兩組條件下,這個問題可以在多項式時間內解出最佳解。
直接預測答案
既然最後要的是 ,作者乾脆不學成本,直接學 。
每條邊是一個二元分類問題,標籤就是 。這樣整個追蹤問題變成一個可以端到端訓練的任務,特徵和「解法」都在同一個網路裡學。
剩下的問題是,一個只看兩個節點的分類器,學不到「這個人已經被別人連走了」這種全域的資訊。要讓每條邊的判斷考慮到整張圖,作者用的是訊息傳遞網路(Message Passing Network, MPN)。
解決問題
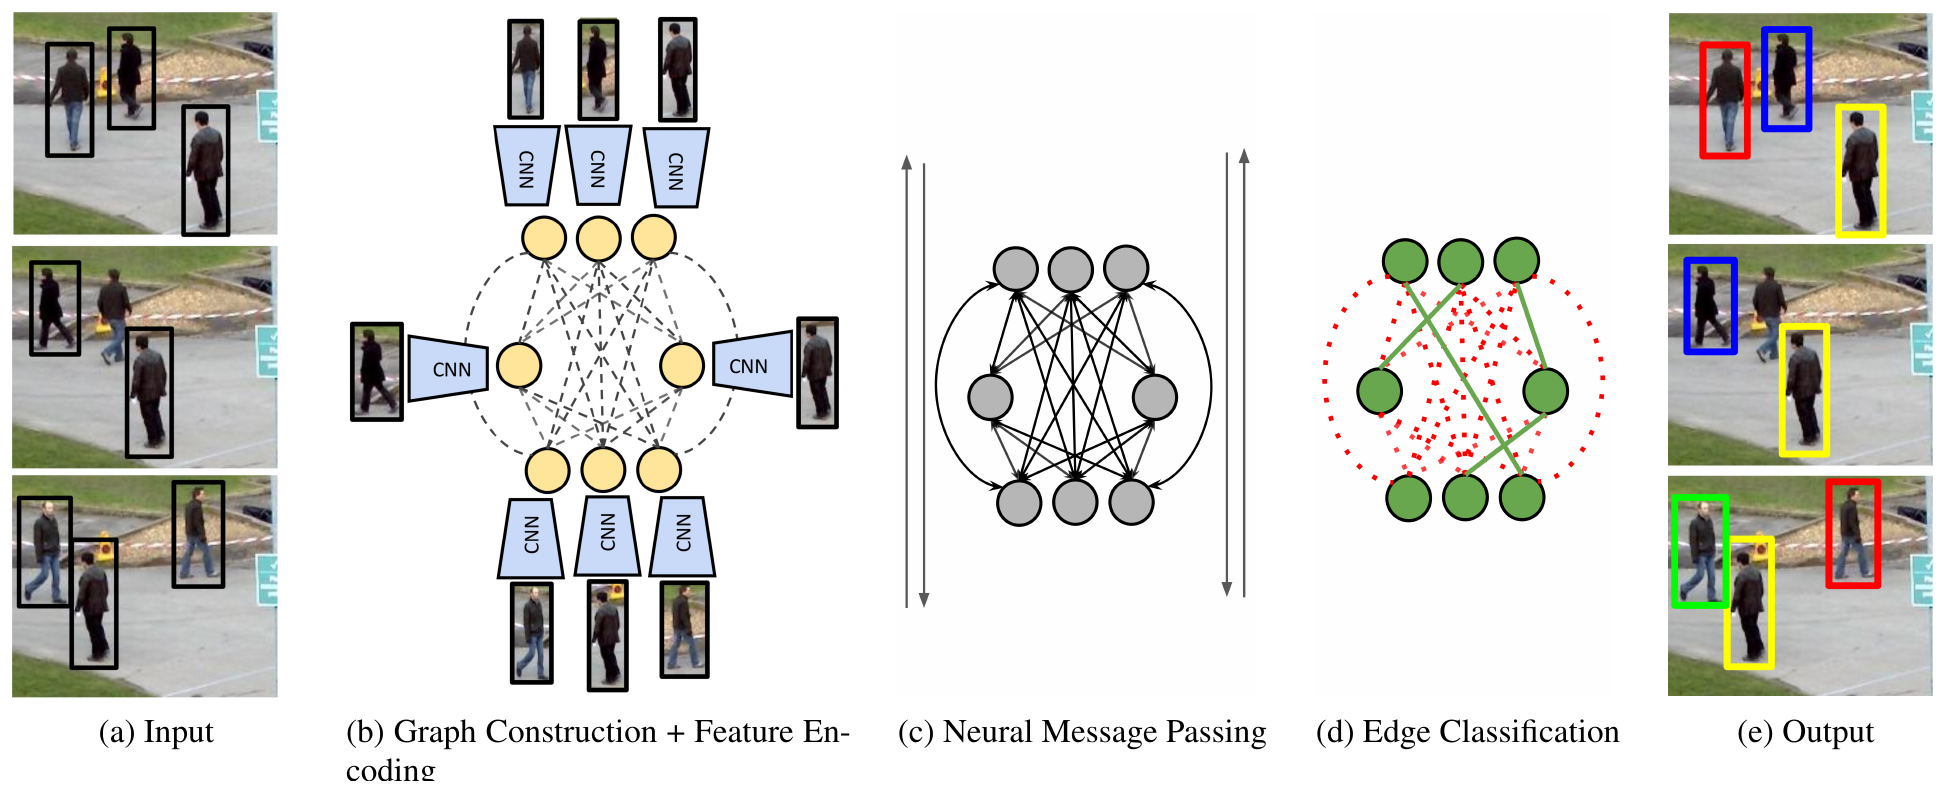
整個流程分成建圖、編碼特徵、訊息傳遞、邊分類四步。
初始特徵
節點的初始嵌入來自外觀。作者用 ImageNet 預訓練的 ResNet-50,在 Market-1501、CUHK03、DukeMTMC 三個行人重新辨識資料集上訓練,得到 256 維的 re-ID 特徵;之後再接三層全連接,把節點嵌入壓到 32 維。
邊的初始嵌入來自幾何關係。對兩個不同幀的偵測框 和 ,先算出相對位置和相對大小:
位移除以兩個框的平均高度,遠近不同的人可以用同一個尺度比較。再接上兩者的時間差 ,以及兩個 re-ID 特徵的歐氏距離,一起送進一個 MLP,得到邊的初始嵌入。
訊息傳遞
一般的訊息傳遞網路,每一步分兩個更新。先用兩端節點更新邊:
再用相連的邊更新節點。每條邊各產生一個訊息,把所有訊息加總(或取平均、最大值),得到新的節點嵌入。
這樣反覆 次之後,每個節點和邊都帶著距離 以內的資訊,作用類似 CNN 的感受野。原本只看兩個框的邊分類,現在能看到「這兩個節點周圍還有哪些候選」。
時間感知的節點更新
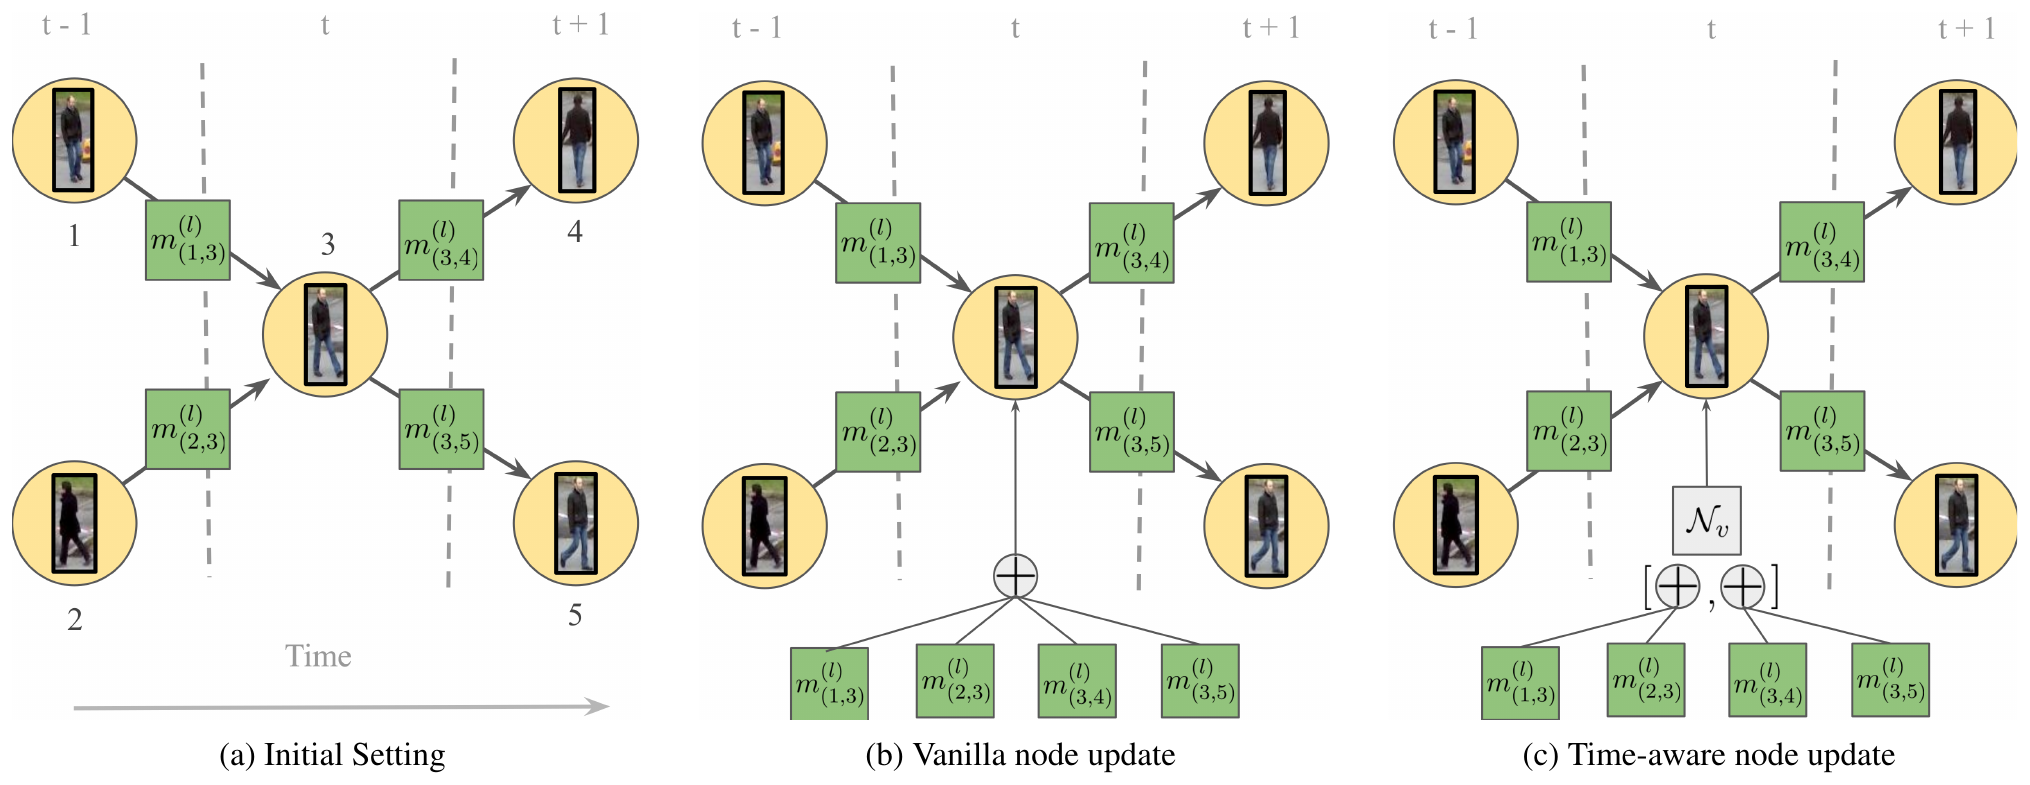
這篇在架構上最主要的改動,是節點更新。
回頭看網路流的條件,每個節點往過去最多連一條、往未來最多連一條。但一般的節點更新把所有鄰居的訊息混在一起加總,加完之後,節點根本分不出哪些訊息來自過去、哪些來自未來,也就很難判斷條件有沒有被違反。
作者把 MOT 圖的時間結構直接寫進更新規則。對節點 ,過去和未來的鄰居用兩個不同的 MLP 計算訊息。過去的鄰居 用的是
未來的鄰居則用 。兩邊分別加總成 和 ,串接後送進最後一個 MLP:
公式裡的 是初始嵌入,一路接到每一步,讓網路傳了很多次之後也不會忘記原本的特徵。邊的更新也同樣接上初始的邊特徵。
訓練與推論
邊分類器是一個輸出單一 sigmoid 值的 MLP。從第 步到最後一步 ,每一步的邊嵌入都拿來預測,一起算加權的二元交叉熵:
其中每條邊在第 步的損失是
啟用的邊遠比未啟用的少,正樣本另外乘上權重 。
推論時,直接把最後一步的預測值當成 的答案,以 0.5 為門檻二值化。網路沒有被強制滿足網路流的條件,所以門檻之後可能出現一個節點連出兩條邊的情況。作者準備了兩種修正方式,一是貪婪地只保留分數最高的那一條,二是用線性規劃求精確的最佳捨入。實際上違反條件的邊很少,兩種方法幾乎沒差別,貪婪法的 IDF1 只低 0.2。
實作細節
這裡有幾個實際跑起來時很重要的設定:
- CNN 凍結。 作者發現連 ResNet 一起訓練,效果沒有明顯提升,計算量卻大很多,所以卷積層全部凍結,只訓練後面的 MLP。
- 滑動視窗。 影片切成 15 幀一段的圖,相鄰兩段重疊 14 幀;重疊的邊取各段預測的平均。靜態鏡頭以每秒 6 幀取樣,移動鏡頭每秒 9 幀,所以每張圖只涵蓋大約一秒半到兩秒多的影片。
- 剪枝。 不同幀的節點全連會讓邊數爆炸,所以只有在兩個節點互為 re-ID 特徵最近的前 50 名時,才連邊。
- 用 Tracktor 前處理。 公開偵測先跑一次 Tracktor,丟掉它給的 ID,只拿修正後的框當作輸入。Tracktor 的框比較準,也會在相鄰幀補上一些漏掉的偵測。輸出軌跡中間缺的幀,先拿 Tracktor 的軌跡補,剩下的再用內插補齊。
最後一點值得注意。MPNTrack 自己的網路每秒能跑 35 幀,但前面的 Tracktor 只有每秒 8 幀,整個系統平均是每秒 6.5 幀。
討論
消融實驗都在 MOT17 訓練集上,以三折交叉驗證進行。
時間感知的更新
| 節點更新 | MOTA ↑ | IDF1 ↑ | ID 切換 ↓ | 條件滿足率 ↑ |
|---|---|---|---|---|
| 一般 | 63.0 | 67.3 | 1,022 | 82.1% |
| 時間感知 | 64.0 | 70.0 | 602 | 98.8% |
整理自原論文 Table 1。條件滿足率是門檻 0.5 下,網路流守恆條件被滿足的平均比例。
把過去和未來分開,IDF1 多了將近 3 分,ID 切換從 1,022 降到 602。
更有意思的是最後一欄。一般的 MPN 直接二值化後,只有 82.1% 的條件被滿足;時間感知的版本是 98.8%。網路幾乎自己學會了「每個人往前往後各只能連一個」這條規則,不需要外加的求解器去強制。
傳幾步
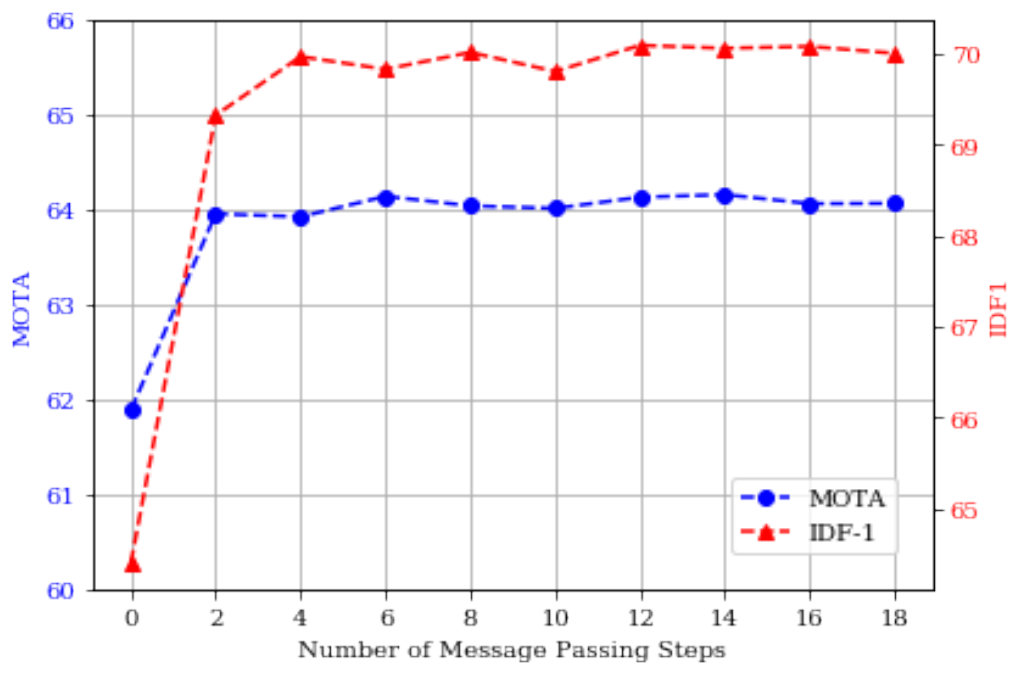
0 步就是不傳訊息,只用初始的邊嵌入做二元分類,等於傳統「學兩兩成本」的作法。
從 0 步到 2 步,MOTA 和 IDF1 都大幅跳升,這是從兩兩關係進到高階關係的那一步。之後上升趨勢大約在 6 步停住,12 步之後就沒有再改善。最終設定用 。
特徵來源
| 邊特徵 | MOTA ↑ | IDF1 ↑ | FP ↓ | ID 切換 ↓ |
|---|---|---|---|---|
| 只有時間差 | 58.8 | 52.6 | 13,127 | 2,962 |
| 時間差 + 位置 | 63.6 | 68.7 | 6,308 | 895 |
| 時間差 + 位置 + 外觀 | 64.0 | 70.0 | 6,169 | 602 |
整理自原論文 Table 2。
這張表有點出人意料。加上相對位置之後,IDF1 從 52.6 跳到 68.7,是最大的一步;外觀特徵再加上去,IDF1 只多 1.3。但外觀把 ID 切換從 895 再壓到 602,還是值得保留。
在這個框架下,位置比外觀重要得多。論文沒有進一步分析原因,一個可能的解釋是,節點本身已經帶著外觀嵌入,訊息傳遞時邊也拿得到,邊上再放一個外觀距離,資訊有一部分是重複的。
和其他方法比
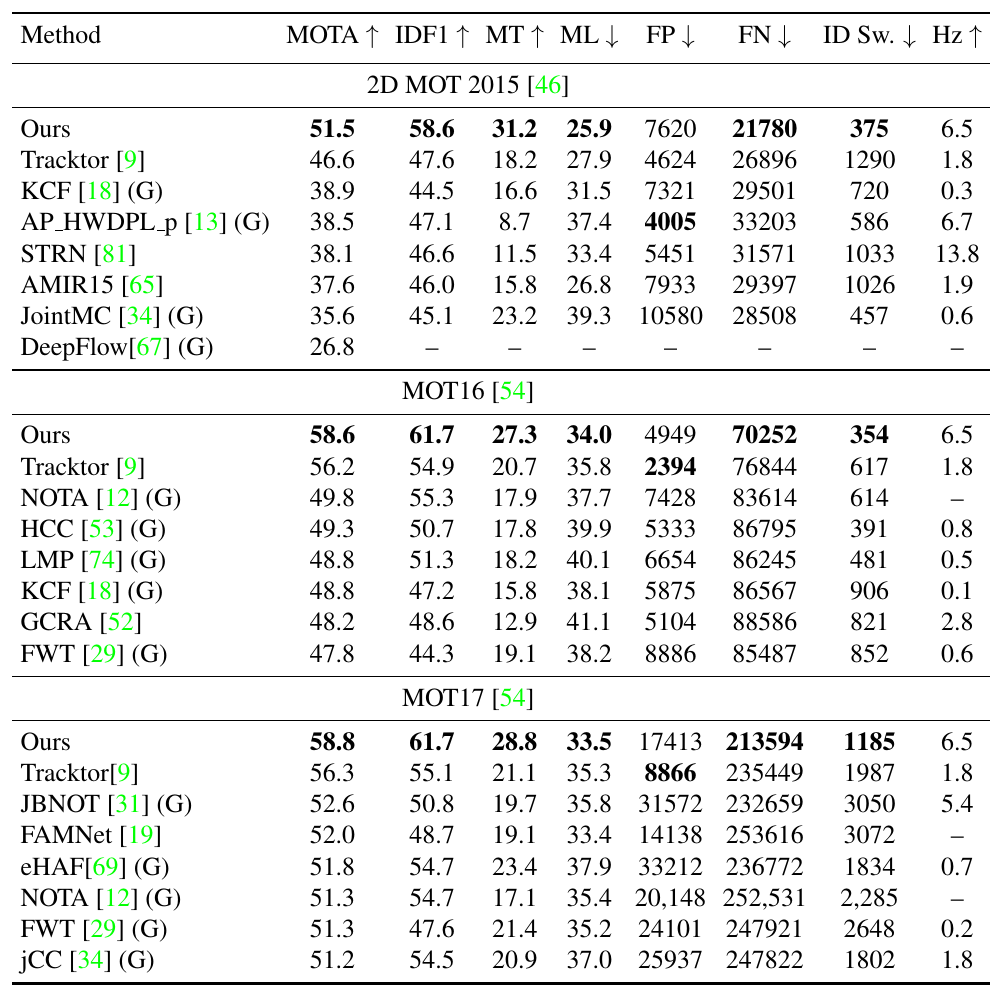
三個基準都使用公開偵測。MPNTrack 在三個資料集上都是第一,IDF1 比先前最好的結果分別高出 11、6.4、6.6 分。和其他圖分割方法比,它不但準得多,還比其中一些快上一個數量級,例如 JointMC 只有 0.6 Hz。
但 Tracktor 的前處理在這裡幫了不少忙。附錄裡,作者另外報告了不用 Tracktor、改用 Faster R-CNN 的迴歸頭修正公開偵測的版本:
| 資料集 | MOTA(有 Tracktor) | MOTA(無) | IDF1(有 Tracktor) | IDF1(無) |
|---|---|---|---|---|
| MOT15 | 51.5 | 46.6 | 58.6 | 53.8 |
| MOT16 | 58.6 | 54.3 | 61.7 | 56.8 |
| MOT17 | 58.8 | 56.0 | 61.7 | 58.4 |
整理自原論文附錄 Table 7。
拿掉 Tracktor,MOTA 掉了 2.8 到 4.9 分,IDF1 掉了 3.3 到 4.9 分。但即使如此,它還是贏過表上其他的圖方法,而那些方法有不少用了沒做非極大值抑制的原始偵測、低階影像特徵或階層式的設計,拿到的資訊比它多。
限制
MPNTrack 是離線方法,每張圖要看到未來的幀才能做決定,沒辦法直接搬到即時系統上。
時間視窗也很短。一張圖只涵蓋兩秒左右,被長時間遮擋的人,就算走回畫面,也不在同一張圖裡,接不回來。邊數隨節點數平方成長,視窗要拉長,剪枝就得更狠。
同一個實驗室後來在 2023 年的 SUSHI 裡把圖疊成多層,下層處理短時間的連結,上層把短軌跡再接成長軌跡,處理的就是這個視窗太短的問題。
結論
在這篇之前,學習在多目標追蹤裡主要用來學特徵和成本,真正決定軌跡的還是傳統的最佳化求解器。MPNTrack 把網路流的二元變數直接當成分類標籤,用訊息傳遞讓每條邊看見整張圖,讓網路自己學出接近可行的解。
時間感知的更新是個不起眼的小改動,只是把過去和未來分開加總,卻讓網路幾乎自己學會了守恆條件。
論文標題說要學一個求解器,網路也確實學到了 98.8%。剩下那 1.2%,最後還是得交給捨入規則收尾,一個貪婪迴圈就夠了。