原始論文
HOTA: A Higher Order Metric for Evaluating Multi-Object Tracking
- arXiv 首次提交
- arXiv:2009.07736
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{multiobjecttrackinghota2020,
  title = {{HOTA: A Higher Order Metric for Evaluating Multi-Object Tracking}},
  author = {Jonathon Luiten and Aljosa Osep and Patrick Dendorfer and Philip Torr and Andreas Geiger and Laura Leal-Taixe and Bastian Leibe},
  year = {2020},
  eprint = {2009.07736},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2009.07736}
}
讀了幾篇追蹤論文,你大概已經對 MOTA 這個數字很熟了。SORT 用它,DeepSORT 用它,Tracktor 和 FairMOT 的主表第一欄也是它。
但我們在 DeepSORT 那篇看過,ID 切換少了 45%,MOTA 只多了 1.6 分。FairMOT 也做過一個實驗:只訓練偵測、re-ID 特徵幾乎是隨機的模型,MOTA 居然比兩個任務一起訓練的還高。
一個號稱衡量「追蹤」的指標,好像對「追得對不對人」不太敏感。
這篇論文來自 RWTH Aachen、慕尼黑工業大學、牛津和圖賓根,作者群裡有 MOTChallenge 的維護者,也有 KITTI 的建立者 Andreas Geiger。他們把 MOTA、IDF1 和 Track-mAP 逐一拆開檢查,然後提出新的指標 HOTA(Higher Order Tracking Accuracy)。這篇論文影響之大,看看後面幾篇筆記的主表就知道:HOTA 成了 ByteTrack、OC-SORT 這一代論文的主要指標。
定義問題
多目標追蹤要做對三件事:
- 偵測:每一幀找到該找的物體,不多也不少。
- 定位:框要準。
- 關聯:同一個物體在不同時間要拿到同一個 ID,不同物體不能共用 ID。
一個好的指標應該同時反映這三件事,而且讓它們的權重合理。作者先檢查當時最常用的兩個指標。
MOTA
MOTA 在每一幀把預測框和真實框做一對一配對(IoU 至少 0.5),配上的是真陽性(TP),多出來的預測是誤報(FP),沒配到的真實框是漏檢(FN)。關聯錯誤則用 ID 切換(IDSW)計算:某個真實物體這一次配到的預測 ID,和它上一次配到的不同,就記一次。
分母是所有真實框的數量。
IDF1
IDF1 不在每一幀配對,而是把整條預測軌跡和整條真實軌跡做一對一配對,挑出讓重疊最多的組合。配上的軌跡在重疊的部分算 IDTP,其他所有的真實框算 IDFN,其他所有的預測框算 IDFP:
同一個人,兩種追法
我們用原論文第一張圖的例子算一次。
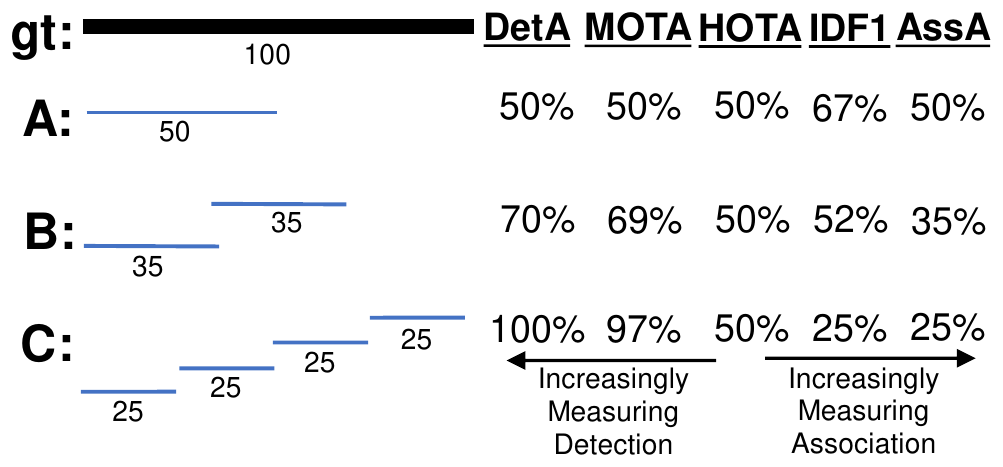
畫面裡只有一個人,出現 100 幀。看 A 和 C 這兩個追蹤器:
- A 追到前 50 幀,從頭到尾同一個 ID,後 50 幀完全沒追到。
- C 每一幀都追到了,但每 25 幀就換一次 ID,總共四個 ID。
哪一個比較好?
先算 MOTA。A 有 50 個漏檢,沒有誤報,沒有 ID 切換,。C 沒有漏檢、沒有誤報,ID 切換 3 次,。
MOTA 認為 C 好得多。換了三次 ID,只扣 3 分。
再算 IDF1。A 的唯一一條軌跡配上真實軌跡,IDTP = 50,IDFN = 50,IDFP = 0,IDF1 = 。C 只能挑一段 25 幀的軌跡配對,IDTP = 25,其他 75 個真實框都是 IDFN,另外三段軌跡的 75 個預測框都是 IDFP,IDF1 = 。
IDF1 認為 A 好得多。C 每一幀都追到了,這件事幾乎沒有被計入。
兩個指標各站一邊,而且都站得很極端。
解決問題
HOTA 的目標是在一個分數裡,公平地衡量偵測、關聯和定位,同時可以拆開來,看出錯誤來自哪裡。
先像 MOTA 一樣,在每一幀配對
HOTA 的配對和 MOTA 一樣,在每一幀把預測框和真實框做一對一配對,定位相似度 (例如 IoU)至少要達到門檻 。配上的是 TP,剩下的是 FP 和 FN。
偵測的分數就是標準的 Jaccard 指數:
再對每一個 TP,問它的軌跡對得多準
關聯的部分是這篇論文的新東西。對每一個配上的 TP,記為 ,作者定義了三個集合:
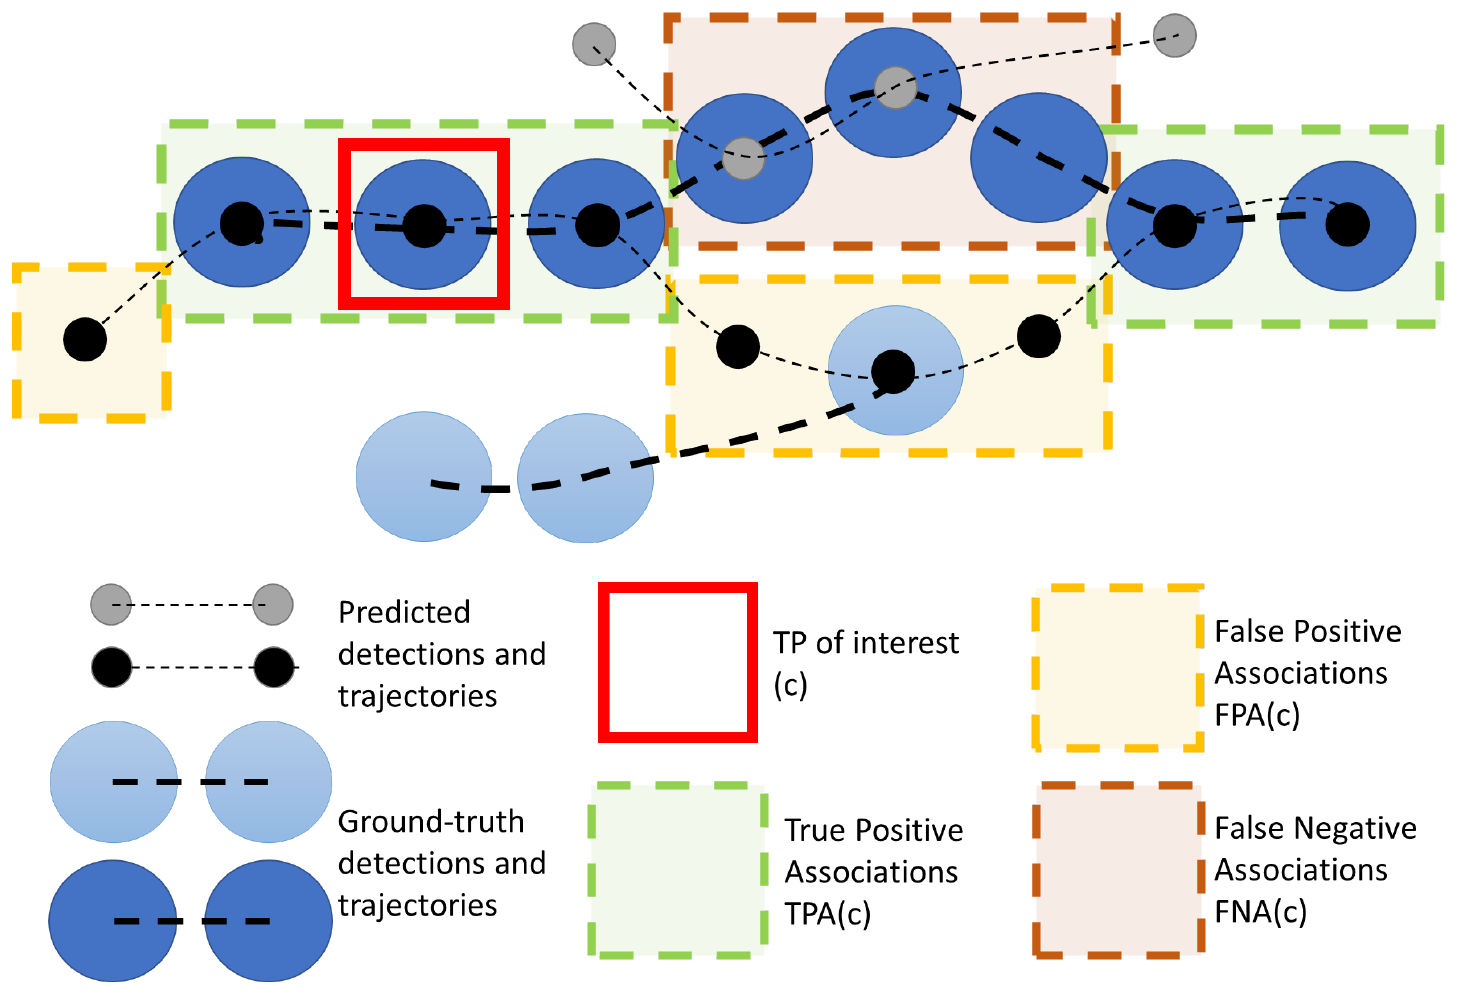
- TPA(True Positive Associations): 和 有相同真實 ID、也有相同預測 ID 的 TP。也就是「同一個人、被追蹤器當成同一個人」的時刻。
- FNA(False Negative Associations): 和 有相同真實 ID,但被給了別的預測 ID、或根本沒被偵測到的真實框。同一個人,追蹤器卻沒認出來。
- FPA(False Positive Associations): 和 有相同預測 ID,但其實屬於別人、或根本不對應任何物體的預測框。追蹤器以為是同一個人,其實不是。
圖中的 有五個 TPA、四個 FPA、三個 FNA。它的關聯分數,又是一個 Jaccard 指數:
代入圖中的數字:
把所有 TP 的關聯分數平均起來,就是關聯準確度:
兩個分數,取幾何平均
作者稱這是「雙重 Jaccard」。外層是偵測的 Jaccard,但分子裡每個 TP 不是算 1,而是乘上自己的關聯分數。
回到剛才的例子。
A 的 DetA 是 。每一個 TP 的 TPA 都是 50,FNA 是後面沒追到的 50 個真實框,FPA 是 0,關聯分數都是 ,AssA 也是 50%。HOTA 。
C 的 DetA 是 100%。每一個 TP 所在的那段軌跡只有 25 幀,TPA 是 25,同一個人的其他 75 幀被給了別的 ID,都是 FNA,關聯分數都是 25%,AssA 也是 25%。HOTA 。
兩個追蹤器打平。A 只追到一半但認得很準,C 全追到了但一直換 ID。HOTA 不偏袒任何一邊,各打五十大板。
最後,把定位也算進去
上面的計算都在固定的定位門檻 下進行。為了把框準不準也算進來,HOTA 在 這 19 個門檻下各算一次,再取平均:
每個門檻都要重新做一次配對。框越準,在高門檻下還能配上的 TP 就越多,最後的分數也越高。
作者特別提醒,DetA 和 AssA 要在每個 下先合成 ,再對 平均,順序不能倒過來。所以論文表格裡的 HOTA,一般不會剛好等於表格裡 DetA 和 AssA 的幾何平均。
拆開來看
HOTA 可以一路拆成五個子指標,各自對應一種錯誤:
- DetRe :漏檢。
- DetPr :誤報。
- AssRe:把 中的 FPA 拿掉後的平均。一個人被切成好幾段軌跡,AssRe 就低。
- AssPr:把 中的 FNA 拿掉後的平均。一條軌跡跨到好幾個人身上,AssPr 就低。
- LocA:所有 TP 的平均定位相似度,同樣對各個 取平均。
這組拆解讓使用者可以依應用挑重點。作者舉例,人體動作分析、人群分析或運動賽事分析在乎身分有沒有一路追對,AssRe 和 AssPr 比較重要;駕駛輔助系統必須找到每一個行人,也不能因為不存在的人緊急閃避,DetRe 和 DetPr 比較重要;監視場景則通常寧可多報、不可漏報。
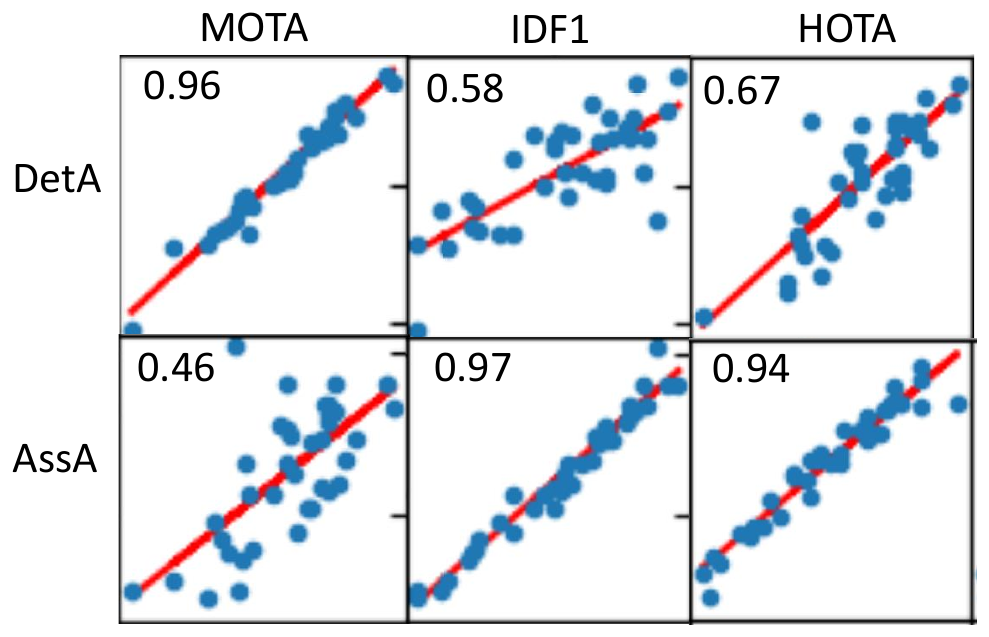
這張圖把三個指標放在 MOT17 上,和 DetA、AssA 對照。MOTA 幾乎只跟著偵測走(),和關聯的關係很弱(0.46);IDF1 正好相反(0.58 和 0.97);HOTA 和兩者都有明顯的關係(0.67 和 0.94)。
HOTA 和 AssA 的關係比較強,並不是因為關聯的權重比較大,兩者的權重是相等的。原因在於這些追蹤器用的都是同一組公用偵測,偵測分數差不多,彼此的差距主要來自關聯。
討論
MOTA 的九個問題
作者列了 MOTA 的九個問題。幾個最有說服力的如下:
- 偵測的影響遠大於關聯。 在 2020 年 4 月 1 日 MOT17 排行榜前十名中,FN + FP 和 IDSW 的數量比介於 42.3 到 186.4,平均 98.6。作者另外拿 175 個追蹤器做線性迴歸:只看偵測的 MODA(MOTA 去掉 IDSW 那一項)可以解釋 MOTA 99.4% 的變異,IDSW 只能解釋 23.7%。
- 精確率的影響遠大於召回率。 拿掉 IDSW 之後,MOTA 可以改寫成 :對召回率是線性的,對精確率卻是雙曲線。精確率差一點,分數掉得比召回率差一點多很多。這會鼓勵大家調高偵測門檻,寧可漏報,不要誤報。
- IDSW 只看前一步。 一次 ID 切換,只檢查這一次的 ID 和上一次是否相同,看不到整條軌跡的對齊程度。追蹤器犯錯後自己改回來,MOTA 會把「改回來」也算成一次 IDSW,等於罰了兩次。
- 不罰 ID 轉移。 一條預測軌跡從 A 跳到 B 身上,只要 A 和 B 各自沒有換 ID,就不算 IDSW。論文的例子是一段只有兩幀的影片:一個人被切成兩條軌跡,MOTA 是 0.5;兩個不同的人被併成一條軌跡,MOTA 是滿分 1.0。
- 和幀率有關。 同一段 2.5 秒的軌跡,中間換一次 ID。用 40 FPS 評估,分母有 100 個框,MOTA 是 0.99;用 4 FPS 評估,分母只有 10 個框,MOTA 是 0.90。HOTA 兩者都是 。
- 沒有下限。 誤報可以無限增加,MOTA 可以一路跌到負無限大。看到一個負的 MOTA,很難說清楚它代表什麼。
IDF1 的問題
IDF1 原本是為多相機追蹤設計的。它的核心問題在於只允許一組最佳的軌跡配對。沒被選中的軌跡,不管它追得多好,裡面的每一個正確偵測都算成 IDFP,反而讓分數下降。所以 IDF1 對偵測不是單調的:偵測做得更好,分數可能變差。
這也解釋了為什麼許多新的基準仍然選擇 MOTA。偵測是追蹤很重要的一部分,而 IDF1 衡量不好它。
為什麼是 Jaccard、為什麼要開根號
論文第 7 節檢查了好幾個設計選擇。
- Jaccard 而不是 F1 或 MODA。 作者用一個例子證明,只有 Jaccard 形式能保證單調性:多一個正確偵測,分數一定上升;把預測和真實互換,結果也一樣。F1 在某些長度比例下會把較差的結果排得比較高,MODA 則不對稱。
- 開根號的三個作用。 一是讓 HOTA 的數值範圍接近大家熟悉的 MOTA 與 IDF1;二是讓 HOTA 成為偵測與關聯的幾何平均,任何一邊趨近於零,總分就趨近於零;三是抵銷重複計算。關聯分數裡本來就包含了配上軌跡中的 FN 和 FP,若不開根號,這些錯誤會被罰兩次。只有一個物體的單目標追蹤情況下,DetA 和 AssA 會完全相同,開根號後 HOTA 剛好等於一個 Jaccard 指數。
- DetA 不能省。 沒有配上任何軌跡的 FN 和 FP 不會出現在 AssA 裡,需要 DetA 來懲罰;而且只看 AssA 不是單調的:加進一個關聯很差的 TP,平均值會下降。
人怎麼看
最後,作者做了一個使用者研究。他們把 MOT17 的七段測試影片切成 36 段 6 秒的片段,挑出兩個指標意見相反的追蹤器配對,讓受試者看兩段追蹤結果,選出比較好的那個。
共有 230 人參與,其中 62 人是多目標追蹤研究者,122 人是電腦視覺研究者,總計比較了 2075 組,平均每組花 2 分 13 秒。
不計兩者打平的票,HOTA 對上 MOTA 時,受試者有 61.6% 站在 HOTA 這邊;HOTA 對上 IDF1 時,比例是 72.0%;MOTA 對上 IDF1 則大約五五波。只看多目標追蹤研究者,HOTA 對 MOTA 的勝率升到 79.3%,對 IDF1 升到 85.9%。
後來
HOTA 很快被採用。KITTI 的追蹤排行榜在 2021 年 2 月改以 HOTA 排名,評估程式來自作者維護的 TrackEval;DanceTrack 等新基準也以 HOTA 為主要指標。後面讀到的 ByteTrack、OC-SORT、StrongSORT、BoT-SORT,主表都把 HOTA、MOTA、IDF1 並列。
也有人覺得 HOTA 還不是最終答案。2021 年,Google Research 的 Jack Valmadre 和 Alex Bewley(對,就是 SORT 的作者)等人提出時間上局部的追蹤指標 ALTA。他們認為,很多應用能容忍一定程度的關聯錯誤,偵測與關聯的相對重要性應該可以調整,於是用時間窗的長度當作調整的旋鈕。HOTA 把兩者固定成五五開,是一種選擇,但不是唯一的選擇。
結論
每一幀先配對,每一個配上的框再用整條軌跡衡量關聯有多準,最後把偵測和關聯取幾何平均,並對 19 個定位門檻平均,這就是 HOTA。它能拆成偵測召回、偵測精確、關聯召回、關聯精確和定位五個子指標。
之後讀追蹤論文的表格,別只看 HOTA 一欄,順手看一下 DetA 和 AssA。一個方法的 HOTA 進步了,到底是偵測器換好了,還是關聯真的變強了,這兩欄一眼就看得出來。
MOTA 說換三次 ID 只要扣三分,IDF1 說全程追到也不算什麼。
HOTA 說,你們兩個都對,也都不對。