原始論文
Simple Online and Realtime Tracking with a Deep Association Metric
- 發表版本
- ICIP 2017會議
- arXiv 首次提交
- arXiv:1703.07402
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{multiobjecttrackingdeepsort2017,
  title = {{Simple Online and Realtime Tracking with a Deep Association Metric}},
  author = {Nicolai Wojke and Alex Bewley and Dietrich Paulus},
  year = {2017},
  eprint = {1703.07402},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1703.07402}
}
SORT 把追蹤器剃到只剩卡爾曼濾波、IoU 和匈牙利演算法,速度飛快,MOTA 也不差。但它的 ID 切換次數一直很難看。
原因不難猜。SORT 只認框的位置和大小,物體被擋住兩幀,軌跡就被刪掉;等它再出現,追蹤器沒有任何線索知道「這個人剛才見過」,只好發一個新 ID。
一年後,SORT 的作者 Alex Bewley 和德國科布倫茨-蘭道大學的 Nicolai Wojke、Dietrich Paulus 一起補上這塊。補的方式很直接,讓追蹤器記住每個人長什麼樣子。
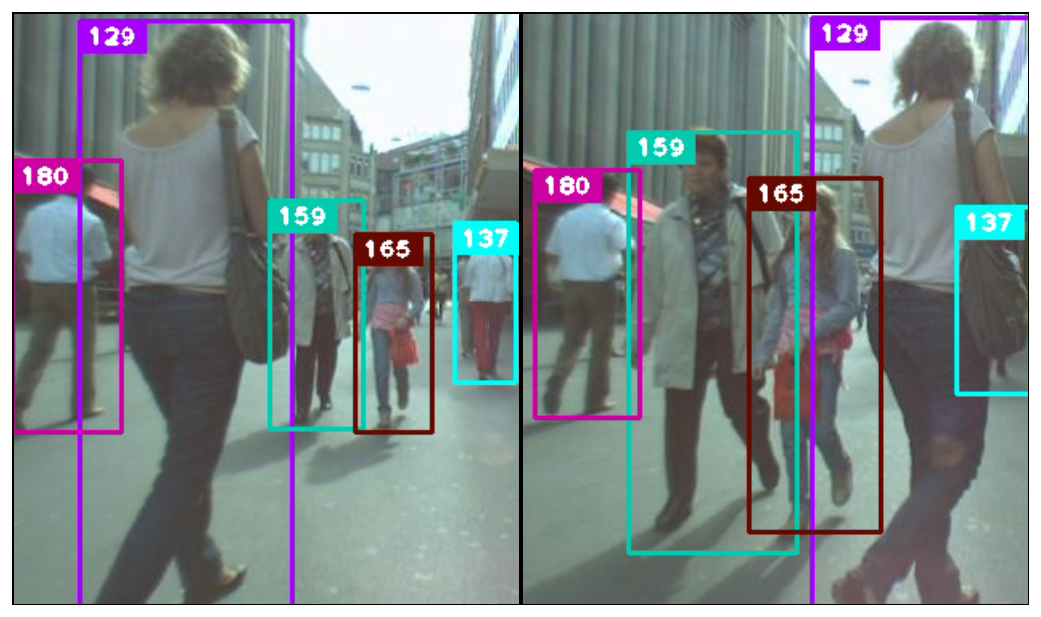
這是 DeepSORT 在 MOT16 上的輸出。兩張圖之間,人群互相交錯,前景的 129 從畫面中間走到右邊,擋住了後面的 137;遠處的 159 和 165 走近之後,框大了好幾倍。五個人的編號都沒變。
這篇只有五頁,卻成了後來好幾年最常被拿來用的追蹤器,名字裡的「Deep」也常被誤會。我們慢慢看。
定義問題
作者先替 SORT 的 ID 切換找出原因。SORT 用預測框與偵測框的 IoU 做配對,這個度量只有在狀態估計很準的時候才可靠。
一旦物體被擋住,卡爾曼濾波只能一直預測,不能更新,預測框越漂越遠,和重新出現的偵測框重疊不起來。正面視角的街景裡,行人互相遮擋是常態,SORT 因此不斷斷線、重發 ID。
要解決這件事,需要一種在位置不可靠的時候仍然能用的線索。作者選了外觀。他們用一個在大型行人重新辨識(person re-identification, re-ID)資料集上訓練好的卷積網路,把每個偵測框轉成一個特徵向量。同一個人在不同時間的特徵應該接近,不同人的特徵應該遠離。
設計上延續 SORT 的精神,把複雜的部分放到離線階段。網路事先訓練好,上線追蹤時只做最近鄰查詢,不做任何線上學習。
解決問題
狀態與軌跡管理
卡爾曼濾波的框架大致沿用 SORT,但狀態換成八維:
是框中心, 是寬高比, 是高度,後四項是對應的速度。和 SORT 相比,面積換成了高度,寬高比也有了自己的速度。偵測框的 直接當成觀測。
每條軌跡 記錄一個計數器 ,表示距離上次成功配對已經過了幾幀。預測時加一,配對成功時歸零。超過上限 就認定物體離開畫面,把軌跡刪掉。
新軌跡的前三幀是「試用期」(tentative)。這三幀每一幀都必須配對成功,否則直接刪除;撐過三幀才轉為確認(confirmed)狀態。
SORT 的 是 1,這裡的 在實驗中設為 30。軌跡可以撐過整整一秒的消失,前提是回來的時候認得出來。
兩種距離
配對仍然是一個指派問題,但成本矩陣換成兩種距離的組合。
第一種是馬氏距離(Mahalanobis distance),描述運動:
是第 條軌跡的預測分布投影到觀測空間後的平均和共變異數, 是第 個偵測框。和 IoU 不同,馬氏距離會考慮不確定性:它量的是偵測框距離預測中心「幾個標準差」。
這個距離可以用來排除不可能的配對。觀測空間是四維,馬氏距離平方服從自由度 4 的卡方分布,取 95% 信賴區間的門檻 ,超過就不准配對。
第二種是外觀距離。每個偵測框經過網路得到一個單位長度的特徵 ,每條軌跡保留最近 100 次配對成功時的特徵,組成一個圖庫 。外觀距離取偵測特徵和圖庫裡最像的那一個之間的餘弦距離:
取最小值的好處是,人轉身、走進陰影,只要圖庫裡有一張角度相近的特徵,就認得出來。外觀距離也有自己的門檻 ,由另外的訓練資料決定;官方程式預設 0.2。
兩者合成最終的成本:
而一個配對要同時通過兩個門檻,才算可行。
作者對兩者的分工說得很清楚。馬氏距離適合短期預測,物體剛被看見、位置很確定時最有用;外觀距離適合長時間遮擋後找回身分,那時候運動資訊已經沒什麼鑑別力。
然後是一個常被忽略的細節。在實驗中,作者把 設為 0。
也就是說,成本矩陣裡只剩外觀距離,馬氏距離只負責門檻,把位置上不可能的配對擋掉。作者的理由是,相機明顯移動時,影像平面上的位移變化很大,卡爾曼濾波的預測只是粗略估計。許多教學把 DeepSORT 描述成「位置和外觀加權相加」,但論文實際跑分用的是「外觀排序、運動把關」。
匹配級聯
作者沒有把所有軌跡和偵測框丟進同一個指派問題,而是設計了一個級聯(matching cascade)。
為什麼要這樣做?問題出在馬氏距離本身。我們用一維的數字算一次(數字是為了說明而設的)。
假設軌跡 A 上一幀才看到,預測位置在 100,標準差 5;軌跡 B 已經被擋住十幾幀,預測位置在 120,但因為一直沒有更新,標準差膨脹到 30。現在有一個偵測框出現在 108。
- 對 A 來說,偵測框差了 8,是 個標準差,馬氏距離平方是 2.56。
- 對 B 來說,偵測框差了 12,只有 個標準差,馬氏距離平方是 0.16。
距離較近、狀態也較確定的 A 反而輸了。
直覺上,一條軌跡越久沒被看見,我們應該越不確定它和任何偵測框有關,距離應該變大才對。但馬氏距離用標準差當單位,不確定性越大,任何偵測框看起來都越「近」。兩條軌跡搶同一個框時,它會偏袒那條最不確定的。
級聯的作法是按「多久沒被看見」分層處理:
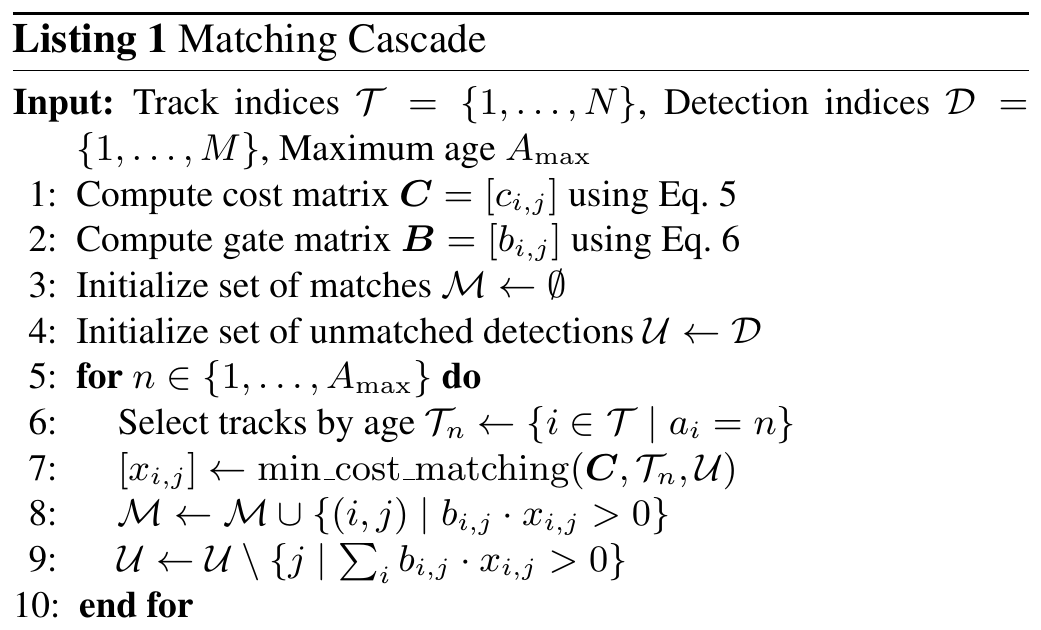
第 5 行的迴圈從 開始,先處理上一幀才配對成功的軌跡,讓它們先挑偵測框;剩下的偵測框再交給 的軌跡,依此類推,直到 。剛才的例子裡,A 會在第一層就拿走偵測框,B 根本輪不到。
級聯結束後還有最後一步。把試用期中的軌跡,以及年齡 但沒配上的軌跡,拿去和剩下的偵測框做一次 SORT 式的 IoU 配對。這一步用來應付外觀突然改變的情況,例如被靜止的物體擋住半身,也讓剛建立、外觀圖庫還很少的軌跡有機會延續。
外觀網路
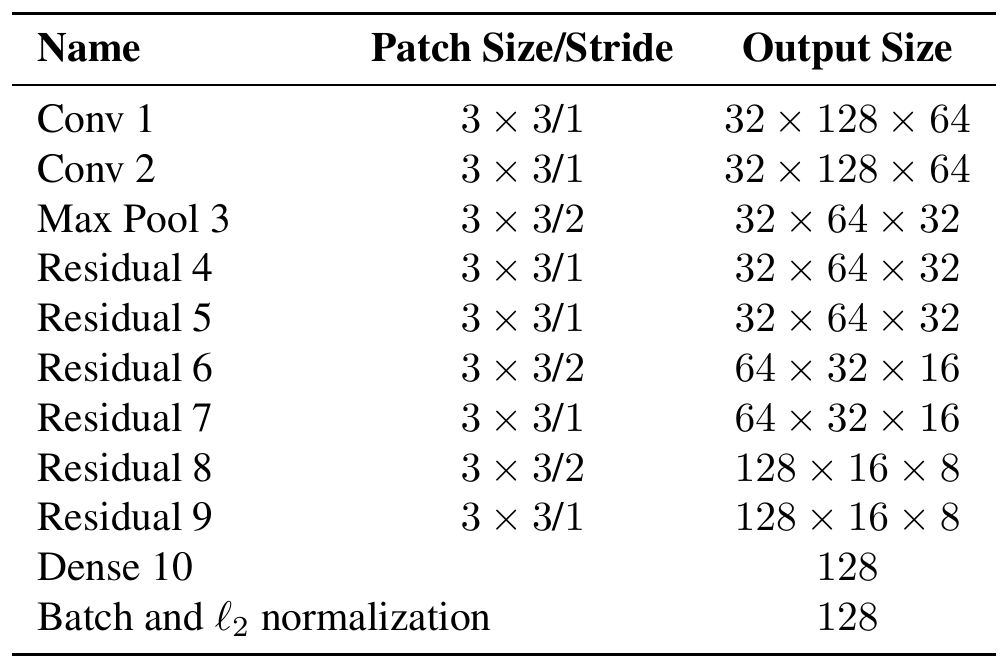
網路是一個寬殘差網路,有兩層卷積、六個殘差區塊,最後一層全連接輸出 128 維。結尾的批次正規化和 L2 正規化把特徵投影到單位球面上,這樣兩個特徵的內積就是餘弦相似度,正好對上前面的外觀距離。
整個網路約 280 萬個參數,在一張 GTX 1050 筆電 GPU 上,一次處理 32 個框大約 30 毫秒。訓練資料是 MARS 行人重新辨識資料集,超過 110 萬張影像、1,261 個人。
訓練細節論文沒寫,作者說超出範圍。官方程式的說明則指向他們隔年另一篇論文的 cosine metric learning 方法。
討論
作者在 MOT16 測試集上評估。MOT16 有七段測試影片,包含移動相機的正面街景,也有俯視的監視器畫面。
偵測結果用的是 Yu 等人(POI 這個方法的作者)公開的 Faster R-CNN 偵測,它用公開與私有資料訓練,品質遠高於官方提供的公用偵測。為了公平,作者用同一組偵測重跑了 SORT。設定是 、,偵測信心分數門檻 0.3。
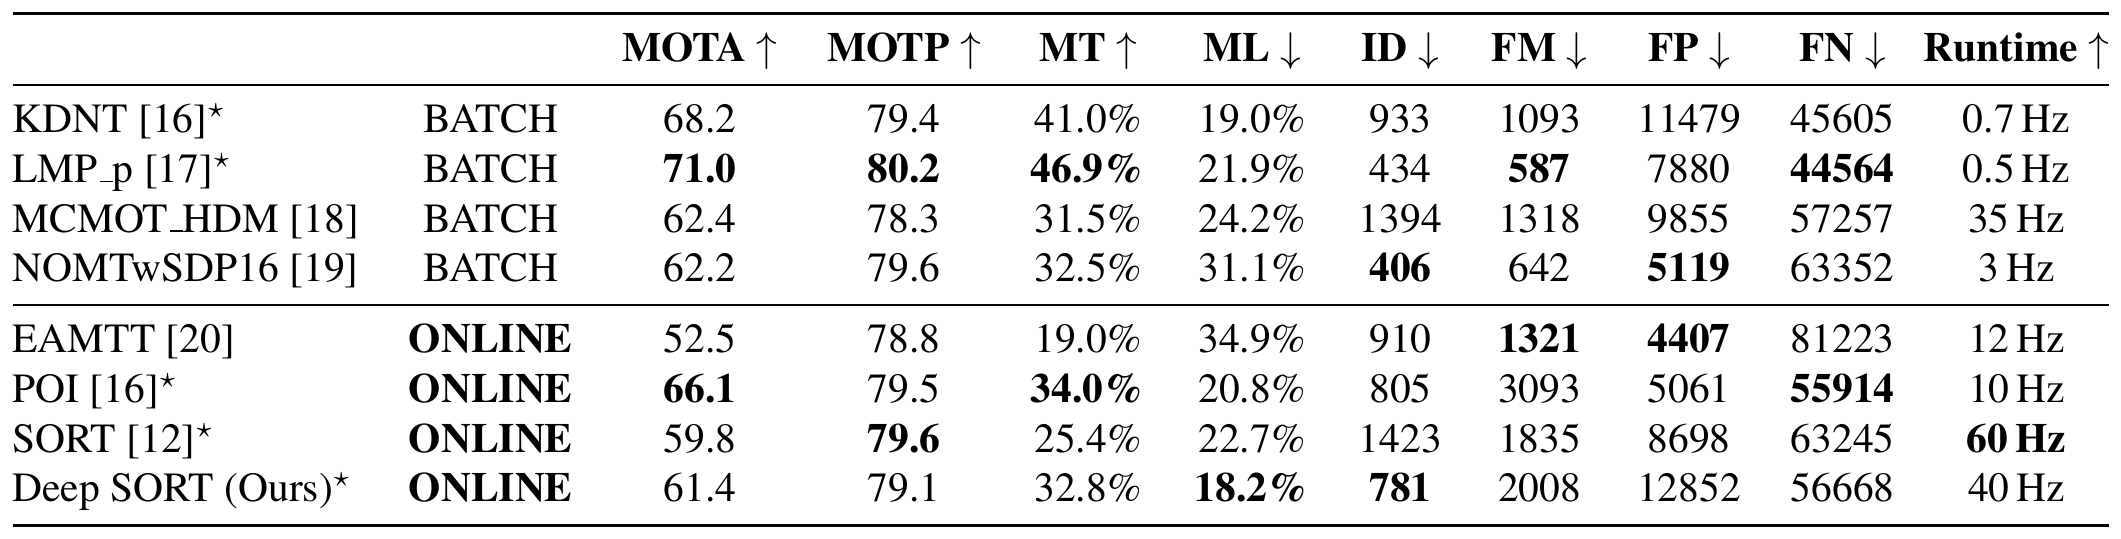
這張表中,打星號的方法都用同一組 POI 偵測。我們先比較 SORT 和 Deep SORT 這兩列,因為只有它們的差別純粹來自追蹤器:
- ID 切換從 1423 降到 781,少了約 45%。這是加上外觀之後最主要的收穫,也是 online 組裡最少的。
- MT 從 25.4% 升到 32.8%,ML 從 22.7% 降到 18.2%。能維持身分的時間變長,大部分時間被追到的軌跡多了,幾乎跟丟的軌跡少了。
- FM 從 1835 增加到 2008。作者解釋,軌跡現在會撐過遮擋與漏檢,中間空掉的那幾幀就被算成一次斷裂。
- FP 從 8698 增加到 12852。這是 MOTA 只從 59.8 升到 61.4 的主因。
最後這一點值得多看一眼。作者檢查輸出後發現,多出來的誤報大多來自偵測器在靜止背景上偶爾冒出的誤判。 讓軌跡活得很久,這些零星的誤報就被接進軌跡裡,形成一條條穩定、停在原地不動的假軌跡。作者也觀察到,軌跡很少在誤報之間跳來跳去。換句話說,這些誤報主要拉低 MOTA,對身分維持的傷害不大。調高偵測門檻可能可以大幅改善 MOTA,但論文沒有報告這組結果。
和同樣使用 POI 偵測的 POI 方法相比,Deep SORT 的 MOTA 低了將近 5 分,ID 切換則略少(781 對 805),速度快了好幾倍。
速度方面,表中列出 40 Hz;作者在正文說,整套實作大約 20 Hz,其中將近一半時間花在產生外觀特徵。不論哪個數字,都不含偵測器本身。
後來
DeepSORT 的程式碼簡單、特徵網路可以直接替換,很快成了工程專案的標準配備。MATLAB 有它的官方範例,GitHub 上「YOLO + DeepSORT」的組合專案更是多到數不清。
五年後,StrongSORT 把它當成重新整修的起點,換掉了外觀網路和卡爾曼濾波,也把匹配級聯拿掉,改回單一的全域指派。他們的消融發現,級聯對較弱的追蹤器有幫助,能減少錯誤配對;追蹤器變強之後,它反而會綁手綁腳。在 StrongSORT 的表中,原版 DeepSORT 換成一般配對後,IDF1 掉了 1.1;逐步強化之後,拿掉級聯的好處越來越明顯,最強的兩個版本分別多了 1.8 和 1.4。
這不算推翻 DeepSORT 的設計,只是說明級聯處理的那個問題(不確定軌跡在馬氏距離上占便宜),在外觀特徵夠強、成本矩陣不再以馬氏距離為主之後,就沒那麼嚴重了。
結論
一個離線訓練好的外觀網路,加上按軌跡年齡分層的匹配級聯,就讓 MOT16 上的 ID 切換少了 45%。軌跡能撐過一整秒的消失,追蹤本身仍維持在每秒數十幀。
它的「Deep」只在外觀特徵上。運動模型、配對、軌跡管理都還是手工規則,所以換一個更好的 re-ID 網路,通常就是最便宜的升級方式。
噢,拿 DeepSORT 去追行人以外的東西時,記得換掉那顆在 MARS 上訓練的特徵網路。它認得一千多個行人,可不認得你的貨車。