原始論文
FairMOT: On the Fairness of Detection and Re-Identification in Multiple Object Tracking
- arXiv 首次提交
- arXiv:2004.01888
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{multiobjecttrackingfairmot2020,
  title = {{FairMOT: On the Fairness of Detection and Re-Identification in Multiple Object Tracking}},
  author = {Yifu Zhang and Chunyu Wang and Xinggang Wang and Wenjun Zeng and Wenyu Liu},
  year = {2020},
  eprint = {2004.01888},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2004.01888}
}
DeepSORT 讓追蹤器學會認人,代價是每個偵測框都要再過一次 re-ID 網路。畫面裡有十個人,就裁十張圖、跑十次特徵;有一百個人,就跑一百次。偵測器和 re-ID 網路各自從原始影像抽特徵,什麼都不共用。
人一多,這套系統就慢下來了。
很自然的想法是把兩件事放進同一個網路。2019 年前後,Track R-CNN 在 Mask R-CNN 上多接一個 re-ID 頭,JDE(Joint Detection and Embedding)在 YOLOv3 上多接一個 re-ID 頭,一次前向傳播同時輸出框和特徵。這類方法叫做 one-shot 追蹤器,速度確實上來了,偵測也還不錯。
但 ID 切換暴增。
華中科技大學與微軟亞洲研究院的張一夫、王春雨等人想知道問題出在哪裡。他們的答案是,這兩個任務在同一個網路裡沒有被公平對待:偵測永遠是主角,re-ID 只是附帶的。這篇論文的 arXiv 第一版原本叫「A Simple Baseline for Multi-Object Tracking」,後來才改成現在這個強調「公平」的名字。
定義問題
作者把 one-shot 追蹤器學不好 re-ID 的原因,歸納成三種「不公平」。
錨框造成的不公平
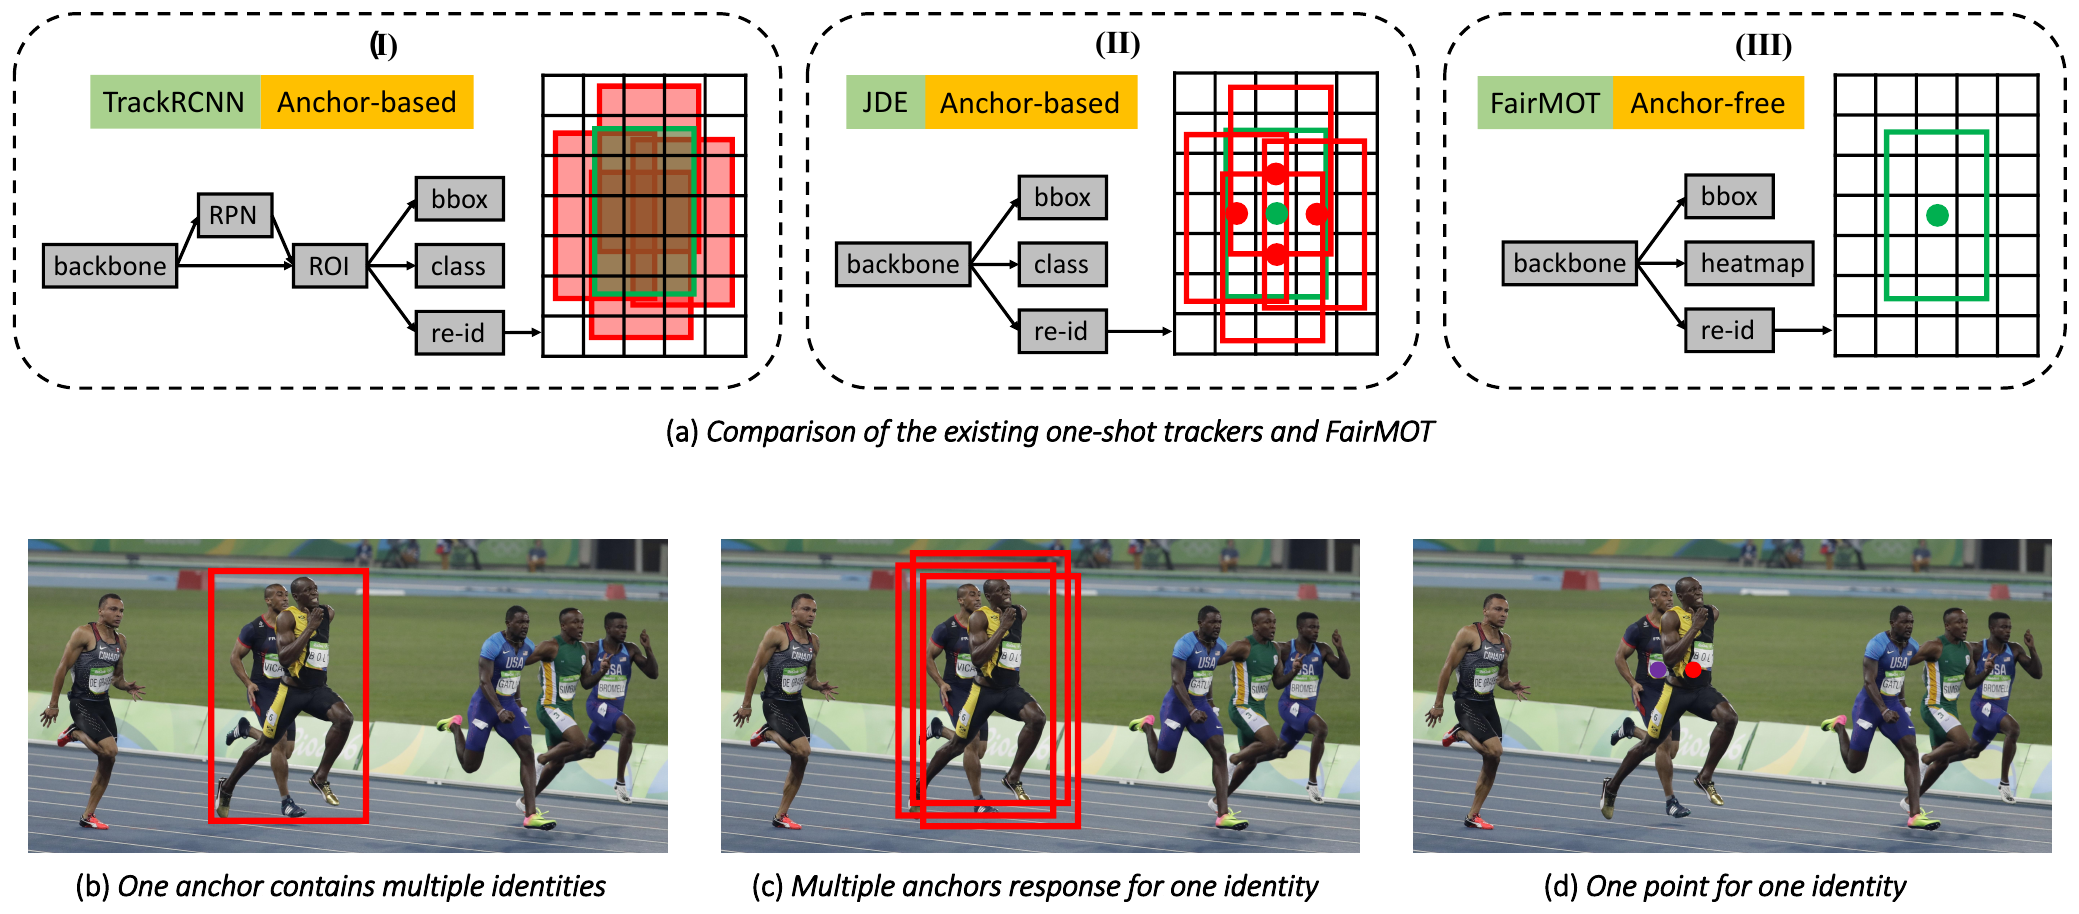
Track R-CNN 和 JDE 都改自以錨框(anchor)為基礎的偵測器,re-ID 特徵也跟著錨框走。這帶來三個麻煩:
- re-ID 被當成次要任務。 Track R-CNN 先用 RPN 產生候選框,再從候選框抽 re-ID 特徵。候選框不準,特徵就沒用,所以訓練時網路會優先把候選框學好,re-ID 排在後面。
- 一個錨框對到多個人。 圖 (b) 的紅框同時框到兩名選手。用 RoI-Align 在框裡取樣,很多取樣點落在別人身上或背景上,抽出來的特徵就混了好幾個人。
- 多個錨框對到同一個人。 圖 (c) 裡,三個位置不同的錨框,因為和同一名選手的 IoU 都夠大,都被要求輸出同一個身分。這三個錨框看到的影像區塊其實不一樣,卻要學出同一個特徵;資料增強稍微平移一下影像,同一個錨框又可能被分配給另一個人。
另外,偵測器的特徵圖通常縮小 8、16、32 倍,對偵測還能接受,對 re-ID 就太粗了,錨框的位置很可能沒對準物體中心。
特徵造成的不公平
偵測和 re-ID 要的特徵很不一樣。偵測希望同一類物體的特徵越像越好,不管這個人穿什麼衣服,都要認出「這是人」;re-ID 卻要把同一類的不同個體分開,需要更多低層的外觀細節。
兩個任務共用同一份特徵,就會互相拉扯。
維度造成的不公平
re-ID 領域習慣用 512 或 1024 維的特徵,而偵測頭的輸出只有類別數加上幾個框座標。作者認為,兩邊維度差這麼多,會讓 re-ID 的損失壓過偵測。
更重要的是,多目標追蹤的 re-ID 和一般的 re-ID 不一樣。一般的 re-ID 要拿一張查詢影像去比對上萬張候選,需要很高的鑑別力;追蹤只需要在相鄰兩幀之間,做少量一對一的配對。追蹤用不到那麼高的維度。
解決問題
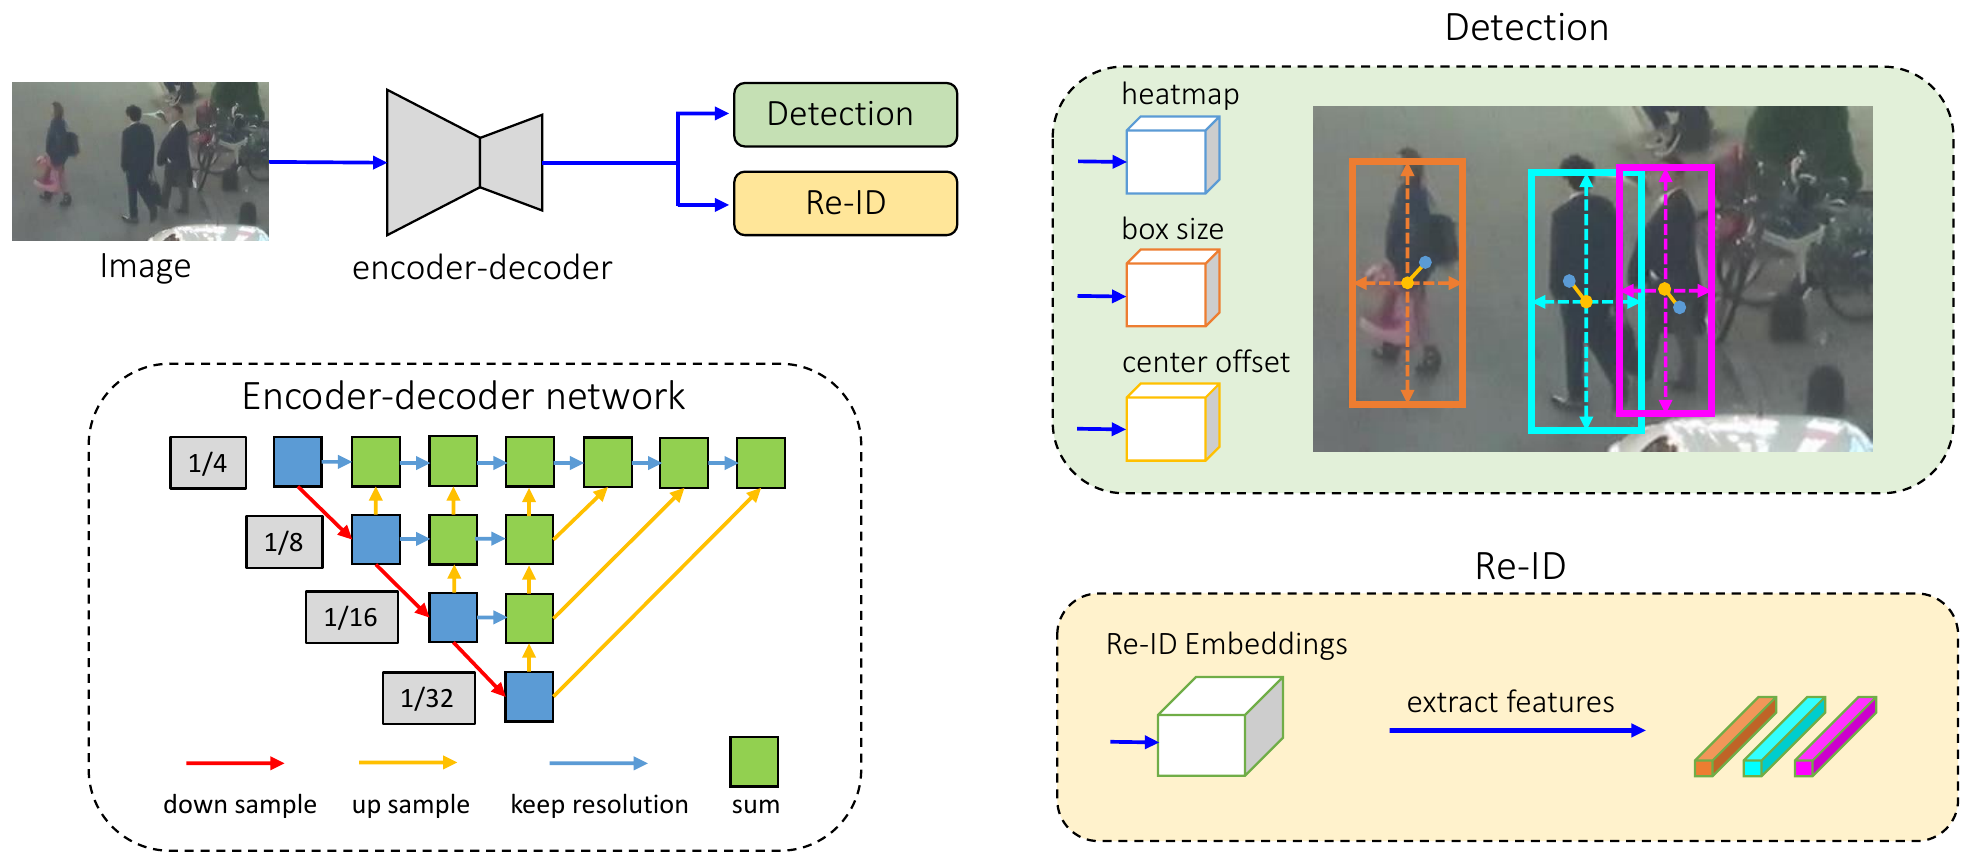
FairMOT 對三個不公平各補一刀。不用錨框,改用 CenterNet 那種以中心點表示物體的偵測方式;用多層特徵融合的骨幹,讓兩個任務各取所需;把 re-ID 特徵的維度壓低。
兩個分支的結構完全相同,都直接接在骨幹輸出的同一張特徵圖上,沒有誰先誰後。
骨幹
骨幹是 DLA-34,由 ResNet-34 加上深層聚合(Deep Layer Aggregation)的多層融合結構組成,上採樣模組裡的卷積全換成可變形卷積(deformable convolution),讓感受野能隨物體的大小和姿態調整。
輸出特徵圖是輸入的 1/4。訓練和推論時,輸入影像統一縮放到 ,特徵圖就是 。
跟著一個人走一遍
我們用一個人來看兩個分支怎麼在同一張特徵圖上分工。
假設在 的輸入影像上,某個人的真實框是 。
第一步,找中心。 框的中心是 。特徵圖縮小 4 倍,中心落在 ,取整數後是特徵圖上的格子 。
第二步,熱圖。 熱圖分支輸出一張 的圖。訓練目標是在 放一個值為 1 的峰,周圍以高斯函數往外遞減。若有 個物體,目標熱圖是
損失用 CenterNet 的 focal loss 形式。峰值位置要預測得接近 1,其他位置要接近 0,但離峰值越近的位置,預測錯了扣得越少。
第三步,偏移與大小。 取整數時丟掉了 ,最多會有 4 個像素的誤差。偏移分支在 這個格子要預測出 ,把中心補回精確位置;大小分支在同一個格子預測框的寬高 。兩者都用 L1 損失,大小項的權重 ,沿用 CenterNet 的設定。
第四步,re-ID。 re-ID 分支用一層 128 個卷積核的卷積,輸出 ,每個格子都有一個 128 維的特徵。這個人的特徵,就是 在 的那一根向量 。
FairMOT 的關鍵設計就在這裡。一個人只對應特徵圖上的一個點,熱圖、偏移、大小、re-ID 全部從這一點讀出來。沒有錨框,也就沒有「一個錨框兩個人」或「三個錨框一個人」的問題。
re-ID 怎麼訓練
re-ID 的訓練被當成分類問題。訓練集裡每一個身分都是一類,共 類。從物體中心取出的特徵,經過一層全連接和 softmax,得到這個物體屬於各個身分的機率 ,再用交叉熵計算損失:
訓練時只用真實中心點上的特徵。推論時,物體中心由熱圖決定,取出來的特徵直接拿去做比對,分類層用不到。
兩個任務怎麼平衡
偵測損失是熱圖加上框的損失,。兩個任務的損失不是直接相加,而是用 Kendall 等人提出的不確定性加權:
和 是可學習的參數。某個任務的損失越大、越不確定,它的權重就會被調小,但 這兩項又懲罰權重無限縮小。網路自己決定兩邊各拿多少。
只用單張影像也能練
追蹤資料需要跨幀的身分標註,很貴。作者另外提出「單張影像訓練」,拿 CrowdHuman 這種只有框、沒有身分的行人偵測資料,把每一個框都當成一個獨立的身分,再對整張影像做旋轉、縮放、平移、色彩等增強。
這樣訓練出來的 re-ID,學的是「這個人和畫面裡其他人不同」。論文把這個方法稱為自監督,官方程式的說明則寫成弱監督;不管叫什麼,它用的是框標註,省下的是身分標註。
推論與關聯
推論時,對熱圖做一次 的最大池化當作非極大值抑制,保留分數高於門檻的峰值,再從偏移和大小分支算出框,從 re-ID 分支取出特徵。
關聯沿用 MOTDT 的兩階段作法:
- 第一階段:外觀為主。 用卡爾曼濾波預測每條軌跡的位置,計算馬氏距離 ;再算軌跡與偵測之間 re-ID 特徵的餘弦距離 。兩者加權成 ,,馬氏距離太大的配對直接排除。用匈牙利演算法配對,門檻 0.4。
- 第二階段:IoU 補漏。 剩下沒配上的偵測框和軌跡,改用框的 IoU 再配一次,門檻 0.5。
軌跡的外觀特徵每一幀都會更新,以適應外觀變化。最後還沒配上的偵測框成為新軌跡;沒配上的軌跡保留 30 幀,等它可能回來。
討論
訓練資料和 JDE 相同,稱為 MIX。其中 ETH 和 CityPersons 只有框,只訓練偵測分支;CalTech、MOT17、CUHK-SYSU、PRW 有身分標註,兩個分支一起訓練。消融實驗都在 MOT17 驗證集上進行。
re-ID 的品質用 TPR@FAR=0.1 衡量,也就是用真實框位置的特徵做檢索,在誤接受率 0.1 時的真陽性率。這個指標不受偵測結果影響,只看特徵本身好不好。
特徵要在哪裡取
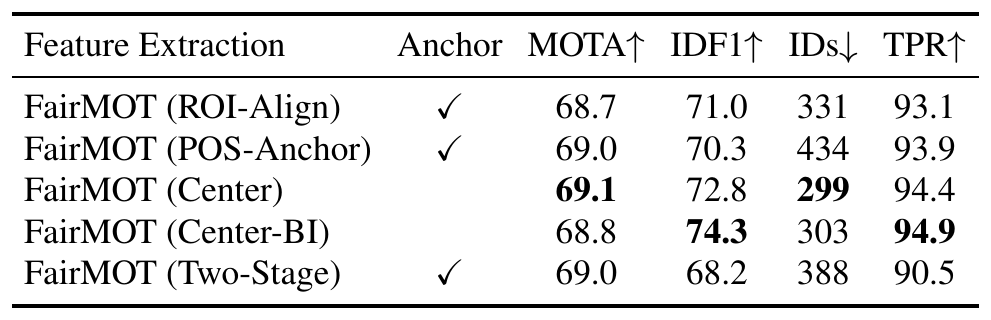
五種方法都建立在 FairMOT 上,唯一的差別是 re-ID 特徵從哪裡取。ROI-Align 是 Track R-CNN 的作法,POS-Anchor 是 JDE 的作法,Center 是 FairMOT 的作法,Center-BI 在中心用雙線性內插取得更精確的位置,Two-Stage 則是先偵測、再用偵測框做 ROI-Align。
MOTA 幾乎都在 69 上下,因為偵測分支是一樣的。差別在 IDF1 和 ID 切換。Center 的 ID 切換 299,比 POS-Anchor 的 434 少了三成;Center-BI 的 TPR 最高。最差的是 Two-Stage,IDF1 只有 68.2,TPR 掉到 90.5。訓練時讓 re-ID 依賴偵測結果,特徵品質確實會被拖累。
偵測和 re-ID 真的會打架嗎
作者做了一個很直接的實驗。拿 ResNet-34 當骨幹,一組兩個分支一起訓練,另一組只訓練偵測分支、re-ID 分支保持隨機初始化。
只訓練偵測時,AP 從 75.1 升到 76.1;兩個任務一起練,偵測確實會被拖累。有意思的是,只練偵測的那組 MOTA 還略高(63.7 對 63.6),但 IDF1 從 67.2 掉到 60.4,TPR 從 90.9 掉到 36.7。MOTA 主要看偵測,re-ID 的特徵幾乎沒用時,它也看不出來。
換成有多層融合的 DLA-34 之後,AP 是 81.2、TPR 是 94.4,兩邊都比 ResNet-34 好。作者的解讀是,多層融合讓兩個任務能從不同層取各自需要的特徵,衝突就小了。
骨幹的比較也支持這一點。ResNet-50 比 ResNet-34 大,ImageNet 準確度也更高,但 MOTA 只從 63.6 到 63.7,ID 切換反而從 435 增加到 501;加上 FPN 的 ResNet-34 參數比 ResNet-50 少,TPR 卻從 90.9 升到 94.2。DLA-34 若把可變形卷積換回普通卷積,MOTA 會從 69.1 掉到 65.0,AP 從 81.2 掉到 78.1。只從中心一點取特徵的方法,很依賴感受野能跟著物體大小調整。
維度低一點比較好
把 re-ID 特徵從 512 維降到 64 維:
- JDE: MOTA 59.9 → 60.3,IDF1 64.1 → 65.0,ID 切換 536 → 474,TPR 76.8 → 82.0。每一項都變好。
- FairMOT: MOTA 68.5 → 69.2,AP 80.9 → 81.3,ID 切換 312 → 283;但 IDF1 從 73.7 略降到 73.3,TPR 從 94.6 略降到 94.3。
FairMOT 這組結果比較細緻。高維特徵本身的鑑別力確實稍強,但它會拖累偵測,偵測一差,整體追蹤就跟著差。作者最後採用 128 維。
損失要怎麼加權
固定權重(網格搜尋得出)的 MOTA 和 AP 最高,TPR 最低,模型偏向偵測;MGDA-UB 的 TPR 最高,MOTA 和 AP 最低,偏向 re-ID。GradNorm 的 IDF1 最高,整體最均衡,但訓練時間較長。作者最後選擇稍遜一點、也簡單得多的不確定性加權。
關聯的三個零件
只用 IoU 關聯,ID 切換有 648 次;只用 re-ID 特徵,降到 435;re-ID 加卡爾曼濾波,342;三者都用,299。在擁擠或相機快速移動的場景,光靠 IoU 會一直換 ID;物體被部分遮擋時,re-ID 特徵又不可靠,這時候需要框和運動來補。
單張影像訓練
只用 CrowdHuman 單張影像訓練、完全沒看過身分標註的模型,直接拿去追 MOT17 驗證集,MOTA 是 64.1,IDF1 64.9。先在 CrowdHuman 上預訓練、再用 MOT17 微調,MOTA 71.1、IDF1 75.6,比只用 MOT17 訓練的 67.5、69.9 高出一截,甚至超過用 MIX 加 MOT17 的 69.1、72.8。
MOTChallenge
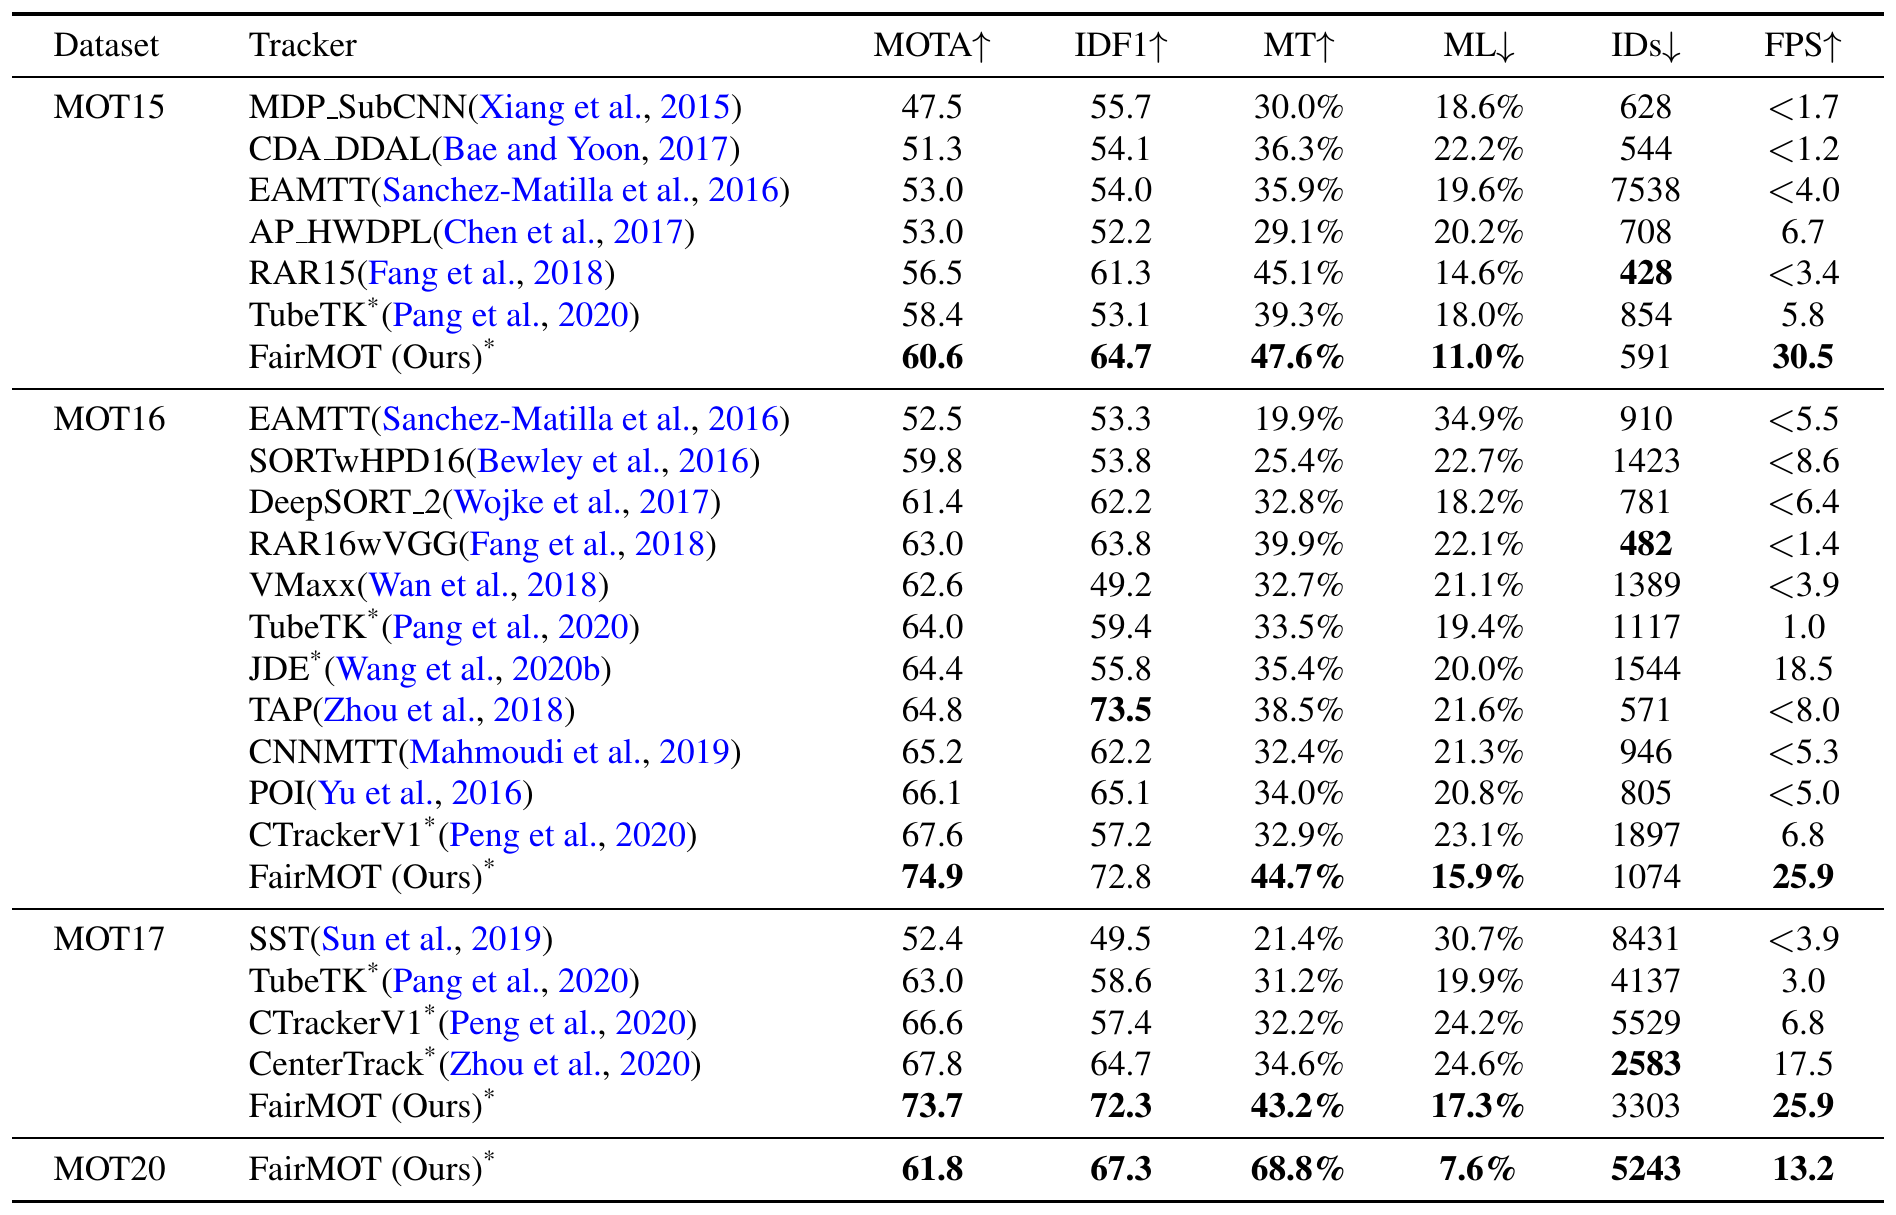
這張表是 private detector 規則,也就是各家用自己的偵測器。FPS 同時計入偵測和關聯,這對 two-step 方法比較嚴格,也是 one-shot 追蹤器想證明的事。
FairMOT 在四個資料集都排第一。MOT17 的 MOTA 73.7、IDF1 72.3,比同為 one-shot 的 CenterTrack 高出約 6 分和 8 分,速度 25.9 FPS。在 MOT16 上,和 DeepSORT(表中的 DeepSORT_2)相比,MOTA 從 61.4 升到 74.9,速度從不到 6.4 FPS 升到 25.9。
不過 ID 切換那一欄要細看。MOT16 上,FairMOT 的 1074 次比 DeepSORT_2 的 781 次多。FairMOT 偵測得多、MT 高、ML 低,追到的軌跡本來就比較多,ID 切換的絕對次數也跟著增加。比較 ID 維持能力時,IDF1 是比較合適的指標。
速度方面,FairMOT 在 MOT20 只剩 13.2 FPS。作者分析各部分的耗時發現,偵測與 re-ID 的網路推論幾乎不受人數影響,卡爾曼濾波和 IoU 配對只要 1、2 毫秒;隨著人數線性增長的,是 re-ID 比對時更新每條軌跡外觀特徵的時間。
後來
社群後續的檢討大多落在擁擠場景。例如 2023 年的 CSMOT 指出,FairMOT 在擁擠場景中偵測不夠準,re-ID 特徵的鑑別力也不足,追蹤效能明顯下降。本文推測,這和只在中心一點取特徵的設計有關。人擠在一起時,一個人的中心點附近,常常就是別人的身體。
結論
one-shot 追蹤器 ID 切換暴增,FairMOT 找到三個原因。錨框讓 re-ID 學到混雜的特徵,共用特徵讓兩個任務互相拉扯,高維特徵壓過偵測;對應的解法是以中心點表示物體、用多層融合的骨幹、把 re-ID 降到 128 維。結果在四個 MOTChallenge 資料集上都排第一,整個系統每秒約 26 幀。
同一個網路裡塞兩個任務時,記得另外量 re-ID 的指標。只練偵測的那組,特徵已經幾乎沒用了,MOTA 卻還是不動如山。
有趣的是,一年半後張一夫寫 ByteTrack 時,在 MOT17 上乾脆連 re-ID 都不用了。