原始論文
Real-time Multiple People Tracking with Deeply Learned Candidate Selection and Person Re-Identification
- 發表版本
- ICME 2018會議
- arXiv 首次提交
- arXiv:1809.04427
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{multiobjecttrackingmotdt2018,
  title = {{Real-time Multiple People Tracking with Deeply Learned Candidate Selection and Person Re-Identification}},
  author = {Long Chen and Haizhou Ai and Zijie Zhuang and Chong Shang},
  year = {2018},
  eprint = {1809.04427},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1809.04427}
}
如果你讀過 FairMOT 或 JDE 的程式碼,關聯那一段很可能會看到 MOTDT 這個名字。
FairMOT 的論文寫得很直接,它的線上關聯「沿用 MOTDT 的階層式關聯」。ByteTrack 拿來比較的三種經典關聯方法,除了 SORT 和 DeepSORT,第三個也是 MOTDT。
這個名字常常出現在別人的表格裡,論文本身卻只有六頁。它是清華大學的 Long Chen、Haizhou Ai 等人在 2018 年發表的,處理的是每個追蹤器都會遇到的問題,偵測器不可靠的時候該怎麼辦。
定義問題
在擁擠的場景裡,偵測器很容易出錯。姿勢一變、被別人擋住,就會出現漏檢、誤報,或者框的位置不準。
離線(batch)方法可以看完整段影片,用未來的幀來修正這些錯誤,但它們不是即時的,沒辦法用在需要當下給出結果的應用。這篇論文只做線上追蹤,只能用目前和過去的幀。
傳統的 tracking-by-detection 在關聯時,候選框只有偵測結果。偵測器漏掉一個人,這一幀就沒有任何框能配給他的軌跡。
作者注意到,偵測和追蹤其實可以互補:
- 軌跡的預測可以處理短時間的漏檢或框不準。偵測器這一幀沒找到人,卡爾曼濾波的預測框還在。
- 高信心的偵測可以防止軌跡長期飄移到背景上。預測框一直沒有偵測來修正,遲早會跑偏。
那就把兩者都當成候選框吧。可是偵測框和預測框來源不同,要怎麼用同一把尺打分數,再從一大堆重疊的框裡挑出最好的?
先前 Yan 等人也試過把偵測器和追蹤器的輸出都當候選,但用的是顏色直方圖、光流這類手工特徵。這篇論文想用深度網路來做,而且要即時。
解決問題
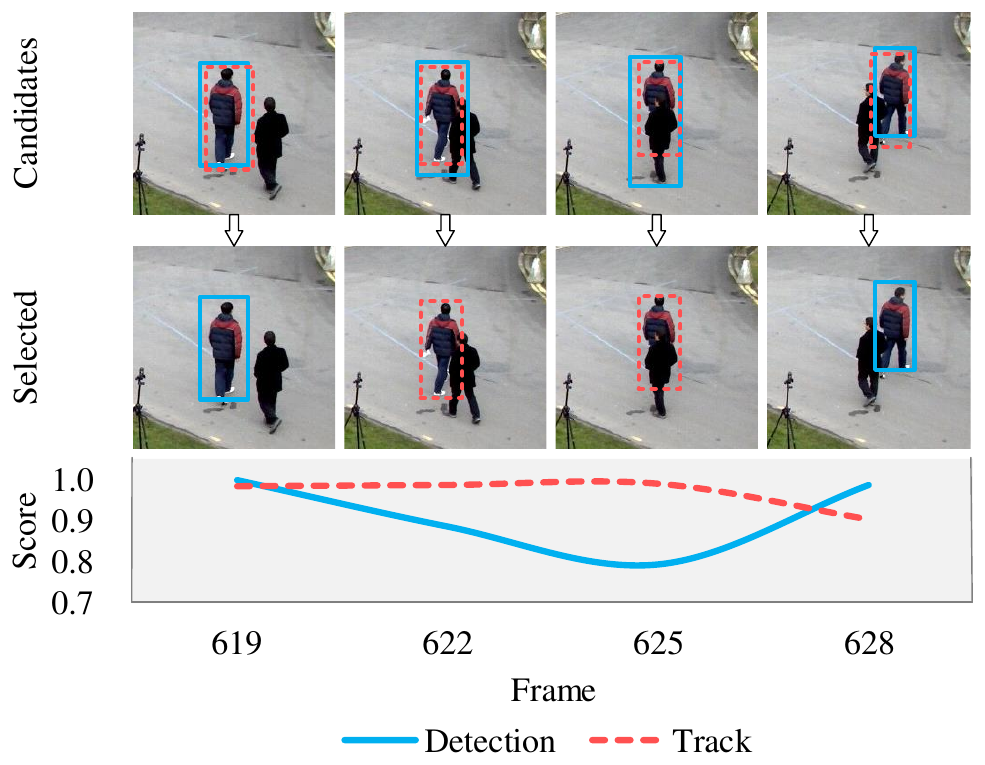
這張圖就是整篇論文的想法。藍色實線是偵測框,紅色虛線是軌跡的預測框,底下的曲線是兩者的分數。
前後的幀,偵測框分數較高,被選中;中間第 622 到 625 幀,這個人被擋住一部分,偵測框的分數掉下來,預測框反而比較可靠,就換成選預測框。
整個方法分兩步,先選候選框,再做關聯。
一、用同一個分類器替所有候選框打分
偵測框加上預測框,數量會很多,而且彼此高度重疊。如果每個框都裁下來送進分類網路,太慢了。
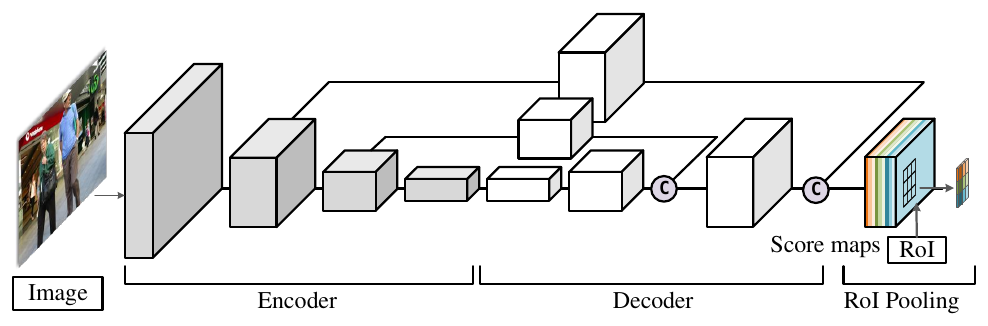
作者改用 R-FCN(region-based fully convolutional network)的作法,整張影像只跑一次網路,輸出幾張分數圖,所有候選框共用這些分數圖。
骨幹用輕量的 SqueezeNet 當編碼器,再接一個帶上採樣的解碼器,把分數圖的解析度拉高。輸入 的影像,在 GTX 1080 Ti 上只要 8 毫秒。
最簡單的打分方式,是在整張圖上算每個點「是人」的機率,再把框內所有點平均。但這樣會丟掉空間資訊。一個框只蓋到半個人,框內的點也都在人身上,平均起來分數照樣很高。
R-FCN 用位置敏感的分數圖解決這個問題。網路輸出 張分數圖,每個候選框切成 個格子,每個格子只讀「屬於自己位置」的那張分數圖。最後把 個格子的反應平均,再經過 sigmoid:
我們用 想像一下。網路會輸出 9 張分數圖,分別對「人的左上角」「人的正上方」……「人的右下角」有反應。一個框正好框住一個人時,左上格讀左上圖、右下格讀右下圖,每格都讀到高分。如果框往右偏了半個人,框的右半邊落在背景上,右側三格讀到的都是低分,平均下來分數就掉了。
這個網路只做分類,不做框的回歸。實作中 ,訓練資料是在真實框周圍隨機取樣的正樣本,以及等量的背景負樣本,來源是 MS COCO 和兩段 MOT16 訓練影片。
二、軌跡信心:預測框能信多久?
預測框在短時間內有用,時間一長就不可靠了。卡爾曼濾波越久沒被偵測更新,預測越不準。
作者為每條軌跡定義了一個信心分數。一條軌跡可能中斷又被找回好幾次,每次找回都會重新初始化卡爾曼濾波,所以只看最後一段連續的小軌跡(tracklet):
是這段小軌跡配到過幾次偵測, 是最後一次配到偵測之後,已經連續用了幾次預測。
這個式子的行為很直觀:
- 剛配到偵測時,,信心是 1。
- 每多用一次預測, 就加一,信心按對數往下掉。
- 當 超過 ,信心就歸零,這條軌跡的預測框不再能當候選。
- 一條軌跡至少要配到兩次偵測,才算有足夠的觀測建立運動模型,它的預測框才能當候選。
三、統一分數
兩種候選框的分數定義成:
偵測框的分數就是分類機率;預測框的分數是分類機率再乘上軌跡信心。一個預測框就算看起來很像人,只要它來自一條很久沒被偵測確認的軌跡,分數也會被壓低。
所有候選框打完分後,做一次非極大值抑制(IoU 門檻 0.3),再丟掉分數低於 0.4 的框。
四、外觀特徵
關聯時要判斷候選框和軌跡是不是同一個人,作者用的是 re-ID 特徵。網路採用 Zhao 等人提出的部件對齊架構,以 GoogLeNet 的卷積骨幹,後面接 個分別對應身體不同部位的全連接分支,輸出 512 維特徵,用歐氏距離比較。
訓練資料結合了 Market-1501、CUHK01、CUHK03 三個行人重新辨識資料集,用 triplet loss 訓練:
是同一個人, 是不同人。已經分得很開的三元組()損失為零,訓練就專注在困難的例子上。
五、階層式關聯
這是後來被 JDE、FairMOT 沿用的部分。關聯分成兩層:
- 第一層:偵測候選框 × 軌跡,用外觀。 計算 re-ID 特徵的距離,門檻 0.4。
- 第二層:剩下的候選框 × 剩下的軌跡,用 IoU。 門檻 0.3。
- 剩下的偵測框,開新的軌跡。
為什麼要分層?預測框是卡爾曼濾波推出來的,在擁擠的場景裡,它框到的區域可能混進了別人。用這種框抽外觀特徵,很容易把別人的樣子記進來。所以外觀比對只用在偵測框上,軌跡的外觀也只用配上的偵測框來更新;預測框只參與第二層的 IoU 配對。
這樣做也比較快。每一幀只需要對偵測框抽一次 re-ID 特徵,預測框完全不用抽。
討論
實驗在 MOT16 上進行,使用官方提供的公用偵測。驗證集取自 5 段訓練影片,用來做消融。
每個元件的貢獻
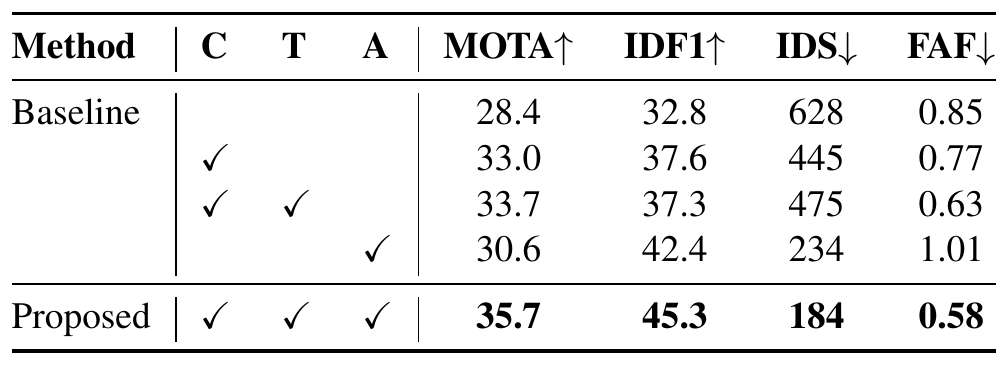
基準是最單純的卡爾曼濾波預測加 IoU 配對,也就是 SORT 那一套。
- 用分類器從偵測框和預測框中挑候選(C),MOTA 從 28.4 升到 33.0,ID 切換從 628 降到 445。把預測框當候選,確實補回了很多漏檢。
- 再加上軌跡信心(T),MOTA 升到 33.7,每幀誤報從 0.77 降到 0.63。不可靠的預測框被壓下去了,但 ID 切換略增到 475。
- 只加外觀特徵(A),IDF1 從 32.8 大幅升到 42.4,ID 切換降到 234;但 MOTA 只有 30.6,每幀誤報反而升到 1.01。
- 三者都加,MOTA 35.7、IDF1 45.3、ID 切換 184,四個指標都最好。
前兩項主要改善偵測相關的指標,外觀特徵主要改善身分相關的指標,兩邊合起來才都到位。
外觀特徵本身也做了比較。下表依原論文 Table 2 整理,比較的是在相同框架下換用不同的外觀表示:
| 外觀表示 | 維度 | MOTA | IDF1 | ID 切換 |
|---|---|---|---|---|
| 不用外觀 | – | 33.7 | 37.3 | 475 |
| 顏色直方圖 | 750 | 34.9 | 38.6 | 250 |
| HOG | 1152 | 34.6 | 38.5 | 317 |
| 顏色 + HOG | 1902 | 34.7 | 39.3 | 307 |
| re-ID 特徵 | 512 | 35.7 | 45.3 | 184 |
手工特徵也有幫助,但 IDF1 都只到 39 左右;學出來的 re-ID 特徵維度最短,IDF1 卻高出 6 分。
速度
作者在最擁擠的 MOT16-03(平均每幀超過 50 人)上量測每幀的處理時間。如果把每個候選框裁下來,用 SqueezeNet 加兩層全連接逐一分類,每幀要 206.2 毫秒;改用共用分數圖的 R-FCN,降到 66.3 毫秒。
MOT16 測試集
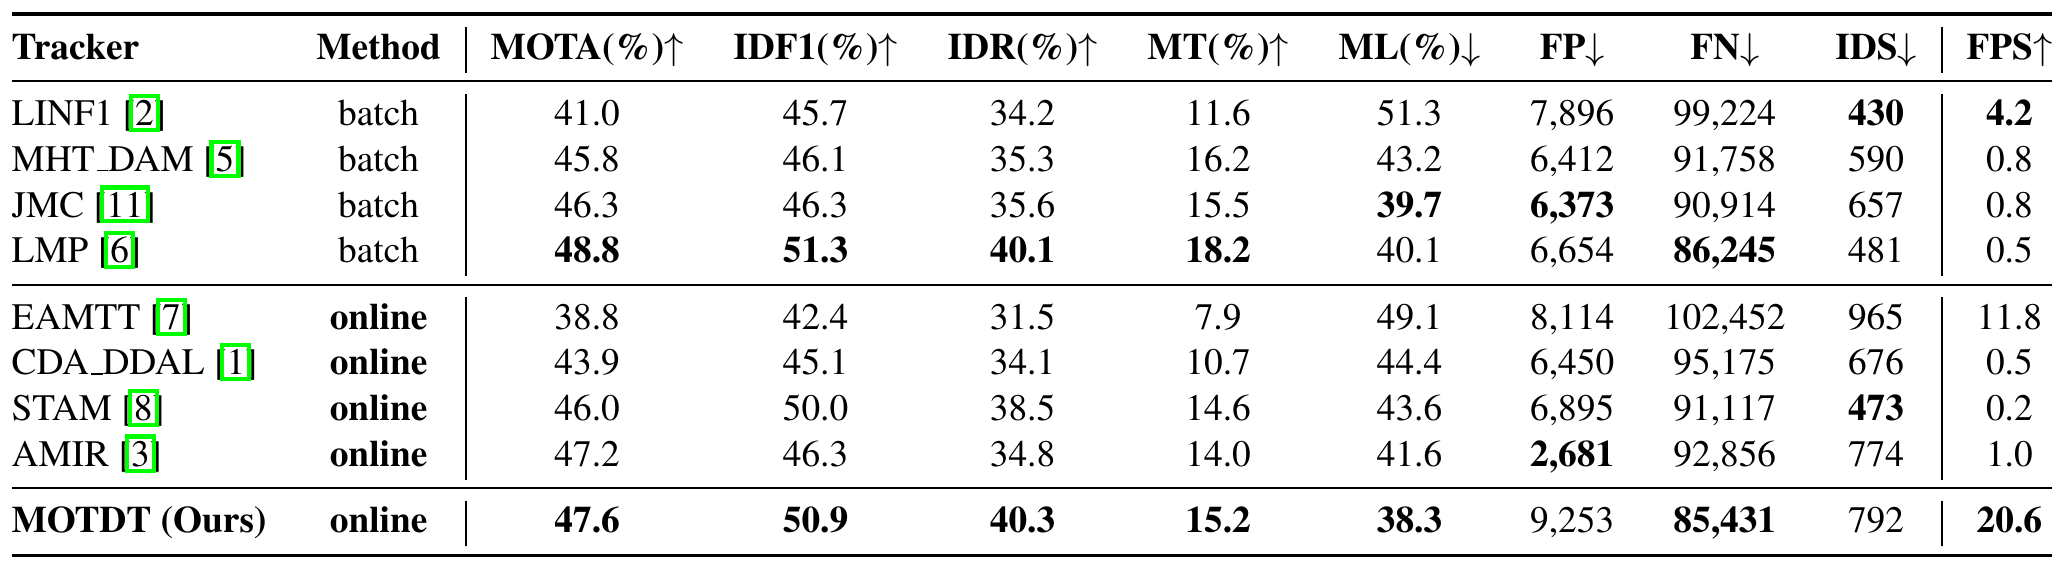
在公用偵測的設定下,MOTDT 的 MOTA 47.6、IDF1 50.9,都是表中線上方法最高的,ML 38.3% 和 FN 85,431 甚至是全表最低。速度 20.6 FPS,作者說大約比多數現有方法快 5 到 20 倍;表中多數方法每秒只有 0.2 到 1 幀,差距其實更大。和最好的離線方法 LMP 相比,MOTA 只差 1.2 分,速度卻是 40 倍。
不過,有兩欄並不漂亮。FP 是 9,253,是 AMIR(2,681)的三倍多;ID 切換 792,也高於 STAM 的 473 和 LMP 的 481。本文推測,把預測框當候選,補回漏檢的同時,也把一部分不該存在的框留了下來。
後來
作者在結論裡寫,未來想讓分類和外觀特徵共用卷積層,進一步提升效率。
隔年,清華大學的 Zhongdao Wang 等人發表 JDE,在一個偵測網路上同時輸出偵測框和 re-ID 特徵;它的官方程式在關聯時,也是先用外觀加運動配對,剩下的再用 IoU。再隔一年,FairMOT 也沿用了同樣的兩階段關聯。MOTDT 的另一半,也就是「把預測框也當候選」,在 FairMOT 裡則沒有沿用。
ByteTrack 在 2021 年把 MOTDT 列為比較對象,用同一個 YOLOX 偵測器在 MOT17 驗證集上跑。MOTDT 的 MOTA 是 75.8,BYTE 是 76.6。ByteTrack 的作者認為,MOTDT 拿預測框當軌跡框,可能會讓位置慢慢飄移;BYTE 改從低分的偵測框裡把人撈回來,位置更準。兩篇處理的是同一個問題(偵測器不可靠時,怎麼別讓人跟丟),選的補救材料卻不同。
結論
MOTDT 把偵測框和軌跡預測框都當成候選,用一個位置敏感的全卷積分類器替它們打統一的分數,再用軌跡信心壓低太久沒被確認的預測。關聯時,外觀只用在偵測框上,剩下的交給 IoU。這套方法在 MOT16 上做到當時線上方法最高的 MOTA 和 IDF1,每秒 20 幀。
想替自己的追蹤器加 re-ID 時,階層式關聯是很實用的起點。外觀特徵只從可信的偵測框抽,預測框只拿來補位。這個規則簡單,卻直接避免了「把別人的臉記成自己的」這種錯誤。
至於標題裡占了一半篇幅的「候選選擇」,後來的追蹤器倒是很少再提起了。