原始論文
LLaMA: Open and Efficient Foundation Language Models
- 發表版本
- 正式發表資訊尚未核實
- arXiv 首次提交
- arXiv:2302.13971
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{transformersllama2023,
  title = {{LLaMA: Open and Efficient Foundation Language Models}},
  author = {Hugo Touvron and Thibaut Lavril and Gautier Izacard and Xavier Martinet and Marie-Anne Lachaux and Timothée Lacroix and Baptiste Rozière and Naman Goyal and Eric Hambro and Faisal Azhar and Aurelien Rodriguez and Armand Joulin and Edouard Grave and Guillaume Lample},
  year = {2023},
  eprint = {2302.13971},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2302.13971}
}
2023 年 2 月底,ChatGPT 上線還不到三個月,最強的語言模型幾乎都關在 API 後面。
GPT-3、Gopher、Chinchilla、PaLM 的權重都沒有公開,訓練資料也常只有一行描述,例如「書籍 2TB」或「社群媒體對話」。公開權重的模型不是沒有,OPT、GPT-NeoX、BLOOM、GLM 都放出來了,但作者的評價是,沒有一個比得上 PaLM-62B 或 Chinchilla。
Meta AI 的 Touvron、Lavril、Izacard、Grave、Lample 等人在這篇論文裡發表了 LLaMA,一組 70 億到 650 億參數的基礎模型。兩個主張讓它一出來就受到注意。第一,130 億參數的 LLaMA-13B 在多數評測上勝過 1,750 億參數的 GPT-3,推論時一張 V100 就跑得動。第二,訓練資料全部來自公開資料集,權重也釋出給研究社群(說是釋出,其實要填申請表;結果一週後,網路上就到處都是了)。
定義問題
Chinchilla 在前一年證明了,給定訓練算力,最好的結果不是來自最大的模型,而是較小的模型配上更多資料。它的目標是讓訓練的計算量用得最有效率。
作者指出,這個目標沒有考慮推論成本,而模型一旦部署,推論的總成本往往遠大於訓練。若要達到某個表現水準,比較划算的是推論最快的模型,不是訓練最快的模型。訓練一個大模型到某個水準也許比較便宜,但小模型多訓練一陣子,最後在推論時會省得多。
作者舉了一個對照。照 Chinchilla 的建議,100 億參數的模型大約該用 2,000 億個 token 訓練;但他們發現,70 億參數的模型在看過 1 兆個 token 之後,表現仍在進步。
所以這篇的目標是,在不同的推論預算下,各自訓練出表現最好的模型,方法是讓它們看比一般多得多的 token。
我們把幾個模型的「每個參數看了幾個 token」算一下。訓練 FLOPs 約為 ,推論每個 token 約 , 是參數量, 是訓練 token 數:
models = {               # 參數量, 訓練 token 數
    "GPT-3 175B":     (175e9, 300e9),
    "Chinchilla 70B": (70e9, 1.4e12),
    "LLaMA-7B":       (6.7e9, 1.0e12),
    "LLaMA-13B":      (13.0e9, 1.0e12),
    "LLaMA-65B":      (65.2e9, 1.4e12),
}
for name, (n, d) in models.items():
    train = 6 * n * d          # 訓練 FLOPs 約 6ND
    infer = 2 * n              # 推論每個 token 約 2N FLOPs
    print(f"{name:15s} token/參數 {d / n:6.1f}  訓練 {train:.1e}  推論/token {infer:.1e}")

# GPT-3 175B      token/參數    1.7  訓練 3.2e+23  推論/token 3.5e+11
# Chinchilla 70B  token/參數   20.0  訓練 5.9e+23  推論/token 1.4e+11
# LLaMA-7B        token/參數  149.3  訓練 4.0e+22  推論/token 1.3e+10
# LLaMA-13B       token/參數   76.9  訓練 7.8e+22  推論/token 2.6e+10
# LLaMA-65B       token/參數   21.5  訓練 5.5e+23  推論/token 1.3e+11
LLaMA-65B 的比例和 Chinchilla 差不多,都是每個參數約 20 個 token。小模型才是這篇的重點,LLaMA-7B 每個參數看了將近 150 個 token,遠超過 Chinchilla 的「最佳」比例。如果 LLaMA-13B 真的追得上 GPT-3,它的訓練算力只有 GPT-3 的四分之一,每個 token 的推論成本更只有約十三分之一。
解決問題
只用公開資料
| 資料來源 | 取樣比例 | 訓練 1.4T token 時的 epoch 數 | 磁碟大小 |
|---|---|---|---|
| CommonCrawl | 67.0% | 1.10 | 3.3 TB |
| C4 | 15.0% | 1.06 | 783 GB |
| GitHub | 4.5% | 0.64 | 328 GB |
| Wikipedia | 4.5% | 2.45 | 83 GB |
| Books | 4.5% | 2.23 | 85 GB |
| ArXiv | 2.5% | 1.06 | 92 GB |
| StackExchange | 2.0% | 1.03 | 78 GB |
整理自原論文 Table 1。
每個來源都有自己的處理方式:
- CommonCrawl:2017 到 2020 年的五個快照,用 CCNet 流程逐行去重、用 fastText 過濾非英文頁面、用 n-gram 語言模型過濾低品質內容。另外訓練一個線性分類器,區分「會被維基百科引用的網頁」和隨機網頁,只保留前者。
- C4:作者發現加入不同方式處理過的 CommonCrawl 有幫助,所以也加入 T5 的 C4。它的品質過濾主要靠標點、字數、句數這類規則,和 CCNet 不同。
- GitHub:只保留 Apache、BSD、MIT 授權的專案,依行長與英數字元比例過濾,再做檔案層級的完全去重。
- Wikipedia:2022 年 6 到 8 月的版本,涵蓋 20 種使用拉丁或西里爾字母的語言。
- 書籍:古騰堡計畫的公有領域書籍,以及 The Pile 中的 Books3;內容重疊超過 90% 的書只留一本。
- ArXiv:LaTeX 原始檔,刪掉第一節之前的內容、參考文獻與註解,並把作者自訂的巨集展開。
- StackExchange:28 個最大站的問答,答案按分數由高到低排列。
分詞用 SentencePiece 的 BPE,數字一律拆成單個位數,未知的 UTF-8 字元退回位元組表示。總計約 1.4 兆個 token,多數資料只看一次,維基百科與書籍約看兩次。
架構:三個借來的改動
LLaMA 是標準的 Transformer 解碼器,加上三個前人提出、已經被大模型用過的改動,論文也在括號裡標出來源:
- Pre-normalization(GPT-3):正規化每個子層的輸入,而不是輸出,以提升訓練穩定性;正規化函數用 RMSNorm。
- SwiGLU(PaLM):前饋層的 ReLU 換成 SwiGLU。
- 旋轉位置編碼 RoPE(GPT-Neo):拿掉絕對位置編碼,在每一層加上 RoPE。
SwiGLU 那一項有個細節。論文說前饋層的寬度用 ,不是 PaLM 的 。原因是 SwiGLU 有三個矩陣,標準的前饋層只有兩個;寬度乘上三分之二,參數量才和原本差不多。官方程式碼再把它進位到 256 的倍數。以 LLaMA-7B 的 算一次:
d, multiple_of = 4096, 256          # LLaMA-7B 的 d_model

hidden = int(2 * (4 * d) / 3)       # 4d 的三分之二
hidden = multiple_of * ((hidden + multiple_of - 1) // multiple_of)  # 進位到 256 的倍數
print(hidden)                       # 11008

relu_ffn = 2 * d * (4 * d)          # 兩個矩陣:d→4d、4d→d
swiglu_ffn = 3 * d * hidden         # 三個矩陣:W、V 與輸出矩陣
print(f"{relu_ffn / 1e6:.1f}M {swiglu_ffn / 1e6:.1f}M")  # 134.2M 135.3M
每一層的前饋參數幾乎一樣,換到的是 SwiGLU 的品質提升。
四個尺寸的設定如下,所有模型的批次都是 400 萬個 token:
| 參數 | 注意力頭數 | 層數 | 學習率 | 訓練 token | |
|---|---|---|---|---|---|
| 6.7B | 4,096 | 32 | 32 | 1.0T | |
| 13.0B | 5,120 | 40 | 40 | 1.0T | |
| 32.5B | 6,656 | 52 | 60 | 1.4T | |
| 65.2B | 8,192 | 64 | 80 | 1.4T |
整理自原論文 Table 2。
最佳化器是 AdamW(、),餘弦學習率排程降到最大值的 10%,權重衰減 0.1,梯度截斷 1.0,暖身 2,000 步。
讓訓練跑得快
作者用了幾項工程最佳化:
- 因果注意力的高效實作:來自 xformers 函式庫,不儲存注意力權重,也不計算被因果遮罩擋掉的 key/query 分數。
- 減少反向傳播時的重算:保留計算代價高的激活值,例如線性層的輸出;為此手寫了 Transformer 層的反向傳播,不靠 PyTorch 的自動微分。
- 模型平行與序列平行,並盡量讓激活值的計算與 GPU 之間的通訊重疊。
訓練 65B 時,每張 GPU 每秒約處理 380 個 token。用 2,048 張 80GB 的 A100,看完 1.4 兆個 token 大約要 21 天。
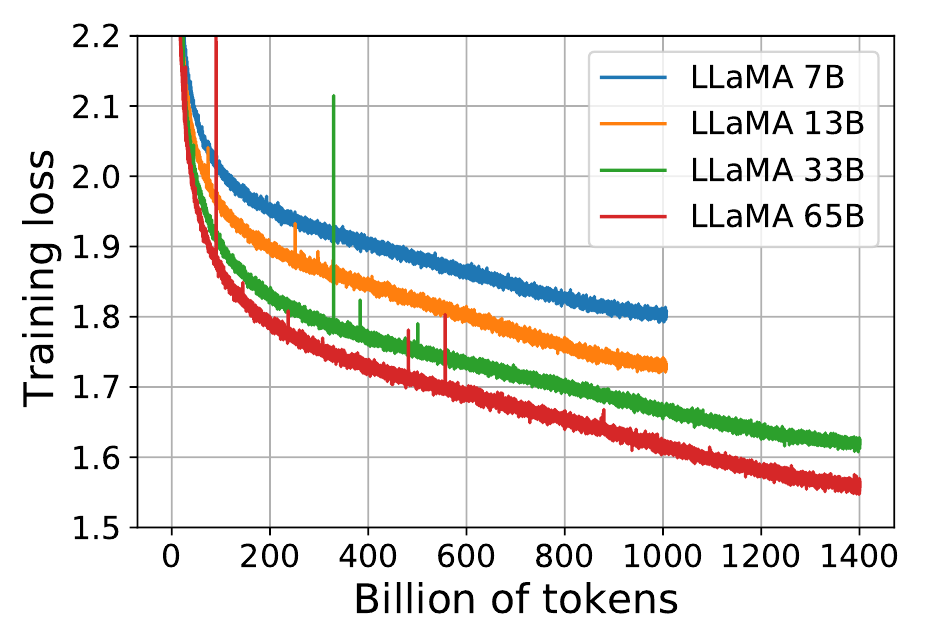
這張圖支撐了前面的主張。四條訓練損失曲線到最後都還在往下走,7B 在 1 兆個 token 時也沒有變平。
討論
主要結果
作者比較了 20 個評測,對象包括沒公開的 GPT-3、Gopher、Chinchilla、PaLM,以及公開的 OPT、GPT-J、GPT-Neo。數字都取自各自的論文。
常識推理(零樣本,8 個評測)。LLaMA-65B 除了 BoolQ 以外都勝過 Chinchilla-70B,除了 BoolQ 和 WinoGrande 以外都勝過 PaLM-540B。LLaMA-13B 在多數評測上勝過 GPT-3。
閉卷問答。Natural Questions 上,65B 的零樣本是 23.8,64-shot 是 39.9,PaLM-540B 分別是 21.2 與 39.6。LLaMA-13B 在兩個閉卷問答評測上也能和 GPT-3、Chinchilla 相比,作者特別提到它推論時只需要一張 V100。
數學。GSM8K 上,LLaMA-65B 單次作答是 50.9,略低於用 385 億個 token 的 arXiv 與數學網頁微調過的 Minerva-62B(52.4)。改用多數決,也就是對同一題取樣多個答案再投票,LLaMA-65B 是 69.7,勝過 Minerva-62B 的 68.5。LLaMA 沒有用任何數學資料微調。
程式。HumanEval 的 pass@1,LLaMA-65B 是 23.7,PaLM-62B 是 15.9,PaLM-540B 是 26.2。13B 以上的 LLaMA 在 HumanEval 和 MBPP 上都勝過 LaMDA-137B。這幾個都是通用模型,沒有特別為程式碼訓練或微調。
MMLU 是 LLaMA 明顯落後的地方。65B 的 5-shot 平均是 63.4,Chinchilla-70B 是 67.5,PaLM-540B 是 69.3。作者認為原因是書籍與學術論文太少。ArXiv、古騰堡與 Books3 加起來只有 177GB,Gopher、Chinchilla、PaLM 用了高達 2TB 的書籍。他們也用這點解釋 Gopher 為何在 MMLU 上勝過 GPT-3,其他評測卻差不多。
訓練過程中的表現
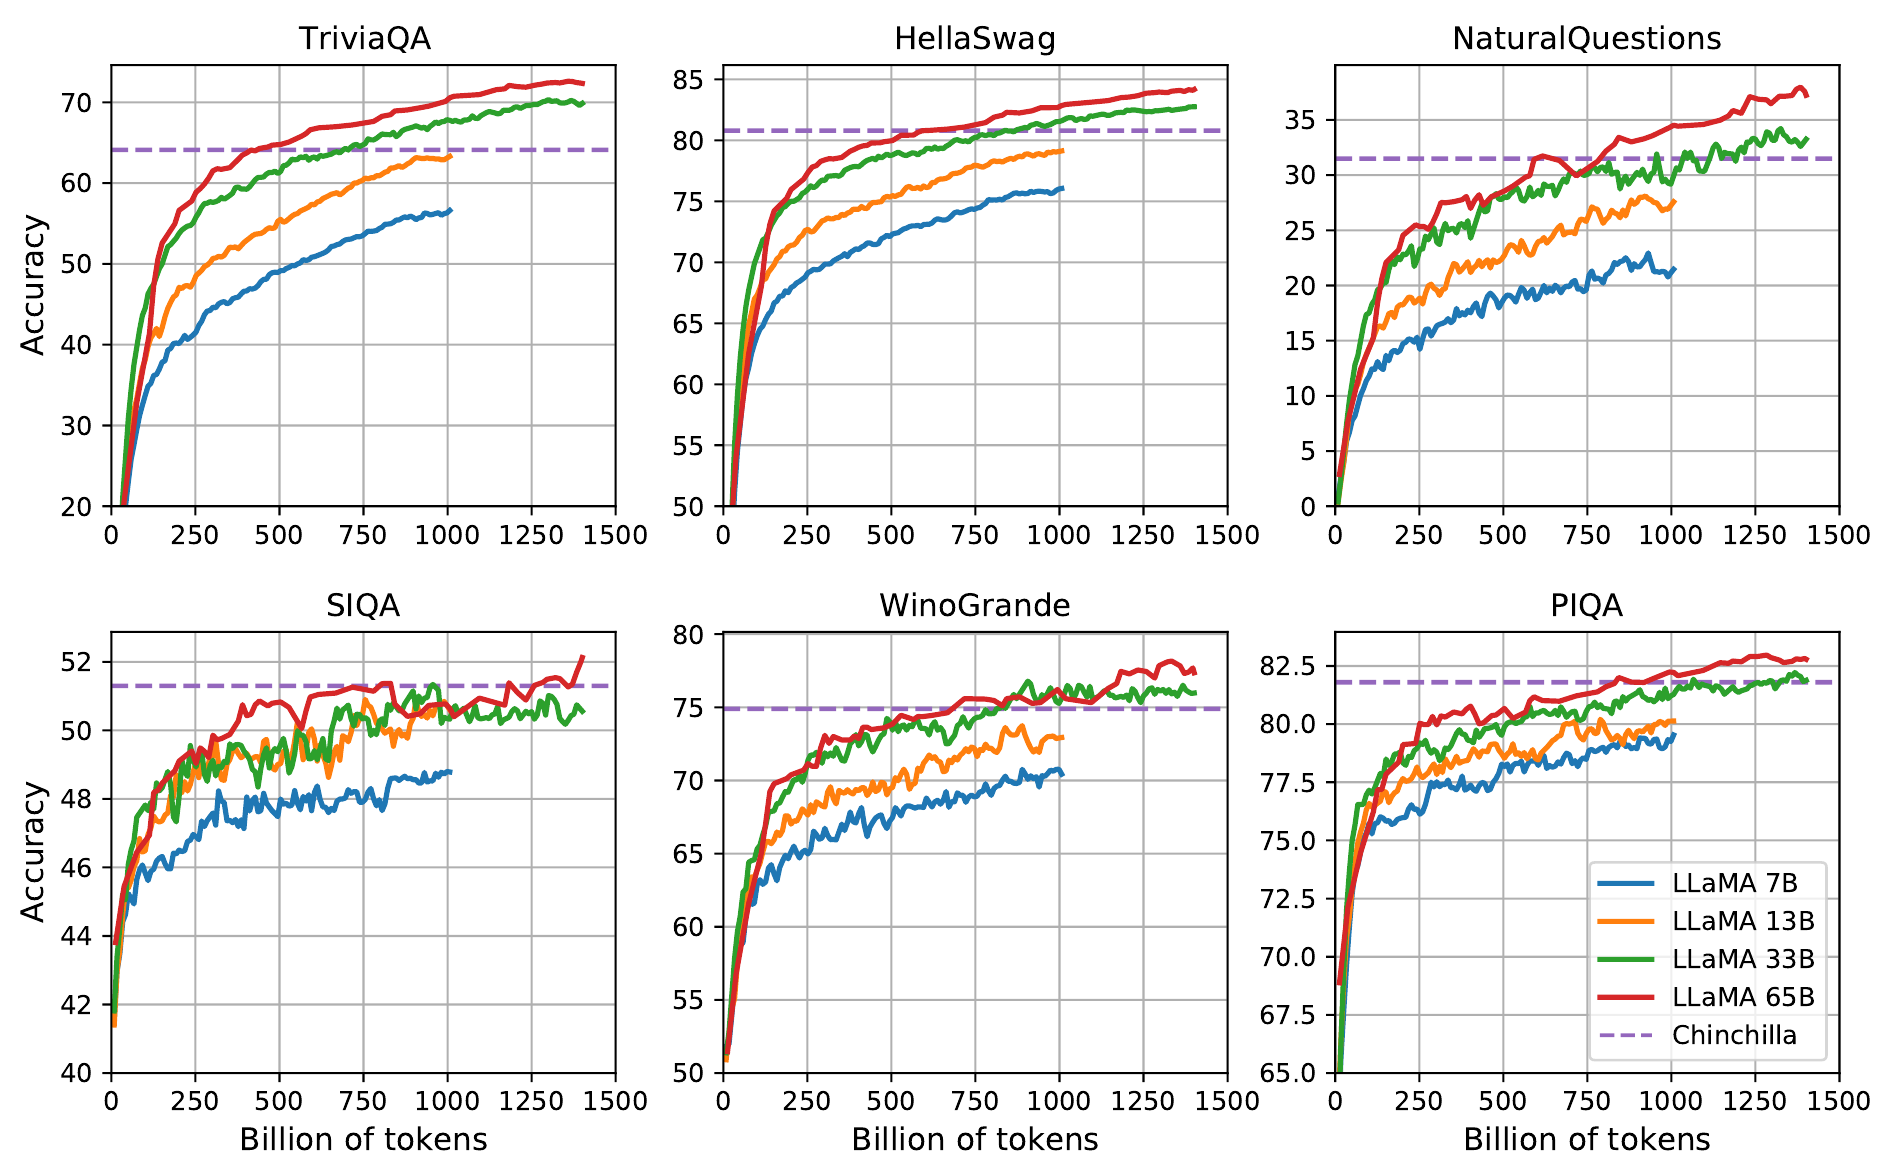
作者在訓練過程中持續追蹤幾個評測。多數評測穩定上升,和訓練損失一起改善。兩個例外值得注意。SIQA 的分數波動很大,作者認為這個評測可能不可靠;WinoGrande 的分數和困惑度的關聯較弱,33B 與 65B 在整個訓練過程中幾乎一樣。
簡單的指令微調
作者也做了一個小實驗,照 Chung 等人(Flan-PaLM)的流程,對 65B 做少量指令微調,稱為 LLaMA-I。MMLU 從 63.4 升到 68.9,勝過 OPT-IML-Max 30B(43.2)與 Flan-PaLM 62B(59.6)等中型指令微調模型,但離當時的最佳,code-davinci-002 的 77.4,還有一段距離。作者強調這不是本文重點,只做了一次實驗。
偏見、毒性與真實性
毒性。在 RealToxicityPrompts 上,毒性隨模型變大而上升,在要求「禮貌、尊重、無偏見地完成句子」的提示下更明顯,65B 是 0.141,7B 是 0.081。
刻板印象。在 CrowS-Pairs 上,LLaMA-65B 的平均偏見分數 66.6,略好於 GPT-3(67.2)與 OPT-175B(69.5),但宗教類別比 OPT 高了約 10 個百分點,其次是年齡與性別。作者推測這些偏見來自 CommonCrawl。
性別與職業。WinoGender 上,模型對「they/them/someone」的代名詞判斷明顯比「he」「she」準。在代名詞和職業的多數性別不一致的「陷阱」題上,錯誤更多,代表模型會用職業的刻板性別來判斷,而不是看句子裡的證據。
真實性。TruthfulQA 上,65B 有 57% 的回答是真實的,同時真實且有資訊量的是 53%,高於 GPT-3 175B 的 28% 與 25%,作者也說正確率仍然偏低,模型很可能會編出錯誤的答案。
算力與碳排
訓練 LLaMA-65B 用了約 102 萬個 A100 GPU 小時。作者估計整個開發過程約 5 個月、用 2,048 張 A100,總耗電約 2,638 MWh,以美國平均電網碳強度換算約 1,015 噸二氧化碳當量。他們的期待是,釋出模型可以讓其他人不必再重新訓練一次。
釋出之後
LLaMA 的權重以非商業授權、申請制的方式提供給研究者。一週後,權重就在 4chan 上以種子檔流出,Meta 隨後對 Hugging Face 等平台上的副本發出下架要求,但檔案已經廣為流傳。
接下來幾週的發展,說明了這組權重的影響。2023 年 3 月 13 日,Stanford 的研究者發表 Alpaca。他們用 OpenAI 的 text-davinci-003 產生 52,000 筆指令示範,微調 LLaMA-7B,宣稱整個重現成本低於 600 美元;在他們自己的盲測中,Alpaca 對 text-davinci-003 是 90 勝 89 負。這組評測規模不大,但它讓「開放權重加上少量指令資料」成了很多人跟著做的路線。
論文透明列出的資料來源也帶來另一面。Books3 收錄了大量受版權保護的書籍。2023 年 7 月,包括 Sarah Silverman 在內的幾位作家對 Meta 提起版權訴訟,指控 LLaMA 用他們的書訓練,Books3 是訴訟的焦點之一。
五個月後,Meta 發表了可商用的 Llama 2;再一年,Llama 3 把同一個方向推得更遠,預訓練資料增加到約 15 兆個 token。
結論
LLaMA 沒有發明新元件,它換了一個問題。Chinchilla 問訓練算力怎麼花最划算,LLaMA 問部署之後怎麼最省,答案是讓小模型讀很多書,13B 讀了一兆個 token,就在多數評測上追過 GPT-3。
挑模型的時候可以記住這個取捨。訓練多讀的 token 只花一次,推論卻是每個請求都要把整個模型跑一遍;要長期上線的服務,小一點、讀多一點的模型通常比較划算。
順帶一提,到了第二代,名字就從 LLaMA 改成了 Llama,大家總算不用再數大寫字母了。