原始論文
Reflexion: Language Agents with Verbal Reinforcement Learning
- 發表版本
- NeurIPS 2023會議
- arXiv 首次提交
- arXiv:2303.11366
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{reinforcementlearningreflexion2023,
  title = {{Reflexion: Language Agents with Verbal Reinforcement Learning}},
  author = {Noah Shinn and Federico Cassano and Edward Berman and Ashwin Gopinath and Karthik Narasimhan and Shunyu Yao},
  year = {2023},
  eprint = {2303.11366},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2303.11366}
}
2023 年春天,用語言模型當代理(agent)的研究一下子多了起來。ReAct 讓模型邊想邊查資料,Toolformer 讓模型自己呼叫工具,還有人讓模型在遊戲、網頁、程式環境裡做事。
這些代理都一樣,失敗了也學不到東西。傳統的強化學習可以從失敗中學習,但要大量的嘗試和昂貴的微調,對幾百億參數的模型來說不太實際。所以當時的代理只能靠提示裡的範例,這一次做錯,下一次還是照樣錯。
美國 Northeastern University 的 Shinn 等人(後來的版本加入了 Princeton 的 Narasimhan 和 Yao)換了一個思路。人做錯事之後,會回想自己哪裡做錯、下次該怎麼做;模型也可以這樣做,把反省寫成文字,放進下一次嘗試的提示裡。權重完全不動,學到的東西全部寫在文字裡。
定義問題
代理在環境裡做一連串的動作,最後拿到回饋。這個回饋常常很稀疏,可能只有「成功」或「失敗」,或者一個分數。
傳統強化學習要從這種訊號裡學,難在功勞分配(credit assignment):一連串幾十個動作,到底是哪一步出錯?只靠一個 0 或 1,很難回答。
作者想問的是,能不能讓語言模型自己把這個稀疏的訊號「放大」成具體的建議,例如「第 3 步拿錯了東西,下次應該先去書桌找檯燈」,再用這段文字引導下一次嘗試?
解決問題
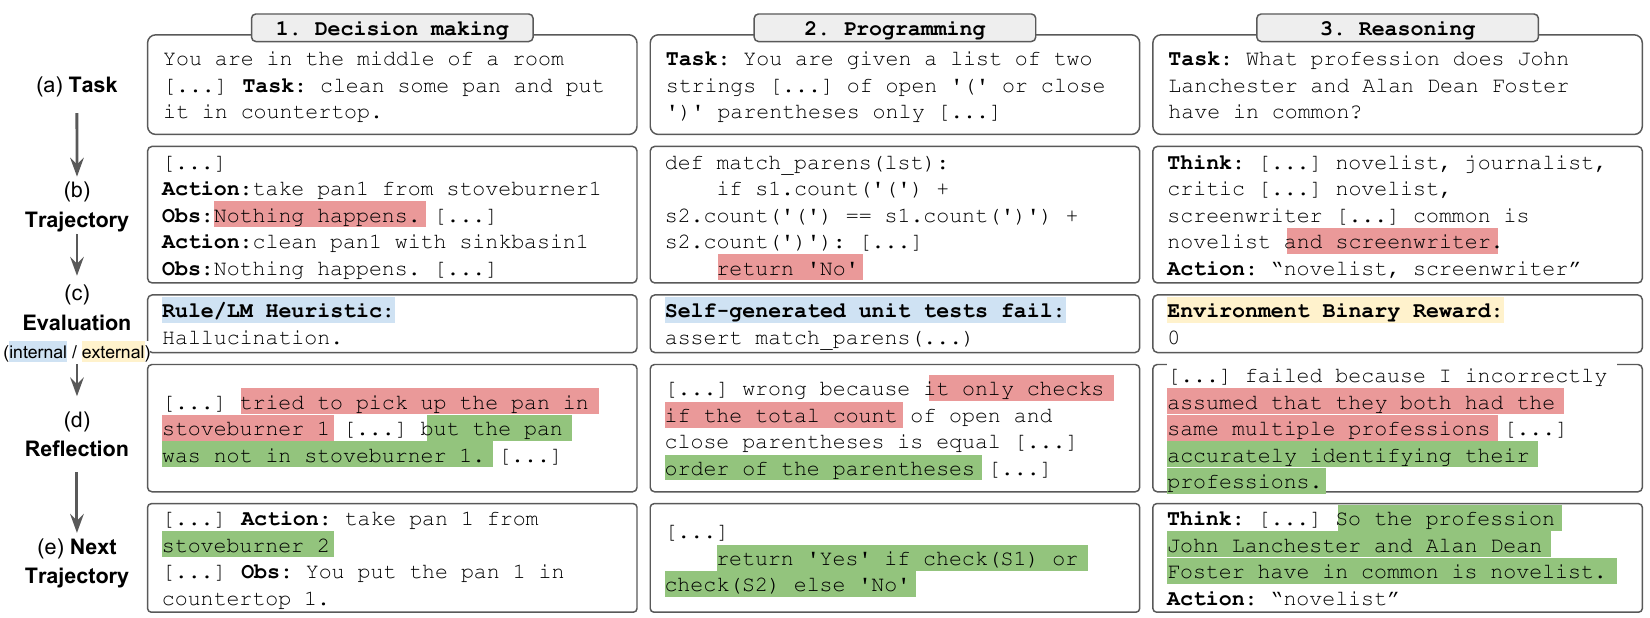
三個模型
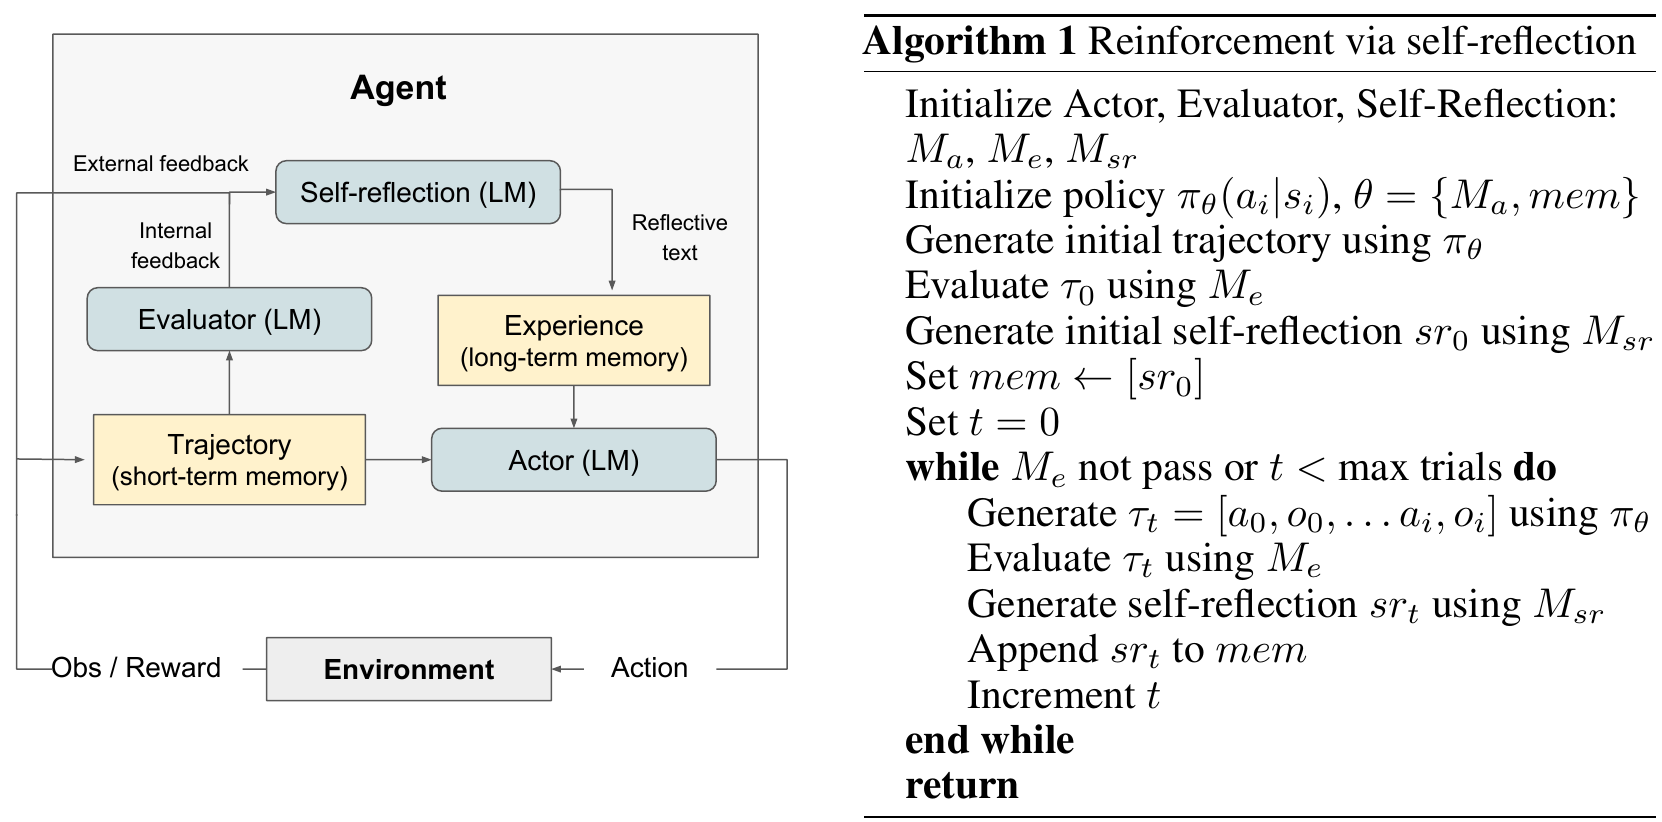
Reflexion 由三個角色組成,三者都可以是同一個語言模型,只是提示不同:
- Actor:在環境裡做事,產生文字和動作。作者試了思維鏈和 ReAct 兩種寫法,並在提示裡加入一段記憶。
- Evaluator:評估這次的表現。推理題用和標準答案完全相同(exact match)來判斷;決策任務用事先寫好的規則,或請另一個語言模型判斷成敗;程式題則跑模型自己寫的單元測試。
- Self-reflection:拿到成敗訊號、這次的軌跡和過去的記憶,寫出一段反省,說明哪裡做錯、下次怎麼做。
兩種記憶
這次嘗試的完整軌跡是短期記憶,細節很多;反省寫成的文字是長期記憶,比較精簡,存的是學到的教訓。下一次嘗試時,Actor 同時看到這兩種記憶。
長期記憶不能無限累積,否則會超過提示的長度上限。作者只保留最近的幾段反省,決策和推理任務是 3 段,程式任務是 1 段。
流程
- Actor 做一次嘗試,得到軌跡 。
- Evaluator 給出分數 。
- Self-reflection 根據 寫出反省 ,放進記憶。
- 重複:Actor 帶著記憶再試一次,評估,寫新的反省,加入記憶,直到 Evaluator 判斷成功,或嘗試次數用完。
作者把它稱為「口語的」強化學習。傳統強化學習的策略由權重決定,這裡的策略是「語言模型 + 記憶」,更新策略的方式是改寫記憶裡的文字。作者也直接承認,這個做法依賴語言模型自我評估的能力,沒有任何保證一定會成功。
討論
決策:AlfWorld
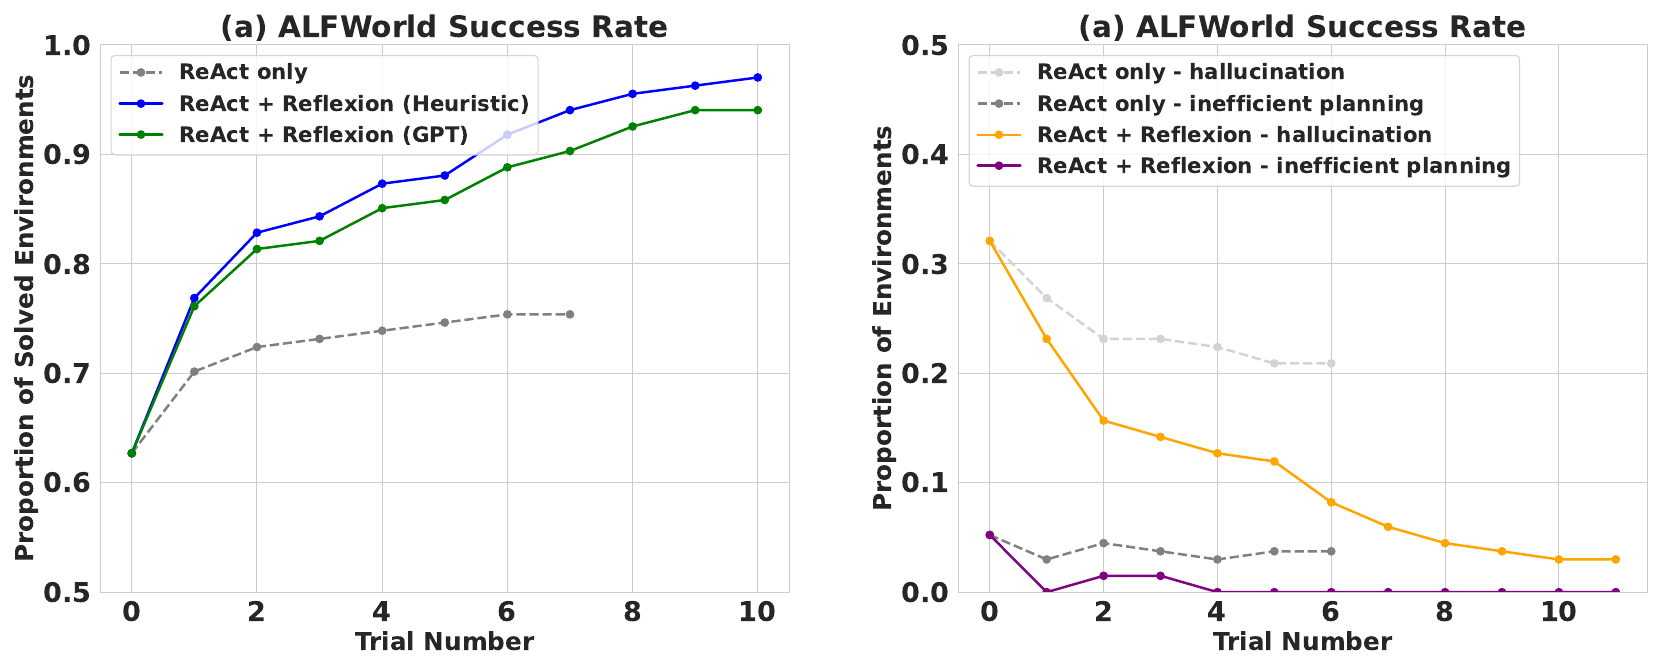
AlfWorld 是文字版的居家環境,代理要用文字指令完成任務,例如找到藏在抽屜裡的鍋鏟、把刀拿到砧板上、把番茄放進冰箱冷卻。作者沿用 ReAct 的設定,在 134 個環境上測試,Actor 是 ReAct。
這個環境只會告訴代理任務完成了沒有,所以 Evaluator 要自己判斷什麼時候算失敗。作者用了兩條簡單的規則。同一個動作重複超過 3 次、得到同樣的回應,就判定為幻覺;這個環境裡的動作超過 30 步,就判定為低效率的規劃。
結果 ReAct + Reflexion 解出 134 個任務中的 130 個,ReAct 單獨使用則在第 6、7 次嘗試之後就不再進步。
右圖把失敗按原因分類。ReAct 最常見的失敗,是以為自己已經拿到某個東西,其實沒有,接著做了一長串動作也找不回錯誤,這類幻覺一直停在 22% 左右。Reflexion 會把很長的失敗軌跡濃縮成幾句提醒,下一次就避開。
附錄有一個具體的例子。任務是「用檯燈檢查杯子」,代理先找到杯子拿起來,再去找檯燈,結果用不了。反省寫道:我的計畫是先找杯子再找檯燈,但任務要用檯燈來檢查杯子,應該先找檯燈;我注意到檯燈在書桌 1 上,下次直接去書桌 1。第二次嘗試,代理三個動作就完成了。
推理:HotPotQA
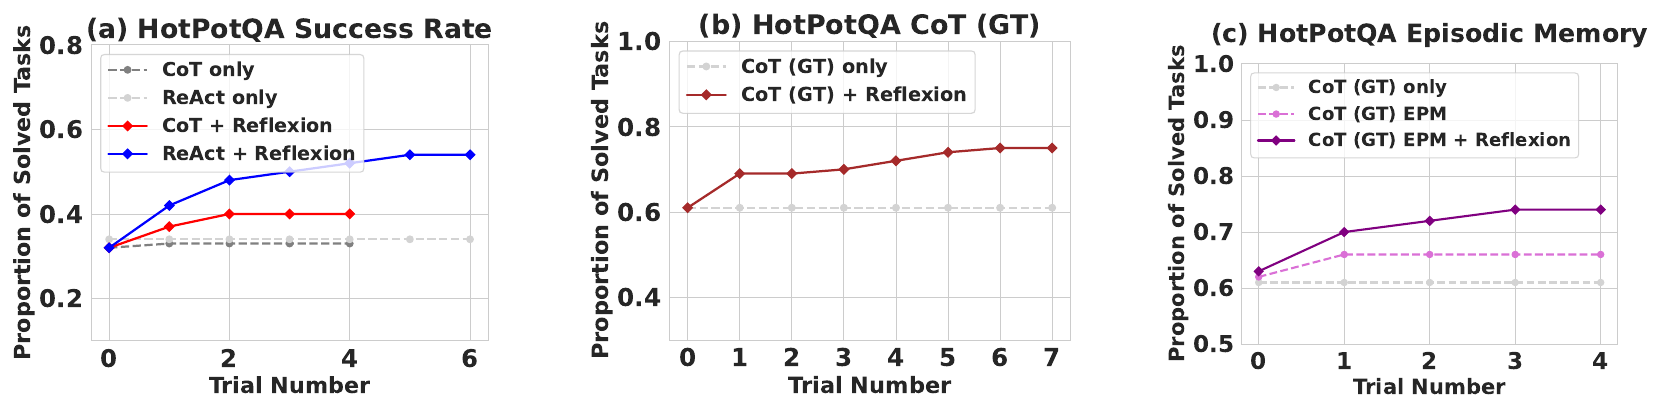
HotPotQA 是要跨好幾篇維基百科文章才能回答的問題。作者測了三種代理,都用 100 題:
- ReAct:可以用維基百科 API 搜尋,邊想邊查。
- 思維鏈:不查資料,只靠推理。
- 思維鏈加上正確的背景段落(CoT (GT)):直接把資料集附的正確段落給模型,單獨測推理能力。
單獨使用時,三種代理重試幾次都沒有新的題目答對,就算用溫度 0.7 取樣也一樣。加上 Reflexion 之後,ReAct 多答對了約 20 個百分點。有正確段落的思維鏈本來就比較高,但仍有 39% 的題目答錯,Reflexion 把準確率再拉高了 14 個百分點。
進步是來自反省,還是只是因為看到了上一次的嘗試?右圖的消融實驗把兩者分開比較。只把上一次的完整軌跡放進提示,也有一些幫助;加上一段第一人稱的反省,再多 8 個百分點。作者據此認為,光是讓模型重寫一次,效果不如先反省再重寫。
這裡要注意評分方式。HotPotQA 每次嘗試之後,環境會用標準答案判斷對錯,告訴代理這次是成功還是失敗。換句話說,代理每次都知道自己答錯了,只是不知道正確答案是什麼。這個設定後面會再談到。
程式:HumanEval、MBPP 和 LeetCode
程式題是 Reflexion 最漂亮的戰場,因為有一個不需要標準答案的評估方式:自己寫測試。
作者先用思維鏈請模型寫出各種單元測試,用語法樹檢查,只留下語法正確的,再從中抽最多 6 個組成測試集。程式寫完後跑這些測試,沒過就反省、重寫,全部通過才交出去。因為整個過程沒有碰到題目隱藏的測試,交出去的那一份仍然算是 pass@1。
| 評測(語言) | 先前最佳 | GPT-4 | Reflexion |
|---|---|---|---|
| HumanEval(Python) | 65.8 | 80.1 | 91.0 |
| HumanEval(Rust) | - | 60.0 | 68.0 |
| MBPP(Python) | 67.7 | 80.1 | 77.1 |
| MBPP(Rust) | - | 70.9 | 75.4 |
| LeetCode Hard(Python) | - | 7.5 | 15.0 |
整理自原論文 Table 1;先前最佳是 CodeT 搭配 GPT-3.5 或 Codex,單位為 pass@1 %。
- Rust 的題目是用 MultiPL-E 把 Python 題目自動翻譯過去的,HumanEval 只取最難的 50 題,用來展示方法和語言無關。
- LeetCode Hard 是作者新做的 40 題,都在 2022 年 10 月 8 日(GPT-4 的預訓練資料截止日)之後才公開。
- 這裡的 GPT-4 是作者自己測的,HumanEval 80.1%,比 GPT-4 技術報告寫的 67.0% 高。
HumanEval Python 從 80.1% 升到 91.0%,但 MBPP Python 反而從 80.1% 掉到 77.1%。作者追查原因,發現問題出在模型自己寫的測試。
測試可能出兩種錯。一種是測試太鬆,錯誤的程式也全部通過,代理就會提早交出錯誤的答案;另一種是測試本身寫錯,正確的程式通不過,代理會去反省一個其實沒錯的程式。作者認為後者比較能接受,代理還有機會從反省中發現是測試錯了。
在 MBPP Python 上,「測試全部通過、程式卻是錯的」的比例是 16.3%,在 HumanEval Python 上只有 1.4%。兩者的基準準確率差不多,差別就在測試的品質。
拿掉一部分會怎樣
作者在 HumanEval Rust 最難的 50 題上做了消融,基礎模型是 GPT-4:
| 做法 | 自己寫測試 | 反省 | pass@1 |
|---|---|---|---|
| 基礎模型 | 否 | 否 | 60% |
| 不寫測試 | 否 | 是 | 52% |
| 不反省 | 是 | 否 | 60% |
| Reflexion | 是 | 是 | 68% |
整理自原論文 Table 3。
不寫測試、只反省,反而比基礎模型更差。代理無法判斷目前的程式對不對,只能把所有回合都用完,一路修改,把原本正確的程式也改壞了。
有測試、不反省,則完全沒有進步。測試和編譯器確實抓到了語法和邏輯錯誤,但模型直接重寫時,修改的內容沒有對應到這些錯誤。作者據此認為,沒有反省、只靠盲目試錯的除錯方法,在 Rust 這種較難的任務上效果不大。
模型要夠強
附錄在不同模型上重做了一次。開源的 starchat-beta 在 HumanEval Python 上,用不用 Reflexion 都是 26%;HotPotQA 上,text-davinci-003、gpt-3.5-turbo、gpt-4 加上 Reflexion 都有進步。作者的結論是,能寫出有用的自我修正,是比較強、比較大的模型才有的能力。
限制
- 局部最佳:Reflexion 本質上是用文字做策略最佳化,仍可能卡在不夠好的解。附錄的 WebShop 實驗就是例子,代理要在購物網站上找出符合需求的商品,跑了 4 次嘗試都沒有進步,寫出來的反省也沒有幫助。作者認為這類任務需要很多樣、很有創意的探索,例如換不同的搜尋關鍵字,Reflexion 做不到。
- 記憶很簡單:只是一個保留最近幾段的滑動視窗,作者建議未來改用向量資料庫或 SQL 資料庫。
- 測試的限制:非確定性的函式、會呼叫外部 API 的函式、輸出依硬體而異或涉及平行處理的函式,都很難寫出準確的測試。
作者也提醒,自動寫程式的實驗要在隔離的環境裡跑,因為生成的程式在執行前沒有經過任何檢查。
後來的事
2023 年 10 月,Google DeepMind 與 UIUC 的 Huang 等人在 Large Language Models Cannot Self-Correct Reasoning Yet 裡,指出這類自我修正研究的一個共同問題。包括 Reflexion 在內的做法,都用標準答案來決定什麼時候停止修正:答對了就停,答錯了才繼續。在真實情境裡,我們不會知道正確答案。
他們設計了一個很尖銳的對照組。同樣用標準答案決定要不要再試,但「修正」的方式是從剩下的選項裡隨便換一個。CommonsenseQA 是五選一,每答錯一次就排除一個選項,最多猜四輪一定猜中。
GPT-3.5 和 GPT-4 在 CommonsenseQA 上的起點分別是 75.8% 和 82.0%。亂猜兩輪,GPT-3.5 就到 87.9%,和讓模型自我修正兩輪的 89.7% 差不多;GPT-4 亂猜是 91.0%,比自我修正的 85.5% 還高;猜四輪,兩個都是 100%。只要有人告訴你「錯了,再來」,就算完全不動腦也會越來越準。拿掉標準答案之後,他們發現模型自己修正推理題,成績不升反降。
這個批評主要針對推理題。程式題的情況不同,測試和執行器本身就是不需要標準答案的檢查,Reflexion 在 HumanEval 上的 91% 正是用這種方式拿到的。Huang 等人也提到,程式生成這類可以用執行器和單元測試驗證的任務,是另一回事。
後來的程式代理也走了這條路:寫程式、跑測試、讀錯誤訊息、修改,反覆進行。差別在於測試換成了專案原本的測試,回饋換成了真實的錯誤訊息。
結論
Reflexion 不改權重,把每次失敗的經驗寫成一段反省,放進下一次嘗試的提示裡。AlfWorld 解出 134 個任務中的 130 個,HotPotQA 多答對約 20 個百分點,HumanEval Python 的 pass@1 從 80.1% 到 91.0%。
它最有說服力的地方在程式題。測試是模型自己寫的,交出去之前沒有看過任何標準答案;消融也說明了測試和反省缺一不可,只反省不測試,成績反而更差。
推理題那部分就要打個折扣,代理每次都被告知「答錯了」,而這正是真實世界最缺的那一項資訊。反省寫得再好,也得先有人說它錯了。