原始论文
The Road Less Scheduled
- 发表版本
- NeurIPS 2024会议
- arXiv 首次提交
- arXiv:2405.15682
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{optimizersschedulefree2024,
  title = {{The Road Less Scheduled}},
  author = {Aaron Defazio and Xingyu Alice Yang and Harsh Mehta and Konstantin Mishchenko and Ahmed Khaled and Ashok Cutkosky},
  year = {2024},
  eprint = {2405.15682},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2405.15682}
}
2024 年 8 月 1 日,MLCommons 公布了首届 AlgoPerf 训练算法竞赛的结果。
如果你没听说过 AlgoPerf,它比的是优化器与训练流程本身。模型、数据和硬件(8 张 V100)都固定,看谁最快把 8 个任务训练到指定的验证分数,任务横跨机器翻译、图像分类、MRI 重建、语音识别、分子图与点击率预测。比赛分两组。外部调参组可以给出一个超参数搜索范围,由主办方替你抽 5 组设置来试;自调参组不能在训练之外搜索超参数,方法必须在单次训练里自己应付所有任务,最常见的做法就是一套设置通吃,作为补偿,训练时间上限放宽到 3 倍。
自调参组只有一份投稿赢过主办方的基线,就是 Meta 与 Samsung 研究员提交的 Schedule Free AdamW,分数 0.8542;基线是 NAdamW 加线性预热与 cosine 衰减,0.8194;其他四份都在 0.4 以下。这个方法最大的特点,是完全不用学习率调度,也不必事先知道要训练多少步。
背后的论文叫〈The Road Less Scheduled〉,标题借用了 Frost〈The Road Not Taken〉里「less traveled」那一句,结论一节也真的引用了原诗。第一作者是 Meta FAIR 的 Aaron Defazio,他之前的 D-Adaptation 也在处理「学习率怎么设」这件事。代码 4 月就以 schedulefree 包的形式发布到 PyPI,论文到 5 月底才放上 arXiv。
定义问题
调度需要终点
现在最常用的学习率调度是 cosine 和线性衰减,两者都要先知道总步数 ,曲线才画得出来。 设错了代价不小,Chinchilla 的附录测过,cosine 周期设得比实际步数长 25% 以上,模型就明显变差;训练到一半想延长,也得重新规划。
平均在理论上很好,实际上很差
另一条路是不用调度,改成对参数取平均。Polyak–Ruppert 平均是最古典的做法,SGD 照常用固定步长走,另外维护一个所有走过的点的平均:
让 恰好是 的等权平均。按照经典的收敛理论,凸的 Lipschitz 问题应该交出 ,而不是最后一步的 。实际上,这个平均比 SGD 的最后一步差很多,作者称之为优化领域的民间共识。
近年的理论又指出,线性衰减调度本身就能让最后一步达到最坏情况下的最优速率。调度和平均在理论上扮演差不多的角色,但调度得先知道 。作者于是问,有没有一种平均方法,实际表现追得上调度,又不放弃理论保证?
解决问题
三个序列
Schedule-Free SGD 的更新是式 (3) 到 (5):
起点 。三个序列各有分工:
- 是基础序列,底层的优化器在这里走步,这里就是普通的 SGD。
- 是评估序列,是 的等权平均,也是最后交出去的模型。
- 是算梯度的位置,在 和 之间插值。
和 Polyak–Ruppert 平均相比,只多了第一行,梯度不在 上算,改在 与 之间的 上算。
两个极端
控制 偏向哪一边。 时 ,梯度在 上算,就是 Polyak–Ruppert 平均。 时 ,梯度在平均点上算,这叫 primal averaging,同样有最坏情况下的最优保证,但一般认为收敛太慢,不实用。
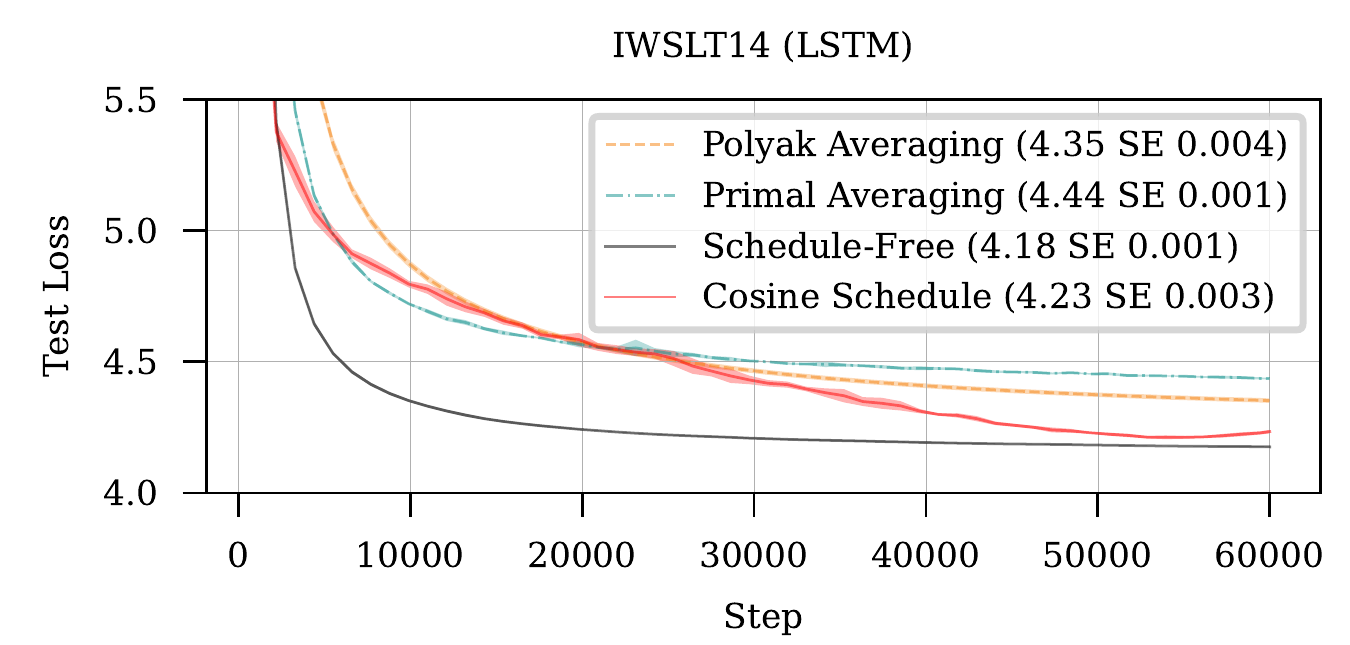
这张图是 IWSLT14 德译英的 LSTM。两个极端都输给调好的 cosine 调度,Polyak 平均最后是 4.35,primal averaging 是 4.44,cosine 是 4.23。Schedule-Free 取中间,,最后 4.18,而且前 1 万步就降得比谁都快。
作者的解释是, 移动得比 快,所以插值保留了 Polyak 平均收敛快的优点; 又被拉向 ,让算梯度的位置不会离交出去的模型太远,增加稳定性。
另一种动量
的角色很像动量,论文也把它和常见的指数移动平均(EMA)动量做了比较。第 步的梯度 进入 时,立即的影响是 , 时就是 ,这和 EMA 动量一样。差别在剩下的 90%。EMA 动量在接下来大约 10 步内就把大部分加完;Schedule-Free 则是通过 这个平均,非常缓慢地把它加进来。
这种动量在理论上没有副作用。Theorem 1 说,若 是凸函数、每个样本的损失 都是 -Lipschitz、样本独立同分布,取 ( 是起点到最优解的距离),那么对 里的任何 :
这是非光滑凸问题的最优速率,连常数都一样。相比之下,EMA 动量在同一个设置下,反而会让最坏情况的保证变差。
不就是递减调度吗?
读到这里你可能会问, 的更新里有一个 ,这不就是一个递减的学习率吗?
某种意义上是的。作者用 Figure 4 说明,每一步的梯度最后在 与 里各占多少比例:
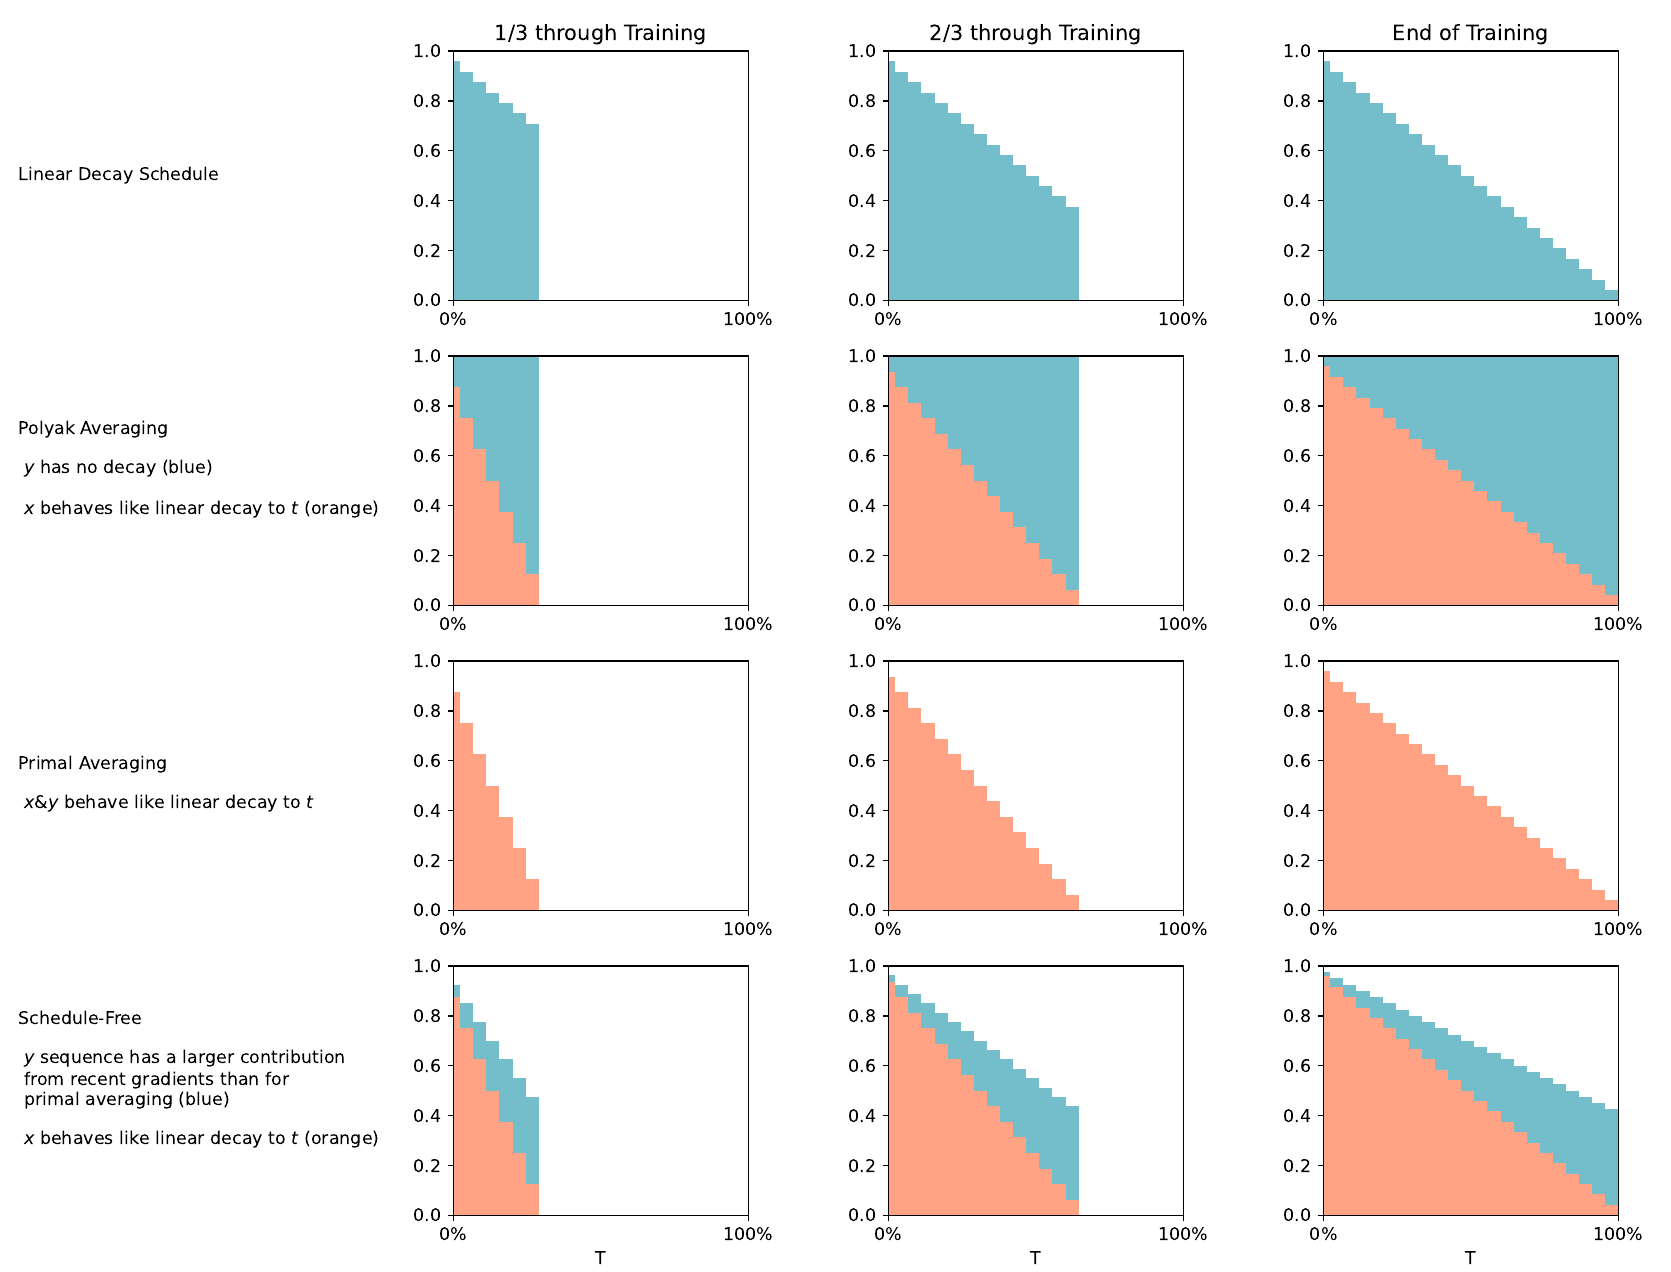
先看第一行。线性衰减调度走到 1/3、2/3、终点时,每一步的梯度按当时的学习率被加进参数,越靠后的步子越小,所以是一个斜坡;但这个斜坡的终点固定在 。
再看下面三行的橙色部分,也就是 。三种平均方法的 ,在每个时间点都长得像一个终点就在当下 的线性衰减。平均能取代调度,原因就在这里。它其实隐含了一个调度,只是这个调度的终点会跟着 往前移,不必事先知道 。
蓝色部分是 ,三种方法的差别在这里。Polyak 平均的 就是 ,每一步的梯度都完整算进去,训练后期近期梯度的比重比调度大得多;primal averaging 的 就是 ,近期梯度被压得很小,前期收敛慢;Schedule-Free 在两者之间,对近期梯度的比重稍微补强。
附录 B 把这件事写成代数。令 是基础优化器的一步,,那么在等权平均、 固定时, 每一步的实际移动量是:
也就是一个动量项,加上基础优化器那一步的 倍。如果让 随时间变化,恰好取成 时,动量项的系数会整个消掉,剩下的就是线性衰减调度。Schedule-Free 选择固定 ,所以不需要 。
理论覆盖到哪里
Theorem 1 其实是更一般的 Theorem 2 的特例。Theorem 2 允许任意的在线学习算法产生 、任意的平均权重 与插值系数 ,把它们的 regret 转成随机优化的收敛保证,也就是一种 online-to-batch conversion。设 得到经典的 Polyak 平均, 得到 primal averaging(Defazio 先前的研究指出它等价于 heavy-ball 动量), 则得到线性衰减调度的最后一步保证。附录 C 再把它收紧成等式,推出光滑问题上的加速速率。
条件也要说清楚。这些保证都在凸问题上;Theorem 1 的步长 里还藏着 ,换成任何时候都成立的 ,实际效果又很差。实践中大家用的是大得多的固定步长 。Theorem 3 说明,在一个训练中就能检查的条件下,这么大的步长也能拿到最优速率;作者在 4.1 节的所有问题上检查过,条件都成立,但他们也承认,随机问题下大步长何时可用,还没有完整的理解。
另一个佐证来自二次函数。作者随机生成 10 个 20 维的二次问题,扫描 和 。步长小的时候 几乎没有影响;步长大的时候, 是收敛的关键。
Schedule-Free AdamW
把基础优化器换成 AdamW,就是 Algorithm 1:
- ,用插值取代动量。
- 在 上算梯度 。
- 。
- ,把预热与偏差修正都并进学习率。
- 。
- 。
- 。
有几个地方和 AdamW 不一样。
- 没有一阶矩。 拿去做插值了,所以只需要存 、 和 ,显存占用和 AdamW 一样;SGD 版本也和 SGD 加动量一样。
- 还是要预热。 作者在 4.4 节直说,这个方法仍然需要学习率预热。
- 平均的权重跟着学习率走。 有预热时,作者改用 当平均的权重,预热期间学习率小的那几步,在平均里的比重也跟着变小;他们发现这样做效果大幅改善。预热结束后, 就回到按 的速度递减。
- 权重衰减算在 上。 也可以算在 上,但在 ImageNet 与 NanoGPT 等问题上,算在 明显比较好。
实现细节
训练时算梯度要用 ,评估时要用 ,所以模型参数得在两者之间切换。官方 PyTorch 实现只多存一份 ,参数本身的缓冲区在训练时存 、评估时存 。由 可以解出 ,optimizer.eval() 做的就是这个插值,optimizer.train() 再换回 。
这带来几条使用规则。调用 model.train() 的地方要一起调用 optimizer.train(),model.eval() 的地方要调用 optimizer.eval(),存 checkpoint 前也要切到 eval 模式,否则存下来的是 而不是 。如果代码支持 PyTorch 的 step closure,可以改用 closure 版本,省掉这些切换。
BatchNorm 最麻烦。BN 的 running mean 与 variance 是在训练时、也就是在 上累积的,换成 之后统计量就对不上。官方 README 给的修正是评估前用 跑几十个训练批次,重新累积统计量:
model.train()
optimizer.eval()
with torch.no_grad():
    for batch in itertools.islice(train_loader, 50):
        model(batch)
model.eval()
LayerNorm 这类不依赖批量统计量的归一化层就没有这个问题。README 另外提醒,如果框架另外缓存了一份 fp16 参数(某些 GradScaler 会这样做),也要手动更新,确保评估用的是 。
讨论
实验设置
作者称这是目前规模最大的优化器评测之一,总共 28 个问题,包括 12 个逻辑回归、9 个深度学习任务,以及 AlgoPerf 的 7 个任务。深度学习任务里,CIFAR-10、CIFAR-100、SVHN、ImageNet 用 Schedule-Free SGD,IWSLT14、DLRM、fastMRI、MAE 微调与 NanoGPT 用 Schedule-Free AdamW。
比较的方式是两边都在网格上扫学习率与权重衰减,Schedule-Free 另外在 0.9 与 0.98 两个 中挑一个;在习惯用阶梯调度的任务上,也加上阶梯调度一起比。
一次训练,画出整条前沿
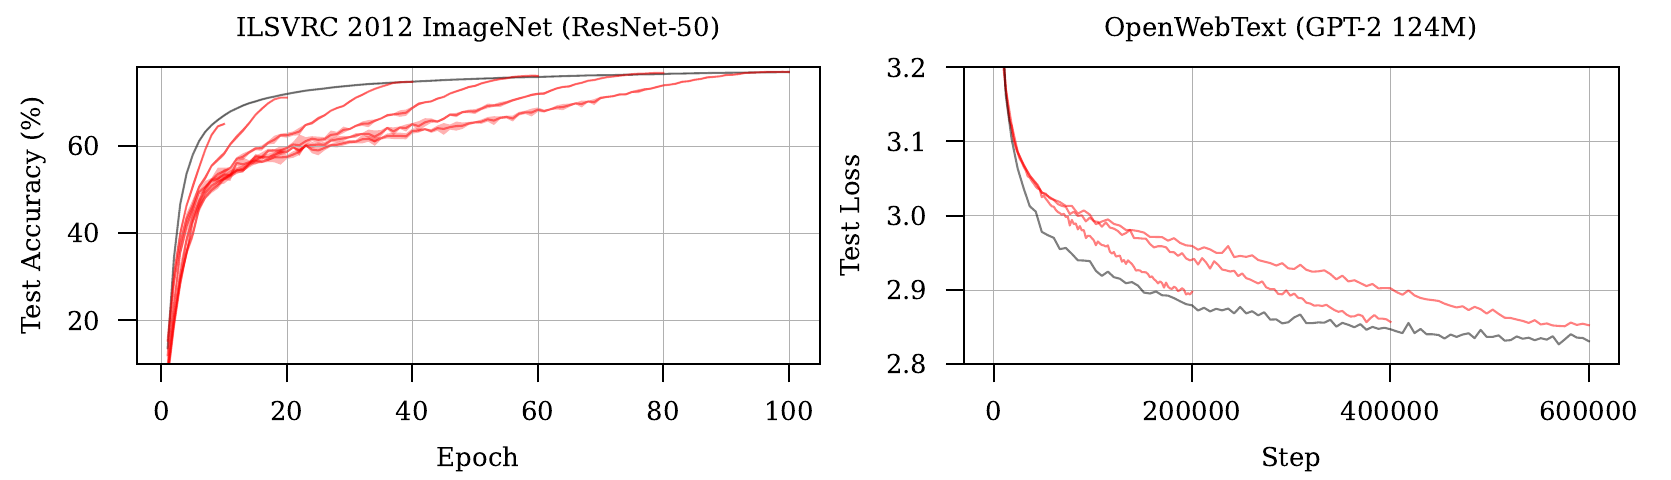
红线是多条长度不同的 cosine 调度,每一条都要到自己的终点才最好;把这些终点连起来,就是「训练时间对表现」的前沿。黑线只训练一次,却在每个时间点都贴着这条前沿,GPT-2 那边甚至在大部分时间都在红线下方。换句话说,训练到哪里停,都差不多等于事先为那个长度调好了一条 cosine。
九个深度学习任务
| 任务 | 指标 | Schedule-Free | 最佳调度 |
|---|---|---|---|
| CIFAR-10 | 准确率 | 96.03 | 95.73 |
| CIFAR-100 | 准确率 | 78.71 | 77.41 |
| SVHN | 准确率 | 98.40 | 98.27 |
| ImageNet | 准确率 | 76.90 | 76.90 |
| IWSLT14 | 损失 ↓ | 4.18 | 4.23 |
| fastMRI | SSIM | 0.9112 | 0.9110 |
| Criteo | 准确率 | 0.7915 | 0.7906 |
| MAE 微调 | 准确率 | 83.54 | 83.52 |
| GPT-2 124M | 损失 ↓ | 2.831 | 2.853 |
整理自原论文 Figure 2 与 Figure 5 的图例。「最佳调度」列是作者调好的 cosine 或线性衰减调度;ImageNet 用 ResNet-50,GPT-2 124M 是 NanoGPT 在 OpenWebText 上的设置。
七个任务胜过调好的调度(fastMRI 与 Criteo 的差距很小),ImageNet 与 MAE 微调打平。差距最大的是 CIFAR-100,多了 1.3 个百分点;ImageNet 上两者都是 76.90%,阶梯调度是 76.49%。
这些数字背后有几个设置值得一看。
- 学习率大很多。 CIFAR-10 上 Schedule-Free 的学习率是 10,cosine 是 0.2;ImageNet 是 1.5 对 0.05;NanoGPT 是 0.005 对 0.0005。作者认为,能用更大的学习率而不发散,可能是收敛较快的原因之一。
- NanoGPT 要特别处理。 时损失会在训练中途快速上升,要改成 0.98 才稳定;梯度裁剪也必须关掉,作者说这一点很关键。
- 梯度没有崩掉。 在 CIFAR-10 上,用 cosine 调度的 SGD 到了后期训练损失接近 0,梯度范数也跟着跌到接近 0,之后几乎学不动;Schedule-Free 没有这个现象。作者认为这可能是它在 CIFAR 与 SVHN 上特别好的原因。
附录还补了 Polyak 平均与 primal averaging 在同一组任务上的结果,两者都明显落后。ImageNet 上分别是 72.84% 与 69.78%,NanoGPT 上 Polyak 平均的损失直接发散。
AlgoPerf
论文里的 AlgoPerf 结果,是作者自己按比赛规则、拿 NAdamW 基线跑 10 个随机种子的比较。ResNet-50 任务被排除,因为 AdamW 与 NAdamW 都达不到目标。剩下 7 个任务,Schedule-Free AdamW 在 WMT、ViT、fastMRI、OGBG 上较快,Conformer 和 Criteo 打平,DeepSpeech 稍慢。作者把这两个任务的表现归因于 BatchNorm,Conformer 与 DeepSpeech 都用 BN,而比赛的代码框架不方便在 上重算 BN 统计量。
附录也列出了自调参组用的那一套设置,学习率 0.0025、、、权重衰减约 0.081、预热 2%,平均的权重另外乘上 。
官方的结果则在 MLCommons 的公告与主办方后来在 ICLR 2025 发表的分析里。自调参组里,Schedule Free AdamW 是唯一胜过基线的投稿,平均训练时间快约 8%,在 8 个基础任务中有 4 个最快;拿它和外部调参组的基线比,在双方都训练成功的 7 个任务上,它不调参也快了约 10%。同一组人也带着 5 组设置的版本参加外部调参组,拿到第二名(0.7077),输给 Distributed Shampoo 的 0.7784;在双方都成功的 7 个任务上,Shampoo 比自调参的 Schedule-Free AdamW 快约 24%。
还有一个小插曲。自调参组的奖金最后没有颁出。MLCommons 的公告写着,由于多份参赛作品的所属机构与工作组主席重叠,未达颁奖条件。
对动量的敏感度
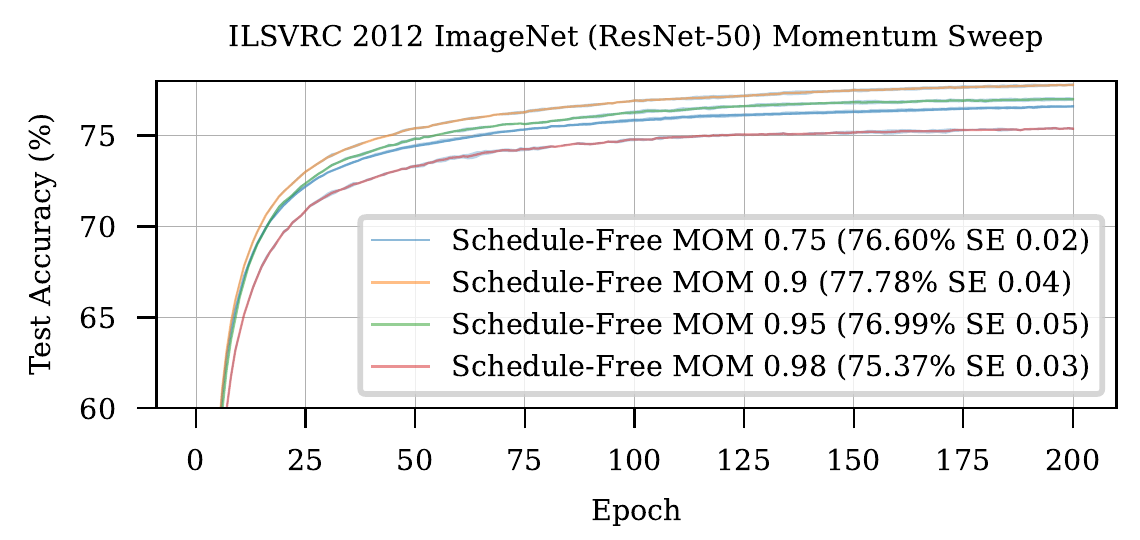
如果最佳的 会随训练长度改变,「不用知道 」就只是把问题从调度搬到动量上。作者在 ImageNet 上跑了比平常长的 200 个 epoch,扫了四种动量。不论在哪个时间点停下来看,最好的都是 。学习率的敏感度也和 cosine 调度差不多,只有训练很短(25 个 epoch 以内)时,大一点的学习率比较好。
不过其他证据没有这么乐观。NanoGPT 本身就得把 调到 0.98;官方 README 也写着,训练特别长时可能要把 提高到 0.95 或 0.98。Hägele 等人(NeurIPS 2024)在 2.1 亿参数的语言模型上,拿 Schedule-Free AdamW 和「固定学习率加最后一段线性冷却」(类似 WSD)比较。 时明显较差,训练后段损失甚至往上走;换成 表现很好,但两组设置都被冷却调度追平或超越。他们也没有再为任何一方多调超参数。
局限
作者在结论里写得很明白,最主要的实际限制是得重新扫学习率与权重衰减,因为最佳值和用调度时不同。其他需要留意的地方,前面大多已经提过。
- 预热仍然需要。论文的实验大多把预热设成总训练量的 5%,AlgoPerf 的设置是 2%,严格说来,这里还是用到了训练长度。
- BN 需要在 上重算统计量;训练与评估要切换模式,存 checkpoint 也一样。
- 理论只覆盖凸问题,大步长何时可用还没有完整的理论。
- 对长时间的语言模型训练比较敏感。
结论
Schedule-Free 用三个序列取代学习率调度。基础优化器在 上走步, 是 的平均,梯度在两者之间的 上计算。平均本身隐含了一个终点随时移动的线性衰减调度,所以不必事先知道 ;在凸问题上,任何 都保有最优的最坏情况速率。9 个深度学习任务中它赢了 7 个、平了 2 个,并拿下 AlgoPerf 2024 自调参组的第一名。
想试用的话,换掉优化器之后,记得在 model.train()、model.eval() 旁边加上对应的 optimizer.train()、optimizer.eval(),存 checkpoint 前切到 eval;有 BN 的模型,评估前用 重算统计量。学习率从调度版本的 1 到 10 倍(AdamW)或 10 到 50 倍(SGD)开始试, 先用 0.9,训练很长时往 0.95、0.98 调,预热照留。
毕竟名字叫 Schedule-Free,Algorithm 1 的第 8 行还是写着 。