原始论文
Samba: Synchronized Set-of-Sequences Modeling for Multiple Object Tracking
- 发表版本
- ICLR 2025会议
- arXiv 首次提交
- arXiv:2410.01806
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multiobjecttrackingsamba2024,
  title = {{Samba: Synchronized Set-of-Sequences Modeling for Multiple Object Tracking}},
  author = {Mattia Segu and Luigi Piccinelli and Siyuan Li and Yung-Hsu Yang and Bernt Schiele and Luc Van Gool},
  year = {2024},
  eprint = {2410.01806},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2410.01806}
}
看一段群舞,你会发现舞者很少各跳各的。队形往左移,所有人一起往左;一个人蹲下,旁边的人可能同时跳起。鸟群转向、球员跑位,也是一样的道理。
这对跟踪是一条很有用的线索。一个舞者被挡住了,我们不知道她现在在哪里,但看看其他舞者怎么动,大致猜得出来。
可是大部分跟踪器都把每条轨迹分开处理。卡尔曼滤波一条轨迹一个;MOTR 这类基于查询的跟踪方法,每个查询也只带着自己上一帧的信息往下传。苏黎世联邦理工学院(ETH)的 Mattia Segu、Luc Van Gool 等人想做一个能同时看「每条轨迹的长期历史」和「轨迹彼此之间关系」的模型,取名 Samba,既是 Synchronized Mamba 的缩写,也是那种讲究整齐划一的桑巴舞。
定义问题
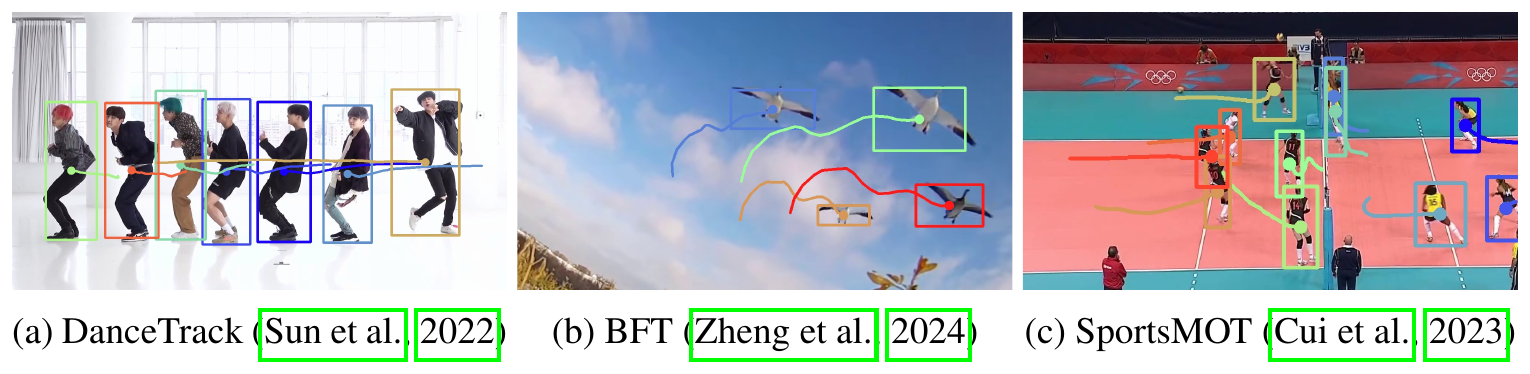
作者把重点放在「基于查询的跟踪」这条路线上,也就是 TrackFormer、MOTR 这一系列。这些方法每一帧用一组跟踪查询,在画面上重新找到上一帧跟踪过的人,再把查询传到下一帧。
这条路线有三个问题:
- 只看上一帧。 查询从这一帧传到下一帧,更早的历史没有被好好利用。MeMOTR 加了一个长期记忆,但用的是指数移动平均,细节被平均掉了。
- 各跟各的。 每个查询独立传播,舞者之间、鸟之间的协同关系完全没有用上。
- 遮挡时只能冻结。 物体被挡住、检测置信度很低的时候,MeMOTR 和 MOTRv2 的做法是冻结查询,停在最后一次看到的状态,等它重新出现。被挡得越久,冻住的状态离真实位置越远。
解决问题
整体架构
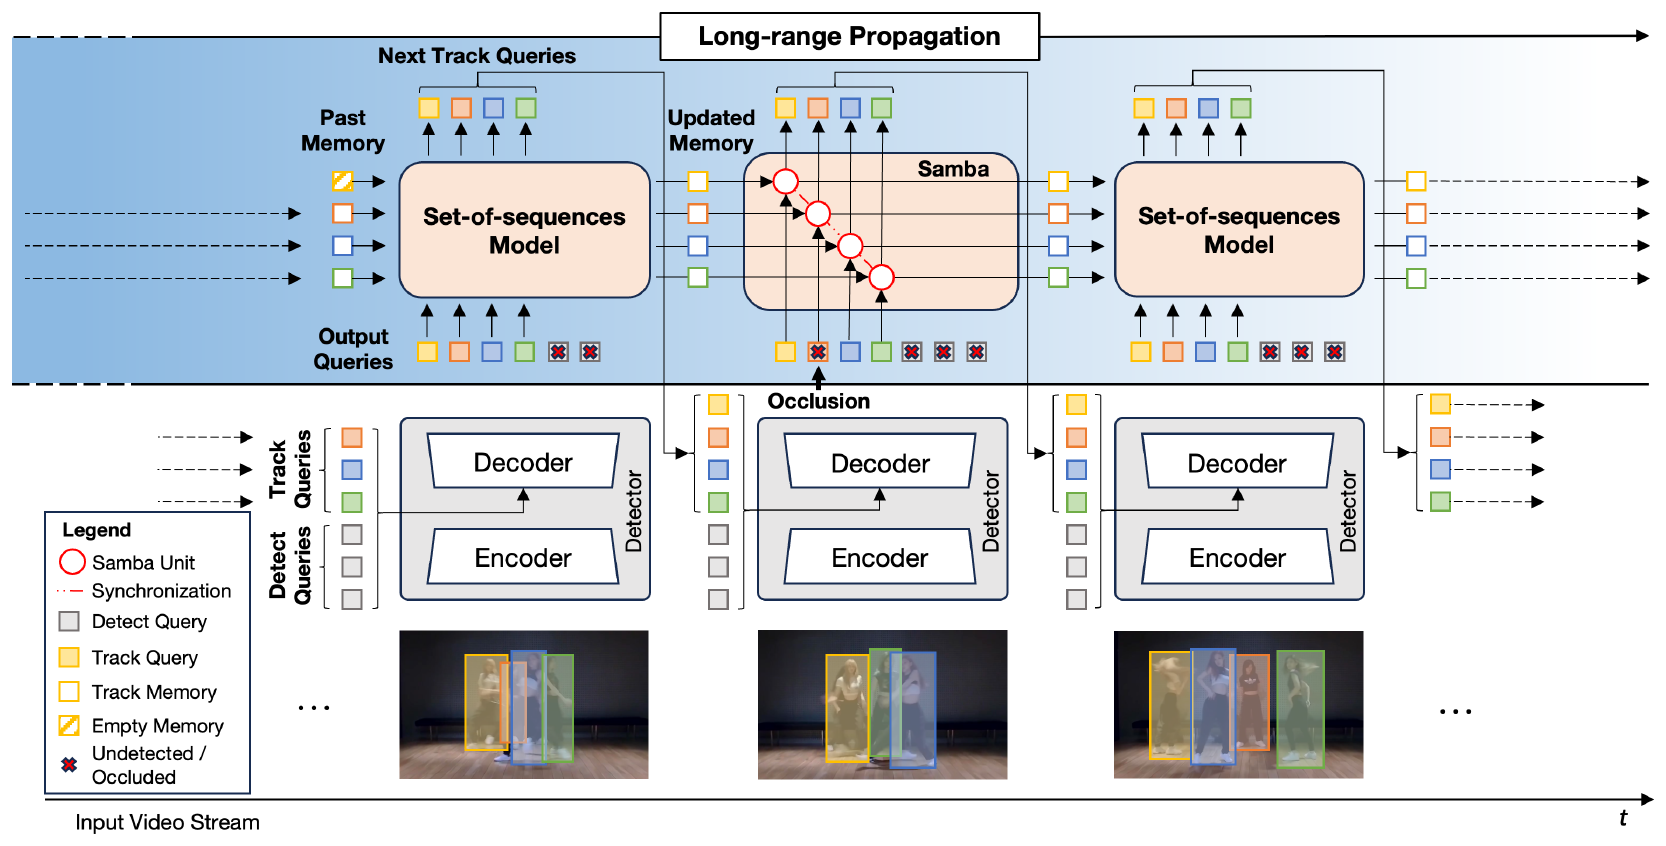
SambaMOTR 的检测器是标准的 Deformable-DETR,和 MOTR 一样。改的是「怎么把这一帧的查询传到下一帧」。
MOTR 用一个小模块,把这一帧的输出直接转成下一帧的查询。SambaMOTR 换成 Samba:每条轨迹是一个序列,Samba 用一个状态空间模型,把这条轨迹从出生到现在的所有输出压缩成一个隐状态,再由隐状态预测下一帧的查询。
送进 Samba 之前,解码器的输出还会加上框坐标的位置编码,让模型同时看到外观和位置。Samba 输出的不是完整的新查询,而是一个残差,加到原本的查询上。
同步的状态空间模型
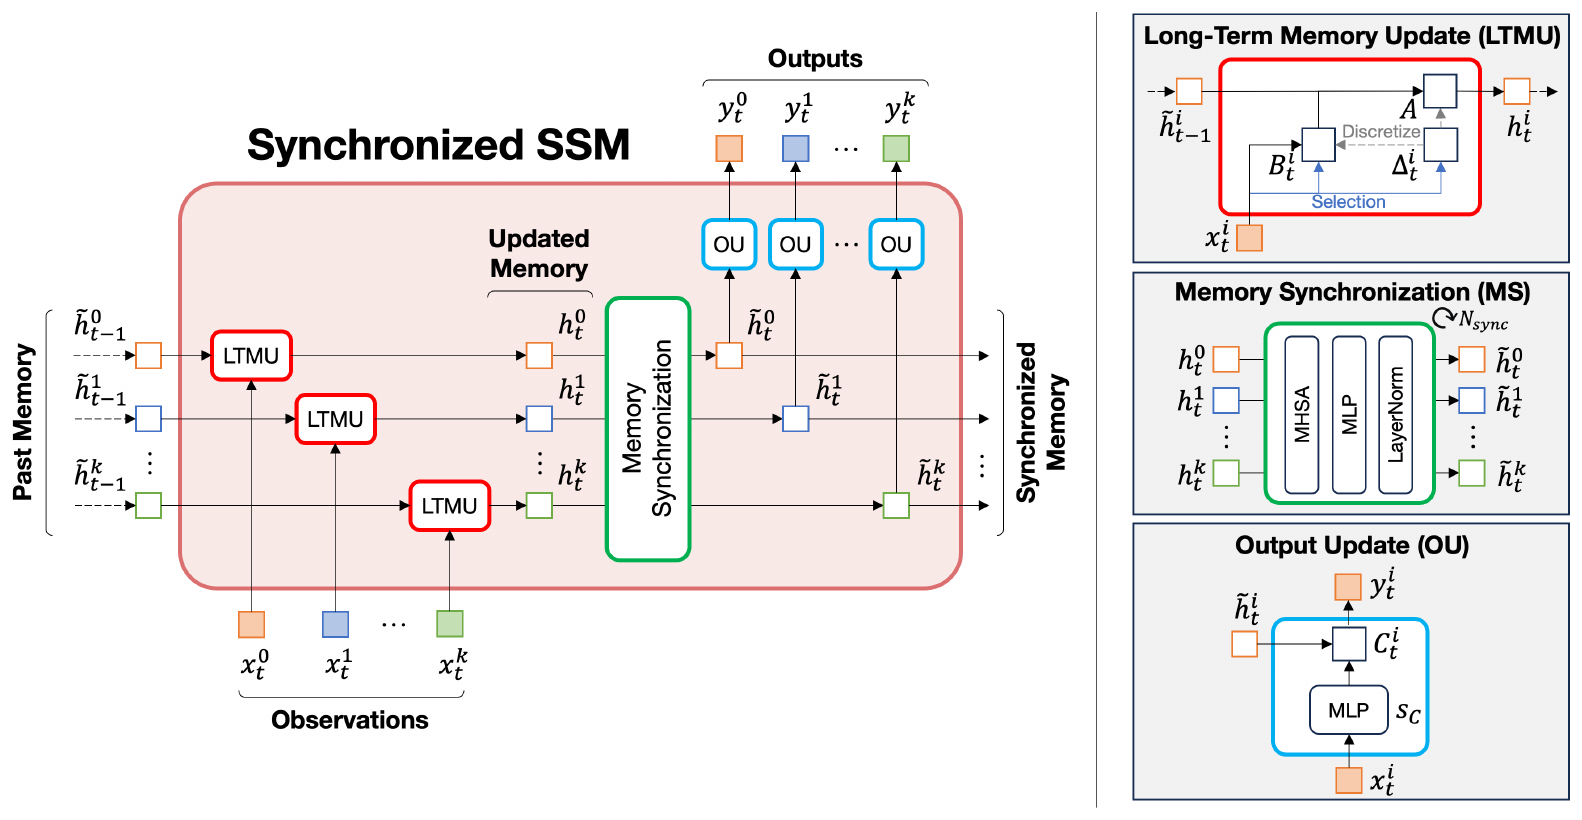
Samba 的核心是「同步」。一般的 Mamba,每条序列的隐状态只根据自己的输入更新。Samba 在每一步多加一个同步:
第一行是 Mamba 原本的更新,每条轨迹用自己这一帧的观测更新记忆。第二行是同步:把所有轨迹更新后的记忆放在一起,做几层自注意力,让它们互相交换信息。第三行由同步后的记忆产生输出。
自注意力有两个刚好需要的性质:轨迹有多少条都能处理,而且和轨迹的排列顺序无关。代价是计算量和轨迹数量的平方成正比;不过对时间长度仍然是线性的,轨迹再长都可以一路跟下去。
MaskObs:不可信的观测就别收
物体被挡住时,解码器还是会输出一个查询,但这个查询多半不可靠,可能抓到了挡住它的那个人。如果照样拿来更新记忆,错误就会一路累积。
MaskObs 让检测置信度低于 0.5 的观测不进入记忆更新。
和冻结不同的是,记忆和查询仍然每一帧都往前更新。只是这时的更新完全依靠这条轨迹自己的历史,以及同步时从其他看得见的轨迹得到的信息。
我们把这个式子简化成一维,并把 、 固定成 0.6 和 0.4,看看差别在哪里。某位舞者 A 的记忆是 1.0。这一帧她被 B 挡住,解码器的输出其实比较像 B,数值是 ,置信度只有 0.3。下一帧 A 重新出现,观测是 1.0,置信度 0.9。
| 做法 | 遮挡这一帧 | A 重新出现后 |
|---|---|---|
| 照收观测 | ||
| MaskObs |
本文整理的算例;实际模型中 、 会随输入改变,记忆是高维向量。
照收的话,B 的信息混进了 A 的记忆,A 回来之后还要好几帧才能恢复。屏蔽之后,A 的记忆保住了大部分。
用长片段训练
MOTR 系列训练时,每次取 5 帧,5 帧都算梯度。只看 5 帧,长期记忆学不起来;直接把片段加长,显存占用又会跟着变大。
作者的做法是取 10 帧的片段,前 5 帧只做前向、不算梯度,只在后 5 帧反向传播。这样显存占用差不多,模型却学到怎么利用比较长的历史。
讨论
每个设计的贡献
| 设置 | HOTA | AssA | IDF1 |
|---|---|---|---|
| MOTR | 54.2 | 40.2 | 51.5 |
| MeMOTR | 63.4 | 52.3 | 65.5 |
| 换成状态空间模型 | 63.5 | 53.8 | 67.0 |
| +MaskObs | 64.8 | 54.3 | 68.1 |
| +同步 | 65.9 | 55.6 | 68.7 |
| +长片段训练 | 67.2 | 57.5 | 70.5 |
整理自原论文 Table 4,DanceTrack 测试集。
光是把传播模块换成单纯的 Mamba,就已经和 MeMOTR 打平,AssA 还多了 1.5。之后每加一个设计,HOTA 都多 1 分以上,合计比 MeMOTR 高 3.8。
附录里有几个更细的消融:
- 同步放在哪里。 在加入这一帧观测之前同步,HOTA 66.1,和不同步的 66.0 差不多;在更新之后同步,是 67.2。作者的解释是,更新之后再同步,被遮挡的轨迹才能用其他轨迹这一帧的信息补上自己缺的那一块。
- 最难的六段视频。 挑出没有同步时表现最差的六段 DanceTrack 视频,加上同步后平均 HOTA 从 40.9 升到 44.5,AssA 从 25.1 升到 28.3。越乱的场景,同步越有用。
- 冻结还是 MaskObs。 换成 MeMOTR 那种遮挡时冻结的做法,HOTA 从 67.2 掉到 65.9。
- 预测残差还是完整查询。 直接预测下一帧的完整查询,HOTA 只有 64.2;预测残差是 67.2。
三个数据集
| 数据集 | 表中最强的对手 | 对手 HOTA | SambaMOTR HOTA | AssA 差距 |
|---|---|---|---|---|
| DanceTrack | MeMOTR | 63.4 | 67.2 | +5.2 |
| BFT | OC-SORT | 66.8 | 69.6 | +4.9 |
| SportsMOT | TransTrack | 68.9 | 69.8 | +1.9 |
DanceTrack 整理自原论文 Table 1,BFT 整理自原论文 Table 2,SportsMOT 整理自原论文 Table 3;均不使用额外训练数据。
三个数据集都是第一,而且检测器只是 ResNet-50 的 Deformable-DETR,不是先检测再跟踪的方法常用的 YOLOX-X。DanceTrack 上,C-BIoU 用 YOLOX-X 的 DetA 是 81.3,比 SambaMOTR 的 78.8 高,但 AssA 只有 45.4,比 SambaMOTR 低了 12 分以上。
鸟群的 BFT 很能说明同步的价值。鸟长得几乎一模一样,外观分不出谁是谁,但它们成群转向。SambaMOTR 的 AssA 是 73.6,比之前最好的基于查询的跟踪器 TrackFormer 高了 12.5。
MOT17 和其他局限
附录里也报告了 MOT17。SambaMOTR 的 HOTA 是 58.8,和 MeMOTR 一样,远低于 ByteTrack 的 63.1。作者认为 MOT17 的行人大多直线前进,训练视频又只有 7 段,端到端的方法在这里没有优势。
作者自己列了两个局限。第一,轨迹不活跃超过一定帧数就会被丢掉,足球员常常跑出画面好几秒,回来时已经是新的 ID,这需要另外接一个长期的重识别。第二,同步用的是自注意力,计算量随轨迹数平方增长,人一多就会变慢。推理速度在单张 RTX 4090 上是 16 FPS。
结论
SambaMOTR 让基于查询的跟踪方法多了两样东西。一是长期记忆:每条轨迹用一个状态空间模型,把整段历史压缩成隐状态,而且计算量对时间是线性的。二是同步:每一步让所有轨迹的记忆互相交换信息,一条轨迹被挡住时,可以参考其他轨迹的动向。
MaskObs 则把遮挡时的处理从「冻结」改成「不收可疑的观测,但继续推」。三者加上长片段训练,在群舞、鸟群和球赛上都超过了先前的方法。
它的作者群和 MASA 有很大的重叠。MASA 完全不用视频学外观的关联;SambaMOTR 则在视频里学时间和群体的关系,两篇刚好从两端处理关联这件事。