原始論文
Samba: Synchronized Set-of-Sequences Modeling for Multiple Object Tracking
- 發表版本
- ICLR 2025會議
- arXiv 首次提交
- arXiv:2410.01806
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{multiobjecttrackingsamba2024,
  title = {{Samba: Synchronized Set-of-Sequences Modeling for Multiple Object Tracking}},
  author = {Mattia Segu and Luigi Piccinelli and Siyuan Li and Yung-Hsu Yang and Bernt Schiele and Luc Van Gool},
  year = {2024},
  eprint = {2410.01806},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2410.01806}
}
看一段群舞,你會發現舞者很少各跳各的。隊形往左移,所有人一起往左;一個人蹲下,旁邊的人可能同時跳起。鳥群轉向、球員跑位,也是一樣的道理。
這對追蹤是一條很有用的線索。一個舞者被擋住了,我們不知道她現在在哪裡,但看看其他舞者怎麼動,大致猜得出來。
可是大部分追蹤器都把每條軌跡分開處理。卡爾曼濾波一條軌跡一個;MOTR 這類用查詢追蹤的方法,每個查詢也只帶著自己上一幀的資訊往下傳。ETH 蘇黎世的 Mattia Segu、Luc Van Gool 等人想做一個能同時看「每條軌跡的長期歷史」和「軌跡彼此之間關係」的模型,取名 Samba,既是 Synchronized Mamba 的縮寫,也是那種講究整齊劃一的森巴舞。
定義問題
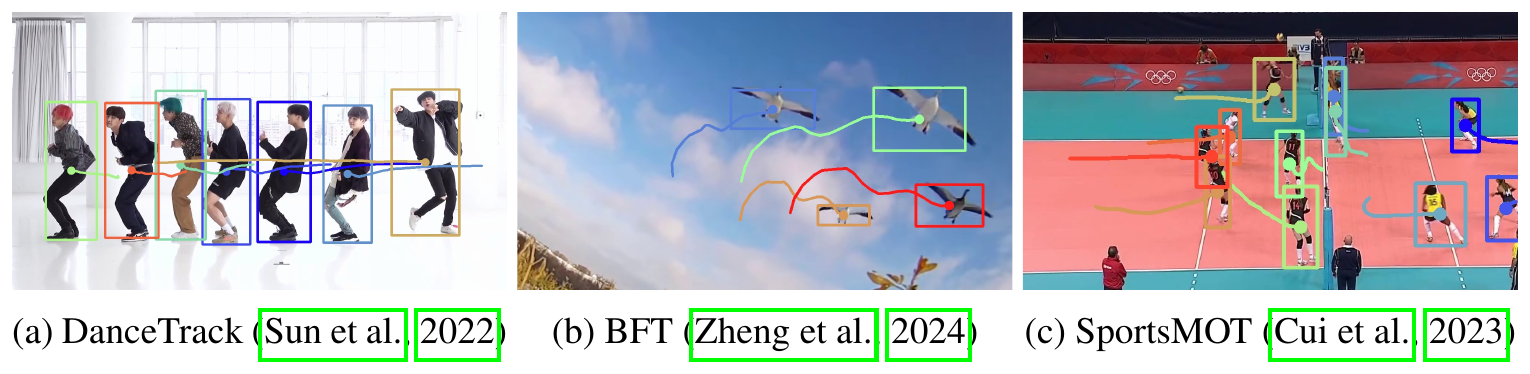
作者把重點放在「用查詢追蹤」這條路線上,也就是 TrackFormer、MOTR 這一系列。這些方法每一幀用一組追蹤查詢,在畫面上重新找到上一幀追過的人,再把查詢傳到下一幀。
這條路線有三個問題:
- 只看上一幀。 查詢從這一幀傳到下一幀,更早的歷史沒有被好好利用。MeMOTR 加了一個長期記憶,但用的是指數移動平均,細節被平均掉了。
- 各追各的。 每個查詢獨立傳遞,舞者之間、鳥之間的協同關係完全沒有用上。
- 遮擋時只能凍結。 物體被擋住、偵測信心很低的時候,MeMOTR 和 MOTRv2 的做法是凍結查詢,停在最後一次看到的狀態,等它重新出現。被擋得越久,凍住的狀態離真實位置越遠。
解決問題
整體架構
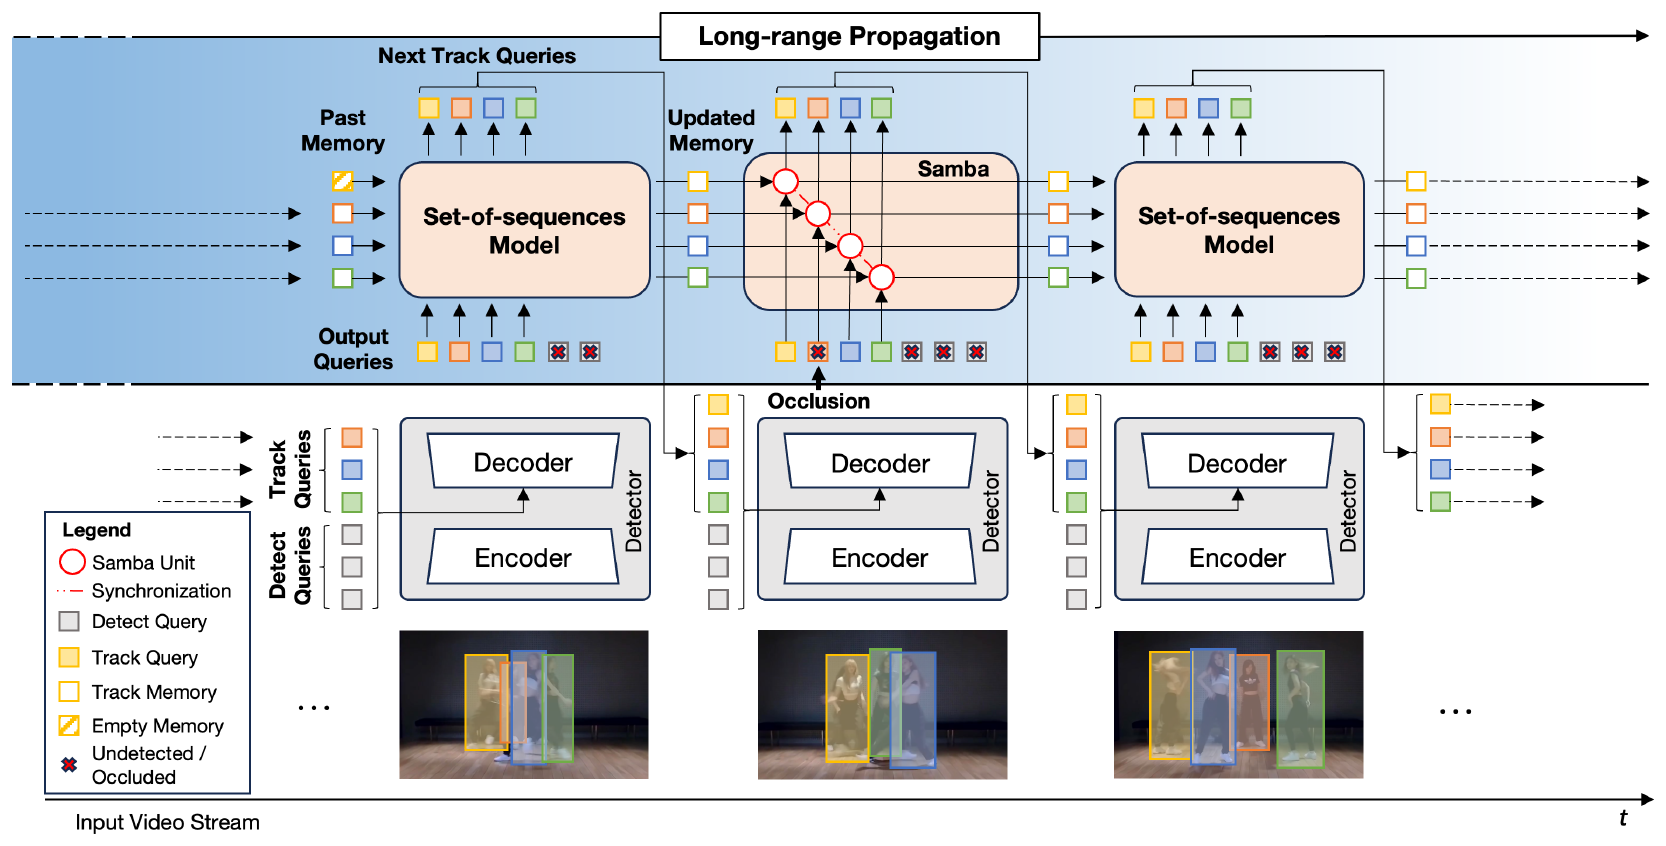
SambaMOTR 的偵測器是標準的 Deformable-DETR,和 MOTR 一樣。改的是「怎麼把這一幀的查詢傳到下一幀」。
MOTR 用一個小模組,把這一幀的輸出直接轉成下一幀的查詢。SambaMOTR 換成 Samba:每條軌跡是一個序列,Samba 用一個狀態空間模型,把這條軌跡從出生到現在的所有輸出壓縮成一個隱藏狀態,再由隱藏狀態預測下一幀的查詢。
送進 Samba 之前,解碼器的輸出還會加上框座標的位置編碼,讓模型同時看到外觀和位置。Samba 輸出的不是完整的新查詢,而是一個殘差,加到原本的查詢上。
同步的狀態空間模型
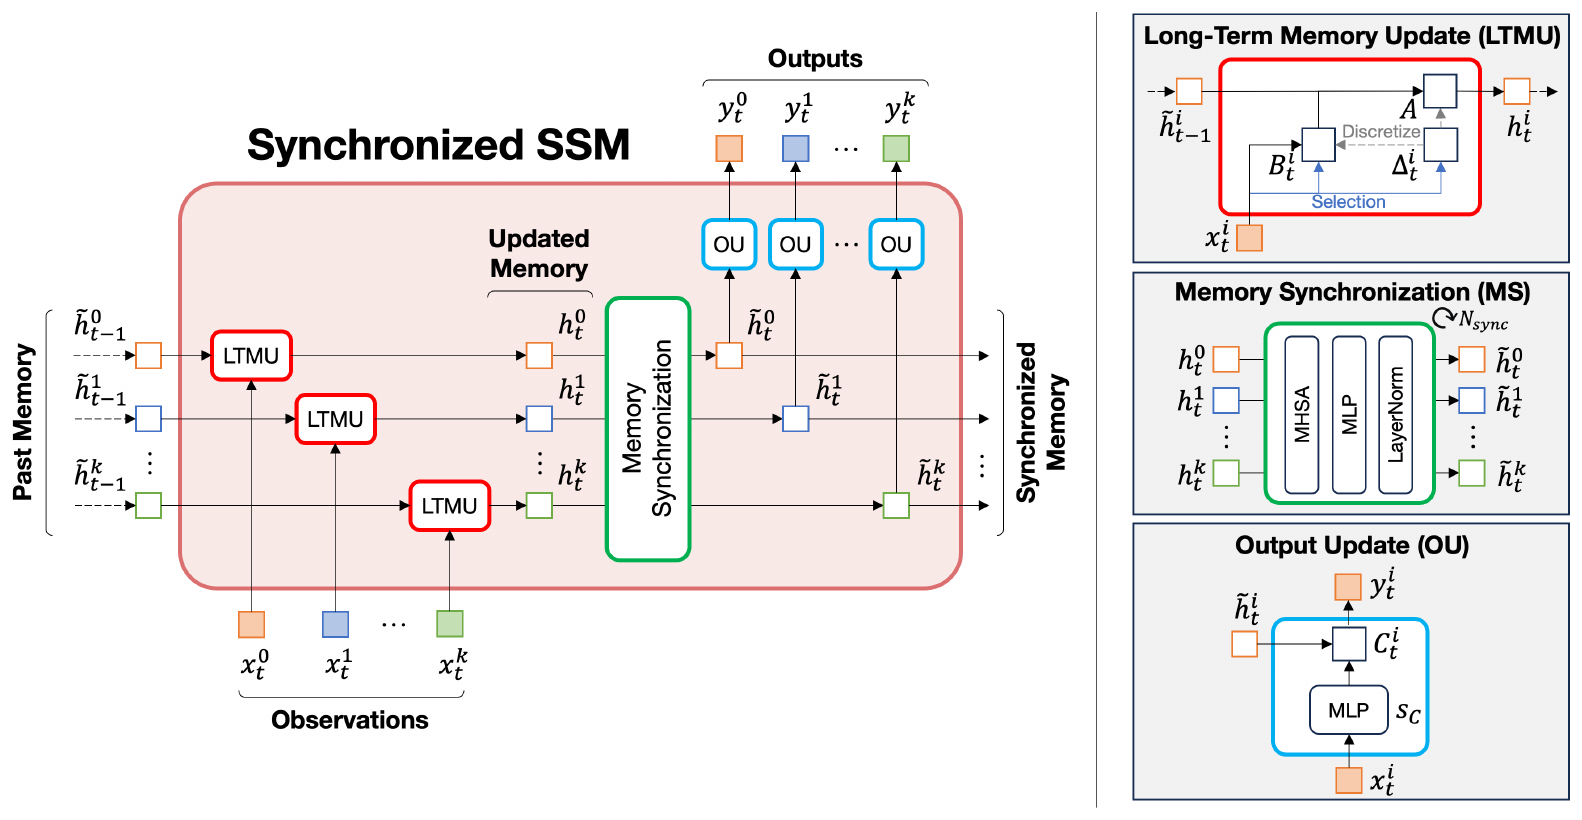
Samba 的核心是「同步」。一般的 Mamba,每條序列的隱藏狀態只依自己的輸入更新。Samba 在每一步多加一個同步:
第一行是 Mamba 原本的更新,每條軌跡用自己這一幀的觀測更新記憶。第二行是同步:把所有軌跡更新後的記憶放在一起,做幾層自注意力,讓它們互相交換資訊。第三行由同步後的記憶產生輸出。
自注意力有兩個剛好需要的性質:軌跡有多少條都能處理,而且和軌跡的排列順序無關。代價是計算量和軌跡數量的平方成正比;不過對時間長度仍然是線性的,軌跡再長都可以一路追下去。
MaskObs:不可信的觀測就別收
物體被擋住時,解碼器還是會輸出一個查詢,但這個查詢多半不可靠,可能抓到了擋住它的那個人。如果照樣拿來更新記憶,錯誤就會一路累積。
MaskObs 讓偵測信心低於 0.5 的觀測不進入記憶更新。
和凍結不同的是,記憶和查詢仍然每一幀都往前更新。只是這時的更新完全依靠這條軌跡自己的歷史,以及同步時從其他看得見的軌跡得到的資訊。
我們把這個式子簡化成一維,並把 、 固定成 0.6 和 0.4,看看差別在哪裡。某位舞者 A 的記憶是 1.0。這一幀她被 B 擋住,解碼器的輸出其實比較像 B,數值是 ,信心只有 0.3。下一幀 A 重新出現,觀測是 1.0,信心 0.9。
| 做法 | 遮擋這一幀 | A 重新出現後 |
|---|---|---|
| 照收觀測 | ||
| MaskObs |
本文整理的算例;實際模型中 、 會隨輸入改變,記憶是高維向量。
照收的話,B 的資訊混進了 A 的記憶,A 回來之後還要好幾幀才能恢復。遮罩之後,A 的記憶保住了大部分。
用長片段訓練
MOTR 系列訓練時,每次取 5 幀,5 幀都算梯度。只看 5 幀,長期記憶學不起來;直接把片段加長,記憶體用量又會跟著變大。
作者的做法是取 10 幀的片段,前 5 幀只做前向、不算梯度,只在後 5 幀反向傳播。這樣記憶體用量差不多,模型卻學到怎麼利用比較長的歷史。
討論
每個設計的貢獻
| 設定 | HOTA | AssA | IDF1 |
|---|---|---|---|
| MOTR | 54.2 | 40.2 | 51.5 |
| MeMOTR | 63.4 | 52.3 | 65.5 |
| 換成狀態空間模型 | 63.5 | 53.8 | 67.0 |
| +MaskObs | 64.8 | 54.3 | 68.1 |
| +同步 | 65.9 | 55.6 | 68.7 |
| +長片段訓練 | 67.2 | 57.5 | 70.5 |
整理自原論文 Table 4,DanceTrack 測試集。
光是把傳遞模組換成單純的 Mamba,就已經和 MeMOTR 打平,AssA 還多了 1.5。之後每加一個設計,HOTA 都多 1 分以上,合計比 MeMOTR 高 3.8。
附錄裡有幾個更細的消融:
- 同步放在哪裡。 在加入這一幀觀測之前同步,HOTA 66.1,和不同步的 66.0 差不多;在更新之後同步,是 67.2。作者的解釋是,更新之後再同步,被遮擋的軌跡才能用其他軌跡這一幀的資訊補上自己缺的那一塊。
- 最難的六段影片。 挑出沒有同步時表現最差的六段 DanceTrack 影片,加上同步後平均 HOTA 從 40.9 升到 44.5,AssA 從 25.1 升到 28.3。越亂的場景,同步越有用。
- 凍結還是 MaskObs。 換成 MeMOTR 那種遮擋時凍結的做法,HOTA 從 67.2 掉到 65.9。
- 預測殘差還是完整查詢。 直接預測下一幀的完整查詢,HOTA 只有 64.2;預測殘差是 67.2。
三個資料集
| 資料集 | 表中最強的對手 | 對手 HOTA | SambaMOTR HOTA | AssA 差距 |
|---|---|---|---|---|
| DanceTrack | MeMOTR | 63.4 | 67.2 | +5.2 |
| BFT | OC-SORT | 66.8 | 69.6 | +4.9 |
| SportsMOT | TransTrack | 68.9 | 69.8 | +1.9 |
DanceTrack 整理自原論文 Table 1,BFT 整理自原論文 Table 2,SportsMOT 整理自原論文 Table 3;皆不使用額外訓練資料。
三個資料集都是第一,而且偵測器只是 ResNet-50 的 Deformable-DETR,不是先偵測再追蹤的方法常用的 YOLOX-X。DanceTrack 上,C-BIoU 用 YOLOX-X 的 DetA 是 81.3,比 SambaMOTR 的 78.8 高,但 AssA 只有 45.4,比 SambaMOTR 低了 12 分以上。
鳥群的 BFT 很能說明同步的價值。鳥長得幾乎一模一樣,外觀分不出誰是誰,但牠們成群轉向。SambaMOTR 的 AssA 是 73.6,比之前最好的查詢式追蹤器 TrackFormer 高了 12.5。
MOT17 和其他限制
附錄裡也報告了 MOT17。SambaMOTR 的 HOTA 是 58.8,和 MeMOTR 一樣,遠低於 ByteTrack 的 63.1。作者認為 MOT17 的行人大多直線前進,訓練影片又只有 7 段,端到端的方法在這裡沒有優勢。
作者自己列了兩個限制。第一,軌跡不活躍超過一定幀數就會被丟掉,足球員常常跑出畫面好幾秒,回來時已經是新的 ID,這需要另外接一個長期的重識別。第二,同步用的是自注意力,計算量隨軌跡數平方增長,人一多就會變慢。推論速度在單張 RTX 4090 上是 16 FPS。
結論
SambaMOTR 讓用查詢追蹤的方法多了兩樣東西。一是長期記憶:每條軌跡用一個狀態空間模型,把整段歷史壓縮成隱藏狀態,而且計算量對時間是線性的。二是同步:每一步讓所有軌跡的記憶互相交換資訊,一條軌跡被擋住時,可以參考其他軌跡的動向。
MaskObs 則把遮擋時的處理從「凍結」改成「不收可疑的觀測,但繼續推」。三者加上長片段訓練,在群舞、鳥群和球賽上都超過了先前的方法。
它的作者群和 MASA 有很大的重疊。MASA 完全不用影片學外觀的關聯;SambaMOTR 則在影片裡學時間和群體的關係,兩篇剛好從兩端處理關聯這件事。