原始论文
MambaMOT: State-Space Model as Motion Predictor for Multi-Object Tracking
- 发表版本
- ICASSP 2025会议
- arXiv 首次提交
- arXiv:2403.10826
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multiobjecttrackingmambamot2024,
  title = {{MambaMOT: State-Space Model as Motion Predictor for Multi-Object Tracking}},
  author = {Hsiang-Wei Huang and Cheng-Yen Yang and Wenhao Chai and Zhongyu Jiang and Jenq-Neng Hwang},
  year = {2024},
  eprint = {2403.10826},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2403.10826}
}
2023 年底,Mamba 以「选择性状态空间模型」的身份登场,在长序列上和 Transformer 分庭抗礼,计算量却只随序列长度线性增长。接下来的几个月,各个领域都有人试着把它搬进来。
多目标跟踪里,最适合放序列模型的位置,是运动预测。给定一条轨迹过去几帧的框,预测下一帧的框,这本来就是一个序列问题,从 SORT 以来一直由卡尔曼滤波负责。
华盛顿大学的 Hsiang-Wei Huang、Jenq-Neng Hwang 等人做的,就是把卡尔曼滤波换成 Mamba。论文只有四页,想法也很直接,但它刚好可以拿来和早不到两周出现的 DiffMOT 对照:同一个问题,一个用扩散模型,一个用状态空间模型。
定义问题
卡尔曼滤波假设物体在短时间内匀速直线前进。行人大致符合这个假设,舞者和球员就不行了。
OC-SORT 曾经分析过卡尔曼滤波在这类场景的两个弱点。一是对状态噪声敏感:速度的估计只要有一点偏差,物体几帧没被检测到,预测位置就会偏得很远。二是误差会随时间放大:没有新观测的时候,卡尔曼滤波只能沿着旧的速度一直推下去。
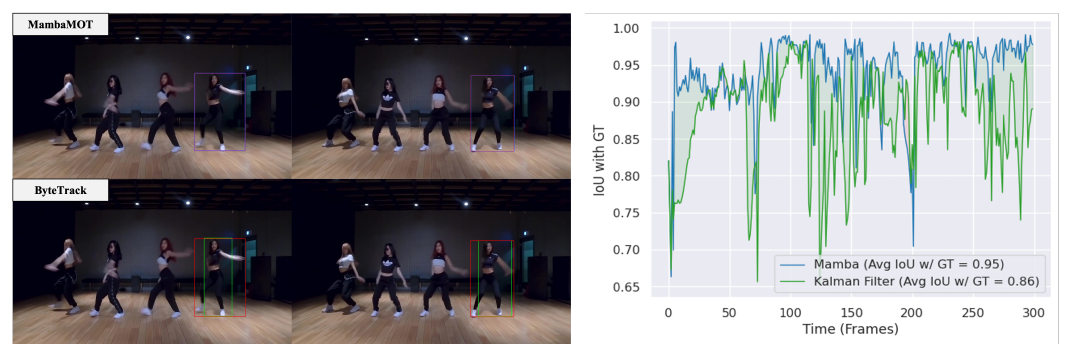
右边的曲线很能说明问题。卡尔曼滤波大部分时候也预测得不错,但每当舞者突然改变动作,绿线就往下掉,有好几次掉到 0.75 以下。对 IoU 关联来说,这种突然的失准就是轨迹断掉的时候。
作者的想法是,与其假设运动是线性的,不如让模型从数据学:舞者通常怎么动、球员通常怎么动。
解决问题
用 Mamba 预测下一个框
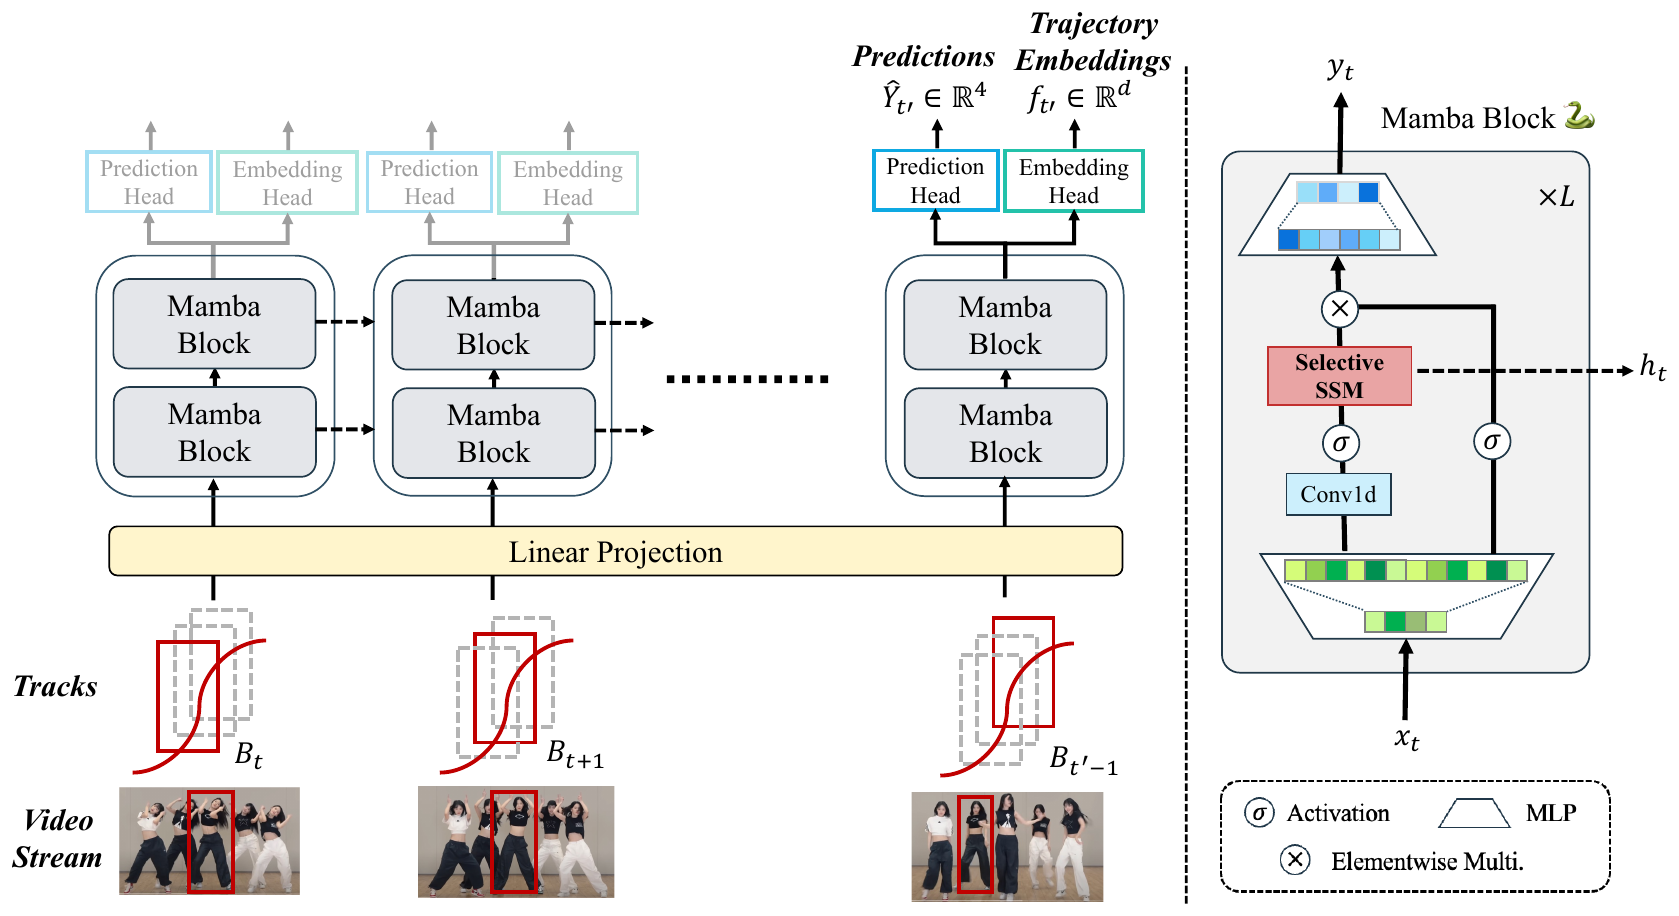
MambaMOT 的运动模型很小。输入是一条轨迹过去 帧的框,每个框四个数字;先用一层线性投影升到 64 维,经过两个 Mamba 块,最后一个 MLP 输出下一帧的框。训练的损失是预测框和真值框之间的 GIoU 加上均方误差。
关联完全沿用 ByteTrack:高分框先和预测框用 IoU 配对,剩下的轨迹再和低分框配一次。所以 MambaMOT 和 ByteTrack 的差别,只有运动模型这一个组件。
选择性是什么意思
Mamba 的核心是一个递归:
隐状态 是过去所有输入的摘要,每来一个新输入,就决定旧的摘要留多少、新的输入收多少。
传统的状态空间模型里,、 是固定的,每一步留多少、收多少都一样。Mamba 让它们随着输入改变,所以叫「选择性」。论文里把这两个量写成 和 ,两者加起来刚好是 1。
把这个式子简化成一维,就看得出它在运动预测上的意义。令 ,递归就变成:
这是一个指数移动平均,只是平滑系数 由输入决定。
一个转身的例子
我们把输入简化成舞者每一帧的水平速度。前几帧她一直往右,每帧 10 像素,记忆里的 。这一帧她突然转身,速度变成 。
| 做法 | 平滑系数 | 更新后的记忆 | 预测的方向 |
|---|---|---|---|
| 固定系数 | 0.2 | 仍然往右 | |
| 选择性 | 0.8 | 改往左 |
本文整理的算例;实际模型的隐状态是高维向量,输出还要经过 MLP。
固定系数的模型,对每个输入一视同仁,旧的趋势要好几帧才会被新信息盖过去。选择性的模型可以学到:看到这种输入时,旧的趋势不可信,要大幅采纳新的观测。
卡尔曼滤波其实也会根据观测调整,但它的调整幅度由事先设定的噪声参数决定,而且背后永远是匀速模型。Mamba 的调整方式则是从数据学来的。
MambaMOT+:顺便学一个轨迹特征
Mamba 的隐状态既然记住了整条轨迹的运动模式,作者想进一步利用它。MambaMOT+ 在 Mamba 块的输出上多接一个嵌入头,输出这条轨迹的特征向量。
训练这个特征用的是余弦嵌入损失:同一条轨迹切出来的两段,特征要相似;不同轨迹的两段,相似度要压到 0 以下。
跟踪结束后,把所有 tracklet 的特征两两比较,用层次聚类把运动模式相似的接起来。为了避免接上不合理的组合,时间差超过 50 帧、空间距离超过 50 像素的不接。
作者强调,传统的 tracklet 合并要另外训练一个孪生网络,每一对 tracklet 都要跑一次,计算量是 ;MambaMOT+ 每条 tracklet 只要跑一次前向,是 。不过聚类时两两比较余弦相似度,这一步仍然是 ,只是向量内积比跑网络便宜得多。
另外要注意,这个合并是在整段视频跟踪完之后才做的,所以 MambaMOT+ 不再是在线方法。
训练数据
运动模型的训练数据,取自 MOT17、DanceTrack、SportsMOT 的训练集轨迹。每次随机切一段长度在 2 到 之间的片段,不足 的补齐,目标是下一帧的真值框。单张 RTX 4080 训练 500 个 epoch。
讨论
DanceTrack 和 SportsMOT
| 方法 | HOTA | AssA | IDF1 |
|---|---|---|---|
| ByteTrack | 47.3 | 31.4 | 52.5 |
| OC-SORT | 54.6 | 40.2 | 54.6 |
| MambaMOT | 55.5 | 38.3 | 53.9 |
| MambaMOT+ | 56.1 | 39.0 | 54.9 |
整理自原论文 Table I,DanceTrack 测试集。
和使用同一组检测的 ByteTrack 相比,MambaMOT 的 HOTA 高了 8.2,这是论文的主要卖点。
不过拆开来看,这 8.2 里有不少来自检测那一侧:ByteTrack 的 DetA 是 71.6,MambaMOT 是 80.8,AssA 则是 31.4 对 38.3。运动模型主要影响的是关联,同一组检测、DetA 却差了 9 分以上,说明表中两者的设置可能不只运动模型不同。OC-SORT 的 DetA 是 80.4,和 MambaMOT 接近,拿它当对照比较公平。
和 OC-SORT 比,故事就不太一样。OC-SORT 是在卡尔曼滤波上动手脚的方法,MambaMOT 的 HOTA 只比它高 0.9,AssA 和 IDF1 反而比它低。加上轨迹合并的 MambaMOT+,IDF1 才以 0.3 小胜。
SportsMOT 上的情况类似。用同一个 YOLOX 检测器,MambaMOT 的 HOTA 是 70.4,OC-SORT 是 70.2;MambaMOT+ 到 71.3。MambaMOT 和 ByteTrack 的 62.0 比,差距是 8.4。
少了什么
这篇论文的篇幅很短,有几件事没有交代:
- 没有消融。 输入几帧、用几个 Mamba 块、拿掉 GIoU 损失会怎样,都没有实验。换成 LSTM 或 Transformer 会不会一样好,也没有比较。
- 没有行人数据集的结果。 训练数据里有 MOT17 的轨迹,测试却只报告了 DanceTrack 和 SportsMOT。
- 没有跨数据集的实验。 运动模型在三个数据集的训练轨迹上一起训练,再在其中两个的测试集上评估。换到没见过的运动类型时表现如何,论文没有测。
- 比较对象不完整。 表中最强的对手是 OC-SORT。同期的 DiffMOT 在 DanceTrack 上的 HOTA 是 62.3,Deep OC-SORT 是 61.3,都没有列入。这些方法还用了外观特征,不能直接比,但读者很难从这篇论文判断 Mamba 本身的位置。
DiffMOT 的消融倒是提供了一个侧面的参考。在 DiffMOT 的框架里,同样是学习式的运动模型,LSTM 的 HOTA 是 51.2,Transformer 是 54.6,扩散模型是 55.7,卡尔曼滤波是 46.8。学习式的运动模型确实比卡尔曼滤波好,至于用哪一种序列模型,差距就小得多。
速度
MambaMOT 在单张 GPU 上跑 28.8 FPS。作者拿它和 MOTR 这类端到端方法比,后者通常不到 10 FPS。运动模型只有两个 64 维的 Mamba 块,本身非常轻。
结论
MambaMOT 把卡尔曼滤波换成一个小型的 Mamba,看跟踪会不会变好。在舞者和球员身上,答案是会,和 ByteTrack 相比,HOTA 一口气多了 8 分以上。
选择性状态空间模型的好处,在于它能根据输入决定要相信旧的趋势还是新的观测,而这正是不规则运动最需要的。不过它和 OC-SORT 这类改良过的卡尔曼滤波方法相比,优势就只剩一点点;至于它是不是比其他序列模型更适合这个任务,这篇论文没有给出答案。