原始论文
Occlusion-Aware SORT: Observing Occlusion for Robust Multi-Object Tracking
- 发表版本
- CVPR 2026会议
- arXiv 首次提交
- arXiv:2603.06034
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multiobjecttrackingoasort2026,
  title = {{Occlusion-Aware SORT: Observing Occlusion for Robust Multi-Object Tracking}},
  author = {Chunjiang Li and Jianbo Ma and Li Shen and Yanru Chen and Liangyin Chen},
  year = {2026},
  eprint = {2603.06034},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2603.06034}
}
两个身形差不多的人一前一后走过,后面那个被挡住大半。这时候检测器给出的框,常常只框到后面那人露出来的一小块,或者干脆框歪到前面那人身上。
卡尔曼滤波接着拿这些不准的框去更新自己,预测也跟着歪。到了配对的时候,前面那人的检测框,和后面那人的预测框,IoU 可能比它和自己的预测框还高。匈牙利算法只看代价,两人的身份就这样对调了。
四川大学的 Chunjiang Li、Yanru Chen 等人把这种现象叫做代价混淆。他们先把「谁挡住了谁、挡了多少」算出来,再用它来修正配对和卡尔曼滤波。整套方法不需要训练,可以直接装到现有的跟踪器上。
定义问题
位置关联有三个零件:卡尔曼滤波预测位置,IoU 衡量检测框和预测框有多吻合,匈牙利算法找代价最低的配对。
作者把检测框和预测框都写成「真实位置加误差」:
部分遮挡时,物体的外观少了一块,检测误差 变大,IoU 可能在一两帧内突然跳动。遮挡持续下去,不准的检测一再被拿来更新卡尔曼滤波,预测误差 也跟着累积。两种误差叠在一起,代价矩阵就不再能稳定反映谁跟谁是同一个人。
很多跟踪器靠外观特征、运动方向、检测置信度来补救。可是这些线索在遮挡时一样不可靠:被挡住的人,提取出来的外观特征混进了前面那人的样子;检测置信度也被压低。作者因此回到位置本身,直接处理遮挡。
解决问题
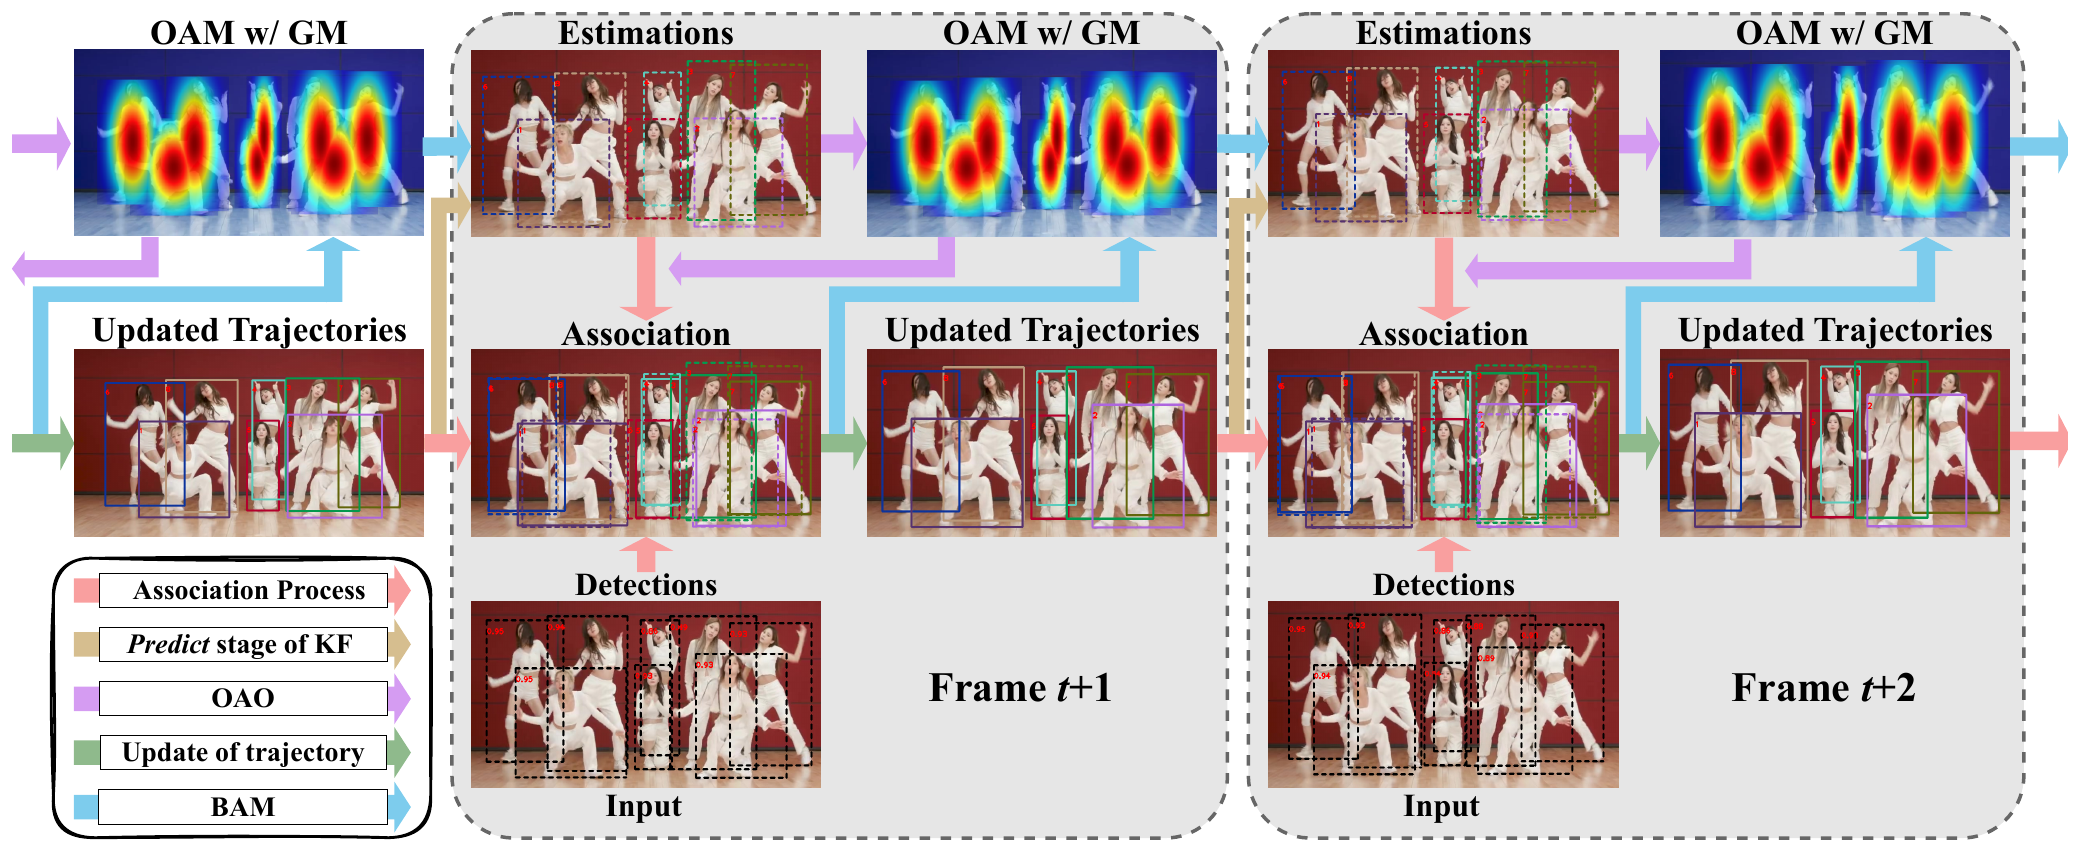
OA-SORT 由三个零件组成。OAM 负责估计遮挡程度,OAO 把它用在配对,BAM 把它用在卡尔曼滤波的更新。
OAM:谁在前面,挡了多少
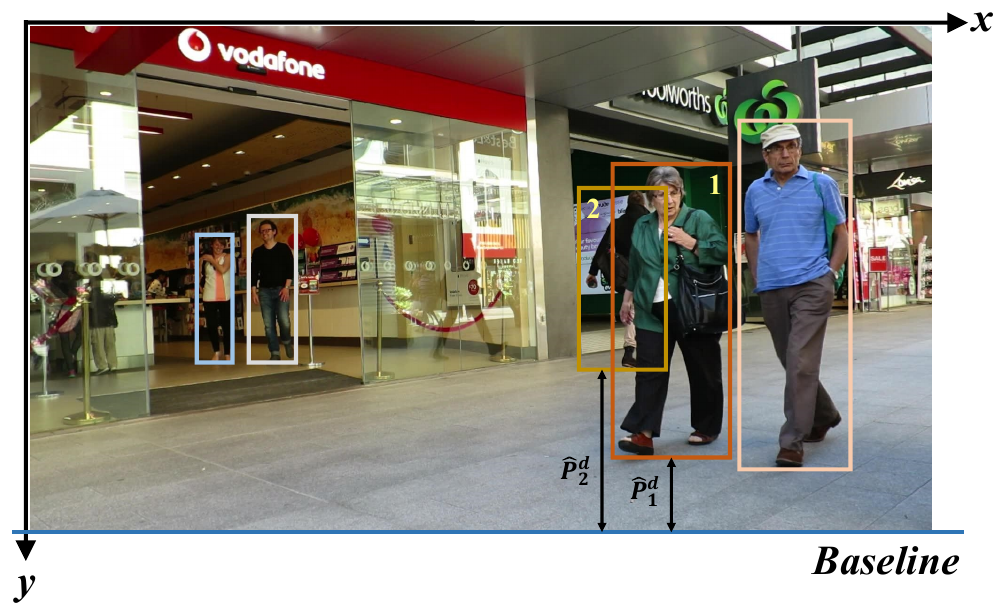
要知道谁挡住谁,先要知道谁在前面。一般的监控摄像头从斜上方往下拍,站在地上的人,脚越靠近画面下缘,就离镜头越近。所以只要比较两个框的底边,就能排出前后。为了避免框抖动造成误判,底边至少要差 5 个像素才算数。
知道前后之后,被挡住的比例就是「前方所有框和它的交集面积」除以「它自己的面积」:
不过框里不全是人。舞者张开手臂、跨出一大步时,框的边缘大多是背景,被挡到边缘不太要紧。作者加了一张高斯图,每个像素按它到框中心的距离给权重,中心是 1,往外递减。被挡住的面积改成按权重加总。
衰减的速度按数据集调整。DanceTrack 的设置下,框左右边缘的权重只有 。同样被挡住一条,挡在边上大约只算挡在中间的十分之一。
OAO:被挡住的,配对时让一让
OAO 把遮挡程度加进配对的分数:
这里的遮挡程度算在卡尔曼滤波的预测框 上,而不是检测框上。被挡住的检测框底边常常乱跳,前后关系反而判断不准;预测框比较平滑。
被挡得越严重的轨迹,对所有检测框的分数都会打一点折扣。当两条轨迹抢同一个检测框时,站在前面、没被挡住的那条就占了优势。
用一个例子看。舞者 j 站在前面,舞者 i 在后面被挡住六成。这一帧 j 的检测框是 ,它和 i 的预测框 IoU 是 0.70,和 j 自己的预测框只有 0.65,因为 j 的预测已经被前几帧的误差带偏了。 取 DanceTrack 的 0.15:
| 预测框 | 遮挡程度 | IoU | 只看 IoU | 加入遮挡后的分数 |
|---|---|---|---|---|
| 后方的 i | 0.6 | 0.70 | 0.70 | 0.15 × 0.4 + 0.85 × 0.70 = 0.655 |
| 前方的 j | 0 | 0.65 | 0.65 | 0.15 × 1 + 0.85 × 0.65 ≈ 0.703 |
本文整理的算例。
只看 IoU, 会被分给后面的 i,两人换了身份。加入遮挡程度后, 回到 j 身上。
OAO 只用在第一阶段,也就是高分检测框的配对。
BAM:不可靠的观测,少听一点
被挡住的人,检测分数通常偏低,会在第二阶段才被配上。这些低分框不太准,如果卡尔曼滤波照单全收,速度估计就会被带歪,下一帧的预测跟着出错。
BAM 在更新之前,先把观测往预测拉回一些:
观测和预测差得越多,或者这条轨迹上一次被挡得越严重,BAM 就越小,更新时就越相信预测。作者在附录里指出,这等于把卡尔曼增益乘上 BAM,不用另外去估计遮挡下的噪声协方差。
例如预测的 坐标是 100,低分检测框是 120,两者 IoU 0.5,这条轨迹上一次被挡住六成。BAM 是 ,拿去更新的观测变成 。
讨论
每个零件的贡献
| 设置 | HOTA | AssA | IDF1 | 每帧时间 |
|---|---|---|---|---|
| Hybrid-SORT | 59.4 | 44.9 | 60.7 | 9.57 ms |
| +OAO | 59.9 | 45.6 | 60.9 | +1.96 ms |
| +OAO、高斯图 | 60.6 | 46.7 | 62.0 | +9.25 ms |
| +OAO、BAM | 60.5 | 46.5 | 62.2 | +3.81 ms |
| 全部 | 61.5 | 48.0 | 63.7 | +14.99 ms |
整理自原论文 Table 4,DanceTrack 验证集;时间不含检测。
三个零件合起来,HOTA 多了 2.1。高斯图的影响不小:OAO 加上它,HOTA 从 59.9 到 60.6。代价也主要在它身上,逐像素计算让每帧的跟踪时间从 9.57 毫秒增加到 24.56 毫秒,仍然可以实时。
BAM 里的 IoU 项也有作用。把它换成固定常数,最好的情况是 0.4,HOTA 61.26;用 IoU 是 61.49。
装到其他跟踪器上
| 跟踪器 | 原本 HOTA | 加上遮挡感知 | 原本 IDF1 | 加上遮挡感知 |
|---|---|---|---|---|
| ByteTrack | 47.1 | 49.0 | 51.9 | 55.9 |
| OC-SORT | 54.6 | 56.5 | 54.6 | 57.6 |
| SparseTrack | 55.5 | 57.8 | 58.3 | 60.2 |
| PD-SORT | 58.2 | 60.4 | 57.5 | 60.8 |
| Hybrid-SORT | 62.2 | 63.1 | 63.0 | 64.2 |
整理自原论文 Table 1,DanceTrack 测试集,使用 OC-SORT 的检测结果。
四个外加的跟踪器,HOTA 平均多 2.08,IDF1 平均多 3.05。SparseTrack 和 PD-SORT 本身已经用了框底边推估的「伪深度」,加上遮挡感知还是有进步。作为基础的 Hybrid-SORT 进步最小,它本来就用运动方向处理遮挡,只多了 0.9。
验证集上,作者也试着装到 TrackTrack,HOTA 从 59.3 到 59.9,IDF1 从 61.1 到 62.0。TrackTrack 的配对方式不是匈牙利算法,也用了被 NMS 删掉的框,OA-SORT 一样能叠上去。
其他数据集
SportsMOT 上,只用训练集训练检测器的设置下,HOTA 从 73.0 到 73.4,IDF1 从 73.3 到 74.1,而且完全没用相机运动补偿。作者的解释是,遮挡关系是物体之间的相对位置,镜头转动时仍然成立。
MOT17 上,HOTA 从 63.6 到 64.2,IDF1 从 78.4 到 79.1,甚至略高于加了 ReID 的 Hybrid-SORT。不过 MOTA 从 80.6 掉到 79.6。
什么时候会失灵
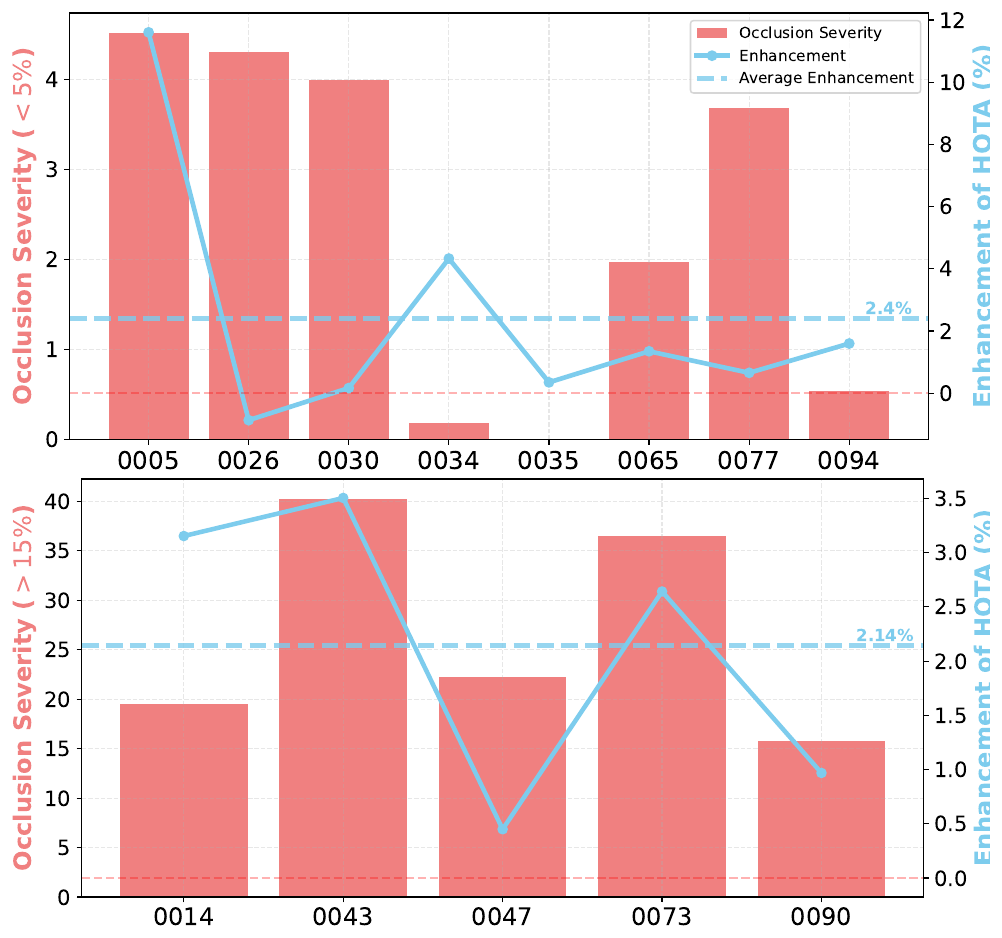
大部分视频都有进步,但上图的 0026 段是负的。作者在局限里提到,整套方法靠框的底边判断前后,当一个人的下半身被挡住,或者舞者跳起来双脚离地,底边就不再代表他站在哪里,前后关系会判断错。
此外,遮挡程度只看当下这一帧,没有建模遮挡随时间的变化,长时间的遮挡仍然会让关联不稳。
结论
遮挡是位置关联出错的主因,OA-SORT 就从把遮挡程度算出来开始。用框的底边排前后,用交集面积和高斯权重算被挡了多少,再把这个数字分别放进配对的分数和卡尔曼滤波的更新里。
它不需要训练,也不需要外观特征,装到五种不同的跟踪器上,HOTA 和 IDF1 都有进步。代价是一个靠「脚踩在地上」成立的假设:舞台上的舞者一跳起来,这个假设就不管用了。