原始論文
Occlusion-Aware SORT: Observing Occlusion for Robust Multi-Object Tracking
- 發表版本
- CVPR 2026會議
- arXiv 首次提交
- arXiv:2603.06034
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{multiobjecttrackingoasort2026,
  title = {{Occlusion-Aware SORT: Observing Occlusion for Robust Multi-Object Tracking}},
  author = {Chunjiang Li and Jianbo Ma and Li Shen and Yanru Chen and Liangyin Chen},
  year = {2026},
  eprint = {2603.06034},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2603.06034}
}
兩個身形差不多的人一前一後走過,後面那個被擋住大半。這時候偵測器給出的框,常常只框到後面那人露出來的一小塊,或者乾脆框歪到前面那人身上。
卡爾曼濾波接著拿這些不準的框去更新自己,預測也跟著歪。到了配對的時候,前面那人的偵測框,和後面那人的預測框,IoU 可能比它和自己的預測框還高。匈牙利演算法只看成本,兩人的身分就這樣對調了。
四川大學的 Chunjiang Li、Yanru Chen 等人把這種現象叫做成本混淆。他們先把「誰擋住了誰、擋了多少」算出來,再用它來修正配對和卡爾曼濾波。整套方法不需要訓練,可以直接裝到現有的追蹤器上。
定義問題
位置關聯有三個零件:卡爾曼濾波預測位置,IoU 衡量偵測框和預測框有多吻合,匈牙利演算法找成本最低的配對。
作者把偵測框和預測框都寫成「真實位置加誤差」:
部分遮擋時,物體的外觀少了一塊,偵測誤差 變大,IoU 可能在一兩幀內突然跳動。遮擋持續下去,不準的偵測一再被拿來更新卡爾曼濾波,預測誤差 也跟著累積。兩種誤差疊在一起,成本矩陣就不再能穩定反映誰跟誰是同一個人。
很多追蹤器靠外觀特徵、運動方向、偵測信心來補救。可是這些線索在遮擋時一樣不可靠:被擋住的人,抽出來的外觀特徵混進了前面那人的樣子;偵測信心也被壓低。作者因此回到位置本身,直接處理遮擋。
解決問題
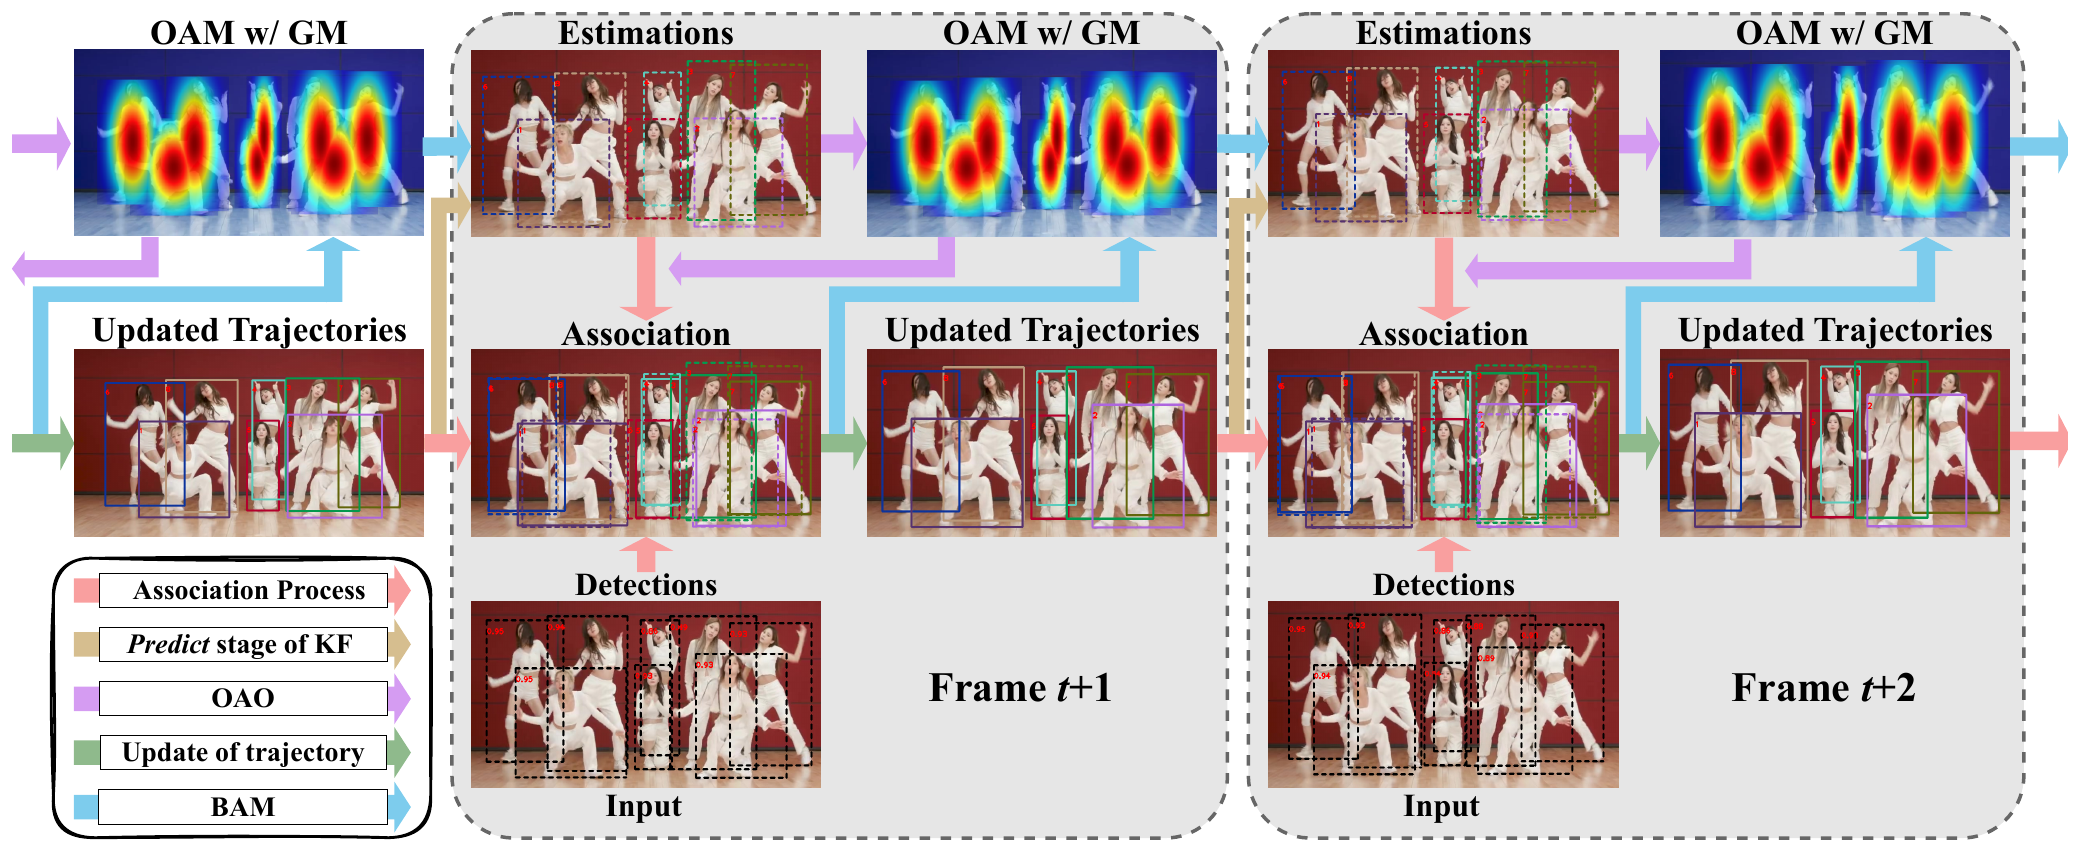
OA-SORT 由三個零件組成。OAM 負責估計遮擋程度,OAO 把它用在配對,BAM 把它用在卡爾曼濾波的更新。
OAM:誰在前面,擋了多少
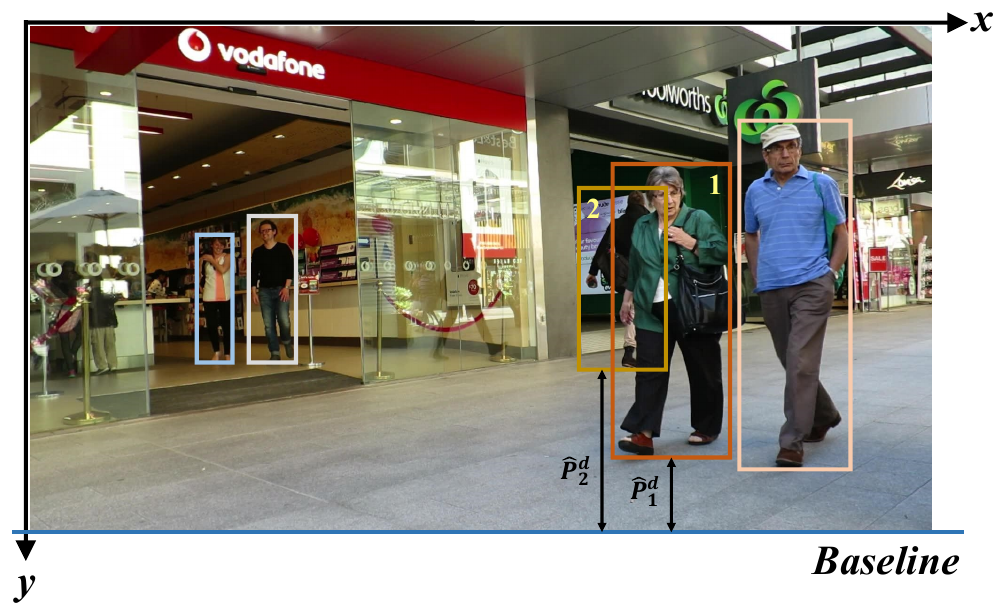
要知道誰擋住誰,先要知道誰在前面。一般的監視器從斜上方往下拍,站在地上的人,腳越靠近畫面下緣,就離鏡頭越近。所以只要比較兩個框的底邊,就能排出前後。為了避免框抖動造成誤判,底邊至少要差 5 個像素才算數。
知道前後之後,被擋住的比例就是「前方所有框和它的交集面積」除以「它自己的面積」:
不過框裡不全是人。舞者張開手臂、跨出一大步時,框的邊緣大多是背景,被擋到邊緣不太要緊。作者加了一張高斯圖,每個像素依它到框中心的距離給權重,中心是 1,往外遞減。被擋住的面積改成按權重加總。
衰減的速度依資料集調整。DanceTrack 的設定下,框左右邊緣的權重只有 。同樣被擋住一條,擋在邊上大約只算擋在中間的十分之一。
OAO:被擋住的,配對時讓一讓
OAO 把遮擋程度加進配對的分數:
這裡的遮擋程度算在卡爾曼濾波的預測框 上,而不是偵測框上。被擋住的偵測框底邊常常亂跳,前後關係反而判斷不準;預測框比較平滑。
被擋得越嚴重的軌跡,對所有偵測框的分數都會打一點折扣。當兩條軌跡搶同一個偵測框時,站在前面、沒被擋住的那條就佔了優勢。
用一個例子看。舞者 j 站在前面,舞者 i 在後面被擋住六成。這一幀 j 的偵測框是 ,它和 i 的預測框 IoU 是 0.70,和 j 自己的預測框只有 0.65,因為 j 的預測已經被前幾幀的誤差帶偏了。 取 DanceTrack 的 0.15:
| 預測框 | 遮擋程度 | IoU | 只看 IoU | 加入遮擋後的分數 |
|---|---|---|---|---|
| 後方的 i | 0.6 | 0.70 | 0.70 | 0.15 × 0.4 + 0.85 × 0.70 = 0.655 |
| 前方的 j | 0 | 0.65 | 0.65 | 0.15 × 1 + 0.85 × 0.65 ≈ 0.703 |
本文整理的算例。
只看 IoU, 會被分給後面的 i,兩人換了身分。加入遮擋程度後, 回到 j 身上。
OAO 只用在第一階段,也就是高分偵測框的配對。
BAM:不可靠的觀測,少聽一點
被擋住的人,偵測分數通常偏低,會在第二階段才被配上。這些低分框不太準,如果卡爾曼濾波照單全收,速度估計就會被帶歪,下一幀的預測跟著出錯。
BAM 在更新之前,先把觀測往預測拉回一些:
觀測和預測差越多,或者這條軌跡上一次被擋得越嚴重,BAM 就越小,更新時就越相信預測。作者在附錄裡指出,這等於把卡爾曼增益乘上 BAM,不用另外去估計遮擋下的雜訊共變異數。
例如預測的 座標是 100,低分偵測框是 120,兩者 IoU 0.5,這條軌跡上一次被擋住六成。BAM 是 ,拿去更新的觀測變成 。
討論
每個零件的貢獻
| 設定 | HOTA | AssA | IDF1 | 每幀時間 |
|---|---|---|---|---|
| Hybrid-SORT | 59.4 | 44.9 | 60.7 | 9.57 ms |
| +OAO | 59.9 | 45.6 | 60.9 | +1.96 ms |
| +OAO、高斯圖 | 60.6 | 46.7 | 62.0 | +9.25 ms |
| +OAO、BAM | 60.5 | 46.5 | 62.2 | +3.81 ms |
| 全部 | 61.5 | 48.0 | 63.7 | +14.99 ms |
整理自原論文 Table 4,DanceTrack 驗證集;時間不含偵測。
三個零件合起來,HOTA 多了 2.1。高斯圖的影響不小:OAO 加上它,HOTA 從 59.9 到 60.6。代價也主要在它身上,逐像素計算讓每幀的追蹤時間從 9.57 毫秒增加到 24.56 毫秒,仍然可以即時。
BAM 裡的 IoU 項也有作用。把它換成固定常數,最好的情況是 0.4,HOTA 61.26;用 IoU 是 61.49。
裝到其他追蹤器上
| 追蹤器 | 原本 HOTA | 加上遮擋感知 | 原本 IDF1 | 加上遮擋感知 |
|---|---|---|---|---|
| ByteTrack | 47.1 | 49.0 | 51.9 | 55.9 |
| OC-SORT | 54.6 | 56.5 | 54.6 | 57.6 |
| SparseTrack | 55.5 | 57.8 | 58.3 | 60.2 |
| PD-SORT | 58.2 | 60.4 | 57.5 | 60.8 |
| Hybrid-SORT | 62.2 | 63.1 | 63.0 | 64.2 |
整理自原論文 Table 1,DanceTrack 測試集,使用 OC-SORT 的偵測結果。
四個外加的追蹤器,HOTA 平均多 2.08,IDF1 平均多 3.05。SparseTrack 和 PD-SORT 本身已經用了框底邊推估的「偽深度」,加上遮擋感知還是有進步。基準 Hybrid-SORT 的進步最小,它本來就用運動方向處理遮擋,只多了 0.9。
驗證集上,作者也試著裝到 TrackTrack,HOTA 從 59.3 到 59.9,IDF1 從 61.1 到 62.0。TrackTrack 的配對方式不是匈牙利演算法,也用了被 NMS 刪掉的框,OA-SORT 一樣能疊上去。
其他資料集
SportsMOT 上,只用訓練集訓練偵測器的設定下,HOTA 從 73.0 到 73.4,IDF1 從 73.3 到 74.1,而且完全沒用相機運動補償。作者的解釋是,遮擋關係是物體之間的相對位置,鏡頭轉動時仍然成立。
MOT17 上,HOTA 從 63.6 到 64.2,IDF1 從 78.4 到 79.1,甚至略高於加了 ReID 的 Hybrid-SORT。不過 MOTA 從 80.6 掉到 79.6。
什麼時候會失靈
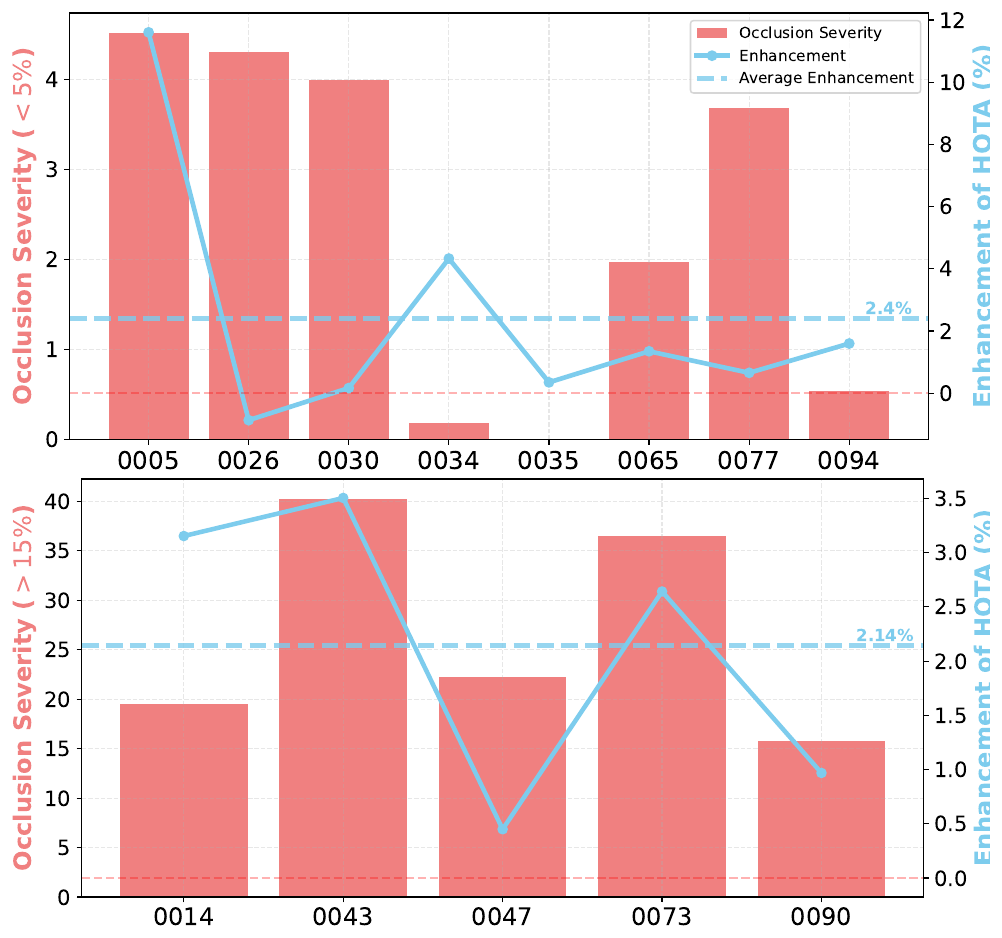
大部分影片都有進步,但上圖的 0026 段是負的。作者在限制裡提到,整套方法靠框的底邊判斷前後,當一個人的下半身被擋住,或者舞者跳起來雙腳離地,底邊就不再代表他站在哪裡,前後關係會判斷錯。
此外,遮擋程度只看當下這一幀,沒有建模遮擋隨時間的變化,長時間的遮擋仍然會讓關聯不穩。
結論
遮擋是位置關聯出錯的主因,OA-SORT 就從把遮擋程度算出來開始。用框的底邊排前後,用交集面積和高斯權重算被擋了多少,再把這個數字分別放進配對的分數和卡爾曼濾波的更新裡。
它不需要訓練,也不需要外觀特徵,裝到五種不同的追蹤器上,HOTA 和 IDF1 都有進步。代價是一個靠「腳踩在地上」成立的假設:舞台上的舞者一跳起來,這個假設就不管用了。