原始論文
MOTRv2: Bootstrapping End-to-End Multi-Object Tracking by Pretrained Object Detectors
- 發表版本
- CVPR 2023會議
- arXiv 首次提交
- arXiv:2211.09791
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{multiobjecttrackingmotrv22022,
  title = {{MOTRv2: Bootstrapping End-to-End Multi-Object Tracking by Pretrained Object Detectors}},
  author = {Yuang Zhang and Tiancai Wang and Xiangyu Zhang},
  year = {2022},
  eprint = {2211.09791},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2211.09791}
}
MOTR 把多目標追蹤做成了完全端到端:軌跡查詢一幀一幀往下傳,新物體交給偵測查詢,不需要任何配對或後處理。
在 DanceTrack 上,MOTR 的關聯能力是當時最好的,AssA 40.2,比 ByteTrack、OC-SORT 這些靠運動配對的方法都高。但它的偵測不行。DanceTrack 上 DetA 只有 73.5,比 OC-SORT 的 80.3 低一截;到了 MOT17,MOTA 73.4,比 ByteTrack 的 80.3 差了將近 7 分。
上海交通大學的 Yuang Zhang 與曠視的 Tiancai Wang、Xiangyu Zhang,也就是 MOTR 原本團隊的成員,認為問題出在同一個解碼器要同時學兩件事。偵測和關聯在 MOTR 裡互相拉扯,結果偵測學不好。
那就找一個現成、很強的偵測器來幫忙吧。
定義問題
要把外部偵測器接上 MOTR,最直接的作法是學 TransTrack,讓軌跡查詢預測出框,再用 IoU 和偵測器的框配對。
作者試過,偵測只有些微改善,而且又回到了「先預測、再配對」的老路,MOTR 端到端的特性也沒了。
作者想要的是像 tracking-by-detection 那樣,把偵測結果當成輸入,讓 MOTR 只需要專心學關聯。偵測結果要怎麼「餵」進一個以查詢為核心的 Transformer,就是這篇要解決的問題。
解決問題
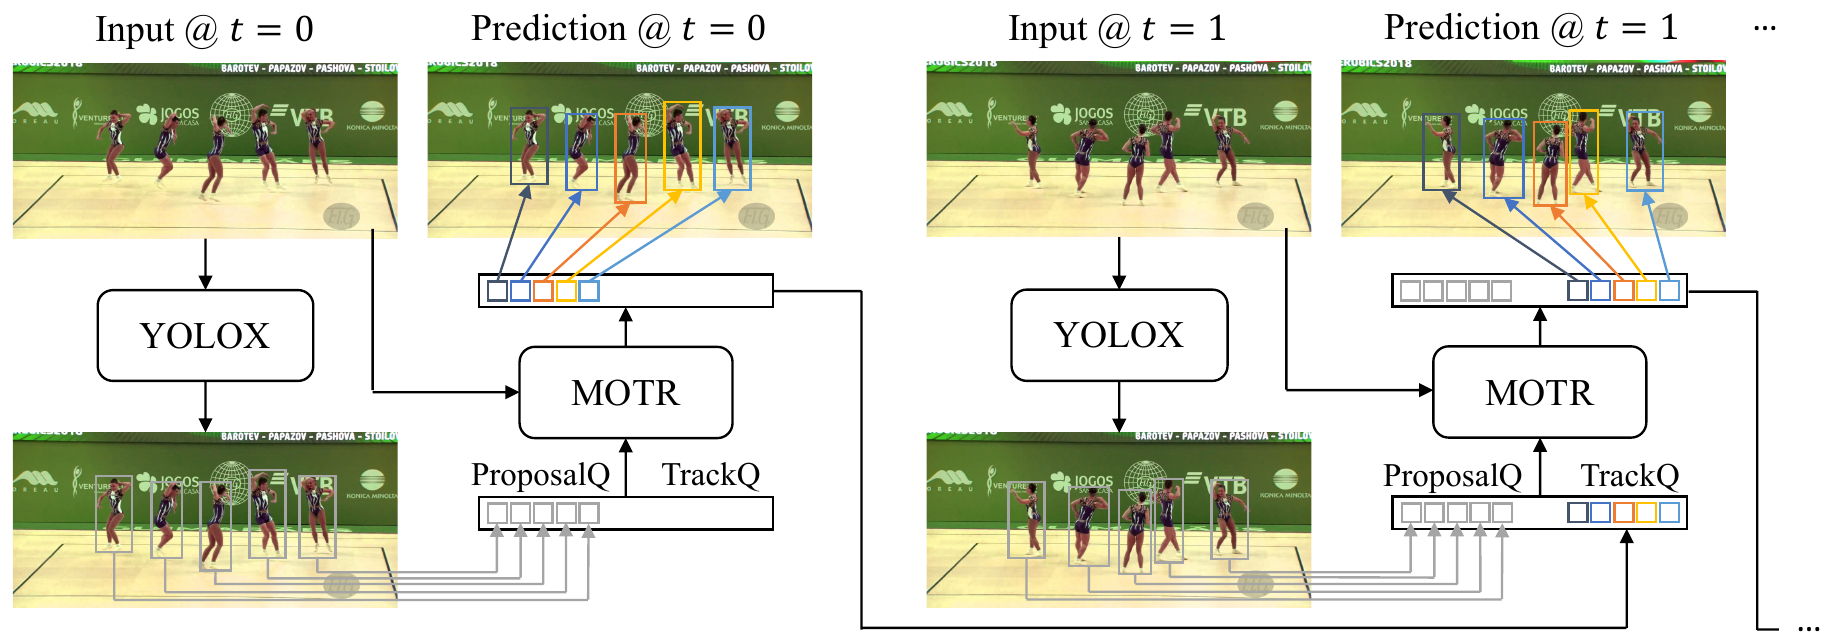
MOTRv2 由一個現成的 YOLOX 偵測器,和一個改成錨框式的 MOTR 組成。
錨框式的查詢
關鍵的一步來自 DAB-DETR 這類偵測器的想法。查詢不只是一個抽象的嵌入,還帶著一個明確的錨框(中心、寬、高)。解碼器只要預測相對於錨框的偏移量,偵測就變得容易很多。
作者把 MOTR 的偵測查詢和軌跡查詢都改成這種錨框式的寫法。原本可學習的位置嵌入,換成錨框座標的 sine-cosine 編碼。
這樣一來,外部偵測器的框就能直接拿來當錨框,偵測的先驗資訊就這樣接進了 MOTR。
提議查詢
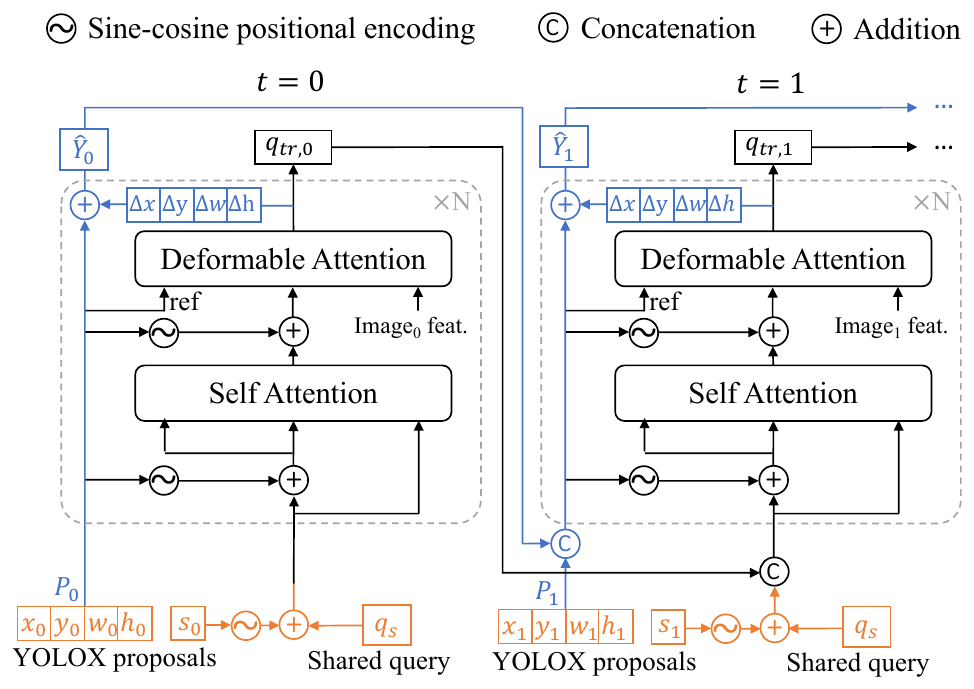
每一幀,YOLOX 會產生 個候選框,每個框有中心 、寬高 和信心分數 。為了盡量不漏掉物體,信心分數只要超過 0.05 就保留。
提議查詢(proposal query)分三步產生:
- 一個可學習的共用查詢 ,大小 ,複製成 。
- 每個候選框的信心分數 ,用 sine-cosine 編碼成一個 維向量。
- 兩者相加,就是這一幀的提議查詢;候選框本身則作為它們的錨框。
所有提議查詢共用同一個嵌入,彼此的差別只來自錨框位置和信心分數。另外還保留了 10 個可學習的錨框,用來撿回 YOLOX 漏掉的物體。
信心分數要不要編碼進去,作者也比較過。完全不用分數,驗證集 HOTA 63.0;用線性投影 63.4;用 sine-cosine 編碼 63.7。信心分數對 MOTR 來說是有用的資訊。
框的傳遞
第一幀只有新物體。提議查詢經過解碼器,輸出相對於 YOLOX 框的偏移量,加回去就是預測框 ;更新後的查詢成為軌跡查詢 。
之後每一幀,上一幀的軌跡查詢 和這一幀的提議查詢 串接在一起;上一幀的預測框 也和這一幀的 YOLOX 框 串接,當作所有查詢的錨框。
分工就此確定。提議查詢只負責新出現或先前漏掉的物體,軌跡查詢負責重新定位已經在追的物體。兩者之間的協調,交給解碼器的自注意力。提議查詢要看軌跡查詢,避免把已經在追的人重複偵測一次;軌跡查詢也能參考 YOLOX 的框,讓位置更準。
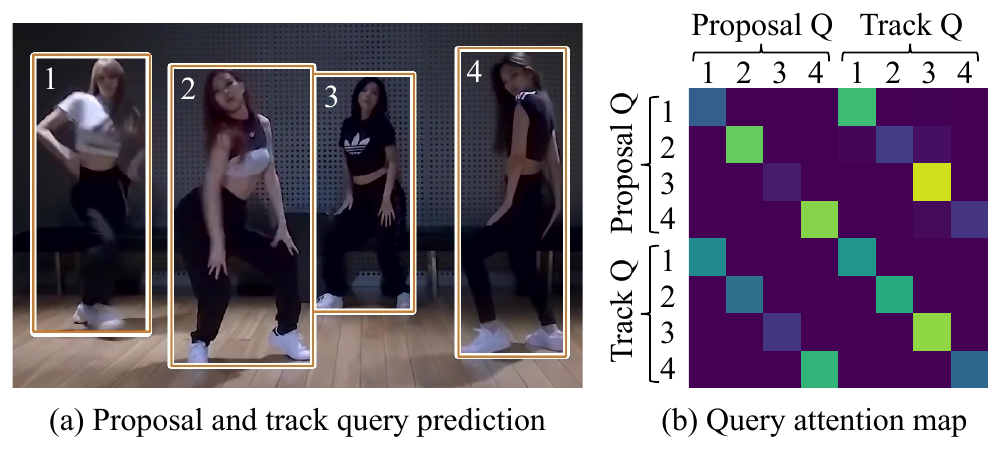
作者把自注意力圖畫出來。同一個人的提議查詢和軌跡查詢之間,注意力明顯較高,兩者確實在交換資訊。
MOTR 原本只傳遞中心點作為參考點,MOTRv2 傳遞的是完整的框。作者比較過這兩種作法:以 DanceTrack 驗證集的 AssA 來看,只傳中心點時是 49.2,傳整個框時升到 53.1。上一幀框的寬高,對關聯很有幫助。
訓練
訓練時,每段短片 5 幀,幀與幀的間隔從 1 到 10 隨機選。
原本的 MOTR 會人為插入假的軌跡查詢、或隨機丟掉真的,模擬誤報與漏偵測。MOTRv2 不再這麼做,而是直接把信心分數高於 0.5 的軌跡查詢傳下去。訓練中自然出現的誤報和漏偵測,就是最真實的擴增。
在 DanceTrack 和 MOT17 上,YOLOX 本身不再訓練,直接使用 DanceTrack 和 ByteTrack 官方釋出的權重,在訓練前先把所有影像的候選框算好。
另外兩個訓練技巧:
- 混合 CrowdHuman。 和 MOTR 一樣,把 CrowdHuman 的單張影像做成 5 幀的假影片,和 DanceTrack 一起訓練。
- 查詢去噪。 借用 DN-DETR 的去噪輔助任務加速收斂。但預設的雜訊太大,比相鄰兩幀之間的移動還大,反而傷害關聯;作者把雜訊縮小之後,DetA 提升了 2.1 分。
討論
一步一步加上去
| 設定 | 驗證集 HOTA | 測試集 HOTA |
|---|---|---|
| MOTR | 51.7 | 54.2 |
| + 實作調整 | 54.8 | |
| + 傳遞整個框 | 57.1 | |
| + YOLOX 與 CrowdHuman | 63.7 | |
| + 查詢去噪 | 64.5 | 69.9 |
| + 額外關聯、加入驗證集、模型集成 | 73.4 |
整理自原論文 Table 5,DanceTrack;每一列都在上一列的基礎上累加。
從 MOTR 的 54.2 到 MOTRv2 的 69.9,測試集 HOTA 多了 15.7 分。最大的一步是接上 YOLOX 並混合 CrowdHuman 訓練,驗證集一口氣多了 6.6 分。
YOLOX 和 CrowdHuman 這一步,作者另外拆開來看:
| CrowdHuman | YOLOX | HOTA | DetA | AssA |
|---|---|---|---|---|
| 57.1 | 66.2 | 49.5 | ||
| ✓ | 60.7 | 74.8 | 49.6 | |
| ✓ | 56.7 | 73.7 | 43.9 | |
| ✓ | ✓ | 63.7 | 76.6 | 53.2 |
整理自原論文 Table 6,DanceTrack 驗證集。
只加 CrowdHuman,偵測變好了,AssA 卻掉了 5.6 分,HOTA 還略降。作者的解釋是,CrowdHuman 的假影片是用仿射變換做出來的,人的「運動」和舞蹈差很多,而且訓練會被拉去處理更多困難的偵測,偏向偵測、犧牲關聯。
有了 YOLOX 之後,情況反過來。偵測交給 YOLOX,MOTR 不用再為偵測掙扎,CrowdHuman 帶來的額外資料就能轉化成關聯能力,AssA 從 49.6 升到 53.2。
這兩張表合起來看,正好說明了這篇的核心主張:偵測和關聯在 MOTR 裡互相衝突,把偵測卸下來,關聯才能學好。
DanceTrack
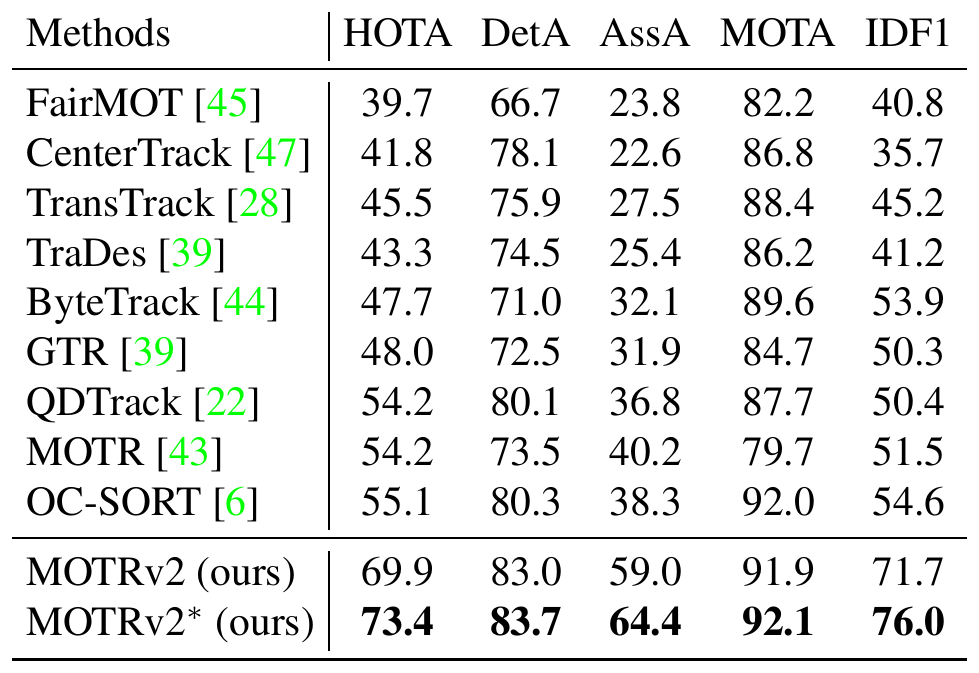
MOTRv2 的 HOTA 69.9,比先前最好的 OC-SORT 高出 14.8 分。AssA 59.0,比 OC-SORT 的 38.3 高了二十分以上;DetA 83.0,也比 OC-SORT 的 80.3 高。關聯大幅領先,偵測也不再落後。
表上的 MOTRv2* 拿到 73.4,是第一屆團體舞多人追蹤挑戰賽的冠軍。但這個數字另外加入了驗證集訓練、4 個模型集成,以及一條後處理規則。如果一條軌跡結束後 20 到 100 幀內,剛好只出現一條新軌跡,就把兩者視為同一個人。這條規則很實用,但已經不是端到端了。
BDD100K
BDD100K 有 8 個類別。MOTRv2 為每個類別各配一個共用查詢,驗證集上 mMOTA 43.6、mIDF1 56.5,比先前最好的 Unicorn 高 2.4 和 2.5 分。
和一個同樣加了 BDD100K 影像聯合訓練、也傳遞整個框、但不用 YOLOX 的 MOTR 相比,mMOTA 多了 8.1 分,mIDF1 多了 8.3 分,YOLOX 的幫助在多類別場景同樣明顯。
MOT17 與 MOT20
MOT17 上,MOTRv2 的 HOTA 62.0、MOTA 78.6、IDF1 75.0,比 MOTR 的 57.8、73.4、68.6 好很多,但仍比 ByteTrack(63.1、80.3、77.3)和 BoT-SORT(64.6、80.6、79.5)低。
MOT20 也一樣。MOTRv2 的 HOTA 60.3,加入 MOT17 聯合訓練後 61.0,仍低於表上 ByteTrack 的 61.3 和 OC-SORT 的 62.4。
作者把差距歸因於資料量。MOT17 的訓練影片太少,不夠訓練一個以查詢為核心的追蹤器;加入 MOT17 一起訓練之後,MOT20 的差距就縮小了一些。
為了在 MOT17、MOT20 這種擁擠場景用好 YOLOX 的框,作者另外加了「軌跡查詢對齊」:把 MOTR 的預測框和 YOLOX 的框用 IoU 做匈牙利配對,IoU 大於 0.5 的就用 YOLOX 的框取代錨框,沒配上的預測則視為誤報移除。只對齊錨框,MOT17 半驗證集的 MOTA 就從 75.9 升到 84.3。查詢嵌入本身的傳遞沒有改變,但這一步其實又把 IoU 配對請回來了。
限制
作者列了三個限制:
- 需要大量資料。 在小資料集上效果不夠好,MOT17 就是例子。
- 重複的軌跡查詢。 兩個人交錯而過時,偶爾會有一個軌跡查詢跟錯人,結果兩個軌跡查詢跟著同一個人。
- 速度。 在 2080Ti 上,YOLOX 每秒 25 幀,MOTR 每秒 9.5 幀,合起來只有 6.9 幀。
結論
MOTRv2 沒有去改 MOTR 的關聯,而是把偵測交了出去。外部偵測器的框變成查詢的錨框,MOTR 只需要調整位置、決定誰是誰。
在 DanceTrack 這種偵測簡單、關聯困難的場景,這個分工效果驚人,HOTA 一口氣多了將近 15 分。
不過,為了在 MOT17 上追得更好,作者最後還是用了 IoU 配對來對齊錨框,再加上一條後處理規則去 DanceTrack 衝冠軍。端到端追蹤器想要拿到最好的成績,最後還是得向 tracking-by-detection 借幾招。