原始论文
MOT16: A Benchmark for Multi-Object Tracking
- 发表版本
- 正式发表信息尚未核实
- arXiv 首次提交
- arXiv:1603.00831
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multiobjecttrackingmot162016,
  title = {{MOT16: A Benchmark for Multi-Object Tracking}},
  author = {Anton Milan and Laura Leal-Taixe and Ian Reid and Stefan Roth and Konrad Schindler},
  year = {2016},
  eprint = {1603.00831},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1603.00831}
}
跟踪论文读久了,MOT16、MOT17 这两个名字几乎每篇都会出现。DeepSORT 在 MOT16 上报成绩,Tracktor、FairMOT、ByteTrack、BoT-SORT 的主表都是 MOT17。
这篇就是它们的源头。
2014 年 10 月,阿德莱德大学、苏黎世联邦理工学院与达姆施塔特工业大学的研究者上线了 MOTChallenge。它包含一份共用的数据集、一套统一的评估代码,以及一个任何人都能上传结果的排行榜。第一版叫 MOT15,有 11 段训练视频、11 段测试视频。到这篇论文写成时,已经有 47 个方法上传了结果,注册用户超过 180 个。SORT 的成绩就是在 MOT15 上跑出来的。
但 MOT15 用了一年多,问题也浮现出来了。Anton Milan、Laura Leal-Taixé 等人于是推出了第二版,也就是 MOT16。
定义问题
评估多目标跟踪比评估很多视觉任务都难。作者列了三个原因。
一、正确答案本身就说不清楚。 一个人被挡住一大半,算不算要跟踪的目标?橱窗玻璃上的倒影、海报上的人、人体模特呢?就算请人来标,彼此的意见也可能不同。
二、指标各说各话。 CLEAR MOT 是当时的主流,但判断「预测框和真实框匹配上了」的 IoU 阈值,不同论文从 25% 到 50% 都有;评估代码的实现细节也各不相同,结果差很多。
三、没有固定的训练与测试划分。 以 PETS 2009 为例,最简单的 S2L1 序列,给了好的检测后,跟踪准确度早就超过 90%。但大家用的子集、训练方式、评估代码、检测输入都不一样,结果其实没法比较。作者问得很直接,这些序列对现在的方法来说已经太简单了吗?还是方法根本只是过拟合,或者评估方式出了问题?
MOTChallenge 用共用数据、统一评估、公开排行榜来回答这些问题。但第一版的 MOT15 也有它的毛病:
- 标注规则不一致。部分序列的标注直接沿用各个旧数据集,标准不一。
- 训练集和测试集的拥挤程度分布不平衡。
- 有些序列太简单又太有名(例如 PETS09-S2L1),方法都对它们过拟合了。
- 官方提供的检测结果太差,有些参赛者干脆换掉了检测器。
最后一点,SORT 那篇已经示范过。SORT 的论文主张,正是换掉 MOT15 官方的 ACF 检测,跟踪成绩就大幅提升了。
解决问题
MOT16 准备了全新的视频、一套严格的标注规则,以及一套讲清楚的评估方式。
14 段新视频
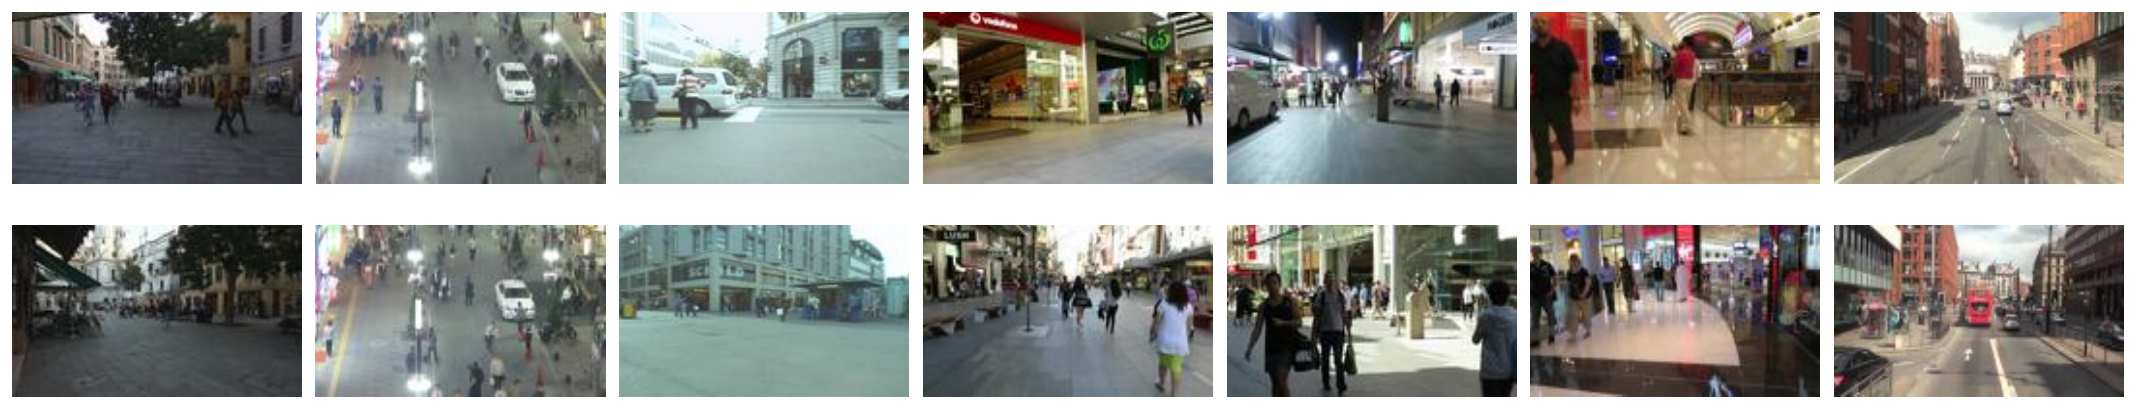
MOT16 共有 14 段视频,一半训练、一半测试,测试集的标注不公开。和 MOT15 相比,框的数量是它的将近 3 倍,平均拥挤程度也是 3 倍。
这些视频刻意做得很不一样:
- 相机: 固定在场景中,或由人手持、放在婴儿车上、装在车上移动。
- 视角: 从高处俯瞰、和行人同高,或从低处拍。
- 环境: 晴天(有阴影和过曝)、阴天、夜晚(大量运动模糊)、室内。
- 帧率: 大部分是 30 FPS,也有 25 和 14 FPS 的视频。
据原论文 Table 2 的统计,训练集共 5,316 帧、512 条轨迹、110,407 个行人框,平均每帧 20.8 人;测试集共 5,919 帧、830 条轨迹、182,326 个行人框,平均每帧 30.8 人。
这份统计里还藏着一个值得注意的地方。测试集里的 MOT16-03 是一段夜间的俯瞰人群,平均每帧 69.7 人,光这一段就有 104,556 个行人框,占整个测试集的 57%。MOTA 是把所有序列串在一起计算的,所以这一段的表现,会大幅左右整体分数。
谁该被跟踪?
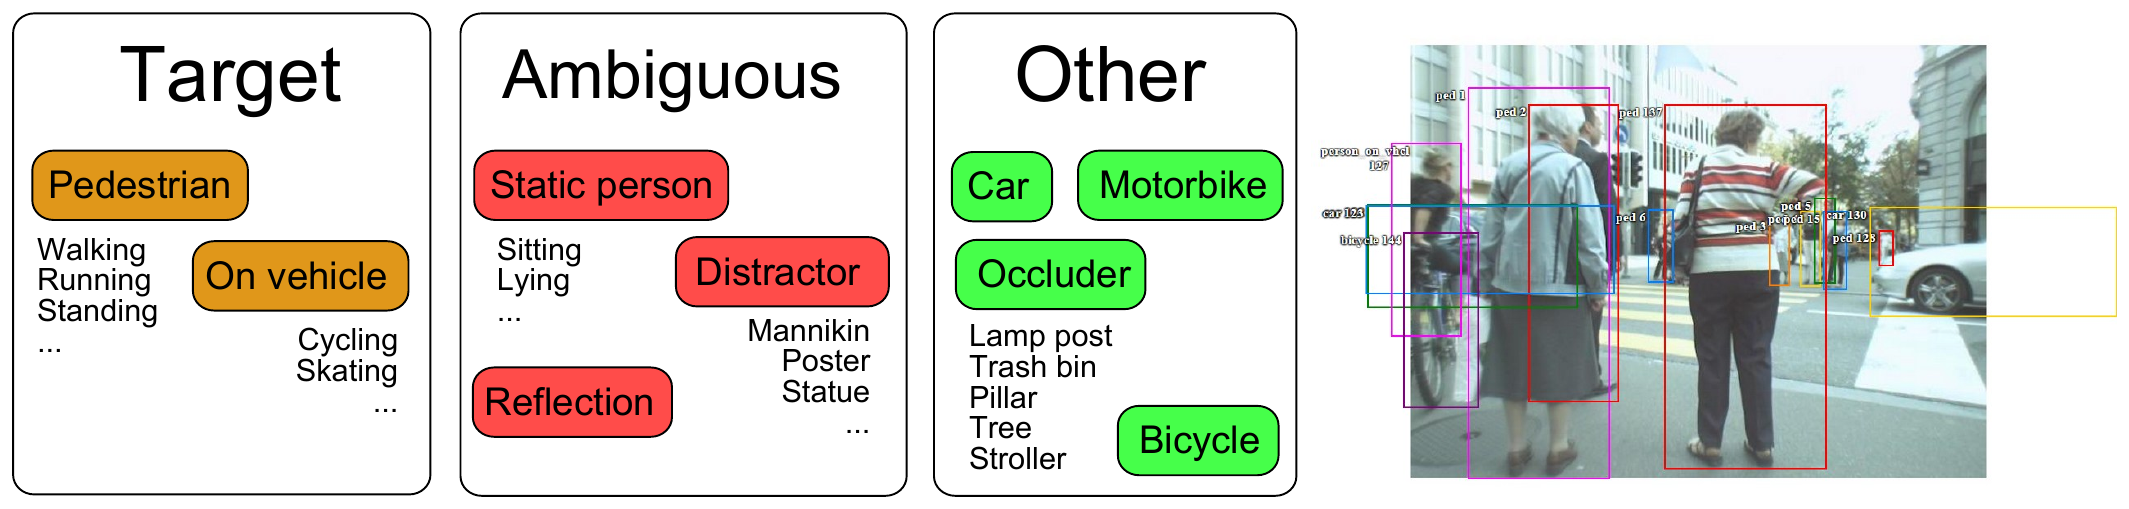
所有序列都由研究人员按照同一套规则从头重新标注,再交叉检查。规则的核心是把「像人的东西」分成三组:
- 目标: 所有直立的人,不管是走路、跑步还是站着。这是跟踪器要跟踪的对象。
- 模糊类别: 不是直立姿势的人(坐着、躺着),以及各种人的「替身」,包括倒影、海报、照片、人体模特,还有玻璃后面的人。
- 其他: 移动中的车辆、摩托车、自行车、婴儿车,以及柱子、树这类遮挡物。
第二组是这篇论文很聪明的地方。检测器看到海报上的人,很可能也会框出来;跟踪器老老实实地跟踪了这个框,算不算错?MOT16 的回答是,这些情况不罚也不奖。评估时,和干扰物、静止的人、倒影、骑在车上的人重叠超过 50% 的预测框会直接被移除,既不算误报,没跟踪到也不算漏检。
第三组虽然不参与评估,但标出来可以拿来训练,也可以用来计算每个行人被挡住了多少。
框本身也有规则:
- 框要包住这个人的所有像素,同时尽可能紧。 侧面走路的人,框的宽度会随步伐周期变化;被挡住的部分,要根据身高、影子、前后帧等线索推测完整范围;被画面边缘截掉的人,框可以延伸到画面外。
- 能确定位置就开始标,大约露出一成就开始;确定不了就结束。
- ID 尽量保持。 只要这个人还在画面里、路径能清楚判断,就保持同一个 ID;被挡住时,只要用匀速这类简单推理就能确定位置,也要继续标。挡得太久、看不出路径,再出现时给新的 ID。
- 每个框都有可见度。 不用人工标,而是用地面假设和所有框的位置自动算出来,从 0 到 1。
最后还有一道「合理性检查」,用行人检测器把所有视频跑一遍,把检测器置信度很高、标注却漏掉的人或干扰物补上。
这套规则后来影响很深。我们在 Tracktor 那篇看到的可见度分析、CenterTrack 和 ByteTrack 专门处理的「框超出画面」问题,都来自这里。
官方检测与数据格式
作者测试了几种行人检测器,最后提供 DPM v5 的检测结果作为官方的公开检测。原因是当时现成的 R-CNN 除了「人」这一类,其他类别都比 DPM 好,偏偏行人检测输给了 DPM。为了让召回率高一点,检测阈值设得很低。
所有标注和检测都是逗号分隔的文本文件,每一行一个框,九个字段依次是帧号、ID、框左上角的 x 与 y、宽、高、置信度分数(标注文件里改成「是否纳入评估」的标志位),最后两个字段在标注文件里是类别和可见度。检测文件的 ID 一律填 −1,因为还没有被跟踪。
这个格式一直用到今天。你在 GitHub 上看到跟踪器把结果写成一行一行的 frame,id,x,y,w,h,...,十有八九就是在对齐 MOTChallenge。
评估怎么算
评估沿用 CLEAR MOT(MOTA、MOTP)和 Wu 与 Nevatia 提出的轨迹质量指标(MT、ML、FM)。重点是把每个细节都讲清楚。
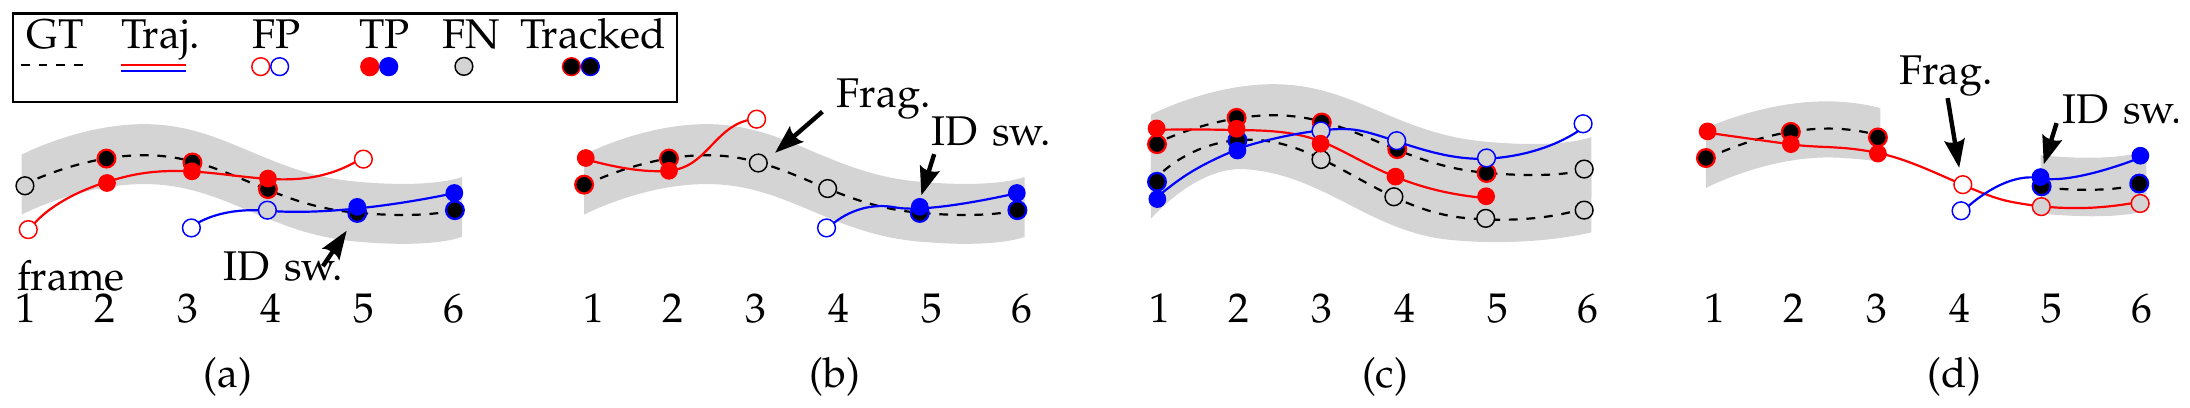
匹配。 每一帧用匈牙利算法把预测框和真实框一对一匹配,IoU 阈值是 50%。但匹配不是每一帧各自独立做。如果某个真实目标在上一帧分配给了轨迹 ,这一帧和 的距离仍在阈值内,就沿用这个匹配,即使旁边有更近的预测框也一样。
ID 切换。 一个真实目标这一次匹配到的轨迹,和它上一次匹配到的轨迹不同,就算一次 ID 切换(IDSW)。作者特别提醒,跟踪到两倍轨迹的方法,ID 切换次数自然也会更多,所以另外报告 ID 切换除以召回率的相对数字。
断裂。 一条真实轨迹从「有跟踪到」变成「没跟踪到」,之后又被跟踪回来,算一次断裂(FM)。
MOTA 与 MOTP。 MOTA 把漏检、误报和 ID 切换加起来,除以真实框总数再用 1 去减,范围是负无穷大到 100%,错得太多时可以是负的。MOTP 是所有匹配上的框的平均重叠,作者直接说明,它主要反映检测器的定位精度,对跟踪器本身的表现说明不了多少。
MT 与 ML。 一条真实轨迹有 80% 以上的时间被跟踪到,算「大部分跟踪到」;不到 20%,算「大部分跟丢」。这两个指标不管 ID 有没有换过。
所有测试序列串在一起计算,不是各自算完再平均,因为各序列的人数差得太多了。
作者也坦白说明了这些指标的局限。MOTA 把三种错误合成一个数字,好处是方便比较,但「它能否单独作为唯一的指标,非常值得商榷」。作者也说明,这套评估并不处理重识别。目标离开画面再回来,就被当成新的目标。
讨论
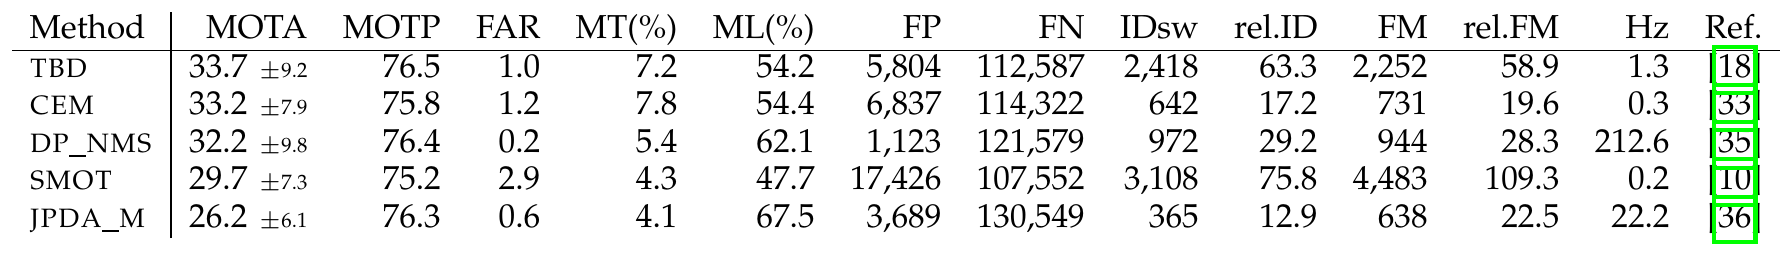
作者用公开的代码重跑了五个当时常见的方法,涵盖网络流(DP_NMS)、连续能量最小化(CEM)、运动相似度(SMOT)、两阶段匹配(TBD)和近似的联合概率数据关联(JPDA_M)。
参数怎么调,作者也写清楚了。从作者建议的默认值出发,每个参数在 之间随机采样,在训练集上跑 20 次,挑 MOTA 最高的那组,只在测试集上跑一次。作者也声明,这些数字未必是各方法的最佳表现。
结果有三个地方值得看:
- MOTA 最高也只有三十出头。 最好的 TBD 是 33.7,最差的 JPDA_M 是 26.2。
- 大部分人都跟丢了。 每个方法的 ML 都在 47% 以上,FN 都超过十万。也就是说,检测没找到的人,跟踪器也救不回来,而官方的 DPM 检测漏掉了很多人。
- 速度差了一千倍。 DP_NMS 每秒 212.6 帧,SMOT 只有 0.2 帧。准确度差不多的方法,速度可以差到这种程度。
把这张表和后来的论文对照,就能看到检测器的影响有多大。一年后,DeepSORT 换上一组质量好得多的私有检测,在同一个 MOT16 测试集上拿到 61.4 的 MOTA;再过几年,FairMOT 是 74.9。跟踪方法当然进步了,但从三十多分一路跳到七十多分,大部分的功劳属于检测器。
后来
2017 年,MOTChallenge 推出 MOT17。视频和 MOT16 完全相同,但标注又修正了一轮,官方检测也从只有 DPM 一组,增加到 DPM、Faster R-CNN、SDP 三组,参赛者要用三组检测各跑一次,再把结果平均。我们在 Tracktor 那篇看到的「public detection」赛道,就是在这个设置下比赛。
2020 年的 MOT20 则把拥挤程度推到极限,据 ByteTrack 论文的统计,测试集平均每帧有 170 人。同一年,Leal-Taixé 等 MOTChallenge 的维护者也参与提出了 HOTA,正式回应了这篇论文里那句「MOTA 能否单独作为唯一指标,非常值得商榷」。
结论
MOT16 给了多目标跟踪 14 段新视频、一套从头重做的标注规则,以及一套把匹配、ID 切换、断裂都定义清楚的评估方式。它最精细的设计,是把倒影、海报、坐着的人放进「不罚也不奖」的模糊类别,让跟踪器不会因为检测器的合理反应而被扣分。
下次在论文表格里看到 MOT17 的数字,可以先问,用的是公开检测还是自己的检测?再想想测试集的 MOTA 里,MOT16-03 那段夜间人群占了多少分量。
至于哪些人该被跟踪,十年后大家还在用这篇论文的答案。