原始论文
HOTA: A Higher Order Metric for Evaluating Multi-Object Tracking
- arXiv 首次提交
- arXiv:2009.07736
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multiobjecttrackinghota2020,
  title = {{HOTA: A Higher Order Metric for Evaluating Multi-Object Tracking}},
  author = {Jonathon Luiten and Aljosa Osep and Patrick Dendorfer and Philip Torr and Andreas Geiger and Laura Leal-Taixe and Bastian Leibe},
  year = {2020},
  eprint = {2009.07736},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2009.07736}
}
读了几篇跟踪论文,你大概已经对 MOTA 这个数字很熟了。SORT 用它,DeepSORT 用它,Tracktor 和 FairMOT 的主表第一列也是它。
但我们在 DeepSORT 那篇看过,ID 切换少了 45%,MOTA 只多了 1.6 分。FairMOT 也做过一个实验:只训练检测、re-ID 特征几乎是随机的模型,MOTA 居然比两个任务一起训练的还高。
一个号称衡量「跟踪」的指标,好像对「有没有跟对人」不太敏感。
这篇论文来自 RWTH Aachen、慕尼黑工业大学、牛津和图宾根,作者里有 MOTChallenge 的维护者,也有 KITTI 的创建者 Andreas Geiger。他们把 MOTA、IDF1 和 Track-mAP 逐一拆开检查,然后提出新的指标 HOTA(Higher Order Tracking Accuracy)。这篇论文影响有多大,看看后面几篇笔记的主表就知道:HOTA 成了 ByteTrack、OC-SORT 这一代论文的主要指标。
定义问题
多目标跟踪要做对三件事:
- 检测:每一帧找到该找的物体,不多也不少。
- 定位:框要准。
- 关联:同一个物体在不同时刻要拿到同一个 ID,不同物体不能共用 ID。
一个好的指标应该同时反映这三件事,而且让它们的权重合理。作者先检查当时最常用的两个指标。
MOTA
MOTA 在每一帧把预测框和真实框做一对一匹配(IoU 至少 0.5),匹配上的是真阳性(TP),多出来的预测是误报(FP),没匹配到的真实框是漏检(FN)。关联错误则用 ID 切换(IDSW)来计:某个真实物体这一次匹配到的预测 ID,和它上一次匹配到的不同,就记一次。
分母是所有真实框的数量。
IDF1
IDF1 不在每一帧匹配,而是把整条预测轨迹和整条真实轨迹做一对一匹配,挑出重叠最多的组合。匹配上的轨迹在重叠的部分算 IDTP,其余所有真实框算 IDFN,其余所有预测框算 IDFP:
同一个人,两种跟法
我们用原论文第一张图的例子算一遍。
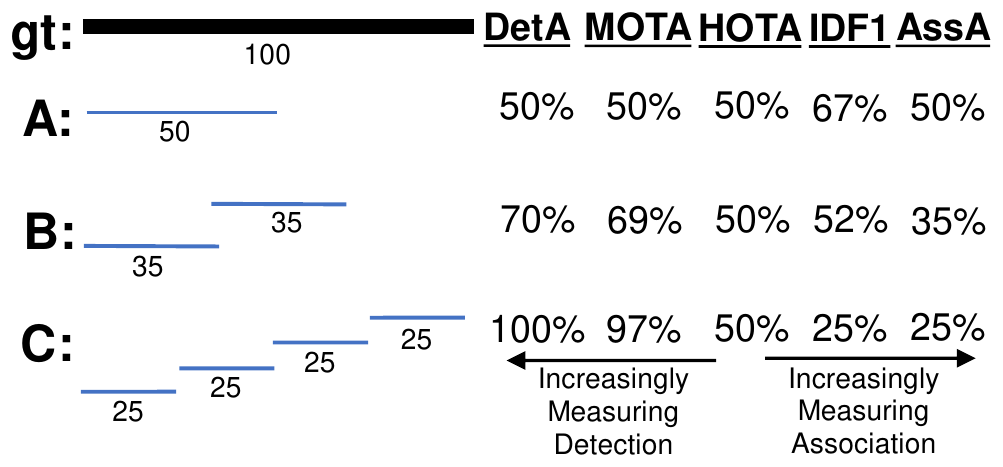
画面里只有一个人,出现了 100 帧。看 A 和 C 这两个跟踪器:
- A 跟踪到前 50 帧,从头到尾同一个 ID,后 50 帧完全没跟到。
- C 每一帧都跟到了,但每 25 帧就换一次 ID,总共四个 ID。
哪一个比较好?
先算 MOTA。A 有 50 个漏检,没有误报,没有 ID 切换,。C 没有漏检、没有误报,ID 切换 3 次,。
MOTA 认为 C 好得多。换了三次 ID,只扣 3 分。
再算 IDF1。A 唯一的一条轨迹匹配上真实轨迹,IDTP = 50,IDFN = 50,IDFP = 0,IDF1 = 。C 只能挑一段 25 帧的轨迹去匹配,IDTP = 25,其余 75 个真实框都是 IDFN,另外三段轨迹的 75 个预测框都是 IDFP,IDF1 = 。
IDF1 认为 A 好得多。C 每一帧都跟到了,这件事几乎没被算进去。
两个指标各站一边,而且都站得很极端。
解决问题
HOTA 的目标是在一个分数里,公平地衡量检测、关联和定位,同时可以拆开来,看出错误来自哪里。
先像 MOTA 一样,在每一帧匹配
HOTA 的匹配和 MOTA 一样,在每一帧把预测框和真实框做一对一匹配,定位相似度 (例如 IoU)至少要达到阈值 。匹配上的是 TP,剩下的是 FP 和 FN。
检测的分数就是标准的 Jaccard 指数:
再对每一个 TP,问它的轨迹对得有多准
关联的部分是这篇论文的新东西。对每一个匹配上的 TP,记为 ,作者定义了三个集合:
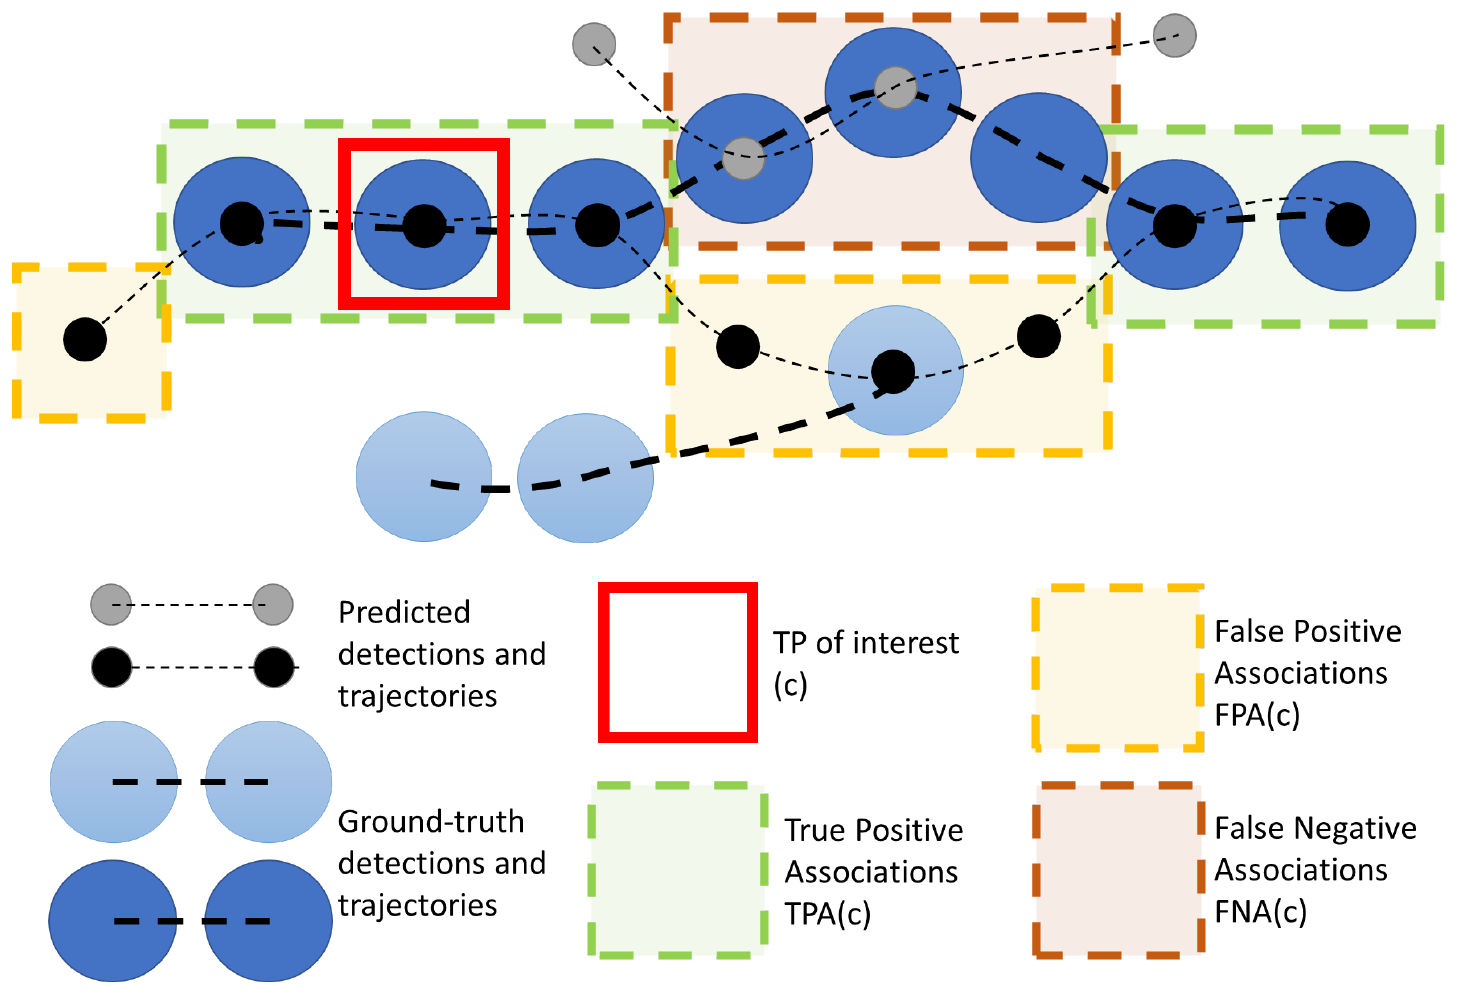
- TPA(True Positive Associations): 和 有相同真实 ID、也有相同预测 ID 的 TP。也就是「同一个人、被跟踪器当成同一个人」的时刻。
- FNA(False Negative Associations): 和 有相同真实 ID,但被分到别的预测 ID、或根本没被检测到的真实框。同一个人,跟踪器却没认出来。
- FPA(False Positive Associations): 和 有相同预测 ID,但其实属于别人、或根本不对应任何物体的预测框。跟踪器以为是同一个人,其实不是。
图中的 有五个 TPA、四个 FPA、三个 FNA。它的关联分数,又是一个 Jaccard 指数:
代入图中的数字:
把所有 TP 的关联分数平均起来,就是关联准确度:
两个分数,取几何平均
作者称之为「双重 Jaccard」。外层是检测的 Jaccard,但分子里每个 TP 不是算 1,而是乘上自己的关联分数。
回到刚才的例子。
A 的 DetA 是 。每一个 TP 的 TPA 都是 50,FNA 是后面没跟到的 50 个真实框,FPA 是 0,关联分数都是 ,AssA 也是 50%。HOTA 。
C 的 DetA 是 100%。每一个 TP 所在的那段轨迹只有 25 帧,TPA 是 25,同一个人的其余 75 帧被分到了别的 ID,都是 FNA,关联分数都是 25%,AssA 也是 25%。HOTA 。
两个跟踪器打平。A 只跟到一半但认得很准,C 全跟到了但一直换 ID。HOTA 不偏袒任何一边,各打五十大板。
最后,把定位也算进去
上面的计算都在固定的定位阈值 下进行。为了把框准不准也算进来,HOTA 在 这 19 个阈值下各算一次,再取平均:
每个阈值都要重新做一次匹配。框越准,在高阈值下还能匹配上的 TP 就越多,最后的分数也越高。
作者特别提醒,DetA 和 AssA 要在每个 下先合成 ,再对 求平均,顺序不能倒过来。所以论文表格里的 HOTA,一般不会刚好等于表格里 DetA 和 AssA 的几何平均。
拆开来看
HOTA 可以一路拆成五个子指标,各自对应一种错误:
- DetRe :漏检。
- DetPr :误报。
- AssRe:把 中的 FPA 去掉后的平均。一个人被切成好几段轨迹,AssRe 就低。
- AssPr:把 中的 FNA 去掉后的平均。一条轨迹跨到好几个人身上,AssPr 就低。
- LocA:所有 TP 的平均定位相似度,同样对各个 取平均。
这组拆解让用户可以按应用挑重点。作者举例,人体动作分析、人群分析或体育赛事分析在乎身份是不是一路都跟对了,AssRe 和 AssPr 比较重要;驾驶辅助系统必须找到每一个行人,也不能为了一个不存在的人紧急避让,DetRe 和 DetPr 比较重要;监控场景则通常宁可多报、不可漏报。
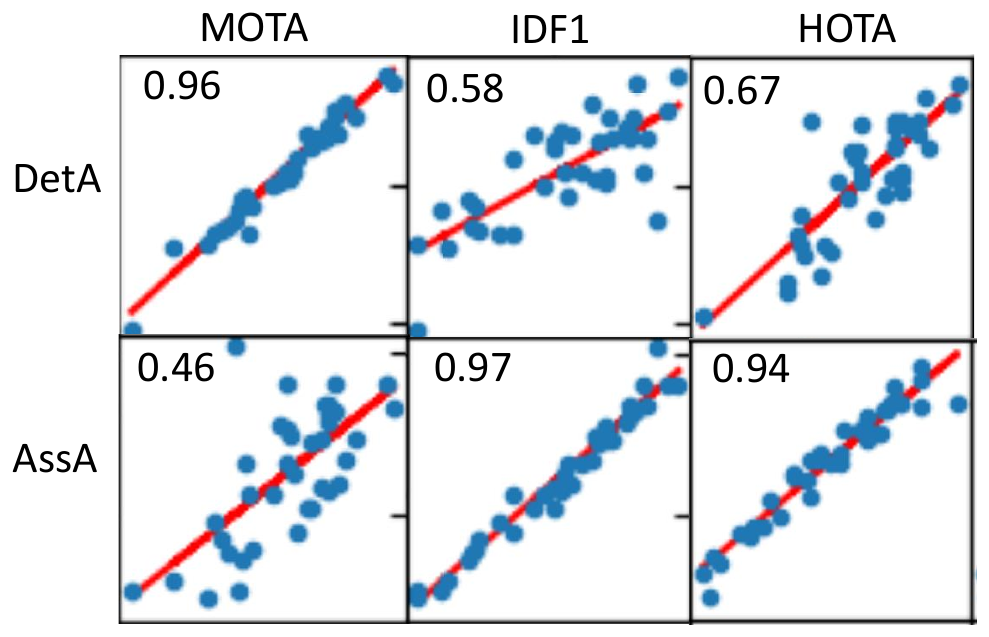
这张图把三个指标放在 MOT17 上,和 DetA、AssA 对照。MOTA 几乎只跟着检测走(),和关联的关系很弱(0.46);IDF1 正好相反(0.58 和 0.97);HOTA 和两者都有明显的关系(0.67 和 0.94)。
HOTA 和 AssA 的关系比较强,并不是因为关联的权重比较大,两者的权重是相等的。原因在于这些跟踪器用的都是同一组公开检测,检测分数差不多,彼此的差距主要来自关联。
讨论
MOTA 的九个问题
作者列了 MOTA 的九个问题。其中最有说服力的几个如下:
- 检测的影响远大于关联。 在 2020 年 4 月 1 日 MOT17 排行榜前十名中,FN + FP 与 IDSW 的数量比介于 42.3 到 186.4 之间,平均 98.6。作者另外拿 175 个跟踪器做线性回归:只看检测的 MODA(MOTA 去掉 IDSW 那一项)可以解释 MOTA 99.4% 的变异,IDSW 只能解释 23.7%。
- 精确率的影响远大于召回率。 去掉 IDSW 之后,MOTA 可以改写成 :对召回率是线性的,对精确率却是双曲线。精确率差一点,分数掉得比召回率差一点多得多。这会鼓励大家调高检测阈值,宁可漏报,不要误报。
- IDSW 只看前一步。 一次 ID 切换,只检查这一次的 ID 和上一次是否相同,看不到整条轨迹的对齐程度。跟踪器犯错后自己改回来,MOTA 会把「改回来」也算成一次 IDSW,等于罚了两次。
- 不罚 ID 转移。 一条预测轨迹从 A 跳到 B 身上,只要 A 和 B 各自没有换 ID,就不算 IDSW。论文的例子是一段只有两帧的视频:一个人被切成两条轨迹,MOTA 是 0.5;两个不同的人被并成一条轨迹,MOTA 是满分 1.0。
- 和帧率有关。 同一段 2.5 秒的轨迹,中间换一次 ID。用 40 FPS 评估,分母有 100 个框,MOTA 是 0.99;用 4 FPS 评估,分母只有 10 个框,MOTA 是 0.90。HOTA 两种情况都是 。
- 没有下限。 误报可以无限增加,MOTA 可以一路跌到负无穷。看到一个负的 MOTA,很难说清楚它代表什么。
IDF1 的问题
IDF1 原本是为多相机跟踪设计的。它的核心问题在于只允许一组最佳的轨迹匹配。没被选中的轨迹,不管跟得多好,里面的每一个正确检测都算成 IDFP,反而让分数下降。所以 IDF1 对检测不是单调的:检测做得更好,分数可能变差。
这也解释了为什么许多新的基准仍然选择 MOTA。检测是跟踪很重要的一部分,而 IDF1 衡量不好它。
为什么是 Jaccard、为什么要开根号
论文第 7 节检查了好几个设计选择。
- Jaccard 而不是 F1 或 MODA。 作者用一个例子证明,只有 Jaccard 形式能保证单调性:多一个正确检测,分数一定上升;把预测和真实互换,结果也一样。F1 在某些长度比例下会把较差的结果排得更高,MODA 则不对称。
- 开根号的三个作用。 一是让 HOTA 的数值范围接近大家熟悉的 MOTA 与 IDF1;二是让 HOTA 成为检测与关联的几何平均,任何一边趋近于零,总分就趋近于零;三是抵消重复计算。关联分数里本来就包含了匹配上的轨迹中的 FN 和 FP,若不开根号,这些错误会被罚两次。在只有一个物体的单目标跟踪情况下,DetA 和 AssA 会完全相同,开根号后 HOTA 刚好等于一个 Jaccard 指数。
- DetA 不能省。 没有匹配上任何轨迹的 FN 和 FP 不会出现在 AssA 里,需要 DetA 来惩罚;而且只看 AssA 不是单调的:加进一个关联很差的 TP,平均值会下降。
人怎么看
最后,作者做了一项用户研究。他们把 MOT17 的七段测试视频切成 36 段 6 秒的片段,挑出两个指标意见相反的跟踪器配对,让受试者看两段跟踪结果,选出比较好的那个。
共有 230 人参与,其中 62 人是多目标跟踪研究者,122 人是计算机视觉研究者,总计比较了 2075 组,平均每组花 2 分 13 秒。
不计两者打平的票,HOTA 对上 MOTA 时,受试者有 61.6% 站在 HOTA 这边;HOTA 对上 IDF1 时,比例是 72.0%;MOTA 对上 IDF1 则大致五五开。只看多目标跟踪研究者,HOTA 对 MOTA 的胜率升到 79.3%,对 IDF1 升到 85.9%。
后来
HOTA 很快被采用。KITTI 的跟踪排行榜在 2021 年 2 月改用 HOTA 排名,评估代码来自作者维护的 TrackEval;DanceTrack 等新基准也以 HOTA 为主要指标。后面读到的 ByteTrack、OC-SORT、StrongSORT、BoT-SORT,主表都把 HOTA、MOTA、IDF1 并列。
也有人觉得 HOTA 还不是最终答案。2021 年,Google Research 的 Jack Valmadre 和 Alex Bewley(对,就是 SORT 的作者)等人提出时间上局部的跟踪指标 ALTA。他们认为,很多应用能容忍一定程度的关联错误,检测与关联的相对重要性应该可以调整,于是用时间窗口的长度当作调整的旋钮。HOTA 把两者固定成五五开,是一种选择,但不是唯一的选择。
结论
每一帧先匹配,每一个匹配上的框再用整条轨迹衡量关联有多准,最后把检测和关联取几何平均,并对 19 个定位阈值求平均,这就是 HOTA。它能拆成检测召回、检测精确、关联召回、关联精确和定位五个子指标。
以后读跟踪论文的表格,别只看 HOTA 一列,顺手看一下 DetA 和 AssA。一个方法的 HOTA 进步了,到底是检测器换好了,还是关联真的变强了,这两列一眼就看得出来。
MOTA 说换三次 ID 只要扣三分,IDF1 说全程跟住也不算什么。
HOTA 说,你们两个都对,也都不对。