原始论文
MeMOTR: Long-Term Memory-Augmented Transformer for Multi-Object Tracking
- 发表版本
- ICCV 2023会议
- arXiv 首次提交
- arXiv:2307.15700
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multiobjecttrackingmemotr2023,
  title = {{MeMOTR: Long-Term Memory-Augmented Transformer for Multi-Object Tracking}},
  author = {Ruopeng Gao and Limin Wang},
  year = {2023},
  eprint = {2307.15700},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2307.15700}
}
MOTR 用一个轨迹查询代表一条轨迹,这个查询在每一帧经过解码器、更新,再传给下一帧。物体的身份,就靠这一连串的传递维持下去。
问题是,每一帧的查询只看得到上一帧。舞者被挡住几帧、转个身、和穿一样衣服的人擦肩而过,这一帧的输出就可能变得不可靠,而下一帧的查询就是从这个不可靠的输出来的。
南京大学的 Ruopeng Gao 和王利民(也是 SportsMOT 的通讯作者)想让轨迹查询多记住一点过去。他们给每一条轨迹加上一份长期记忆,更新得很慢,用来稳住轨迹查询。这就是 MeMOTR。
定义问题
作者指出 MOTR 这类基于查询的跟踪方法有两个问题。
只用到相邻两帧。 不管是融合查询还是融合特征,大多数方法只显式利用了相邻两帧的信息。轨迹查询虽然一直在更新,却没有一个稳定的长期表示。同一个人的查询在几帧之间变化太大,就容易在关联时出错。先前的 MeMOT 用一个很大的记忆库存下过去的特征,但存储成本很高。
检测查询和轨迹查询不在同一个层次。 DETR 的可学习目标查询,作用比较像一个可学习的锚框,本身没什么语义。轨迹查询则是从上一帧的输出来的,已经知道自己代表什么类别、在哪个位置。把这两种查询从头一起丢进同一个解码器,两者之间有一段语义上的落差。
解决问题
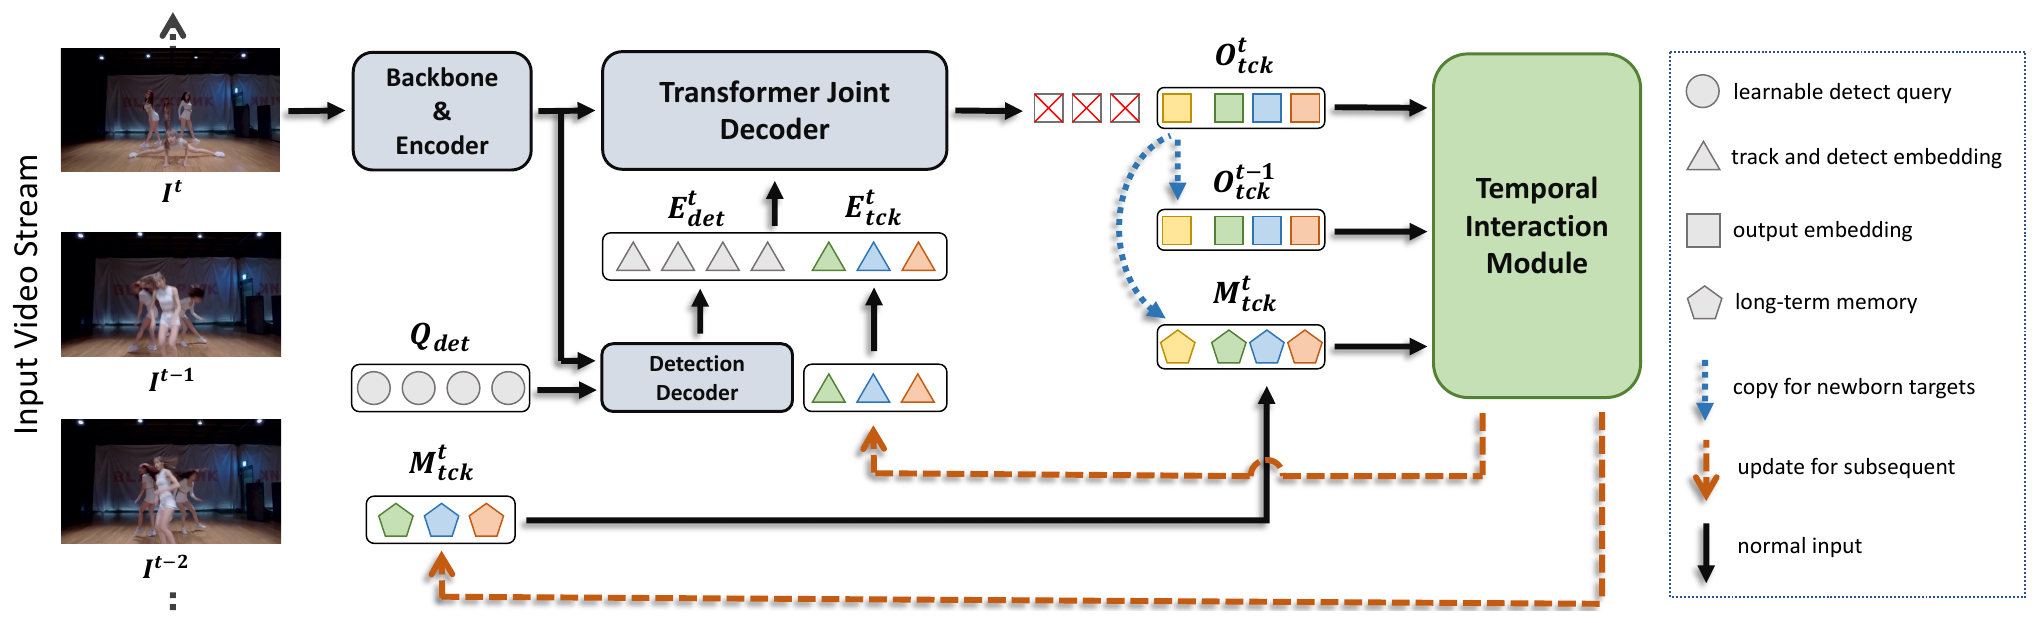
整体架构和 MOTR 很像,ResNet-50 骨干网络加上 Transformer 编码器提取图像特征,解码器同时处理检测和跟踪。不同的地方有三个:解码器拆成两段、每条轨迹多一份长期记忆,以及一个生成下一帧轨迹嵌入的时间交互模块。检测框架用的是 DAB-Deformable-DETR,作者也提供了标准 Deformable-DETR 的版本,方便和 MOTR 公平比较。
先让检测查询有点概念
原本的解码器有 6 层。MeMOTR 把第 1 层拿出来,作为检测解码器,只处理检测查询。检测查询经过这一层,大致找到物体的位置和类别,变成带有语义的检测嵌入 。
接着把检测嵌入和轨迹嵌入 拼在一起,送进剩下 5 层组成的联合解码器。这时两种查询都已经「知道自己在找什么」,起点比较一致。
长期记忆
每一条新出现的轨迹,用它当下的输出初始化一份长期记忆 。之后每一帧这样更新:
是这条轨迹在第 帧的解码器输出。这是一个指数加权移动平均,。
0.01 是一个很小的数字。作者的假设是,物体在连续几帧之间只有轻微的形变和移动,语义特征应该变化得很慢,记忆也应该平稳地更新。
我们算一下它能记多久。某一帧的输出放进记忆时权重是 ,之后每过一帧就乘上 0.99。,所以大约 69 帧之后,这一帧的影响就只剩一半。DanceTrack 的视频是每秒 20 帧,也就是 3 秒半左右。整体来说,这份记忆大约是最近 100 帧、5 秒的平均。
一个舞者转身、被挡住两三秒,这份记忆几乎不会被那几帧的噪声带偏。
时间交互模块
长期记忆要怎么用到下一帧的跟踪上?靠的是时间交互模块。
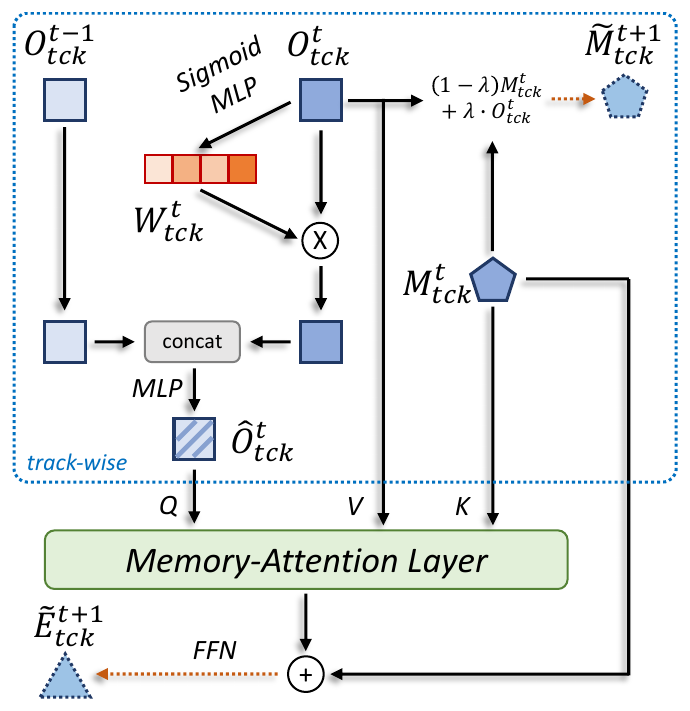
它分成两步。
第一步,融合相邻两帧。 这一帧的输出可能因为遮挡或模糊而不可靠,所以先用一个小网络为它生成逐通道的权重:
把权重乘上这一帧的输出,再和上一帧的输出 拼接,经过两层 MLP,得到融合后的 。上一帧的输出不用乘权重,因为它能留下来,说明置信度已经过了阈值,相对可靠。
第二步,让轨迹之间互相比较。 同一帧里有好几个长得很像的人,作者希望每条轨迹的表示能和别人分得更开。所以用一个多头注意力,称为记忆注意力层,让所有轨迹交互:查询(Q)是融合后的 ,键(K)是长期记忆 ,值(V)是这一帧的输出 。
注意力的输出再加上长期记忆,经过一个前馈网络,就是下一帧的轨迹嵌入 。因为加进了变化缓慢的长期记忆,轨迹嵌入也不容易在相邻两帧之间突然改变。
什么时候更新
推理时有三个阈值,都设成 0.5:
- 检测的置信度超过 ,就成为新轨迹。
- 已跟踪物体的置信度低于 ,不直接删掉,而是标成暂时丢失;连续 帧都找不回来才删除。DanceTrack 上 是 30 帧,MOT17 是 15 帧。
- 只有置信度 超过 ,才用时间交互模块的输出 、 更新轨迹嵌入和长期记忆;否则沿用旧的 、。
一个人被挡住、置信度掉下来的那几帧,他的记忆就先冻结,不让不可靠的输出写进去。
训练时,沿用 MOTR 一次输入一段视频片段的做法,并让片段逐步加长。在 DanceTrack 上训练 18 个 epoch,片段从 2 帧开始,在第 6、10、14 个 epoch 分别加长到 3、4、5 帧。
讨论
DanceTrack
作者主要在 DanceTrack 上评估,因为它的关联问题最难。
| 方法 | HOTA | DetA | AssA | IDF1 |
|---|---|---|---|---|
| ByteTrack | 47.7 | 71.0 | 32.1 | 53.9 |
| MOTR | 54.2 | 73.5 | 40.2 | 51.5 |
| OC-SORT | 55.1 | 80.3 | 38.3 | 54.6 |
| C-BIoU | 60.6 | 81.3 | 45.4 | 61.6 |
| MeMOTR(Deformable-DETR) | 63.4 | 77.0 | 52.3 | 65.5 |
| MeMOTR | 68.5 | 80.5 | 58.4 | 71.2 |
| MOTRv2(额外数据) | 69.9 | 83.0 | 59.0 | 71.7 |
整理自原论文 Table 1,DanceTrack 测试集。
MeMOTR 的 HOTA 比先前不用额外数据的最佳方法 C-BIoU 高 7.9 分,AssA 高 13.0 分。即使换回和 MOTR 一样的标准 Deformable-DETR,HOTA 也有 63.4,比 MOTR 高了 9 分以上。
用了额外数据、又借了 YOLOX 检测结果的 MOTRv2 仍然略高。但 MeMOTR 的 AssA 只差 0.6,差距主要在检测。
从 MOTR 一步步走到 MeMOTR
作者在附录把每一步的改动列成一张表,从 MOTR 开始累加:
| 步骤 | 验证集 HOTA | 测试集 HOTA |
|---|---|---|
| MOTR | 51.7 | 54.2 |
| +长期记忆与时间交互模块 | 56.5 | 62.5 |
| +检测解码器(1 层+5 层) | 61.0 | 63.4 |
| 改用 DAB-Deformable-DETR(不拆解码器) | 62.1 | 65.9 |
| +检测解码器(1 层+5 层) | 63.9 | 68.5 |
| +YOLOX 候选框 | 66.8 | 70.0 |
整理自原论文 Table 8,DanceTrack。除了第一行的 MOTR,其余都去掉了 MOTR 的两个训练技巧(随机删除轨迹查询、插入误报查询)。
最大的一步是第一步。只加上长期记忆和时间交互模块,测试集的 HOTA 就从 54.2 跳到 62.5,多了 8.3 分。换成 DAB-Deformable-DETR 也很有帮助;作者认为基于锚框的位置先验,很适合在时间上平滑移动的轨迹框。最后一行仿照 MOTRv2 加入 YOLOX 候选框,HOTA 到 70.0,但这样就不再是完全端到端的方法了。
每个部件的消融
消融都在 DanceTrack 的验证集上做,因为它的训练数据约是 MOT17 的 10 倍,比较不容易过拟合。
- 检测解码器用 1 层最好。 不拆是 62.1,拆出 1 层是 63.9,AssA 从 52.2 到 55.0;拆出 2 层反而降到 63.2,因为联合解码器少了一层,轨迹嵌入修正的次数也少了。
- 相邻两帧融合要两样一起用。 只加逐通道权重或只加上一帧的输出,HOTA 都只多 0.1 到 0.4;两者一起用才到 63.9,比都不用高 1.6。作者的解释是,只压低不可靠的通道、却没有上一帧补上信息,相当于只是把信息丢掉。
- 记忆注意力层需要长期记忆。 没有长期记忆时,加上记忆注意力层反而变差,AssA 从 52.1 掉到 50.7。有了长期记忆,加上注意力层则让 AssA 从 52.9 升到 55.0。作者认为,没有记忆的轨迹嵌入本身就不稳定,让它们互相比较只会放大噪声。
- 最好。 0.005、0.02、0.04 的 HOTA 分别是 62.6、63.2、63.5。作者也提醒, 可能要根据数据集调整,例如物体形变很大的场景,可能需要更新得快一点。
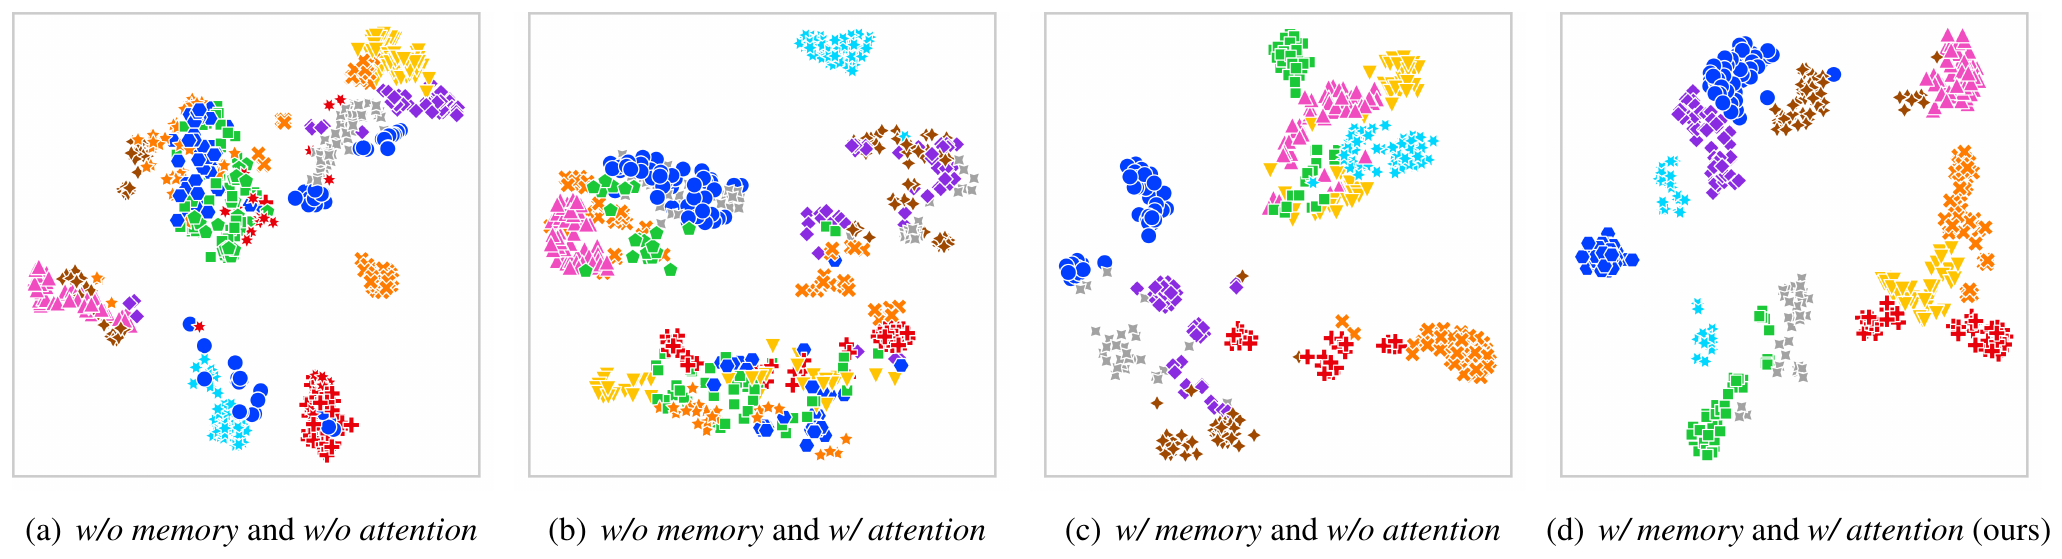
这张图把第 3 点画了出来。(b) 只加注意力时,不同轨迹的点混得比 (a) 还乱;(d) 记忆和注意力都有时,每条轨迹在 50 帧内的嵌入聚成一团,彼此分得最开。
最难的那几段
作者挑出 MOTR 在 DanceTrack 验证集上 AssA 最低的 8 段视频,单独比较。MOTR 在这 8 段的平均 AssA 只有 23.6,MeMOTR 提升到 35.5。
进步很明显,但和 MeMOTR 整体的 58.4 相比还差得远。作者也承认,关联问题远没有解决。
MOT17 与其他数据集
在 MOT17 上,MeMOTR 的 HOTA 是 58.8,在 Transformer 类方法中最高,AssA 58.4、IDF1 71.5 都比先前的 MeMOT 好;但检测的 DetA 只有 59.6,远低于用 YOLOX 的 ByteTrack(64.5),HOTA 也落后于 ByteTrack 的 63.1。
作者给了两个原因。一是 MOT17 的行人又小又密,DETR 类的检测本来就吃力,检测查询在自注意力中还会被轨迹查询压制。二是 MOT17 的训练集只有大约 5,000 帧,即使加上 CrowdHuman 做成的伪视频,模型在训练集上 HOTA 约 90,测试集只有 58.8,过拟合非常严重。
在多类别的 BDD100K 验证集上,以 TETA 指标衡量,MeMOTR 是 53.6,高于 TETer 的 50.8 和 MOTR 的 50.7。
v3 版本另外补上了 SportsMOT 的结果。只用 SportsMOT 的训练集,MeMOTR 的 HOTA 是 70.0、AssA 59.1,高于同样只用训练集、用官方代码重跑的 OC-SORT(68.1)。作者刻意不用额外数据,理由是 SportsMOT 的训练集已经有 2 万 5 千多帧,而把静态图片平移成假视频,偏离了真实的跟踪场景,对直接从数据学习的端到端方法并不好。
结论
MeMOTR 给每一条轨迹加上一份更新得很慢的长期记忆,再用时间交互模块把它注入下一帧的轨迹嵌入,同时拆出一层检测解码器,让检测查询和轨迹查询站在同一个起点上。附录的累加表显示,最大的一步就是长期记忆本身,让 MOTR 在 DanceTrack 测试集上一口气多了 8 分以上。
它的弱点也和 MOTR 一脉相承。检测仍是短板,拥挤的 MOT17 上输给了用 YOLOX 的方法,小数据集上也容易过拟合。作者建议之后可以试试合成数据。
这个团队的下一步,是在 2024 年的 MOTIP 里,把身份关联改写成一个分类问题。
一份每帧只改 1% 的记忆,听起来很迟钝,但要在一群穿着一样衣服的舞者之间认出谁是谁,靠的正是这份迟钝。