原始論文
MeMOTR: Long-Term Memory-Augmented Transformer for Multi-Object Tracking
- 發表版本
- ICCV 2023會議
- arXiv 首次提交
- arXiv:2307.15700
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{multiobjecttrackingmemotr2023,
  title = {{MeMOTR: Long-Term Memory-Augmented Transformer for Multi-Object Tracking}},
  author = {Ruopeng Gao and Limin Wang},
  year = {2023},
  eprint = {2307.15700},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2307.15700}
}
MOTR 用一個軌跡查詢代表一條軌跡,這個查詢在每一幀經過解碼器、更新,再傳給下一幀。物體的身分,就靠這一連串的傳遞維持下去。
問題是,每一幀的查詢只看得到上一幀。舞者被擋住幾幀、轉個身、和穿一樣衣服的人擦身而過,這一幀的輸出就可能變得不可靠,而下一幀的查詢就是從這個不可靠的輸出來的。
南京大學的 Ruopeng Gao 和王利民(也是 SportsMOT 的通訊作者)想讓軌跡查詢多記住一點過去。他們替每一條軌跡加上一份長期記憶,更新得很慢,用來穩住軌跡查詢。這就是 MeMOTR。
定義問題
作者指出 MOTR 這類以查詢追蹤的方法有兩個問題。
只用到相鄰兩幀。 不管是融合查詢還是融合特徵,大多數方法只明確利用了相鄰兩幀的資訊。軌跡查詢雖然一直在更新,卻沒有一個穩定的長期表示。同一個人的查詢在幾幀之間變化太大,就容易在關聯時出錯。先前的 MeMOT 用一個很大的記憶庫存下過去的特徵,但儲存成本很高。
偵測查詢和軌跡查詢不在同一個層次。 DETR 的可學習物件查詢,作用比較像一個可學習的錨框,本身沒什麼語意。軌跡查詢則是從上一幀的輸出來的,已經知道自己代表什麼類別、在哪個位置。把這兩種查詢從頭一起丟進同一個解碼器,兩者之間有一段語意上的落差。
解決問題
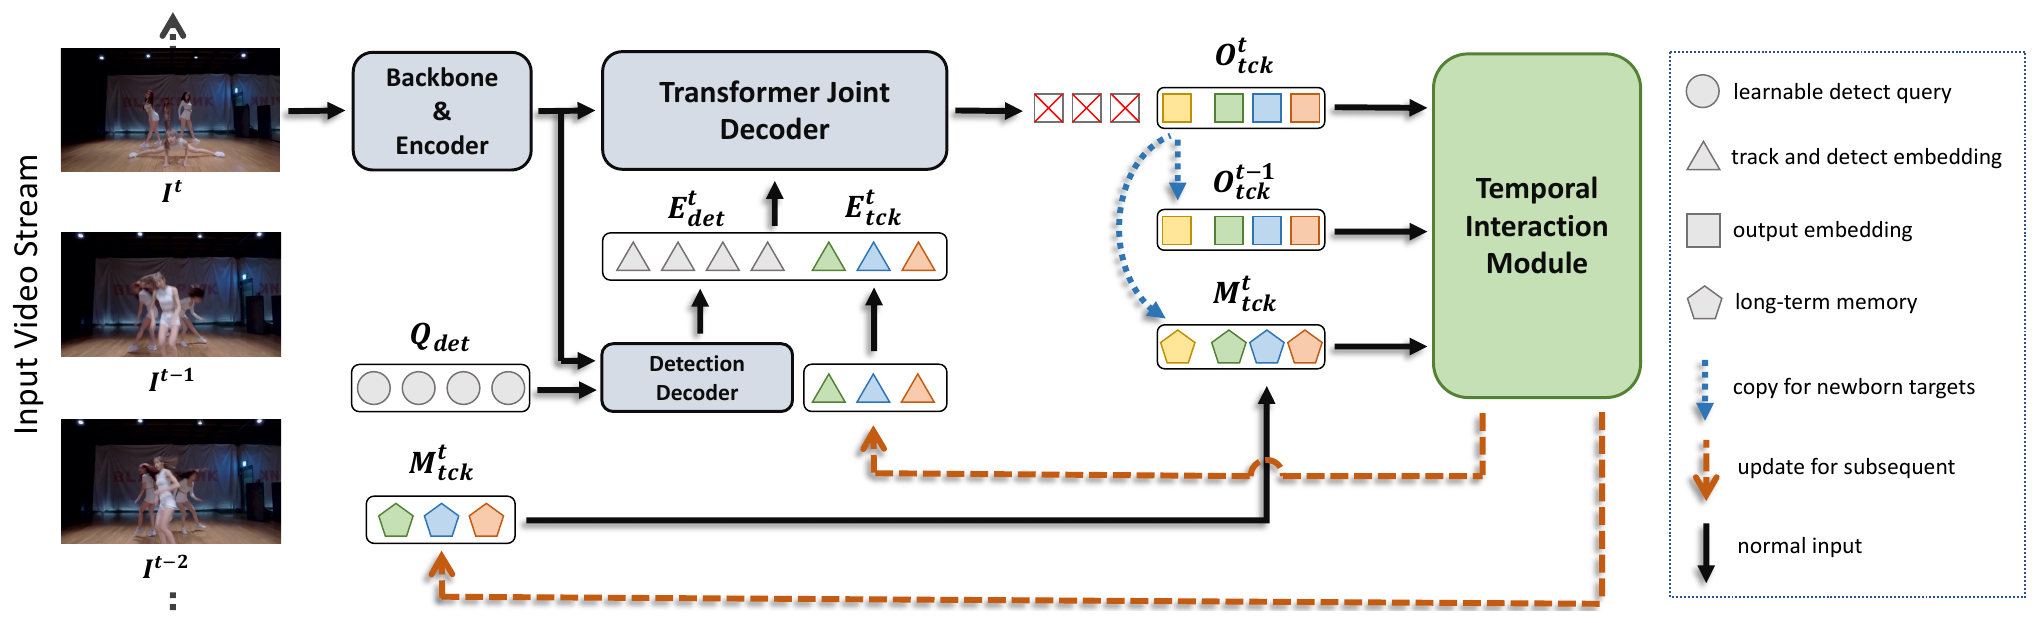
整體架構和 MOTR 很像,ResNet-50 骨幹加上 Transformer 編碼器抽取影像特徵,解碼器同時處理偵測和追蹤。不同的地方有三個:解碼器拆成兩段、每條軌跡多一份長期記憶,以及一個產生下一幀軌跡嵌入的時間互動模組。偵測框架用的是 DAB-Deformable-DETR,作者也提供了標準 Deformable-DETR 的版本,方便和 MOTR 公平比較。
先讓偵測查詢有點概念
原本的解碼器有 6 層。MeMOTR 把第 1 層拿出來,當作偵測解碼器,只處理偵測查詢。偵測查詢經過這一層,大致找到物體的位置和類別,變成帶有語意的偵測嵌入 。
接著把偵測嵌入和軌跡嵌入 串在一起,送進剩下 5 層組成的聯合解碼器。這時兩種查詢都已經「知道自己在找什麼」,起點比較一致。
長期記憶
每一條新出現的軌跡,用它當下的輸出初始化一份長期記憶 。之後每一幀這樣更新:
是這條軌跡在第 幀的解碼器輸出。這是一個指數加權的移動平均,。
0.01 是一個很小的數字。作者的假設是,物體在連續幾幀之間只有輕微的變形和移動,語意特徵應該變化得很慢,記憶也應該平穩地更新。
我們算一下它記得多久。某一幀的輸出放進記憶時權重是 ,之後每過一幀就乘上 0.99。,所以大約 69 幀之後,這一幀的影響就剩一半。DanceTrack 的影片是每秒 20 幀,也就是 3 秒半左右。整體來說,這份記憶大約是最近 100 幀、5 秒的平均。
一個舞者轉身、被擋住兩三秒,這份記憶幾乎不會被那幾幀的雜訊帶偏。
時間互動模組
長期記憶要怎麼用到下一幀的追蹤上?靠的是時間互動模組。
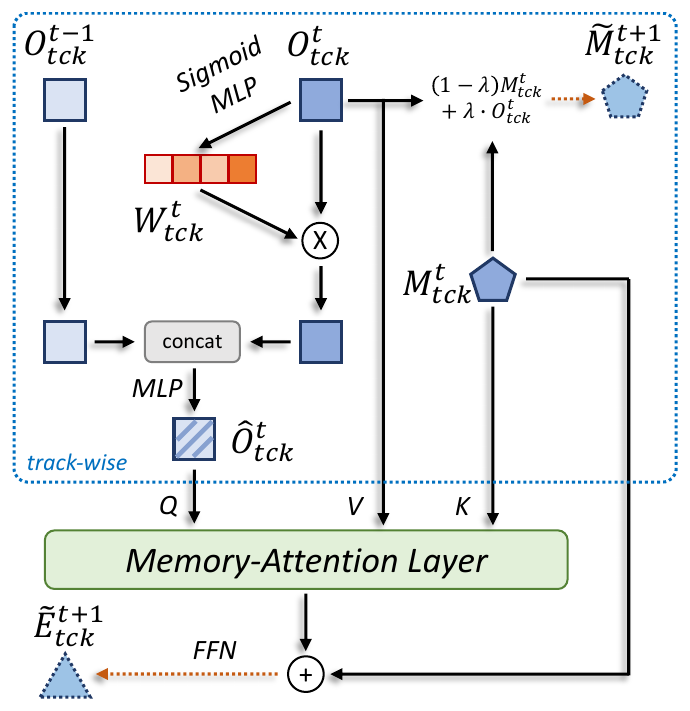
它分成兩步。
第一步,融合相鄰兩幀。 這一幀的輸出可能因為遮擋或模糊而不可靠,所以先用一個小網路替它產生逐通道的權重:
把權重乘上這一幀的輸出,再和上一幀的輸出 串接,經過兩層 MLP,得到融合後的 。上一幀的輸出不用乘權重,因為它能留下來,代表信心分數已經過了門檻,相對可靠。
第二步,讓軌跡之間互相比較。 同一幀裡有好幾個長得很像的人,作者希望每條軌跡的表示能和別人分得更開。所以用一個多頭注意力,稱為記憶注意力層,讓所有軌跡互動:查詢(Q)是融合後的 ,鍵(K)是長期記憶 ,值(V)是這一幀的輸出 。
注意力的輸出再加上長期記憶,經過一個前饋網路,就是下一幀的軌跡嵌入 。因為加進了變化緩慢的長期記憶,軌跡嵌入也不容易在相鄰兩幀之間突然改變。
什麼時候更新
推論時有三個門檻,都設成 0.5:
- 偵測的信心超過 ,就成為新軌跡。
- 已追蹤的物體信心低於 ,不直接刪掉,而是標成暫時遺失;連續 幀都找不回來才刪除。DanceTrack 上 是 30 幀,MOT17 是 15 幀。
- 只有信心 超過 ,才用時間互動模組的輸出 、 更新軌跡嵌入和長期記憶;否則沿用舊的 、。
一個人被擋住、信心掉下來的那幾幀,他的記憶就先凍結,不讓不可靠的輸出寫進去。
訓練時,沿用 MOTR 一次輸入一段影片片段的作法,並讓片段逐步加長。在 DanceTrack 上訓練 18 個 epoch,片段從 2 幀開始,在第 6、10、14 個 epoch 分別加長到 3、4、5 幀。
討論
DanceTrack
作者主要在 DanceTrack 上評估,因為它的關聯問題最難。
| 方法 | HOTA | DetA | AssA | IDF1 |
|---|---|---|---|---|
| ByteTrack | 47.7 | 71.0 | 32.1 | 53.9 |
| MOTR | 54.2 | 73.5 | 40.2 | 51.5 |
| OC-SORT | 55.1 | 80.3 | 38.3 | 54.6 |
| C-BIoU | 60.6 | 81.3 | 45.4 | 61.6 |
| MeMOTR(Deformable-DETR) | 63.4 | 77.0 | 52.3 | 65.5 |
| MeMOTR | 68.5 | 80.5 | 58.4 | 71.2 |
| MOTRv2(額外資料) | 69.9 | 83.0 | 59.0 | 71.7 |
整理自原論文 Table 1,DanceTrack 測試集。
MeMOTR 的 HOTA 比先前不用額外資料的最佳方法 C-BIoU 高 7.9 分,AssA 高 13.0 分。即使換回和 MOTR 一樣的標準 Deformable-DETR,HOTA 也有 63.4,比 MOTR 高了 9 分以上。
用了額外資料、又借了 YOLOX 偵測結果的 MOTRv2 仍然略高。但 MeMOTR 的 AssA 只差 0.6,差距主要在偵測。
從 MOTR 一步步走到 MeMOTR
作者在附錄把每一步的改動列成一張表,從 MOTR 開始累加:
| 步驟 | 驗證集 HOTA | 測試集 HOTA |
|---|---|---|
| MOTR | 51.7 | 54.2 |
| +長期記憶與時間互動模組 | 56.5 | 62.5 |
| +偵測解碼器(1 層+5 層) | 61.0 | 63.4 |
| 改用 DAB-Deformable-DETR(不拆解碼器) | 62.1 | 65.9 |
| +偵測解碼器(1 層+5 層) | 63.9 | 68.5 |
| +YOLOX 候選框 | 66.8 | 70.0 |
整理自原論文 Table 8,DanceTrack。除了第一列的 MOTR,其餘都拿掉了 MOTR 的兩個訓練技巧(隨機刪除軌跡查詢、插入誤報查詢)。
最大的一步是第一步。只加上長期記憶和時間互動模組,測試集的 HOTA 就從 54.2 跳到 62.5,多了 8.3 分。換成 DAB-Deformable-DETR 也很有幫助;作者認為以錨框為基礎的位置先驗,很適合在時間上平滑移動的軌跡框。最後一列仿照 MOTRv2 加入 YOLOX 候選框,HOTA 到 70.0,但這樣就不再是完全端到端的方法了。
每個零件的消融
消融都在 DanceTrack 的驗證集上做,因為它的訓練資料約是 MOT17 的 10 倍,比較不會過擬合。
- 偵測解碼器用 1 層最好。 不拆是 62.1,拆出 1 層是 63.9,AssA 從 52.2 到 55.0;拆出 2 層反而降到 63.2,因為聯合解碼器少了一層,軌跡嵌入修正的次數也少了。
- 相鄰兩幀融合要兩樣一起用。 只加逐通道權重或只加上一幀的輸出,HOTA 都只多 0.1 到 0.4;兩者一起用才到 63.9,比都不用高 1.6。作者的解釋是,只壓低不可靠的通道、卻沒有上一幀補上資訊,等於只是把資訊丟掉。
- 記憶注意力層需要長期記憶。 沒有長期記憶時,加上記憶注意力層反而變差,AssA 從 52.1 掉到 50.7。有了長期記憶,加上注意力層則讓 AssA 從 52.9 升到 55.0。作者認為,沒有記憶的軌跡嵌入本身就不穩定,讓它們互相比較只是放大雜訊。
- 最好。 0.005、0.02、0.04 的 HOTA 分別是 62.6、63.2、63.5。作者也提醒, 可能要依資料集調整,例如物體形變很大的場景,可能需要更新得快一點。
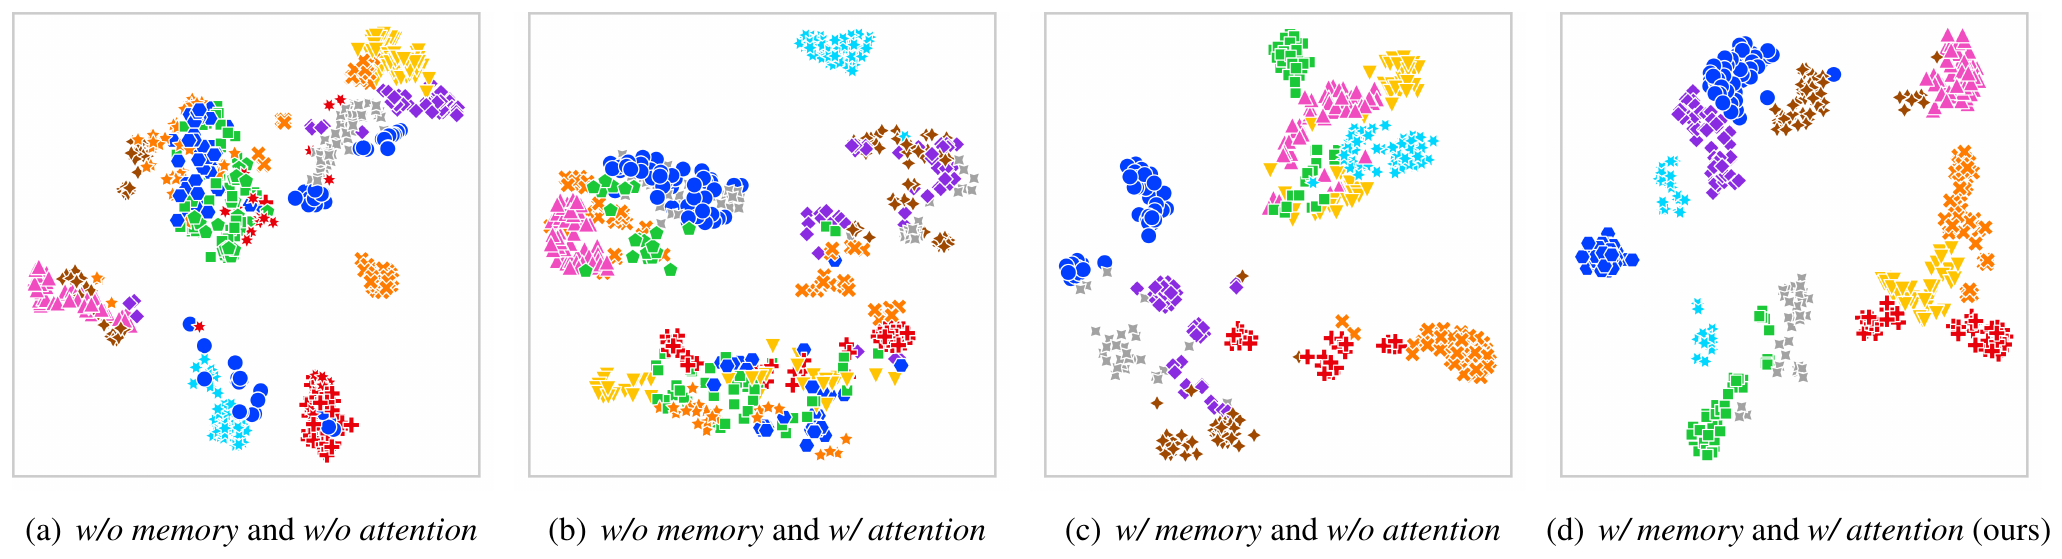
這張圖把第 3 點畫了出來。(b) 只加注意力時,不同軌跡的點混得比 (a) 還亂;(d) 記憶和注意力都有時,每條軌跡在 50 幀內的嵌入聚成一團,彼此分得最開。
最難的那幾段
作者挑出 MOTR 在 DanceTrack 驗證集上 AssA 最低的 8 段影片,單獨比較。MOTR 在這 8 段的平均 AssA 只有 23.6,MeMOTR 提升到 35.5。
進步很明顯,但和 MeMOTR 整體的 58.4 相比還差得遠。作者也承認,關聯問題遠沒有解決。
MOT17 與其他資料集
在 MOT17 上,MeMOTR 的 HOTA 是 58.8,在 Transformer 類方法中最高,AssA 58.4、IDF1 71.5 都比先前的 MeMOT 好;但偵測的 DetA 只有 59.6,遠低於用 YOLOX 的 ByteTrack(64.5),HOTA 也落後 ByteTrack 的 63.1。
作者給了兩個原因。一是 MOT17 的行人又小又密,DETR 類的偵測本來就吃力,偵測查詢在自注意力中還會被軌跡查詢壓制。二是 MOT17 的訓練集只有大約 5,000 幀,即使加上 CrowdHuman 做成的偽影片,模型在訓練集上 HOTA 約 90,測試集只有 58.8,過擬合非常嚴重。
在多類別的 BDD100K 驗證集上,以 TETA 指標衡量,MeMOTR 是 53.6,高於 TETer 的 50.8 和 MOTR 的 50.7。
v3 版本另外補上了 SportsMOT 的結果。只用 SportsMOT 的訓練集,MeMOTR 的 HOTA 是 70.0、AssA 59.1,高於同樣只用訓練集、以官方程式重跑的 OC-SORT(68.1)。作者刻意不用額外資料,理由是 SportsMOT 的訓練集已經有 2 萬 5 千多幀,而把靜態圖片平移成假影片,偏離了真實的追蹤情境,對直接從資料學習的端到端方法並不好。
結論
MeMOTR 替每一條軌跡加上一份更新得很慢的長期記憶,再用時間互動模組把它注入下一幀的軌跡嵌入,同時拆出一層偵測解碼器,讓偵測查詢和軌跡查詢在同一個起點上。附錄的累加表顯示,最大的一步就是長期記憶本身,讓 MOTR 在 DanceTrack 測試集上一口氣多了 8 分以上。
它的弱點也和 MOTR 一脈相承。偵測仍是短處,擁擠的 MOT17 上輸給了用 YOLOX 的方法,小資料集上也容易過擬合。作者建議之後可以試試合成資料。
這個團隊的下一步,是在 2024 年的 MOTIP 裡,把身分關聯改寫成一個分類問題。
一份每幀只改 1% 的記憶,聽起來很遲鈍,但要在一群穿著一樣衣服的舞者之間認出誰是誰,靠的正是這份遲鈍。