原始論文
Learnable Graph Matching: Incorporating Graph Partitioning with Deep Feature Learning for Multiple Object Tracking
- 發表版本
- CVPR 2021會議
- arXiv 首次提交
- arXiv:2103.16178
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{multiobjecttrackinggmtracker2021,
  title = {{Learnable Graph Matching: Incorporating Graph Partitioning with Deep Feature Learning for Multiple Object Tracking}},
  author = {Jiawei He and Zehao Huang and Naiyan Wang and Zhaoxiang Zhang},
  year = {2021},
  eprint = {2103.16178},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2103.16178}
}
從 SORT 到 DeepSORT,大部分的線上追蹤器都是把上一幀的軌跡和這一幀的偵測排成一張二部圖,算出每一對的相似度,交給匈牙利演算法配對。
這張二部圖只有一種邊,就是「軌跡 和偵測 有多像」。同一幀裡的兩個偵測彼此是什麼關係、兩條軌跡原本誰在誰的左邊,全都不在考慮之內。
中國科學院自動化所的 Jiawei He、Zhaoxiang Zhang 和圖森(TuSimple)的 Zehao Huang、Naiyan Wang 認為,這些關係才是遮擋時最可靠的線索。行人常常結伴走,一個人被擋住、外觀看不清楚的時候,我們還是可以從「他原本走在誰旁邊」把他認回來。
定義問題
作者整理了當時資料關聯的三個問題:
- 忽略了同一幀之內的脈絡。 不管是兩幀之間的二部匹配,還是跨多幀的最小成本流,都只在乎「跨幀」的配對,沒有把同一幀裡物體彼此的關係用上。
- 端到端的方法只靠網路去擬合。 有些方法直接讓網路輸出配對結果,卻沒有用到組合最佳化這幾十年累積的工具。
- 最佳化方法的特徵是另外訓練的。 用圖最佳化做關聯的方法,特徵通常來自一個獨立訓練的網路,訓練時的目標和推論時的配對方式並不一致。
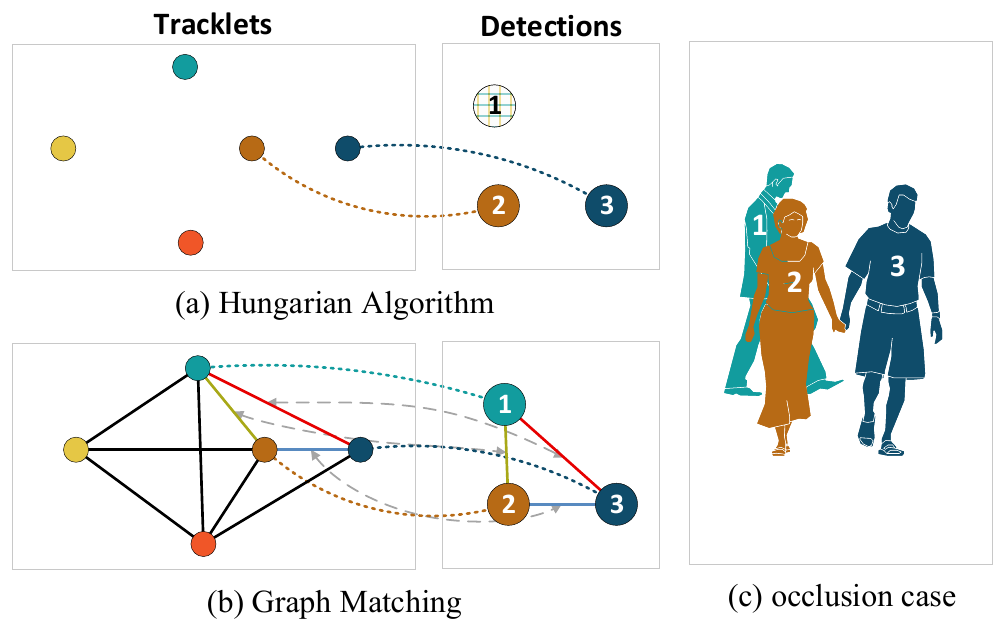
看右邊的 (c)。1 號被 2 號擋住了一大半,外觀特徵抽出來多半不可靠。(a) 的匈牙利演算法只看「這個偵測長得像哪條軌跡」,1 號就配不上了。(b) 還多看偵測 1、2、3 之間的相對位置,它和軌跡之間的相對位置對得上,於是 1 號被認了回來。
作者把這種「邊對邊」的關係稱為二階的相似度。要把它用進關聯,配對問題就不再是二部匹配,而是一般的圖匹配。
解決問題
從二部匹配到圖匹配
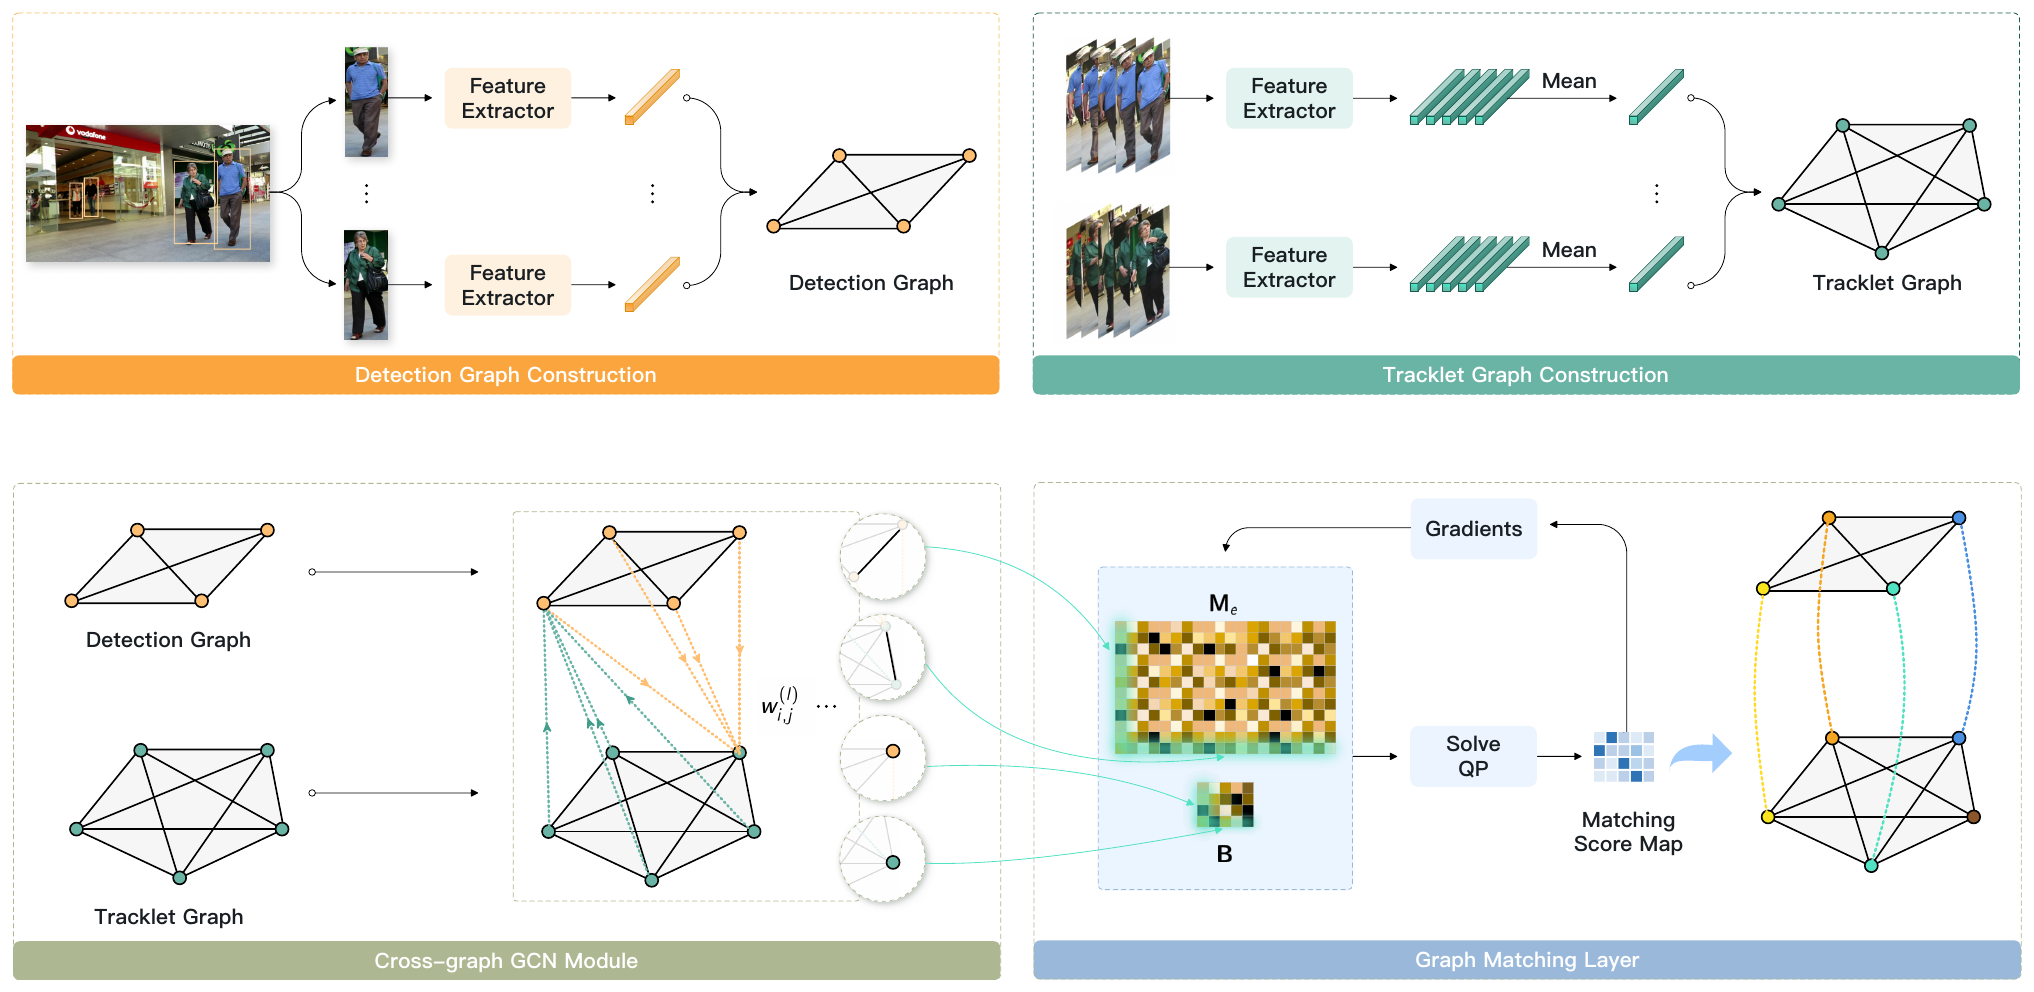
每一幀,作者建兩張圖。偵測圖 的頂點是這一幀的偵測,軌跡圖 的頂點是目前的軌跡,兩張都是完全圖,任兩個頂點之間都有邊。
圖匹配要找一個配對 ,讓配上的頂點彼此相似,配上的邊也彼此相似。寫成數學,是一個二次指派問題:
、 是兩張圖的邊權重, 是頂點之間的相似度。第一項要求配上的邊權重相近,第二項要求配上的頂點相似。
只看第二項,就是一般的匈牙利演算法。第一項是新加的部分。
一個雙胞胎的例子
我們用一個極端的例子,看看第一項有什麼用。
兩條軌跡 、, 一直走在 的左邊。這一幀出現兩個偵測 、,但兩個人是雙胞胎,穿得一模一樣,外觀相似度全部是 0.5。
只看頂點,兩種配法的分數一樣:
| 配法 | 頂點分數 |
|---|---|
| –、– | 0.5 + 0.5 = 1.0 |
| –、– | 0.5 + 0.5 = 1.0 |
匈牙利演算法只能隨便挑一個。
現在加上邊。GMTracker 的邊特徵,是把兩端頂點的特徵串接起來,所以邊有方向, 和 是不同的邊。假設偵測 在 的左邊,邊 和 的相似度是 0.9,和 只有 0.2;反方向同理。
| 配法 | 頂點分數 | 邊分數 | 合計 |
|---|---|---|---|
| –、– | 1.0 | 0.9 + 0.9 | 2.8 |
| –、– | 1.0 | 0.2 + 0.2 | 1.4 |
本文整理的算例。
光看長相分不出來的兩個人,看他們和身邊的人站在哪裡,就分得出來。
鬆弛成可以微分的二次規劃
問題是,二次指派問題是 NP-hard,沒有匈牙利演算法那樣的多項式解法,更沒辦法放進神經網路裡反向傳播。
作者做了兩步:
- 鬆弛。 把只能是 0 或 1 的置換矩陣,放寬成每列、每欄加起來為 1 的「雙隨機矩陣」。這是置換矩陣最緊的凸鬆弛,問題於是變成一個凸的二次規劃。
- 把邊權重換成邊特徵。 原本每條邊只有一個權重,現在每條邊是一個向量。邊和邊之間的相似度,用兩個邊特徵的餘弦相似度表示,組成一個邊對邊的相似度矩陣 ,再展開成二次項的矩陣 。
最後要解的是:
是把配對矩陣拉直後的向量, 是頂點相似度。限制條件是每個偵測的配對分數加起來等於 1,每條軌跡加起來不超過 1,因為有些軌跡在這一幀消失了。
一個二次規劃的最佳解,可以用 KKT 條件和隱函數定理,對輸入求出梯度。作者參考 OptNet 的作法,把整個圖匹配做成一層可微分的網路。訓練時讓梯度穿過這一層,回傳到特徵上;推論時只需要前向求解。
這解決了前面的第三個問題。特徵是為了讓圖匹配配得對而訓練的,訓練和推論用的是同一套配對方式。
跨圖的圖卷積
頂點的特徵來自一個預訓練的 ReID 網路,後面接兩層可訓練的全連接層。軌跡的特徵,是它所有偵測特徵的平均。
在送進圖匹配之前,作者先用一層跨圖的圖卷積加強特徵。偵測圖上的每個頂點,從軌跡圖的所有頂點收集訊息,權重是外觀和位置的相似度:
軌跡的框 由等速卡爾曼濾波預測。鏡頭在動的影片,預測的位置不可靠,就只用外觀相似度。
收集到的訊息 ,經過正規化後加回原本的特徵,再過一個 MLP:
軌跡圖的頂點也用同樣的方式更新。和 MPNTrack 一樣,訊息只在兩張圖之間傳遞,同一張圖內部不傳。最後,每條邊的特徵是兩端頂點特徵串接後做 l2 正規化。
訓練與推論
訓練用加權的二元交叉熵,正樣本的權重是 ,平衡一個偵測只有一條正確軌跡、卻有很多條錯誤軌跡的不平衡。二次規劃的解比較平滑,計算損失前先用溫度很低()的 softmax 把分數拉開。
推論時,鬆弛後的解不一定是 0 或 1,作者用貪婪的方式取整,每個偵測配給分數最高的軌跡。軌跡的建立和刪除則沿用 DeepSORT:外觀太不像、離所有軌跡太遠(卡爾曼濾波的馬氏距離超過門檻)、或和所有軌跡都不重疊的偵測,先不參與配對;這些偵測之後再用 IoU 和匈牙利演算法,和沒配上的軌跡補配一次。另外加上 ECC 做相機運動補償。軌跡 100 幀沒更新才刪除。
討論
每個零件的貢獻
消融在 MOT17 訓練集上做三折交叉驗證,以 DeepSORT 的匈牙利配對為基準:
| 設定 | IDF1 | MOTA | ID 切換 |
|---|---|---|---|
| DeepSORT 基準 | 68.1 | 62.1 | 1,135 |
| +圖匹配 | 70.0 | 62.3 | 1,128 |
| 完整 GMTracker | 71.5 | 62.3 | 1,017 |
| 完美關聯 | 77.2 | 62.6 | 14 |
整理自原論文 Table 1 與附錄 Table A,MOT17 驗證集,不含插值。
- 圖匹配本身貢獻最多。 只把匈牙利演算法換成圖匹配,IDF1 就多了 1.9。訓練過的外觀特徵和圖卷積再加約 0.6,加入位置資訊再加約 1.0。
- MOTA 幾乎不動。 從 62.1 到 62.3,因為 GMTracker 處理的是關聯,偵測沒有變。這也是作者以 IDF1 為主要指標的原因。
- 離完美還有距離。 附錄裡,作者用真值做完美關聯,IDF1 是 77.2。GMTracker 補上了基準和完美之間大約三分之一的差距。
圖匹配層一定要一起訓練才有用。訓練和推論都不用它,IDF1 是 69.5;只在推論時加上它,是 70.2;訓練和推論都用,才到 71.5。
能追多久
| 軌跡保留幀數 | 30 | 50 | 80 | 100 | 150 |
|---|---|---|---|---|---|
| 匈牙利演算法 | 67.2 | 67.9 | 68.1 | 68.1 | 67.3 |
| 圖匹配 | 68.0 | 69.3 | 69.7 | 70.0 | 70.0 |
整理自原論文 Table 4,MOT17 驗證集,IDF1。
保留越久,候選的軌跡就越多,匈牙利演算法在 150 幀時反而掉了 0.8,因為候選一多就容易配錯。圖匹配則一路持平或上升,作者據此認為,GMTracker 可以把消失了大約 5 秒的軌跡配回來。
候選多的時候,光比外觀容易認錯人;把相對關係也放進來,錯誤的組合就比較難湊得起來。
和其他方法比
在 MOT17 測試集上,用 Tracktor 精修過的公用偵測,線上的 GMTracker 的 IDF1 是 63.8、MOTA 56.2,高於當時其他線上方法;換成 CenterTrack 的偵測,IDF1 是 66.9。加上線性插值和離線方法比,IDF1 65.9,高於 MPNTrack 的 61.7 和 LifT 的 65.6;用 CenterTrack 偵測再加插值,IDF1 68.7、MOTA 65.0。
這裡的比較要注意偵測的條件。MOTA 主要受偵測影響,所以同樣是 GMTracker,換一組偵測,MOTA 就從 56.2 跳到 61.5。
代價
這篇論文沒有報告速度。二次規劃的變數個數是偵測數乘以軌跡數,邊對邊的相似度矩陣又比它大上許多;作者推論時改用 CVXPY 只做前向求解。擁擠的場景裡每一幀都要解一次二次規劃,計算成本是使用前要先評估的地方。
後來的期刊擴充版把同一套可學習的圖匹配,用到影像特徵點匹配和點雲對位,標題也改成「資料關聯的實用範式」。
結論
GMTracker 把線上追蹤的配對,從只看頂點的二部匹配,換成同時看頂點和邊的圖匹配。一個人被擋住、外觀不可靠的時候,他和周圍其他人的相對關係,還能把他認回來。為了讓這件事能放進神經網路,作者把二次指派問題鬆弛成凸的二次規劃,再用 KKT 條件求梯度,讓特徵為了配對而學。
這篇和 MPNTrack 都把物體之間的關係當成關聯的線索,不只是兩兩比對。MPNTrack 讓圖網路直接預測哪些邊該連,GMTracker 則保留了最佳化求解,只讓網路學特徵。
同樣出自 MPNTrack 團隊的 SUSHI,後來把圖網路的做法推到了長時間的追蹤。