原始论文
BoT-SORT: Robust Associations Multi-Pedestrian Tracking
- 发表版本
- 正式发表信息尚未核实
- arXiv 首次提交
- arXiv:2206.14651
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multiobjecttrackingbotsort2022,
  title = {{BoT-SORT: Robust Associations Multi-Pedestrian Tracking}},
  author = {Nir Aharon and Roy Orfaig and Ben-Zion Bobrovsky},
  year = {2022},
  eprint = {2206.14651},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2206.14651}
}
ByteTrack 证明了,检测器够强的时候,卡尔曼滤波加 IoU 就能在 MOT17 上拿到 80.3 的 MOTA。
但「IoU 够用」的前提是,上一帧预测的框要和这一帧的检测框对得上。只要拍摄的人转个身、车子转个弯,画面里所有的东西都会一起移动,卡尔曼滤波预测的框就全部落在错的位置。行人自己根本没动,跟踪器却跟丢了一整群人。
以色列特拉维夫大学的 Nir Aharon、Roy Orfaig 和 Ben-Zion Bobrovsky 整理了 SORT 这一类跟踪器的几个老毛病,把对应的改进一个一个装到 ByteTrack 上。名字里的 BoT 是 bag of tricks,一整袋小技巧的意思。
定义问题
作者指出 SORT 类跟踪器的三个局限。
卡尔曼滤波的状态向量。 SORT 用 :中心、面积、宽高比;DeepSORT 之后的多数跟踪器,包括 ByteTrack,改用 :中心、宽高比、高度。这两种表示都是在估计宽高比,宽度得从宽高比搭配面积或高度推回来。作者发现,这样推出来的宽度常常不准,框对不上人。
相机的移动。 IoU 匹配完全依赖预测框的位置。相机一动,预测框和检测框的重叠就变小,造成 ID 切换或漏检。就算是固定相机,风吹或震动也会让画面晃动,在拥挤场景里一样会出问题。
IoU 和外观的取舍。 用 IoU 匹配,MOTA 通常比较好;用 re-ID 特征匹配,IDF1 通常比较好。两种线索怎么结合,才不会顾此失彼?
解决问题
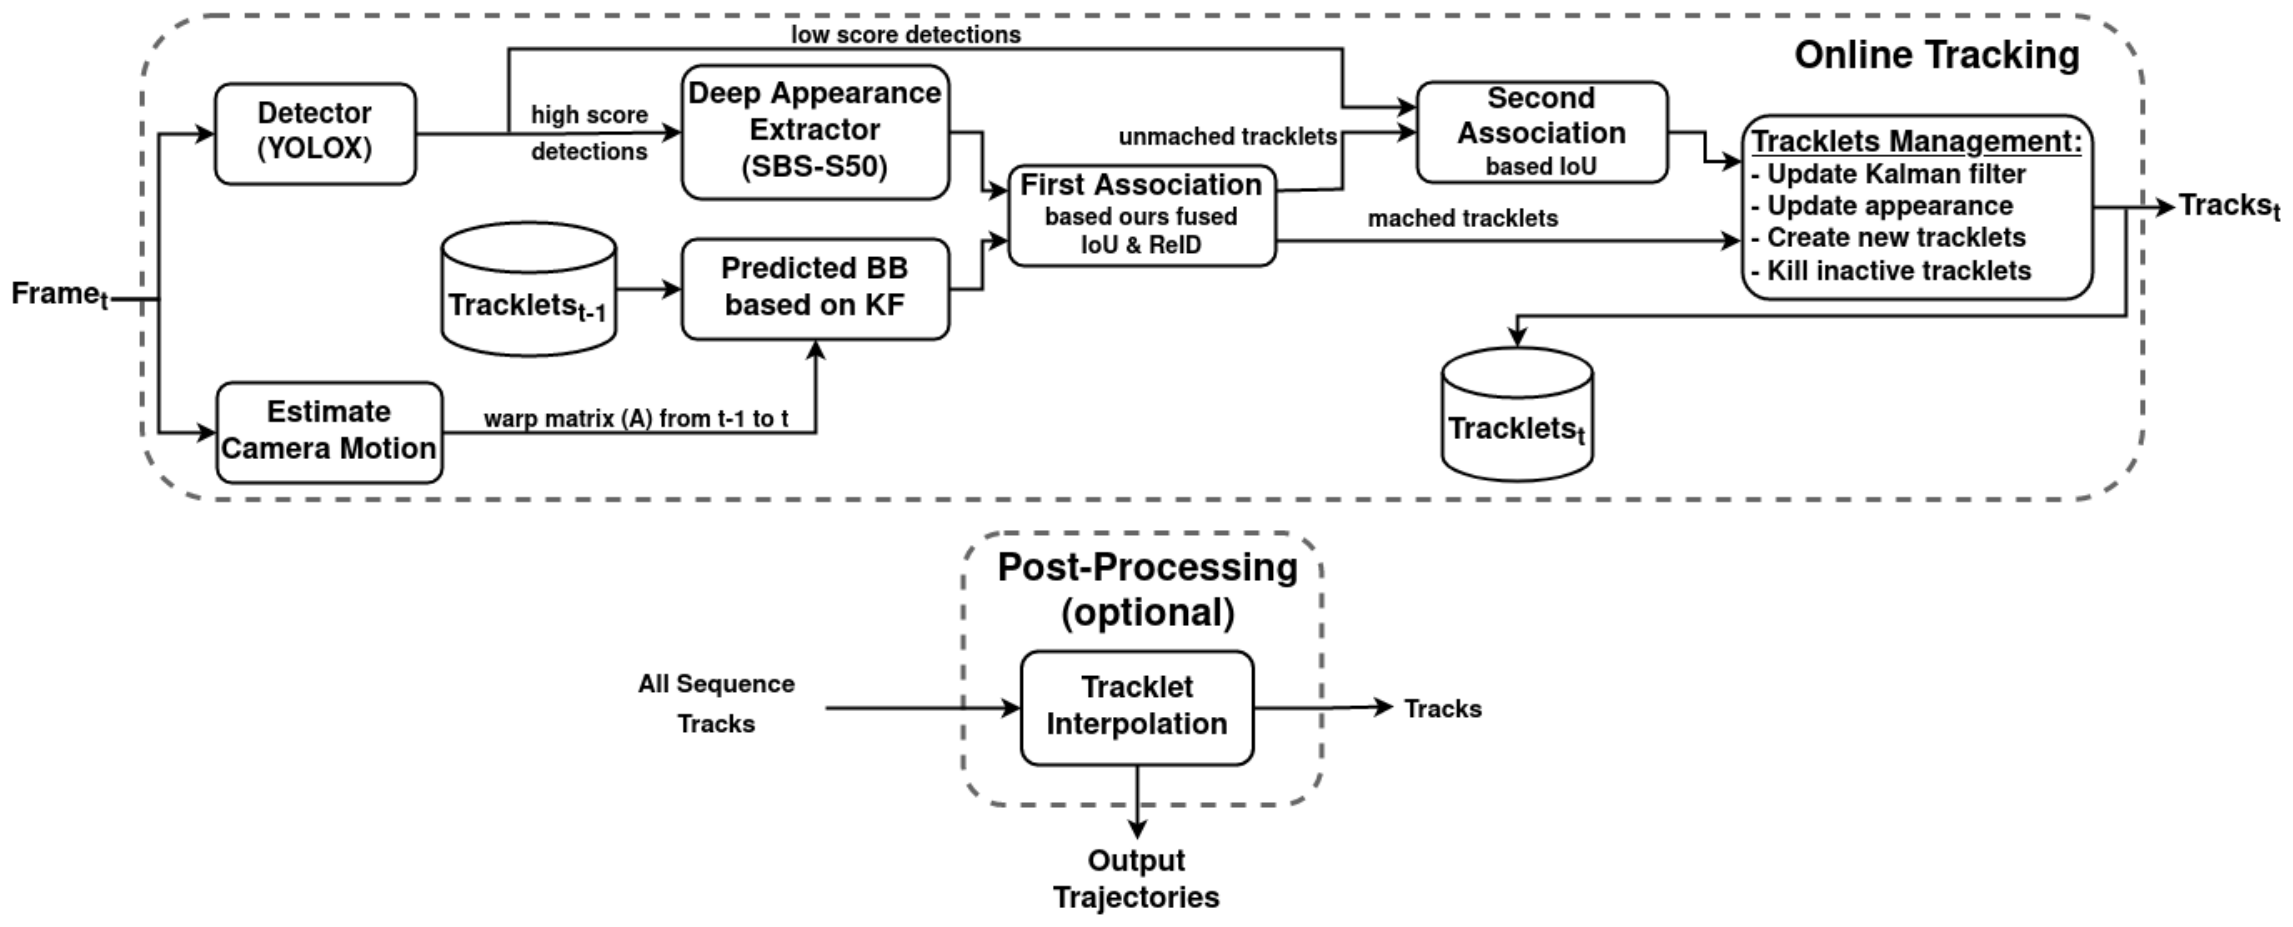
整体骨架就是 ByteTrack,高分框和所有轨迹做第一次关联,低分框和剩下的轨迹用 IoU 做第二次关联。BoT-SORT 在这个骨架上改了三个地方,加上 re-ID 的版本叫 BoT-SORT-ReID。
一、直接估计宽和高
作者把卡尔曼滤波的状态向量改成直接包含宽和高:
噪声矩阵沿用 DeepSORT 的思路,让噪声随框的大小缩放,但改成分别跟着宽和高走:
、、,分别就是 DeepSORT 代码里的 1/20 和 1/160。
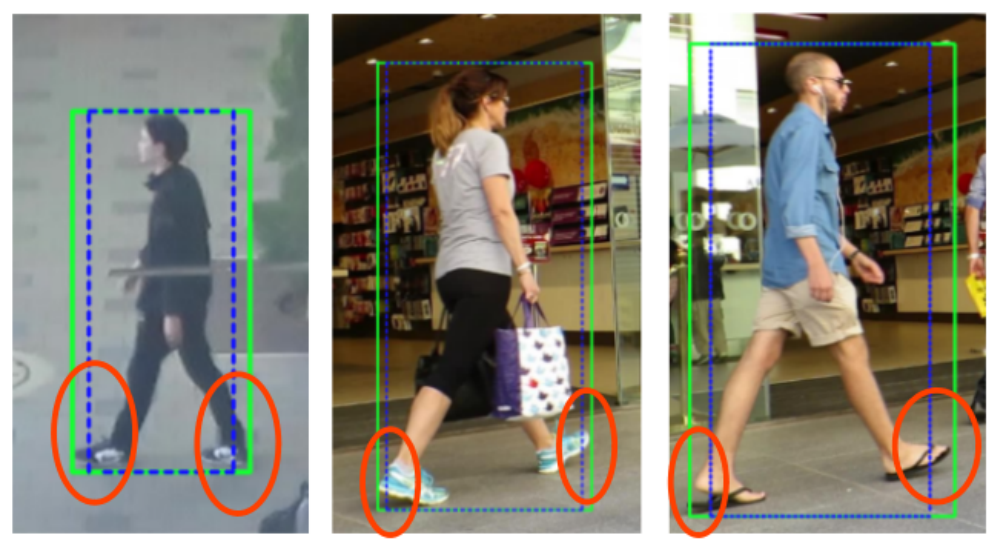
这张图里,蓝色虚线框把行人的脚切掉了,绿色框则把整个人包了进去。走路时脚步张开又合拢,宽度变化很大,从宽高比推回来的宽度跟不上。
作者在论文里很坦白,这个改动确实让 HOTA 上升,但严格来说,他们也不清楚原因,只能推测是框的宽度更贴合物体。
二、相机运动补偿(CMC)
在没有 IMU 或导航信息、也不知道相机内参的情况下,相邻两帧之间的图像配准,是相机刚体运动投影到图像平面上的一个好近似。
作者沿用 OpenCV 视频稳定模块里的全局运动补偿(Global Motion Compensation, GMC):
- 在上一帧提取图像关键点。
- 用稀疏光流把这些关键点跟踪到这一帧,并剔除局部的离群点。
- 用 RANSAC 估计一个 的仿射矩阵:
是缩放和旋转, 是平移。作者也提到,检测框所在的区域是动态物体,可以在估计时排除,让估计只反映背景的运动。
有了 ,就把卡尔曼滤波的预测搬到新的坐标系。作者用了一个小技巧,把 摆成 的分块对角矩阵 ,把 补零成 8 维的 (只有中心位置那两维有值):
我们拆开看这条式子对状态向量做了什么。八维状态可以两两分组:中心 、宽高 、中心速度 、宽高速度 。 对每一组都乘上同一个 ,所以相机一旋转,中心、框的大小和速度方向都跟着转; 只加在中心上,因为相机平移只会让物体的位置移动,不会改变它的大小或速度。协方差也一起变换,让滤波器的不确定性跟着新的坐标系走。
补偿完的预测,才拿去和这一帧的检测做 IoU 匹配。
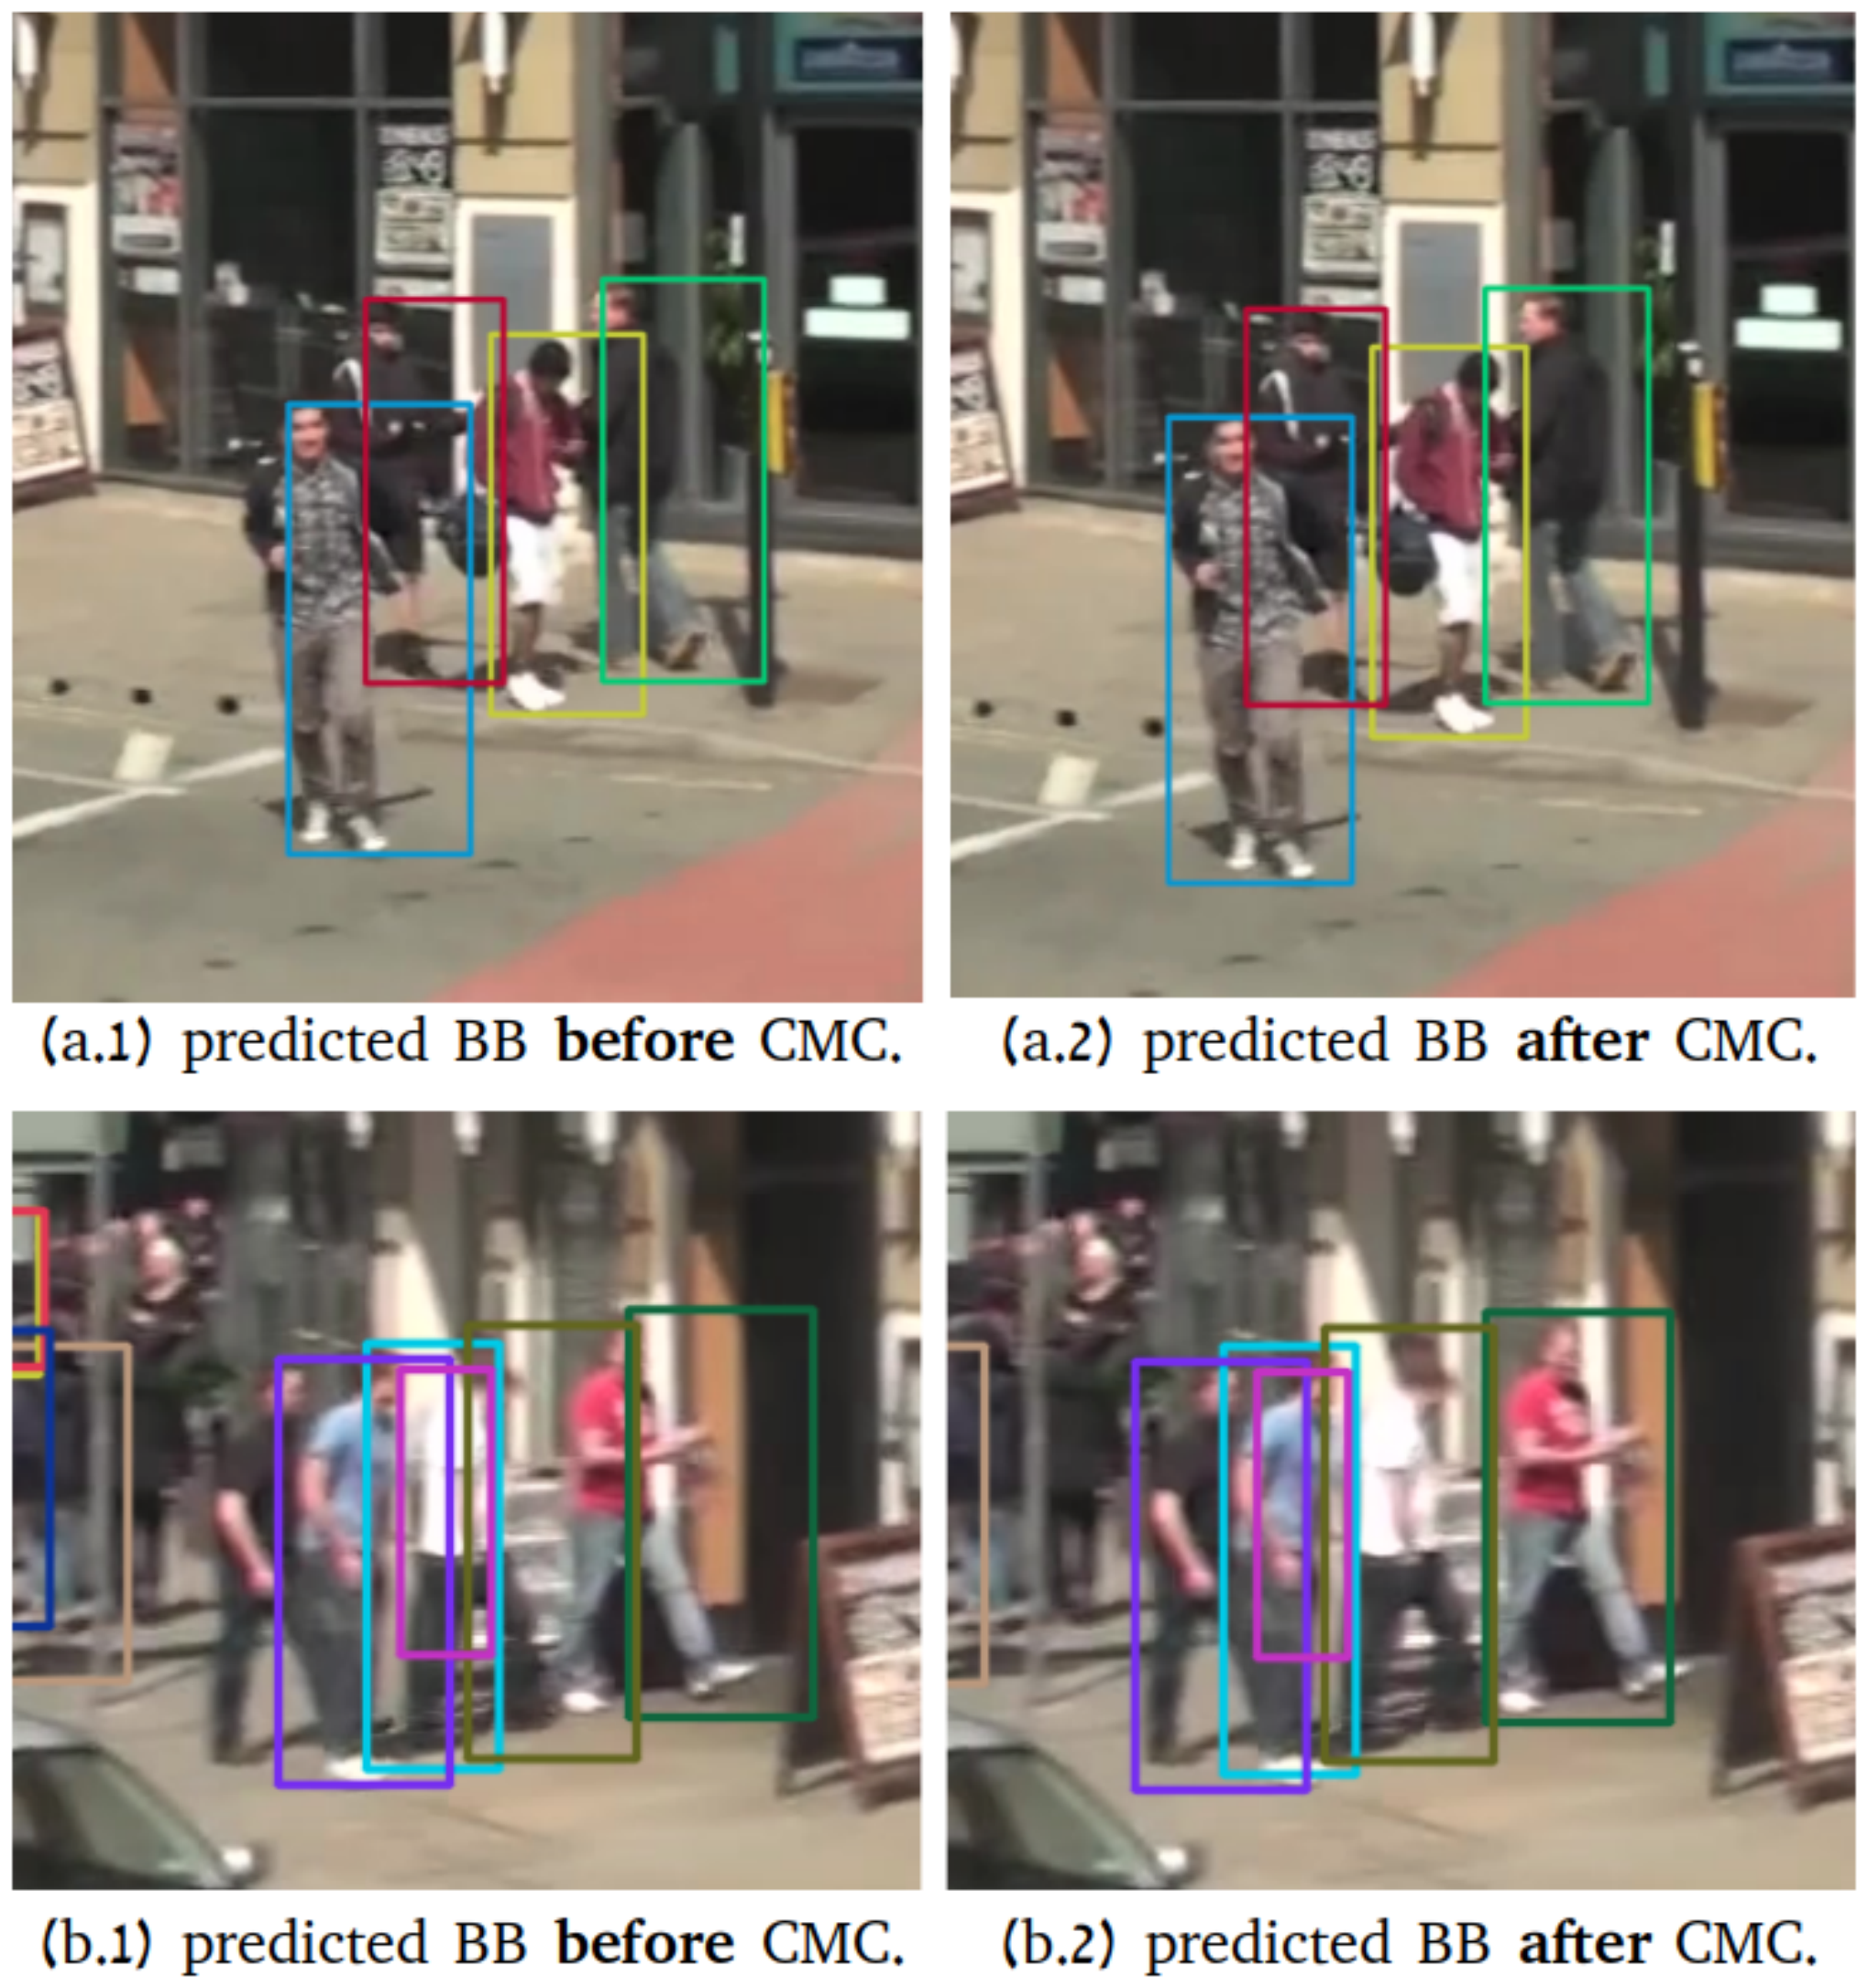
这是 MOT17-13 的画面,相机架在一辆正在右转的车上。补偿前,预测框整排偏到行人旁边,IoU 匹配一定失败;补偿后,框落回人身上。
三、IoU 与 re-ID 的融合
外观特征用 FastReID 库里的 SBS(stronger baseline on top of BoT),骨干是 ResNeSt50。和 StrongSORT 一样,每条轨迹的外观用 EMA 更新,。为了避免被遮挡或模糊的框污染外观,只有高分检测才提取特征。
常见的做法是把外观距离和运动距离加权相加,FairMOT 和 StrongSORT 都用 。作者改用另一种组合:先过滤,再取最小值。
是 IoU 距离(1 减 IoU), 是轨迹外观和检测特征的余弦距离。,。
这个式子读起来有点绕,我们用三组轨迹和检测框代进去看:
- 位置近、长得像。 IoU 是 0.7,所以 ;余弦距离 0.1。两个条件都成立,,代价取较小的 0.05。外观和位置都同意,代价压得很低,这一对几乎一定会匹配上。
- 位置近、长得不像。 IoU 0.8,;余弦距离 0.4,超过 0.25。外观不算数,,代价取 0.2。外观没有扣分,只是不帮忙,匹配完全看 IoU。
- 长得像、位置远。 IoU 0.3,,超过 0.5;余弦距离 0.05。位置太远,外观也不算数,代价取 0.7。
外观只有在「位置也说得过去」的时候才能帮忙压低代价。长得像但离得很远的人,不会因为穿了同样的衣服就被接起来。
这个阈值,是作者在 MOT17 验证集上画出同一人与不同人的外观距离分布后选的:同一人的距离集中在很小的范围,不同人则大多在更远的地方。
顺便一个调试工具:cMOTA
作者还提出一个分析工具,叫 current-MOTA。 就是从第一帧算到第 帧为止的 MOTA;算到最后一帧,就是一般的 MOTA。
把它画成随时间变化的曲线,跟踪器在哪一段开始出错,一眼就看得到。
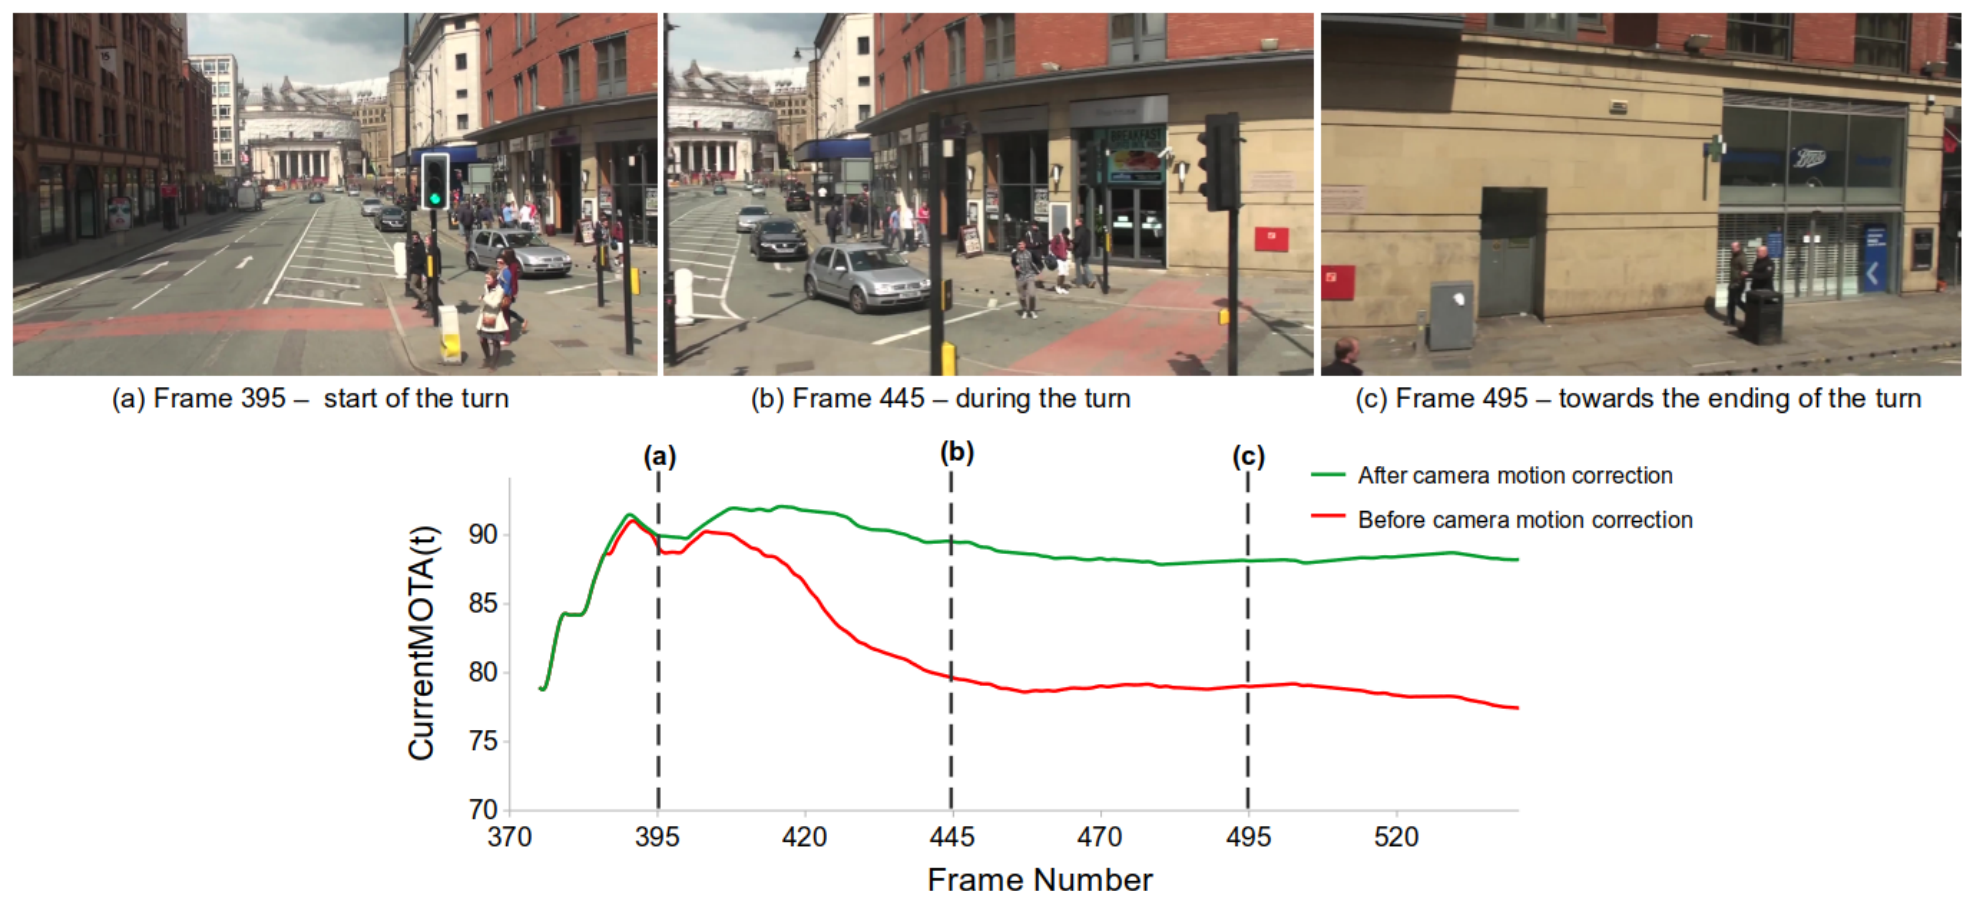
红线在第 400 到 470 帧之间急速下降,对照上面的画面,正好是相机转弯的那一段。加上相机运动补偿后,绿线几乎没有掉。
讨论
检测器直接用 ByteTrack 公开的 YOLOX 权重,re-ID 模型是 FastReID 的 SBS-50,训练 60 个 epoch。跟踪参数沿用 ByteTrack:分数阈值 0.6、相似度低于 0.2 拒绝匹配、丢失轨迹保留 30 帧。为了公平比较,也和 ByteTrack 一样使用最大间隔 20 帧的线性插值。实验在一张 RTX 3060 上跑。
每一项改动的贡献
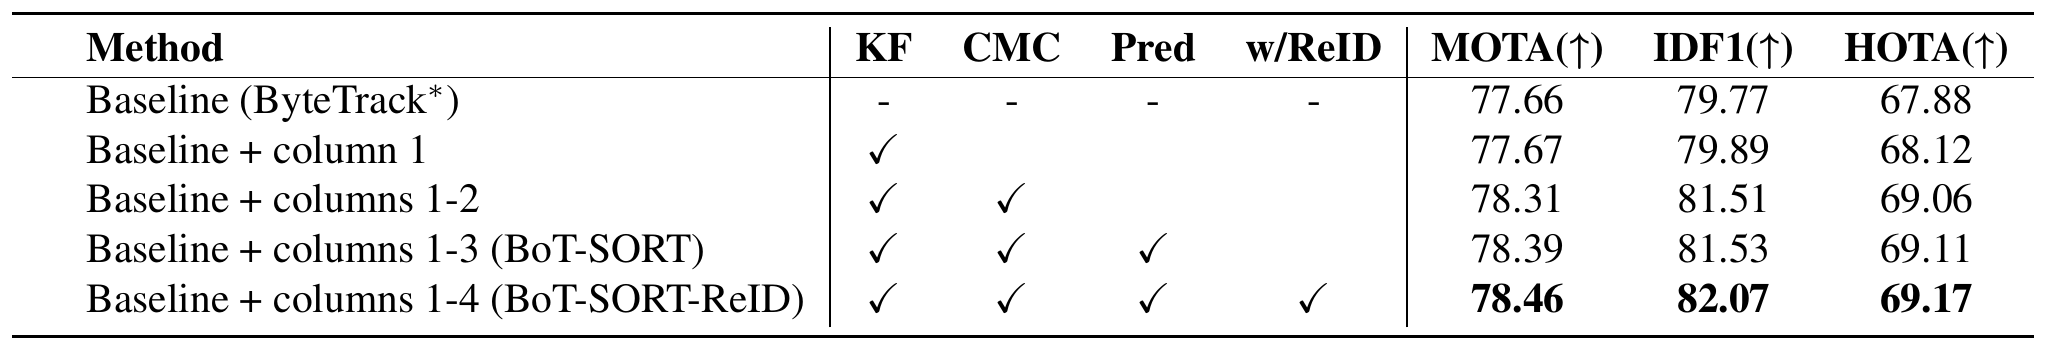
表中的 Pred 是另一个小改动。在高帧率视频中,轨迹短暂没匹配到检测时,用卡尔曼滤波的预测框继续输出,而不是让它消失。
从基线一路加上去:
- 新的卡尔曼滤波: HOTA +0.24,MOTA 和 IDF1 几乎不变。
- 相机运动补偿: MOTA +0.64、IDF1 +1.62、HOTA +0.94,是四项中最大的一步。
- 预测输出: 三项都只多一点点。
- re-ID: IDF1 再 +0.54,MOTA 和 HOTA 小幅上升。
从 ByteTrack 到 BoT-SORT-ReID,HOTA 多了约 1.3,IDF1 多了约 2.3,其中超过一半来自相机运动补偿。
作者也比较了第一次关联该怎么用外观特征。只用 IoU 是 MOTA 78.4、IDF1 81.5、HOTA 69.1;只用余弦距离掉到 73.7、70.0、62.4;JDE 式的「外观距离加卡尔曼滤波门控」是 77.7、80.1、68.2;用 IoU 过滤后只看余弦距离是 78.3、81.0、68.7。除了作者提出的融合方式(78.5、82.1、69.2),其他用到 re-ID 的做法都输给单纯的 IoU。作者因此建议,资源有限的应用,只用 IoU 就是不错的选择。
排行榜
MOT17 测试集上:
- BoT-SORT:MOTA 80.6、IDF1 79.5、HOTA 64.6。
- BoT-SORT-ReID:MOTA 80.5、IDF1 80.2、HOTA 65.0。
作者说,BoT-SORT-ReID 是第一个在 MOT17 上 IDF1 超过 80 的跟踪器。和 ByteTrack 的 80.3、77.3、63.1 相比,MOTA 差不多,IDF1 和 HOTA 都明显提升;ID 切换从 ByteTrack 的 2196 次降到 1212 次。
MOT20 测试集上,BoT-SORT-ReID 是 MOTA 77.8、IDF1 77.5、HOTA 63.3;ByteTrack 是 77.8、75.2、61.3。MOTA 持平,IDF1 和 HOTA 一样有进步。
速度是代价。表中 BoT-SORT 在 MOT17 上是 6.6 FPS,BoT-SORT-ReID 是 4.5 FPS,ByteTrack 则是 29.6 FPS。不过作者也提醒,各方法测速度的硬件不同,大多也不计入检测时间,FPS 很难直接比较。
作者承认的局限
- 相机运动补偿可能失败。 画面里动态物体太多时,背景的关键点不够,相机运动估计就会出错;错的补偿可能让跟踪器做出预期之外的行为。
- 计算时间。 大尺寸图像的全局运动估计很花时间。作者认为,和检测器的推理时间相比,这部分可以忽略,也可以用多线程并行计算。
- 外观特征让跟踪器变慢。 他们只对高分检测提取特征来降低开销;必要时,也可以把特征提取并进检测器的输出头,改成 JDE 那种联合架构。
后来
BoT-SORT 后来成了 Ultralytics YOLO 跟踪模块的默认跟踪器,另一个选项是 ByteTrack。Ultralytics 的文档建议,手持、航拍或车载这类移动相机的视频用 BoT-SORT;只求速度、相机固定的话,ByteTrack 的负担最小。它的配置文件把相机运动估计做成可替换的选项,默认是稀疏光流,也能换成 ORB、SIFT、ECC 或关闭;re-ID 则是可选项。
Roboflow 的跟踪器文档也给了类似的建议,移动相机要开相机运动补偿,固定相机若需要最快的速度可以关掉;在缺乏纹理的背景上,基于稀疏特征的运动估计可能不可靠。这和论文自己写的第一个局限是同一件事。
结论
卡尔曼滤波直接估计宽和高,预测框跟着相机一起搬,IoU 和外观先过滤、再取最小,BoT-SORT 在 ByteTrack 上就做了这三件事。消融显示,最大的一步是相机运动补偿;再加上 re-ID 的 BoT-SORT-ReID,MOT17 的 IDF1 越过了 80。
手机、无人机或车上拍的视频,相机运动补偿大概是最该先打开的开关。监控摄像头固定在墙上不动的话,就把它关掉,把那几毫秒留给检测器吧!