原始论文
Evaluating Multiple Object Tracking Performance: The CLEAR MOT Metrics
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@article{multiobjecttrackingclearmot2008,
  title = {{Evaluating Multiple Object Tracking Performance: The CLEAR MOT Metrics}},
  author = {Keni Bernardin and Rainer Stiefelhagen},
  year = {2008},
  journal = {EURASIP Journal on Image and Video Processing},
  url = {https://doi.org/10.1155/2008/246309},
  doi = {10.1155/2008/246309}
}
跟踪论文的主表,第一列几乎都是 MOTA。
SORT、DeepSORT、FairMOT 都靠它排名次。到了 HOTA 那篇,它被拆开来批评:换了三次 ID 只扣 3 分,分数几乎都被检测吃掉。
既然问题这么多,当初为什么会设计成这样?
这次回到源头。2008 年,德国卡尔斯鲁厄大学的 Keni Bernardin 和 Rainer Stiefelhagen 提出 MOTA 和 MOTP 两个指标,论文标题里的 CLEAR,是 2006 和 2007 年两届国际评测的名字。
有意思的是,当时要评测的对象跟我们熟悉的行人跟踪很不一样。主要的任务是在研讨室里,用好几台相机估计每个人站在地板上的哪个位置,单位是厘米;另外还有人脸跟踪、街景的行人和车辆,甚至有用麦克风阵列找出谁在说话的声音跟踪。MOTA 的很多设计,是被这些任务逼出来的。
定义问题
单个物体的跟踪很好评估,量一量每一帧的位置误差就行了。多个物体就麻烦了:跟踪器输出的轨迹数量可能比真实物体多,也可能少,轨迹之间还会换来换去。
当时并不缺指标,缺的是共识。作者整理了几套已有的评估方式:
- Li 等人为多相机的足球运动员跟踪设计了三个度量,其中两个只适用于足球,比较通用的那一个,又没有考虑误报的轨迹和定位误差。
- ETISEO 项目提出了 8 个指标,彼此依赖,很多指标要搭配另外一两个才能解读。
- Smith 等人最接近这篇的想法,但用了 9 个度量:5 个衡量物体配置的错误,4 个衡量标记不一致。有些度量还分别对跟踪器和物体各定义一次,例如 MT/MO、FIT/FIO。
指标太多,一次大型评测有几十个系统要比较,读者根本看不出谁好谁坏。结果就是很多论文干脆不做定量评估,或是各自发明一套。
作者先描述理想的多目标跟踪器:每一个时刻都找到正确数量的物体,位置估得尽量准,每个物体从头到尾只有一个不变的 ID,被短暂遮住后回来也一样。轮廓、方向、速度这些不在考虑范围内。
由此定出指标的要求:
- 能判断位置估得多准。
- 能反映跟踪器有没有一致地跟住每一个物体,一个物体恰好一条轨迹。
- 可调的参数和阈值越少越好。
- 直观,多种错误同时出现、或错误在时间上分布不均的时候,数字还是合理。
- 通用,2D、3D、只估中心点的、会估框的跟踪器都能比。
- 数量少,但信息量够。
前两点是目标,后面四点是限制。真正难的地方在于「怎么数错误」。先留一个问题给你想想:一个跟踪器在一段视频里,把同一个人换了一次 ID,这算几次错?
解决问题
整套评估在每一帧做三件事:
- 在跟踪器输出的假设 和真实物体 之间,找出最好的对应。
- 对每一组对应,算出位置的误差。
- 累计三种错误:没有任何假设对上的物体算漏检(miss);没有对应任何真实物体的假设算误报(false positive);物体这一次对上的假设和之前不同,算一次错配(mismatch)。
最后只用两个数字表达跟踪器的表现:位置估得多准,以及总共犯了多少错。
这套流程的细节,几乎都在第一步。
太远就不算
最直观的做法是把每个物体配给最近的假设,剩下的物体算漏检、剩下的假设算误报。第一个要处理的情况是,最近的假设也离得很远。
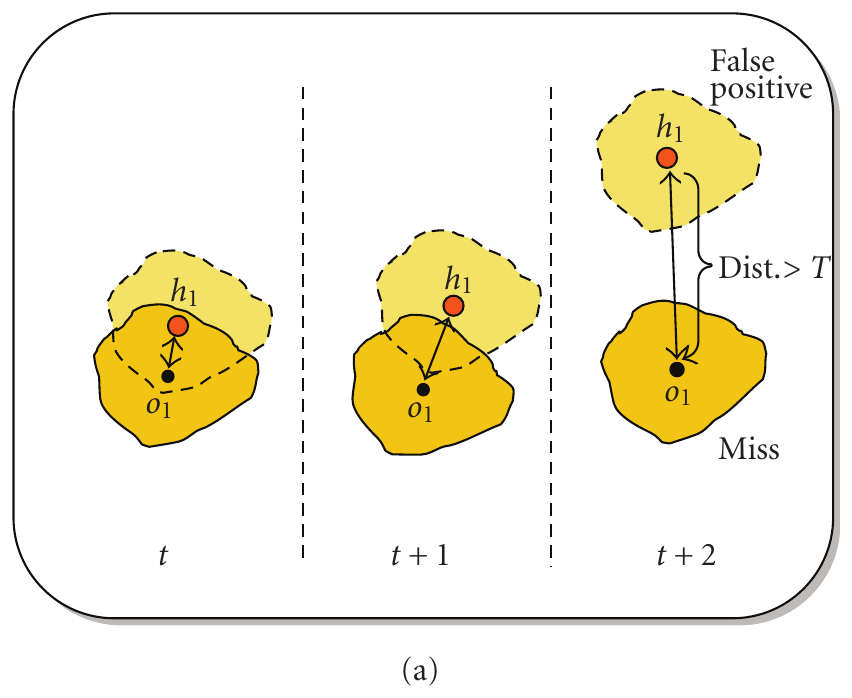
图中的 在第三帧飘到了上方。它还在跟踪 吗?作者认为,距离大到一定程度,就不能再说是「位置估得不准」,而是跟踪器已经丢了这个物体、在跟踪别的东西。所以只有距离 的对应才算有效;超过阈值,物体算一次漏检,假设算一次误报。
阈值 怎么定,取决于任务和距离的算法。会估框的跟踪器可以用重叠程度,阈值设成「完全没有重叠」;只估中心点的跟踪器用欧氏距离,阈值可以是一个人的平均宽度,单位是像素或厘米。作者明确表示, 没办法对所有情况给一个通用值,用数据自动确定的方法这篇也没有研究。
换了人,算几次错?
再来是时间上的一致性。
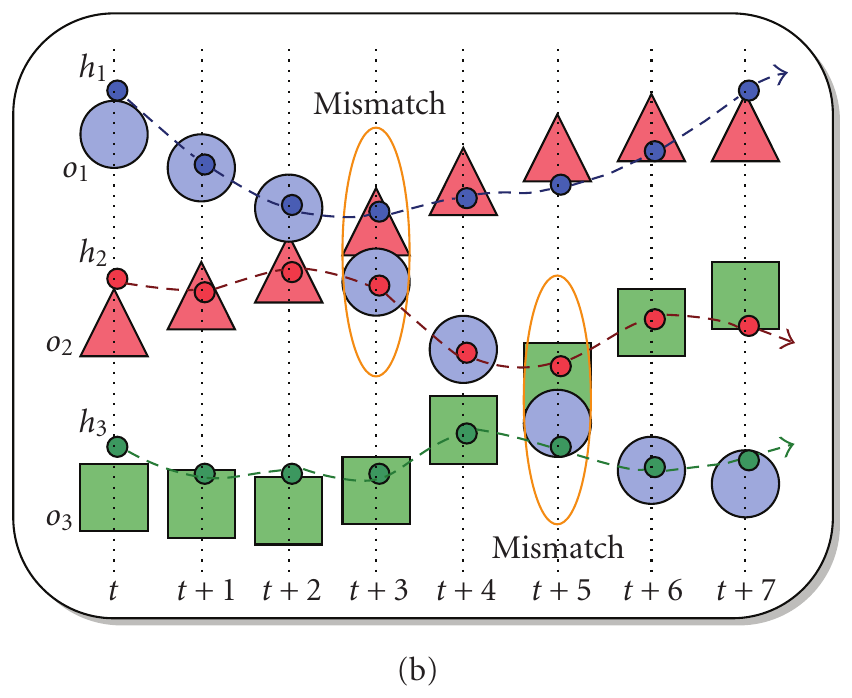
一开始,、、 各自跟着 、、。到了 ,蓝色的 和红色的 走到一起,分开之后, 跟上了 , 跟上了 。到了 , 又和绿色的 交错,这次换成 跟上 、 跟上 。
这种错误要怎么数?
一种想法是先给每个物体确定一个「最佳」的假设,例如第一次配上的、或整段视频里配得最多次的那个,然后把所有违反这组匹配的帧都算成错误。作者用下一张图说明这种做法的问题。
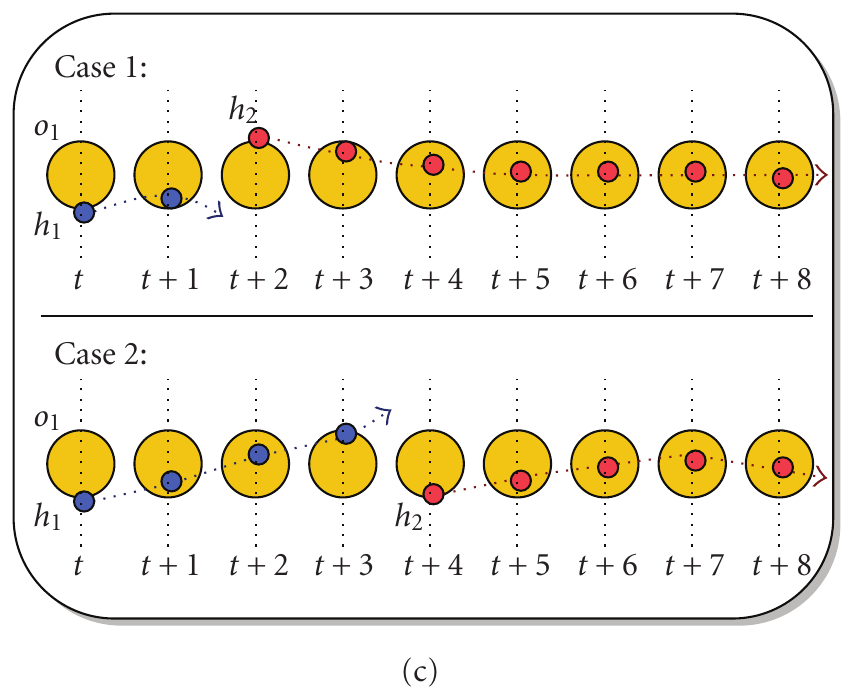
两种情况都只换了一次假设,犯的是同一种错。但 在两种情况里都是配得最多次的假设,用「最佳匹配」去数,Case 1 只有开头 2 帧违反,算 2 个错;Case 2 前 4 帧都违反,算 4 个错。错误的多少,取决于交换发生得早还是晚。
作者改成只在对应改变的那一帧算一次错配,中间的片段都算对。换了一次,就是一次。
照这个规则回头数 Figure 2(b)。 那次交错, 和 各自换了假设,算两次; 那次, 和 各换一次,又是两次,一共四次错配。之后 一路跟着 到最后,不会因为「跟错人」而每一帧都扣分。
记住之前配过谁
要知道「对应改变了」,就得记住之前的对应。作者维护一张对应表 ,记录到时间 为止的所有匹配,一开始是空的 。如果在 时, 配上了 ,和表上的 矛盾,就算一次错配,并把表上的匹配换成 。
这张表还有第二个用途:有好几个有效选择时,用来决定要配给谁。
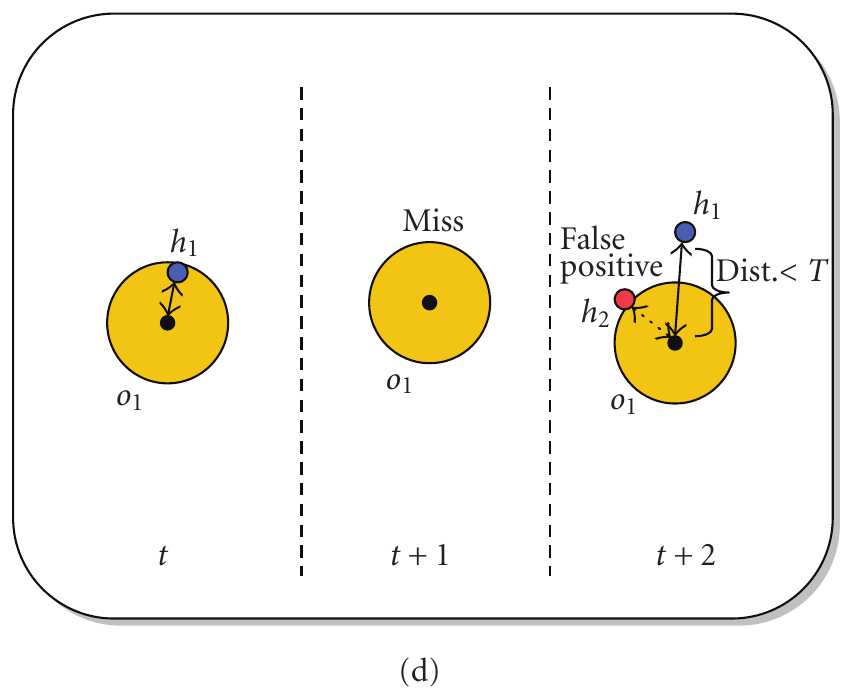
在 跟丢了, 又回来,同时旁边多了一个更近的 。如果只看距离,应该配 ;但表上记着 ,作者优先沿用这组匹配,因为它最可能才是正确的轨迹。 算误报,它可能是跟踪器对同一个人多输出了一个假设,也可能是原本在跟别人的假设刚好飘了过来。
完整的匹配流程
把上面的设计合起来,每一帧的步骤是:
- 先沿用旧的对应。 对表上 的每一组 ,如果物体还在、假设还在、距离没超过 ,这一帧就直接配上。
- 剩下的再重新配。 还没配上的物体和假设,在一对一、距离不超过 的约束下,找出总距离最小的匹配。这是一个最小权重指派问题,用 Munkres 算法(也就是匈牙利算法)求解。若新匹配和 矛盾,就更新表格,并记一次错配;这一帧的错配数记为 。
- 算距离。 这一帧总共配上 组,每组算出物体 和假设之间的距离 。
- 剩下的算错。 没配上的假设都算误报,数量 ;没配上的物体都算漏检,数量 。这一帧的真实物体数记为 。
- 进入下一帧。第一帧的表是空的,所有匹配都是新的,不会有错配。
第一步是整个流程的重点。旧的匹配只要还有效,就不交给匈牙利算法重新决定,即使重新配可以让总距离更小。这样,跟踪器一致地跟住同一个物体,就会在评估里得到回报。
两个指标
有了每一帧的计数,第一个指标是多目标跟踪精度(MOTP):
所有配上的对应,平均的位置误差。它只回答「配上的时候,位置估得多准」,和跟踪器有没有找对物体数量、有没有换 ID 无关。用欧氏距离时越小越好,用框的重叠程度时则越大越好。
第二个指标是多目标跟踪准确度(MOTA):
分子是所有帧的漏检、误报、错配总和,分母是所有帧的真实物体数。拆开来看,就是三个错误率相加:
MOTA 就是 1 减去总错误率。作者把它比作语音识别的词错误率(WER):把该有的、多出来的、认错的全部加起来,除以标准答案的长度。
词错误率可以超过 100%,MOTA 自然也可以是负的。误报很多的时候,分子可以比分母还大。
先求和,再除
公式里的求和分别放在分子和分母里面,而不是先算每一帧的比率再平均。这个顺序是刻意的。
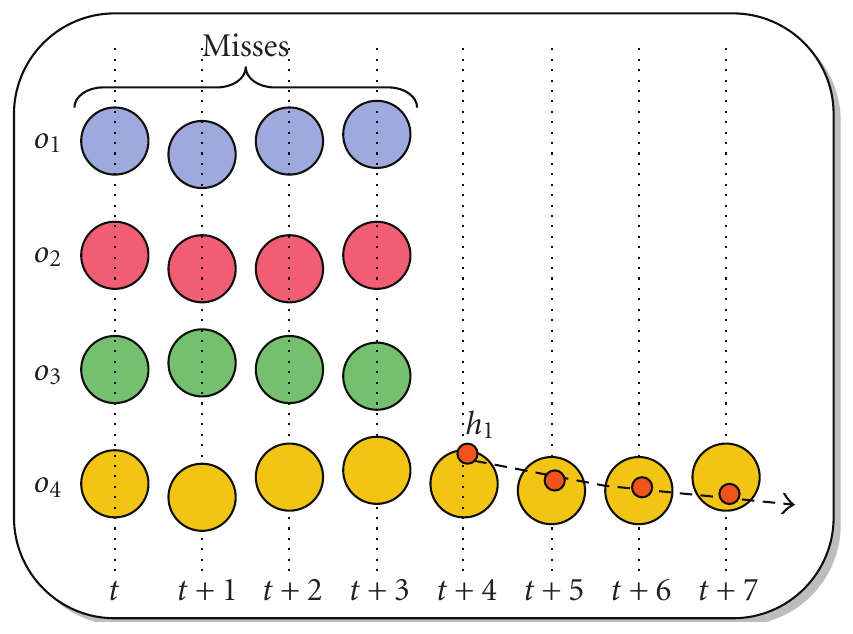
我们用这张图算一次漏检率。
前 4 帧,4 个物体都没跟踪到,每一帧的漏检率是 100%;后 4 帧只剩一个物体,而且跟踪到了,漏检率是 0%。先算每一帧的比率再平均:
先把错误加起来再除:前 4 帧共漏了 16 个,全部 8 帧共有 个物体,漏检率是 。
这个跟踪器明明漏掉了大部分物体,逐帧平均却说它漏了一半。作者指出,Smith 等人的误报和漏检度量用的就是逐帧平均,所以会出现这种反直觉的结果。
在 CLEAR 评测里实际用起来
CLEAR 的全称是 Classification of Events, Activities and Relationships,由欧盟的 CHIL 项目、美国的 VACE 项目和美国国家标准与技术研究院(NIST)联合举办,2007 年 AMI 项目也加入了。2006 年的评测还有一些任务用其他指标;到了 2007 年,所有和跟踪有关的任务,不论单个还是多个物体、不论视觉还是声音,都用 MOT 指标评估。
不同任务只改距离的算法和阈值:
- 3D 视觉人物跟踪: 研讨会和会议的场景,用多台相机估计每个人在地板上的位置。距离是地板上的欧氏距离,阈值 50 厘米。2D 图像跟踪中常见的轨迹合并、分裂,在这种多相机的 3D 场景里没什么意义,反而要小心区分定位误差、误报和配错人。作者说,这个任务主导了 MOT 指标大部分的设计。
- 2D 人脸跟踪: 估计每个视角里人脸的位置和范围,距离改用框的重叠,阈值是完全没有重叠。
- 2D 行人与车辆跟踪: 户外的交通场景,同样用框的重叠。
- 3D 声音与多模态人物跟踪: 用分布式麦克风阵列找出正在说话的人在哪里。漏检和误报恰好对应语音分段的错误,MOTP 对应定位精度。声音跟踪不要求分辨说话者是谁,所以不计错配,这个版本叫 A-MOTA。
七个系统,三个打平
2007 年 3D 多人视觉跟踪的结果如下:
| 系统 | MOTP | 漏检率 | 误报率 | 错配次数 | MOTA |
|---|---|---|---|---|---|
| A | 92 mm | 30.86% | 6.99% | 1,139 | 59.66% |
| B | 91 mm | 32.78% | 5.25% | 1,103 | 59.56% |
| C | 141 mm | 20.66% | 18.58% | 518 | 59.62% |
| D | 155 mm | 15.09% | 14.5% | 378 | 69.58% |
| E | 222 mm | 23.74% | 20.24% | 490 | 54.94% |
| F | 168 mm | 27.74% | 40.19% | 720 | 30.49% |
| G | 147 mm | 13.07% | 7.78% | 361 | 78.36% |
整理自原论文 Figure 7,CLEAR 2007 3D 多人视觉跟踪。
先看 MOTP。大多数系统的平均定位误差都在 20 厘米以内,听起来都很准,毕竟真实位置是把头部中心投影到地板上,本身只标到 5 到 8 厘米的精度。但作者提醒,50 厘米的阈值会让 MOTP 很难变大:超过 50 厘米的都被当成漏检踢掉了,就算误差在阈值内均匀分布,MOTP 也只有 25 厘米。这样看,E 的 222 mm 其实不太准,B 的 91 mm 则相当精确。
再看 MOTA。最好的 G 是 78%,最差的 F 是 30%,一眼就看得出来。但 A、B、C 三个系统用的特征和算法很不一样,MOTA 却都在 59.6% 左右。
只看 MOTA,这三个系统一样好。把分数拆开,B 的位置最准、误报最少,但漏检最多,错配次数是 C 的两倍多;C 漏得少、误报多、错配少。两个跟踪器的强项完全不同。所以评测最后决定,除了 MOTP 和 MOTA,也一起公布漏检、误报和错配这三个组成部分。
错配太便宜了
表上的错配是次数,不是比率。这背后有一个作者在 2006 年就发现、到论文发表时还没解决的问题。
CLEAR 的数据,每段长好几分钟,每 1 秒才标注一次。一个合理的跟踪器,错配次数和真实物体的总数相比少得可怜:错配率通常不到 2%,漏检和误报却有 20% 到 40%。一个人被漏掉一小段时间,扣的分就比换好几次 ID 还多,标错身份对 MOTA 的影响很小。
作者没有就这件事下定论。标错身份算不算比较轻微的错,要看应用;但评测会议的共识是,希望给身份错误更多的权重,例如改用以整条轨迹为单位的错误度量,摆脱由逐帧漏检、误报主导的局面。
这段话写于 2008 年。八年后的 IDF1 用整条轨迹做匹配,再过四年,HOTA 把检测和关联拆成两个分数,做的正是这件事。
后来的 MOTChallenge 每一帧都标注。以下是本文的推测:每一帧都标,漏检和误报会随着帧数等比例增加,一次身份交换却还是只算一次,CLEAR 当年就看到的不平衡,只会更严重。HOTA 那篇里「换了三次 ID 只扣 3 分」的例子,就是这个不平衡的缩影。
阈值决定一切
这个参数的影响也很大。 设成无穷大,一组对应一旦建立就永远有效,不管假设飘到多远,MOTA 只剩下「物体数量对不对」的意义,MOTP 也失去作用; 趋近于零,所有物体最后都会被算成漏检,两个指标都没有意义。
50 厘米是凭直觉定的,效果还算合理。至于最佳的阈值怎么确定,作者说这仍是个没有答案的问题。
MOTA 为什么可以是负的
2006 年的单人 3D 跟踪,只跟踪台上的讲者。表上最差的系统 A,MOTA 是 。
它的平均定位误差有 246 mm,因为距离超过 50 厘米而被算成漏检的比例高达 88.75%,真正没输出假设的漏检只有 2.28%。
这就是 MOTA 会变成负数的原因。每一次定位误差超过阈值,物体算一次漏检,假设算一次误报,同一个错误被罚两次。
作者说这是刻意的。有些跟踪器会根据置信度,在估得不准时干脆不输出;有些跟踪器则一直输出错误的位置。前者应该比较好。照论文的说法,一个有一半时间没检测到讲者的跟踪器,比在同样长的时间里一直跟着空白黑板的跟踪器还要好。
错误分成哪几种固然重要,但错误在时间序列上怎么数,对指标行为的影响同样大,这是整篇论文最重要的观察。
声音跟踪也一样,最好的 G 拿到 54.63% 的 A-MOTA,最差的 B 则是 。至于 2007 年的人脸跟踪,两个系统的 MOTP(框的重叠)分别是 0.66 和 0.68,找到脸之后框得一样准;MOTA 却是 33.07% 对 68.81%,差别全在有没有找到脸、能不能一直跟住。
结论
这篇论文用一套明确的匹配流程,把多目标跟踪的错误归成漏检、误报、错配三类,再用两个数字总结:MOTP 衡量位置估得多准,MOTA 衡量总共错了多少。
它的价值在流程。距离超过阈值就不算配上;旧的匹配只要还有效就优先沿用;错配只在改变的那一帧算一次;比率先求和再除。每一条规则背后都有一个具体的反例撑着。
它的问题,作者也在当年的评测里看到了。三个风格完全不同的系统可以拿到几乎一样的 MOTA;错配和漏检、误报不成比例,标错身份几乎不影响分数;阈值 怎么定,没有答案。后来的 MOTChallenge 把阈值统一成 IoU 0.5,身份错误的权重问题,则等到 IDF1 和 HOTA 才有人正面处理。
下次看到 MOTA 是负的,先别急着怀疑评估程序写错了。这篇论文早就说过,一直跟着黑板跑的跟踪器,本来就该比什么都不输出的还要差。