原始論文
Evaluating Multiple Object Tracking Performance: The CLEAR MOT Metrics
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@article{multiobjecttrackingclearmot2008,
  title = {{Evaluating Multiple Object Tracking Performance: The CLEAR MOT Metrics}},
  author = {Keni Bernardin and Rainer Stiefelhagen},
  year = {2008},
  journal = {EURASIP Journal on Image and Video Processing},
  url = {https://doi.org/10.1155/2008/246309},
  doi = {10.1155/2008/246309}
}
追蹤論文的主表,第一欄幾乎都是 MOTA。
SORT、DeepSORT、FairMOT 都靠它排名次。到了 HOTA 那篇,它被拆開來批評:換了三次 ID 只扣 3 分,分數幾乎都被偵測吃掉。
既然問題這麼多,當初為什麼會設計成這樣?
這次回到源頭。2008 年,德國卡爾斯魯厄大學的 Keni Bernardin 和 Rainer Stiefelhagen 提出 MOTA 和 MOTP 兩個指標,論文標題裡的 CLEAR,是 2006 和 2007 年兩屆國際評測的名字。
有趣的是,當時要評測的對象跟我們熟悉的行人追蹤很不一樣。主要的任務是在研討會教室裡,用好幾台相機估計每個人站在地板上的哪個位置,單位是公分;另外還有臉部追蹤、街景的行人和車輛,甚至有用麥克風陣列找出誰在說話的聲音追蹤。MOTA 的很多設計,是被這些任務逼出來的。
定義問題
單一物體的追蹤很好評估,量一量每一幀的位置誤差就行了。多個物體就麻煩了:追蹤器輸出的軌跡數量可能比真實物體多,也可能少,軌跡之間還會換來換去。
當時並不缺指標,缺的是共識。作者整理了幾套既有的評估方式:
- Li 等人為多相機的足球員追蹤設計了三個量測,其中兩個只適用足球,比較通用的那一個,又沒有考慮誤報的軌跡和定位誤差。
- ETISEO 專案提出了 8 個指標,彼此依賴,很多指標要搭配另外一兩個才能解讀。
- Smith 等人最接近這篇的想法,但用了 9 個量測:5 個衡量物體組態的錯誤,4 個衡量標記不一致。有些量測還分別對追蹤器和物體各定義一次,例如 MT/MO、FIT/FIO。
指標太多,一次大型評測有幾十個系統要比較,讀者根本看不出誰好誰壞。結果就是很多論文乾脆不做量化評估,或是各自發明一套。
作者先描述理想的多目標追蹤器:每一個時刻都找到正確數量的物體,位置估得盡量準,每個物體從頭到尾只有一個不變的 ID,被短暫遮住後回來也一樣。輪廓、方向、速度這些不在考慮範圍內。
由此訂出指標的要求:
- 能判斷位置估得多準。
- 能反映追蹤器有沒有一致地追住每一個物體,一個物體剛好一條軌跡。
- 可調的參數和門檻越少越好。
- 直覺,多種錯誤同時出現、或錯誤在時間上分布不均的時候,數字還是合理。
- 通用,2D、3D、只估中心點的、會估框的追蹤器都能比。
- 數量少,但說得夠多。
前兩點是目標,後面四點是限制。真正難的地方在於「怎麼數錯誤」。舉一個問題讓你先想想:一個追蹤器在一段影片裡,把同一個人換了一次 ID,這算幾次錯?
解決問題
整套評估在每一幀做三件事:
- 在追蹤器輸出的假設 和真實物體 之間,找出最好的對應。
- 對每一組對應,算出位置的誤差。
- 累計三種錯誤:沒有任何假設對上的物體算漏檢(miss);沒有對應任何真實物體的假設算誤報(false positive);物體這一次對上的假設和之前不同,算一次錯配(mismatch)。
最後只用兩個數字表達追蹤器的表現:位置估得多準,以及總共犯了多少錯。
這套流程的細節,幾乎都在第一步。
太遠就不算
最直覺的作法是把每個物體配給最近的假設,剩下的物體算漏檢、剩下的假設算誤報。第一個要處理的情況是,最近的假設也離得很遠。
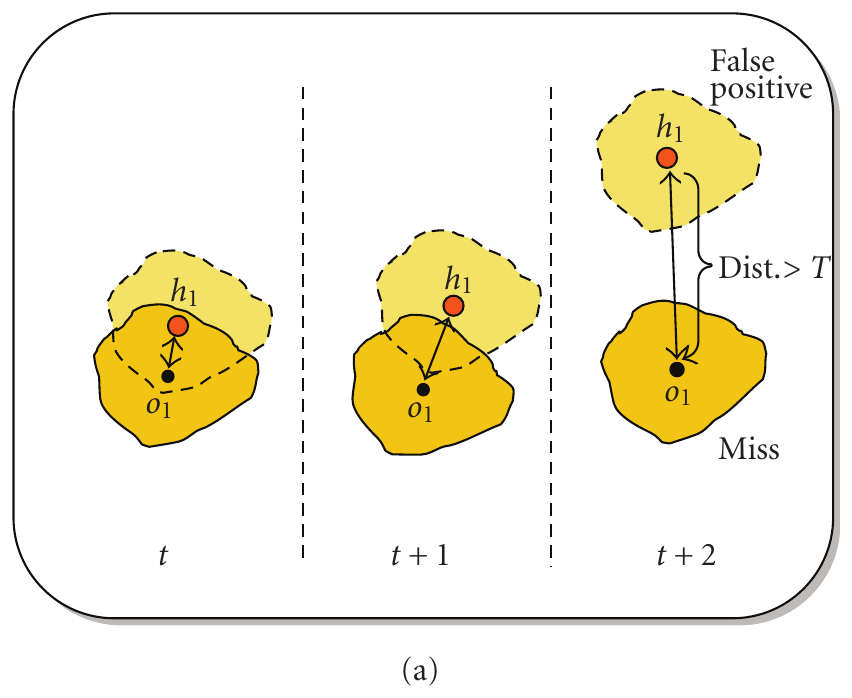
圖中的 在第三幀飄到了上方。它還在追 嗎?作者認為,距離大到某個程度,就不能再說是「位置估得不準」,而是追蹤器已經丟了這個物體、在追別的東西。所以只有距離 的對應才算有效;超過門檻,物體算一次漏檢,假設算一次誤報。
門檻 怎麼定,取決於任務和距離的算法。會估框的追蹤器可以用重疊程度,門檻設成「完全沒有重疊」;只估中心點的追蹤器用歐氏距離,門檻可以是一個人的平均寬度,單位是像素或公分。作者明說, 沒辦法對所有情況給一個通用值,用資料自動決定的方法這篇也沒有研究。
換了人,算幾次錯?
再來是時間上的一致性。
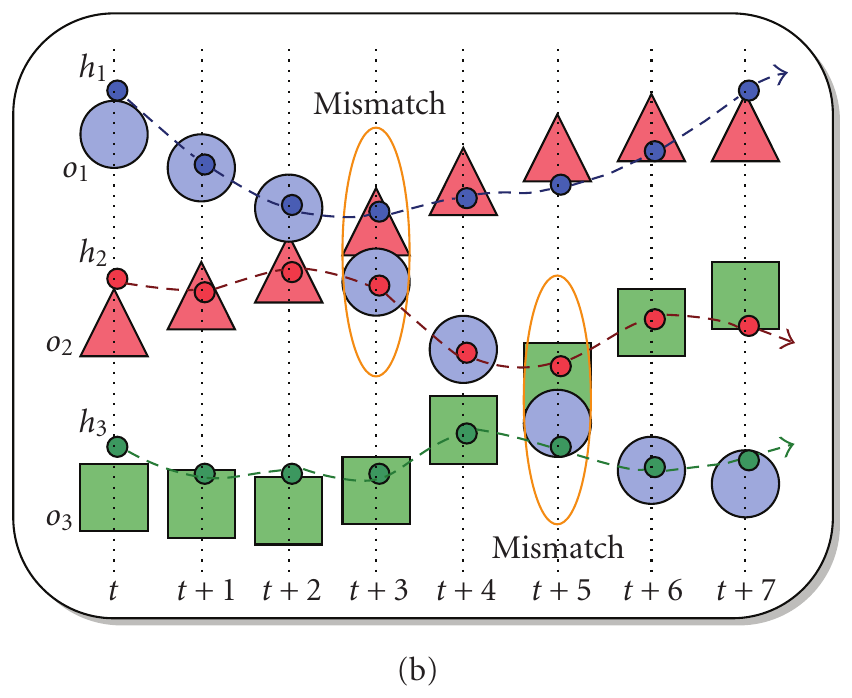
一開始,、、 各自追著 、、。到了 ,藍色的 和紅色的 走到一起,分開之後, 跟上了 , 跟上了 。到了 , 又和綠色的 交錯,這次換成 跟上 、 跟上 。
這種錯誤要怎麼數?
一種想法是先替每個物體決定一個「最佳」的假設,例如第一次配上的、或整段影片裡配得最多次的那個,然後把所有違反這組配對的幀都算成錯誤。作者用下一張圖說明這種作法的問題。
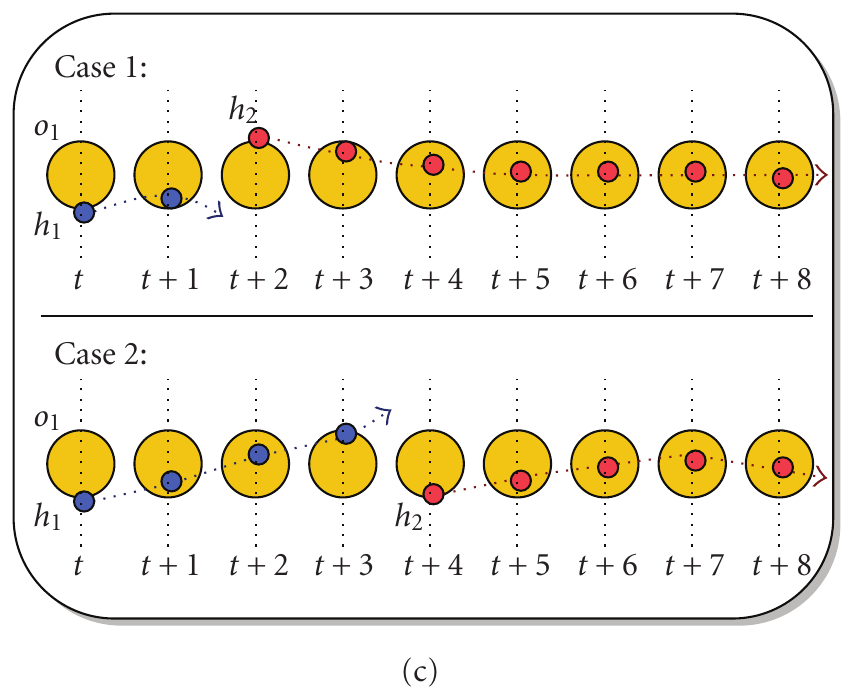
兩種情況都只換了一次假設,犯的是同一種錯。但 在兩種情況裡都是配得最多次的假設,用「最佳配對」去數,Case 1 只有開頭 2 幀違反,算 2 個錯;Case 2 前 4 幀都違反,算 4 個錯。錯誤的多寡,取決於交換發生得早還是晚。
作者改成只在對應改變的那一幀算一次錯配,中間的段落都算對。換了一次,就是一次。
照這個規則回頭數 Figure 2(b)。 那次交錯, 和 各自換了假設,算兩次; 那次, 和 各換一次,又是兩次,一共四次錯配。之後 一路跟著 到最後,不會因為「跟錯人」而每一幀都扣分。
記住之前配過誰
要知道「對應改變了」,就得記住之前的對應。作者維護一張對應表 ,記錄到時間 為止的所有配對,一開始是空的 。如果在 時, 配上了 ,和表上的 矛盾,就算一次錯配,並把表上的配對換成 。
這張表還有第二個用途:有好幾個有效選擇時,用來決定要配給誰。
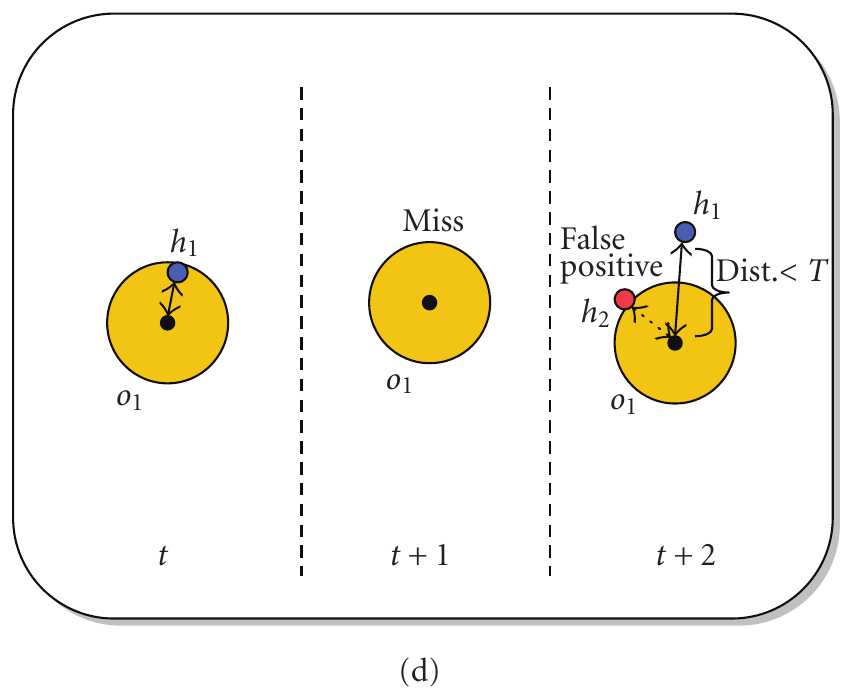
在 跟丟了, 又回來,同時旁邊多了一個更近的 。如果只看距離,應該配 ;但表上記著 ,作者優先沿用這組配對,因為它最可能才是正確的軌跡。 算誤報,它可能是追蹤器對同一個人多輸出了一個假設,也可能是原本在追別人的假設剛好飄了過來。
完整的配對流程
把上面的設計合起來,每一幀的程序是:
- 先沿用舊的對應。 對表上 的每一組 ,如果物體還在、假設還在、距離沒超過 ,這一幀就直接配上。
- 剩下的再重新配。 還沒配上的物體和假設,在一對一、距離不超過 的限制下,找出總距離最小的配對。這是一個最小權重指派問題,用 Munkres 演算法(也就是匈牙利演算法)解。若新配對和 矛盾,就更新表格,並記一次錯配;這一幀的錯配數記為 。
- 算距離。 這一幀總共配上 組,每組算出物體 和假設之間的距離 。
- 剩下的算錯。 沒配上的假設都算誤報,數量 ;沒配上的物體都算漏檢,數量 。這一幀的真實物體數記為 。
- 進到下一幀。第一幀的表是空的,所有配對都是新的,不會有錯配。
第一步是整個流程的重點。舊的配對只要還有效,就不交給匈牙利演算法重新決定,即使重新配可以讓總距離更小。這樣,追蹤器一致地追住同一個物體,就會在評估裡得到回報。
兩個指標
有了每一幀的計數,第一個指標是多目標追蹤精度(MOTP):
所有配上的對應,平均的位置誤差。它只回答「配上的時候,位置估得多準」,和追蹤器有沒有找對物體數量、有沒有換 ID 無關。用歐氏距離時越小越好,用框的重疊程度時則越大越好。
第二個指標是多目標追蹤準確度(MOTA):
分子是所有幀的漏檢、誤報、錯配加總,分母是所有幀的真實物體數。拆開來看,就是三個錯誤率相加:
MOTA 就是 1 減掉總錯誤率。作者把它比作語音辨識的詞錯誤率(WER):把該有的、多出來的、認錯的全部加起來,除以標準答案的長度。
詞錯誤率可以超過 100%,MOTA 自然也可以是負的。誤報很多的時候,分子可以比分母還大。
先加總,再除
公式裡的加總放在分子和分母各自裡面,而不是先算每一幀的比率再平均。這個順序是刻意的。
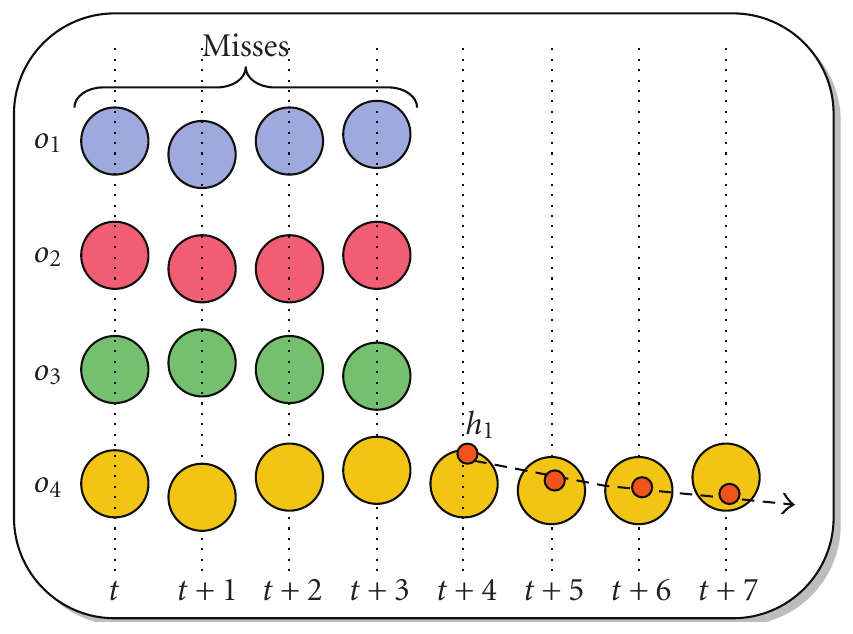
我們用這張圖算一次漏檢率。
前 4 幀,4 個物體都沒追到,每一幀的漏檢率是 100%;後 4 幀只剩一個物體,而且追到了,漏檢率是 0%。先算每一幀的比率再平均:
先把錯誤加總再除:前 4 幀共漏了 16 個,全部 8 幀共有 個物體,漏檢率是 。
這個追蹤器明明漏掉了大部分的物體,逐幀平均卻說它漏了一半。作者指出,Smith 等人的誤報和漏檢量測就是用逐幀平均,所以會出現這種反直覺的結果。
在 CLEAR 評測裡實際用起來
CLEAR 的全名是 Classification of Events, Activities and Relationships,由歐盟的 CHIL 專案、美國的 VACE 專案和美國國家標準暨技術研究院(NIST)合辦,2007 年 AMI 專案也加入。2006 年的評測還有一些任務用其他指標;到了 2007 年,所有和追蹤有關的任務,不論單一或多個物體、不論影像或聲音,都用 MOT 指標評估。
不同任務只改距離的算法和門檻:
- 3D 視覺人物追蹤: 研討會和會議的場景,用多台相機估計每個人在地板上的位置。距離是地板上的歐氏距離,門檻 50 公分。2D 影像追蹤常見的軌跡合併、分裂,在這種多相機的 3D 情境裡沒什麼意義,反而要小心區分定位誤差、誤報和配錯人。作者說,這個任務主導了 MOT 指標大部分的設計。
- 2D 臉部追蹤: 估計每個視角裡臉的位置和範圍,距離改用框的重疊,門檻是完全沒有重疊。
- 2D 行人與車輛追蹤: 戶外的交通場景,同樣用框的重疊。
- 3D 聲音與多模態人物追蹤: 用分散的麥克風陣列找出正在說話的人在哪裡。漏檢和誤報剛好對應語音分段的錯誤,MOTP 對應定位精度。聲音追蹤不要求分辨說話者是誰,所以不計錯配,這個版本叫 A-MOTA。
七個系統,三個平手
2007 年 3D 多人視覺追蹤的結果如下:
| 系統 | MOTP | 漏檢率 | 誤報率 | 錯配次數 | MOTA |
|---|---|---|---|---|---|
| A | 92 mm | 30.86% | 6.99% | 1,139 | 59.66% |
| B | 91 mm | 32.78% | 5.25% | 1,103 | 59.56% |
| C | 141 mm | 20.66% | 18.58% | 518 | 59.62% |
| D | 155 mm | 15.09% | 14.5% | 378 | 69.58% |
| E | 222 mm | 23.74% | 20.24% | 490 | 54.94% |
| F | 168 mm | 27.74% | 40.19% | 720 | 30.49% |
| G | 147 mm | 13.07% | 7.78% | 361 | 78.36% |
整理自原論文 Figure 7,CLEAR 2007 3D 多人視覺追蹤。
先看 MOTP。大多數系統的平均定位誤差都在 20 公分以內,聽起來都很準,畢竟真實位置是把頭部中心投影到地板上,本身只標到 5 到 8 公分的精度。但作者提醒,50 公分的門檻會讓 MOTP 很難變大:超過 50 公分的都被當成漏檢踢掉了,就算誤差在門檻內均勻分布,MOTP 也只有 25 公分。這樣看,E 的 222 mm 其實不太準,B 的 91 mm 則相當精確。
再看 MOTA。最好的 G 是 78%,最差的 F 是 30%,一眼就看得出來。但 A、B、C 三個系統用的特徵和演算法很不一樣,MOTA 卻都在 59.6% 左右。
只看 MOTA,這三個系統一樣好。把分數拆開,B 的位置最準、誤報最少,但漏檢最多,錯配次數是 C 的兩倍多;C 漏得少、誤報多、錯配少。兩個追蹤器的強項完全不同。所以評測最後決定,除了 MOTP 和 MOTA,也一起公布漏檢、誤報和錯配這三個組成。
錯配太便宜了
表上的錯配是次數,不是比率。這背後有一個作者在 2006 年就發現、到論文發表時還沒解決的問題。
CLEAR 的資料,每段長好幾分鐘,每 1 秒才標註一次。一個合理的追蹤器,錯配次數和真實物體的總數相比少得可憐:錯配率通常不到 2%,漏檢和誤報卻有 20% 到 40%。一個人被漏掉一小段時間,扣的分就比換好幾次 ID 還多,標錯身分對 MOTA 的影響很小。
作者沒有替這件事下定論。標錯身分算不算比較輕微的錯,要看應用;但評測會議的共識是,希望給身分錯誤更多的權重,例如改用以整條軌跡為單位的錯誤量測,擺脫由逐幀漏檢、誤報主導的局面。
這段話寫在 2008 年。八年後的 IDF1 用整條軌跡做配對,再過四年,HOTA 把偵測和關聯拆成兩個分數,做的正是這件事。
後來的 MOTChallenge 每一幀都標註。以下是本文的推測:每一幀都標,漏檢和誤報會隨著幀數等比例增加,一次身分交換卻還是只算一次,CLEAR 當年就看到的不平衡,只會更嚴重。HOTA 那篇裡「換了三次 ID 只扣 3 分」的例子,就是這個不平衡的縮影。
門檻決定一切
這個參數的影響也很大。 設成無限大,一組對應一旦建立就永遠有效,不管假設飄到多遠,MOTA 只剩下「物體數量對不對」的意義,MOTP 也失去作用; 趨近於零,所有物體最後都會被算成漏檢,兩個指標都沒有意義。
50 公分是憑直覺定的,效果還算合理。至於最佳的門檻怎麼決定,作者說這仍是個沒有答案的問題。
MOTA 為什麼可以是負的
2006 年的單人 3D 追蹤,只追台上的講者。表上最差的系統 A,MOTA 是 。
它的平均定位誤差有 246 mm,因為距離超過 50 公分而被算成漏檢的比例高達 88.75%,真正沒輸出假設的漏檢只有 2.28%。
這就是 MOTA 會變成負數的原因。每一次定位誤差超過門檻,物體算一次漏檢,假設算一次誤報,同一個錯誤被罰兩次。
作者說這是刻意的。有些追蹤器會根據信心度,在估得不準時乾脆不輸出;有些追蹤器則一直輸出錯誤的位置。前者應該比較好。照論文的說法,一個有一半時間沒偵測到講者的追蹤器,比在同樣長的時間裡一直追著空白黑板的追蹤器還要好。
錯誤分成哪幾種固然重要,但錯誤在時間序列上怎麼數,對指標的行為影響同樣大,這是整篇論文最重要的觀察。
聲音追蹤也一樣,最好的 G 拿到 54.63% 的 A-MOTA,最差的 B 則是 。至於 2007 年的臉部追蹤,兩個系統的 MOTP(框的重疊)分別是 0.66 和 0.68,找到臉之後框得一樣準;MOTA 卻是 33.07% 對上 68.81%,差別全在有沒有找到臉、能不能一直追住。
結論
這篇論文用一套明確的配對流程,把多目標追蹤的錯誤歸成漏檢、誤報、錯配三類,再用兩個數字總結:MOTP 量位置估得多準,MOTA 量總共錯了多少。
它的價值在流程。距離超過門檻就不算配上;舊的配對只要還有效就優先沿用;錯配只在改變的那一幀算一次;比率先加總再除。每一條規則都有一個具體的反例在背後撐著。
它的問題,作者也在當年的評測裡看到了。三個風格完全不同的系統可以拿到幾乎一樣的 MOTA;錯配和漏檢、誤報不成比例,標錯身分幾乎不影響分數;門檻 怎麼定,沒有答案。後來的 MOTChallenge 把門檻統一成 IoU 0.5,身分錯誤的權重問題,則等到 IDF1 和 HOTA 才有人正面處理。
下次看到 MOTA 是負的,先別急著懷疑評估程式寫錯了。這篇論文早就說過,一直追著黑板跑的追蹤器,本來就該比什麼都不輸出的還要差。