原始论文
Self-Instruct: Aligning Language Models with Self-Generated Instructions
- 发表版本
- ACL 2023会议
- arXiv 首次提交
- arXiv:2212.10560
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{modeltuningselfinstruct2022,
  title = {{Self-Instruct: Aligning Language Models with Self-Generated Instructions}},
  author = {Yizhong Wang and Yeganeh Kordi and Swaroop Mishra and Alisa Liu and Noah A. Smith and Daniel Khashabi and Hannaneh Hajishirzi},
  year = {2022},
  eprint = {2212.10560},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2212.10560}
}
指令微调要有指令数据,而那时的指令数据几乎都是人写的。
学术界的做法,是把现成的 NLP 数据集改写成指令,例如 FLAN、T0,或者由研究者一起写出 1,600 多种任务的 Super-NaturalInstructions(以下简称 SuperNI)。业界的 InstructGPT 则用了大量真实用户的提示词,再请标注员写示范,这些数据一条也没有公开。
前者有两个问题。写得出来的任务大多是研究者熟悉的分类、问答、摘要,离普通人真正会拿来问模型的事情有一段距离;而且要人想出新任务、再写出好答案,既要创意也要专业,很难大量做。
2022 年 12 月,华盛顿大学的 Wang 等人想到一个看起来有点偷懒的办法。既然 GPT-3 什么都写得出来,干脆让它自己出题、自己作答,再拿这批数据微调它自己。
定义问题
先把指令数据的样子讲清楚。一个任务 有一段指令 ,以及一组或多组输入与输出 ,模型要做到 。
指令和输入的界线常常不明确。「写一篇关于校园安全的文章」可以整句当指令、不需要输入;也可以把「写一篇关于下列主题的文章」当指令,「校园安全」当输入。作者允许输入为空,让数据格式更多样。
这篇想回答的是,只靠一个没做过指令微调的语言模型,加上很少量的人工种子,能不能生成足够好的指令数据,把模型本身教会听指令?
解决问题
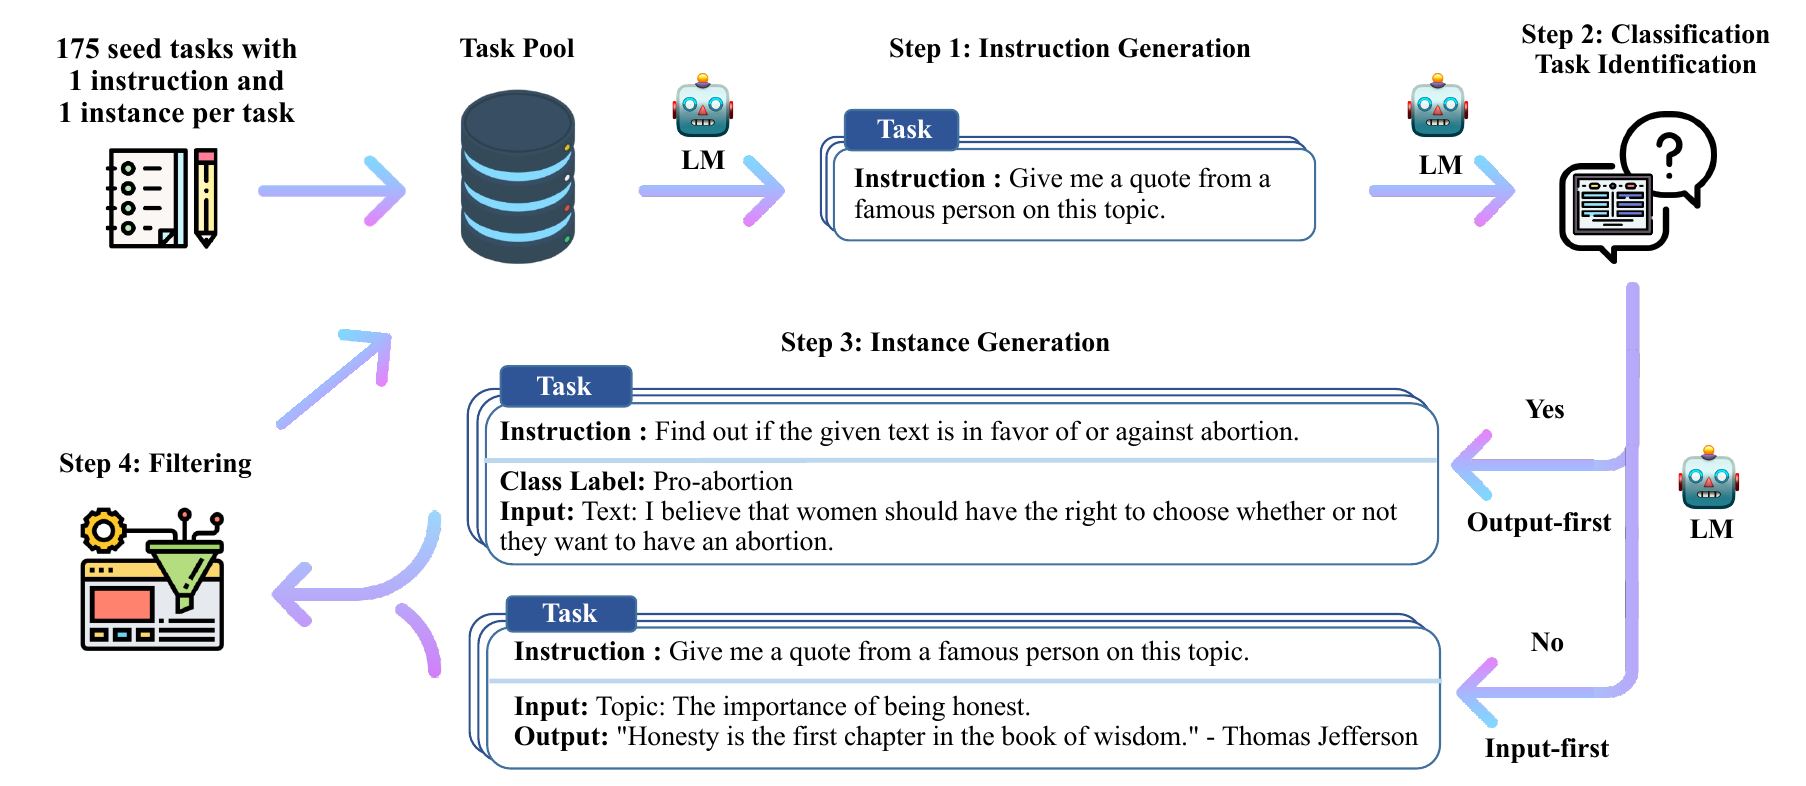
整个流程是一个循环。作者和实验室同事先手写 175 个种子任务,每个一条指令、一组输入输出,放进任务池;接下来四个步骤都交给 GPT-3(OpenAI API 上最大的 davinci),生成的新任务通过过滤后放回任务池,再拿来生成下一批。
步骤一:出新题目
每次从任务池抽 8 条指令当示例,其中 6 条来自人写的种子,2 条来自之前模型生成的任务,请模型接着写出新的指令。混入模型自己的产物,是为了让题目越滚越多样;保留多数人写的种子,则是让质量不至于跑偏。
步骤二:判断是不是分类题
接下来要为每条指令生成输入和输出,而分类题和其他题目的做法不同,所以得先分辨。作者用少样本提示,给模型看 12 条分类指令和 19 条非分类指令,让它判断新指令属于哪一种。这里的分类题,指的是输出只有少数几种标签的任务。
步骤三:生成实例
一般的题目用输入优先,先根据指令写出输入,再写输出。这和平常用模型的顺序一样。
分类题如果也这样做,会出问题。以语法错误检测为例,模型写出来的输入几乎都是语法正确的句子,标签严重偏向一边。所以分类题改用输出优先,先列出可能的标签,再针对每个标签写一个对应的输入。例如「判断这段文字支持还是反对堕胎权」这一题,模型会先定好标签「Pro-abortion」,再生成一段支持堕胎权的文字。
步骤四:过滤
模型会重复自己,所以新指令要和任务池里每一条指令比 ROUGE-L,相似度都低于 0.7 才收。ROUGE-L 看的是两句话的最长公共子序列。以论文流程图里的「Give me a quote from a famous person on this topic.」为例,候选「Give me a famous quote on this topic.」只是把原句换个说法,会被挡下来;「Find out if the given review is positive or negative.」沿用了流程图里另一条指令「Find out if the given text is in favor of or against abortion.」的句型,但任务从立场判断换成了评论的正负面,可以留下来。
其他过滤规则还有:含有 image、picture、graph 这类语言模型处理不了的关键词就丢掉;同一条指令下完全相同的实例,或输入相同、输出却不同的实例也丢掉;再用一些经验规则删掉太长、太短,或输出只是重复输入的生成结果。
微调
数据做好之后,拿它微调生成数据的同一个 GPT-3,通过 OpenAI 的微调 API,提示词部分不计入损失,训练 2 个 epoch。为了让模型不挑格式,指令和输入会用多种模板拼接,例如指令前面加不加「Task:」、输入前面加不加「Input:」、中间空几行。得到的模型称为 GPT3Self-Inst。
生成了什么
最后得到 52,445 条指令、82,439 组实例,其中 11,584 条是分类题,35,878 组实例没有输入。
这些题目和种子差多远?作者算了每条新指令和最相似的种子之间的 ROUGE-L,大多落在 0.2 到 0.45 之间,峰值在 0.3 左右,超过 0.6 的很少,表示多数是种子里没有的新题目。动词和宾语的分布也很分散,最常见的 20 个动词加上各自最常见的 4 个宾语,只占全部指令的 14%。
质量则是另一回事。作者随机抽了 200 条指令、每条一组实例,自己逐一检查:
| 检查项目 | 通过 |
|---|---|
| 指令描述的是一个有效的任务 | 92% |
| 输入适合这条指令 | 79% |
| 输出是正确、可接受的回答 | 58% |
| 三者都没问题 | 54% |
整理自原论文 Table 2。
将近一半的实例有错。作者的看法是,就算内容有错,格式大多是对的,或至少部分正确,对教模型「怎么回应指令」仍然有用。
讨论
SuperNI:差不多追上 InstructGPT001
第一组实验用 SuperNI 的 119 个评测任务,每个 100 条,零样本作答,只给任务定义,看输出和标准答案的 ROUGE-L:
| 模型 | 参数 | ROUGE-L |
|---|---|---|
| GPT-3 | 175B | 6.8 |
| T0 | 11B | 33.1 |
| GPT-3 + T0 训练数据 | 175B | 37.9 |
| GPT3Self-Inst | 175B | 39.9 |
| InstructGPT001 | 175B | 40.8 |
| Tk-Instruct(用 SuperNI 训练) | 11B | 46.0 |
| GPT-3 + SuperNI 训练数据 | 175B | 49.5 |
| GPT3Self-Inst + SuperNI 训练数据 | 175B | 51.6 |
整理自原论文 Table 3。
原本的 GPT-3 几乎不会听指令,常常写出无关或重复的内容,不知道什么时候该停。用自己生成的数据微调之后,ROUGE-L 多了 33.1,和 InstructGPT001 差不到一分;InstructGPT001 用的是私有的用户数据和人类标注。这里只比 001 版,因为更新的版本用过最新的用户数据,很可能看过 SuperNI 的测试集。
用 SuperNI 自己的训练数据当然更强,题目风格和格式都一样。但在 SuperNI 训练数据上再加 Self-Instruct 的数据,还能从 49.5 升到 51.6,说明两种数据可以互补。
真实用途:252 道新题目
SuperNI 的任务大多是为研究设计的,偏重分类。作者另外头脑风暴了一些语言模型可能派上用场的领域,例如写电子邮件、社交媒体、生产力工具、娱乐、编程,针对每个领域写指令,共 252 题。
这些题目很难自动评分,写代码、把一阶逻辑转成自然语言这类题目,普通的众包工作者也评不了。所以由出题的作者自己评,分成四级。A:正确且令人满意;B:可以接受,有小瑕疵;C:有回应指令,但内容有明显错误;D:无关或无效。
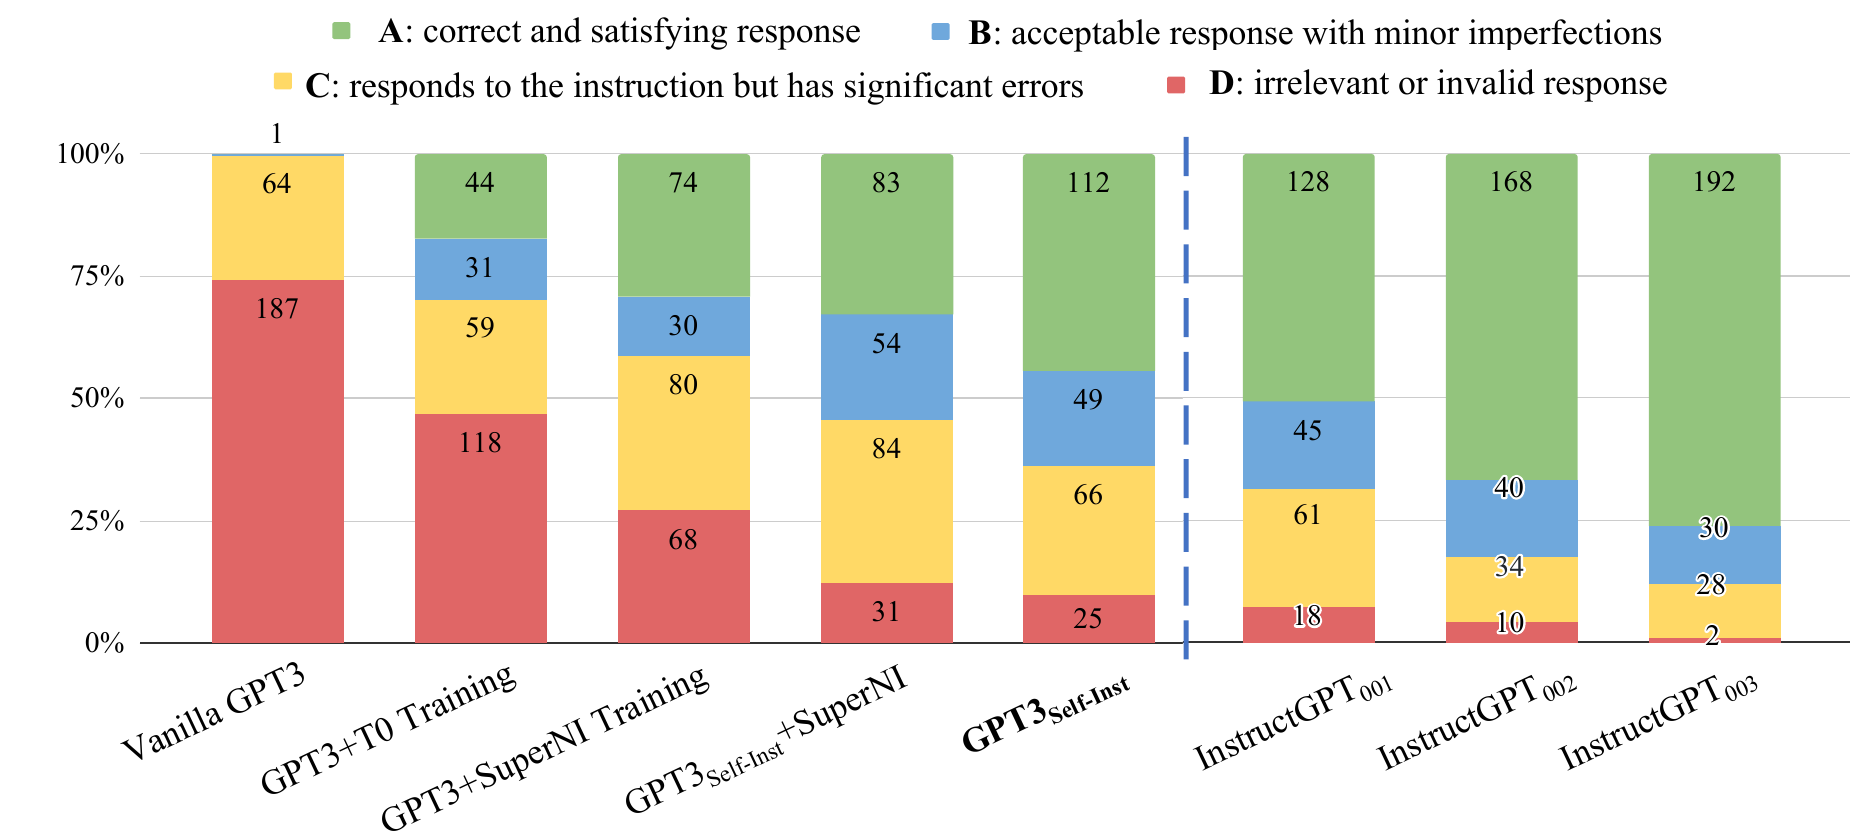
虚线左边是 GPT-3 和它的各种微调版本,右边是 OpenAI 的三代 InstructGPT。每个模型都回答同样的 252 题,GPT3Self-Inst 有 44.4% 被评为 A,InstructGPT001 是 50.8%。
把 B 也算作可用的话,GPT3Self-Inst 是 63.9%,InstructGPT001 是 68.7%,差不到 5 个百分点,这就是摘要说的「只差 5%」。它也明显胜过用 T0 或 SuperNI 数据微调的 GPT-3。不过 InstructGPT002 和 003 就是另一个级别了,003 有超过四分之三的回答被评为 A。
数据越多越好,质量更重要
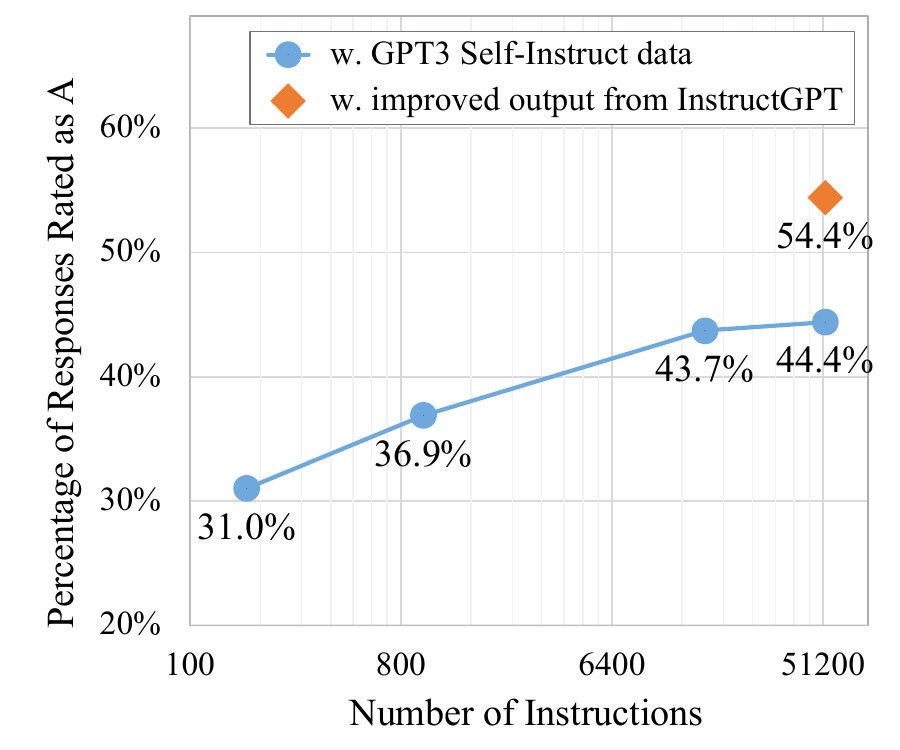
蓝线是拿不同数量的 Self-Instruct 指令微调,评为 A 的比例从 31.0% 升到 44.4%,但过了约 1.6 万条之后就几乎不动了。在 SuperNI 上,饱和得更早,几百条指令就到顶;作者推测是因为这批数据和典型的 NLP 任务差别很大。
橙色那个点更有意思。作者保留所有指令和输入,只把输出改由 InstructGPT003 重写一次,再拿去微调 GPT-3,A 的比例直接跳到 54.4%,多了 10 个百分点。换句话说,是把 InstructGPT003 的能力蒸馏到这批题目上。
这个实验的花费也写在附录里。当时 davinci 每 1,000 个 token 收费 0.02 美元,生成整份数据大约 600 美元;在全部数据上微调 GPT-3,是 338 美元。
局限
作者自己列了三点:
- 长尾:模型擅长的是预训练数据里常见的东西,Self-Instruct 的收获可能也集中在常见的任务上,碰到少见或很有创意的指令就容易失灵。
- 依赖大模型:方法靠的是语言模型本身的归纳偏置,可能只在大模型上有效,计算资源不够的人就用不了。
- 放大偏差:反复自我生成,可能把社会偏见越放越大;分类题的标签难以平衡,也反映了模型原本的偏好。
还有一点值得补充。Self-Instruct 没有给模型带来新知识,题目和答案都出自 GPT-3 本身;它教会的是「看到指令要怎么回应」。只把输出换成 InstructGPT003 重写,评为 A 的比例就从 44.4% 跳到 54.4%,也说明了这一点。
后来的事
三个月后,Stanford 的 Alpaca 把这套流程搬到了 LLaMA 上。他们从同样的 175 个种子出发,改用 text-davinci-003 生成 52,000 条指令示范,生成数据花了不到 500 美元,微调 LLaMA-7B 不到 100 美元。Alpaca 的说明也写得很清楚,它只限学术研究使用,一个原因是 LLaMA 本身是非商业许可,另一个是 OpenAI 的使用条款禁止用它的输出开发和 OpenAI 竞争的模型。
之后,用强模型生成指令数据成了常见做法,手法也越来越讲究。2024 年的 Tülu 3 先准备大量「人设」,再请 GPT-4o 扮演这些人出题,用来增加题目的多样性,和 Self-Instruct 混入模型产物的想法一脉相承。
结论
Self-Instruct 只用 175 个人写的种子任务,就让 GPT-3 生成了 5 万多条指令,微调后在 SuperNI 上追到 InstructGPT001 的水平,在 252 道真实用途的题目上也只差不到 5 个百分点。生成数据大约花了 600 美元,在全部数据上微调 GPT-3 是 338 美元。
想自己做指令数据的话,这篇的四个步骤现在看起来仍然很实用,混入少量模型产物增加多样性、分类题先定标签再写输入、用相似度挡掉重复、再用规则清掉明显的垃圾。最该留意的是质量,作者抽查 200 条,指令、输入、输出三者都没问题的只有 54%,能用,但别太相信。
后来照着做的人,大多只留下这套出题流程,把「自己」换成了更强的老师。Alpaca 改请 text-davinci-003 出题作答,Tülu 3 请 GPT-4o 扮演各种人物出题;论文里只把输出换成 InstructGPT003 重写,A 的比例就多了 10 个百分点,早就暗示了这一步。