原始論文
Self-Instruct: Aligning Language Models with Self-Generated Instructions
- 發表版本
- ACL 2023會議
- arXiv 首次提交
- arXiv:2212.10560
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{modeltuningselfinstruct2022,
  title = {{Self-Instruct: Aligning Language Models with Self-Generated Instructions}},
  author = {Yizhong Wang and Yeganeh Kordi and Swaroop Mishra and Alisa Liu and Noah A. Smith and Daniel Khashabi and Hannaneh Hajishirzi},
  year = {2022},
  eprint = {2212.10560},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2212.10560}
}
指令微調要有指令資料,而那時的指令資料幾乎都是人寫的。
學術界的做法,是把現成的 NLP 資料集改寫成指令,例如 FLAN、T0,或者由研究者一起寫出 1,600 多種任務的 Super-NaturalInstructions(以下簡稱 SuperNI)。業界的 InstructGPT 則用了大量真實使用者的提示,再請標註者寫示範,這些資料一筆也沒有公開。
前者有兩個問題。寫得出來的任務大多是研究者熟悉的分類、問答、摘要,離一般人真正會拿來問模型的事情有一段距離;而且要人想出新任務、再寫出好答案,既要創意也要專業,很難大量做。
2022 年 12 月,華盛頓大學的 Wang 等人想到一個看起來有點偷懶的辦法。既然 GPT-3 什麼都寫得出來,乾脆讓它自己出題、自己作答,再拿這批資料微調它自己。
定義問題
先把指令資料的樣子講清楚。一個任務 有一段指令 ,以及一組或多組輸入與輸出 ,模型要做到 。
指令和輸入的界線常常不明確。「寫一篇關於校園安全的文章」可以整句當指令、不需要輸入;也可以把「寫一篇關於下列主題的文章」當指令,「校園安全」當輸入。作者允許輸入是空的,讓資料格式更多樣。
這篇想回答的是,只靠一個沒做過指令微調的語言模型,加上很少量的人工種子,能不能產生夠好的指令資料,把模型本身教會聽指令?
解決問題
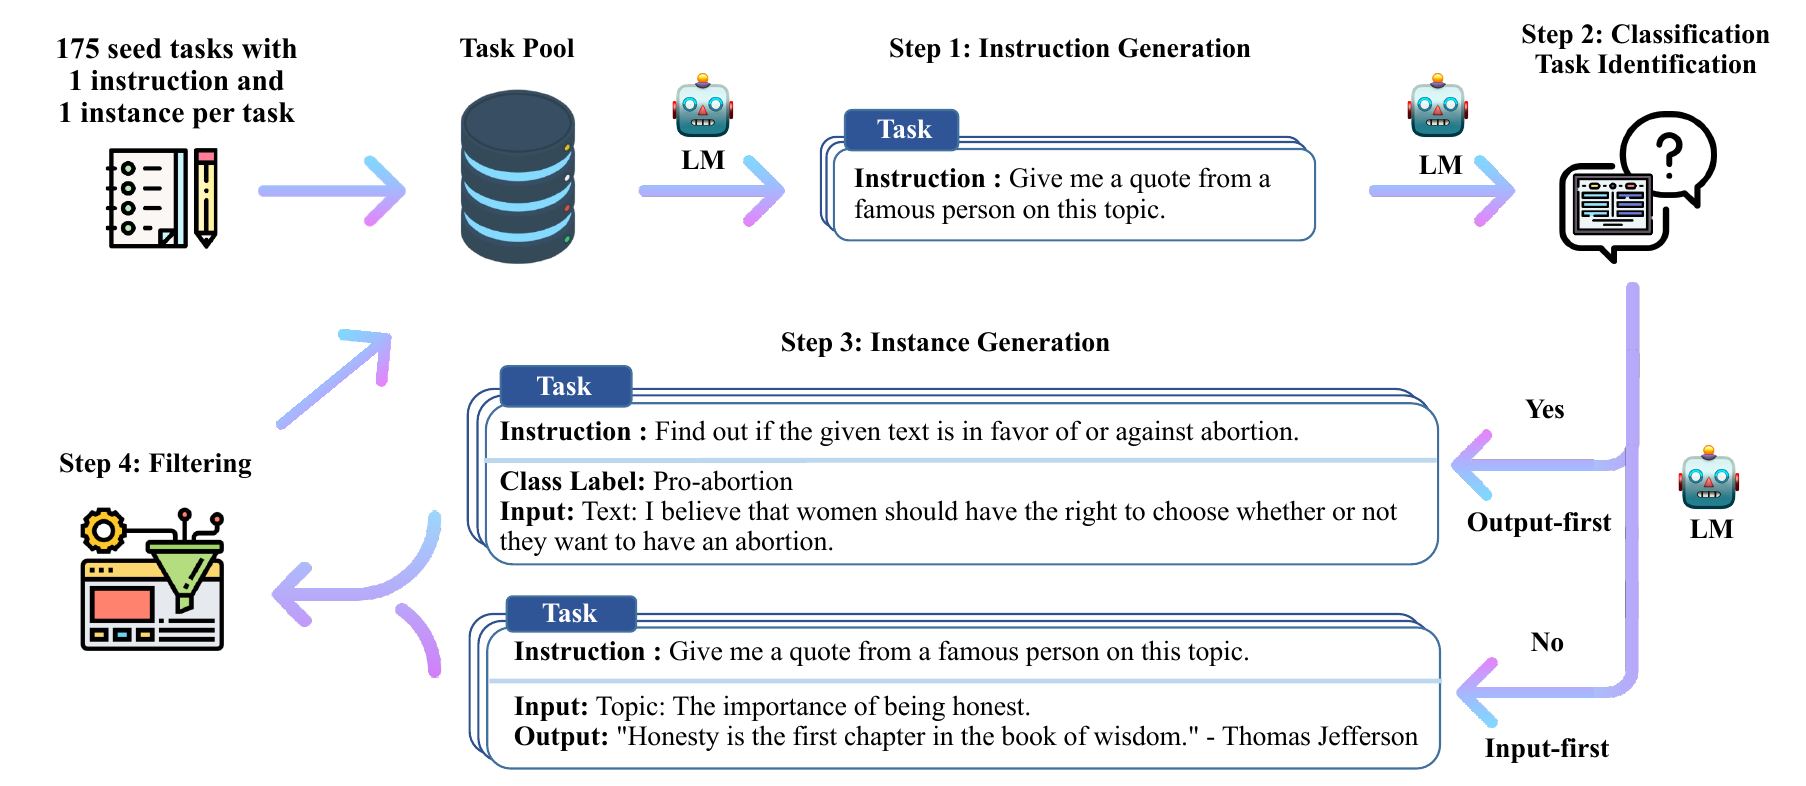
整個流程是一個迴圈。作者和實驗室同事先手寫 175 個種子任務,每個一條指令、一組輸入輸出,放進任務池;接下來四個步驟都交給 GPT-3(OpenAI API 上最大的 davinci),產生的新任務通過過濾後放回任務池,再拿來產生下一批。
步驟一:出新題目
每次從任務池抽 8 條指令當範例,其中 6 條來自人寫的種子,2 條來自之前模型產生的任務,請模型接著寫出新的指令。混入模型自己的產物,是為了讓題目越滾越多樣;保留多數人寫的種子,則是讓品質不至於飄走。
步驟二:判斷是不是分類題
接下來要替每條指令產生輸入和輸出,而分類題和其他題目的做法不同,所以得先分辨。作者用少樣本提示,給模型看 12 條分類指令和 19 條非分類指令,讓它判斷新指令屬於哪一種。這裡的分類題,指的是輸出只有少數幾種標籤的任務。
步驟三:產生範例
一般的題目用輸入優先,先根據指令寫出輸入,再寫輸出。這和平常用模型的順序一樣。
分類題如果也這樣做,會出問題。以文法錯誤偵測為例,模型寫出來的輸入幾乎都是文法正確的句子,標籤嚴重偏向一邊。所以分類題改用輸出優先,先列出可能的標籤,再針對每個標籤寫一個對應的輸入。例如「判斷這段文字支持還是反對墮胎權」這一題,模型會先定好標籤「Pro-abortion」,再生出一段支持墮胎權的文字。
步驟四:過濾
模型會重複自己,所以新指令要和任務池裡每一條指令比 ROUGE-L,相似度都低於 0.7 才收。ROUGE-L 看的是兩句話的最長共同子序列。以論文流程圖裡的「Give me a quote from a famous person on this topic.」為例,候選「Give me a famous quote on this topic.」只是把原句換個說法,會被擋下;「Find out if the given review is positive or negative.」沿用了流程圖裡另一條指令「Find out if the given text is in favor of or against abortion.」的句型,但任務從立場判斷換成評論的正負面,可以留下來。
其他過濾規則還有:含有 image、picture、graph 這類語言模型處理不了的關鍵字就丟掉;同一條指令下完全相同的範例,或輸入相同、輸出卻不同的範例也丟掉;再用一些經驗規則刪掉太長、太短,或輸出只是重複輸入的生成結果。
微調
資料做好之後,拿它微調產生資料的同一個 GPT-3,透過 OpenAI 的微調 API,提示部分不算損失,訓練 2 個 epoch。為了讓模型不挑格式,指令和輸入會用多種模板拼接,例如指令前面加不加「Task:」、輸入前面加不加「Input:」、中間空幾行。得到的模型稱為 GPT3Self-Inst。
產生了什麼
最後得到 52,445 條指令、82,439 組範例,其中 11,584 條是分類題,35,878 組範例沒有輸入。
這些題目和種子差多遠?作者算了每條新指令和最相似的種子之間的 ROUGE-L,大多落在 0.2 到 0.45 之間,峰值在 0.3 左右,超過 0.6 的很少,表示多數是種子裡沒有的新題目。動詞和受詞的分布也很分散,最常見的 20 個動詞加上各自最常見的 4 個受詞,只占全部指令的 14%。
品質則是另一回事。作者隨機抽 200 條指令、每條一組範例,自己逐一檢查:
| 檢查項目 | 通過 |
|---|---|
| 指令描述的是一個有效的任務 | 92% |
| 輸入適合這條指令 | 79% |
| 輸出是正確、可接受的回答 | 58% |
| 三者都沒問題 | 54% |
整理自原論文 Table 2。
將近一半的範例有錯。作者的看法是,就算內容有錯,格式多半是對的,或至少部分正確,對教模型「怎麼回應指令」仍然有用。
討論
SuperNI:差不多追上 InstructGPT001
第一組實驗用 SuperNI 的 119 個評測任務,每個 100 筆,零樣本作答,只給任務定義,看輸出和標準答案的 ROUGE-L:
| 模型 | 參數 | ROUGE-L |
|---|---|---|
| GPT-3 | 175B | 6.8 |
| T0 | 11B | 33.1 |
| GPT-3 + T0 訓練資料 | 175B | 37.9 |
| GPT3Self-Inst | 175B | 39.9 |
| InstructGPT001 | 175B | 40.8 |
| Tk-Instruct(用 SuperNI 訓練) | 11B | 46.0 |
| GPT-3 + SuperNI 訓練資料 | 175B | 49.5 |
| GPT3Self-Inst + SuperNI 訓練資料 | 175B | 51.6 |
整理自原論文 Table 3。
原本的 GPT-3 幾乎不會聽指令,常常寫出無關或重複的內容,不知道什麼時候該停。用自己產生的資料微調之後,ROUGE-L 多了 33.1,和 InstructGPT001 差不到一分;InstructGPT001 用的是私有的使用者資料和人類標註。這裡只比 001 版,因為更新的版本用過最新的使用者資料,很可能看過 SuperNI 的測試集。
用 SuperNI 自己的訓練資料當然比較強,題目風格和格式都一樣。但在 SuperNI 訓練資料上再加 Self-Instruct 的資料,還能從 49.5 升到 51.6,表示兩種資料可以互補。
真實用途:252 道新題目
SuperNI 的任務多半是為研究設計的,偏重分類。作者另外腦力激盪了一些語言模型可能派上用場的領域,例如寫電子郵件、社群媒體、生產力工具、娛樂、寫程式,針對每個領域寫指令,共 252 題。
這些題目很難自動評分,寫程式、把一階邏輯轉成自然語言這類題目,一般的眾包工作者也評不了。所以由出題的作者自己評,分成四級。A:正確且令人滿意;B:可以接受,有小瑕疵;C:有回應指令,但內容有明顯錯誤;D:無關或無效。
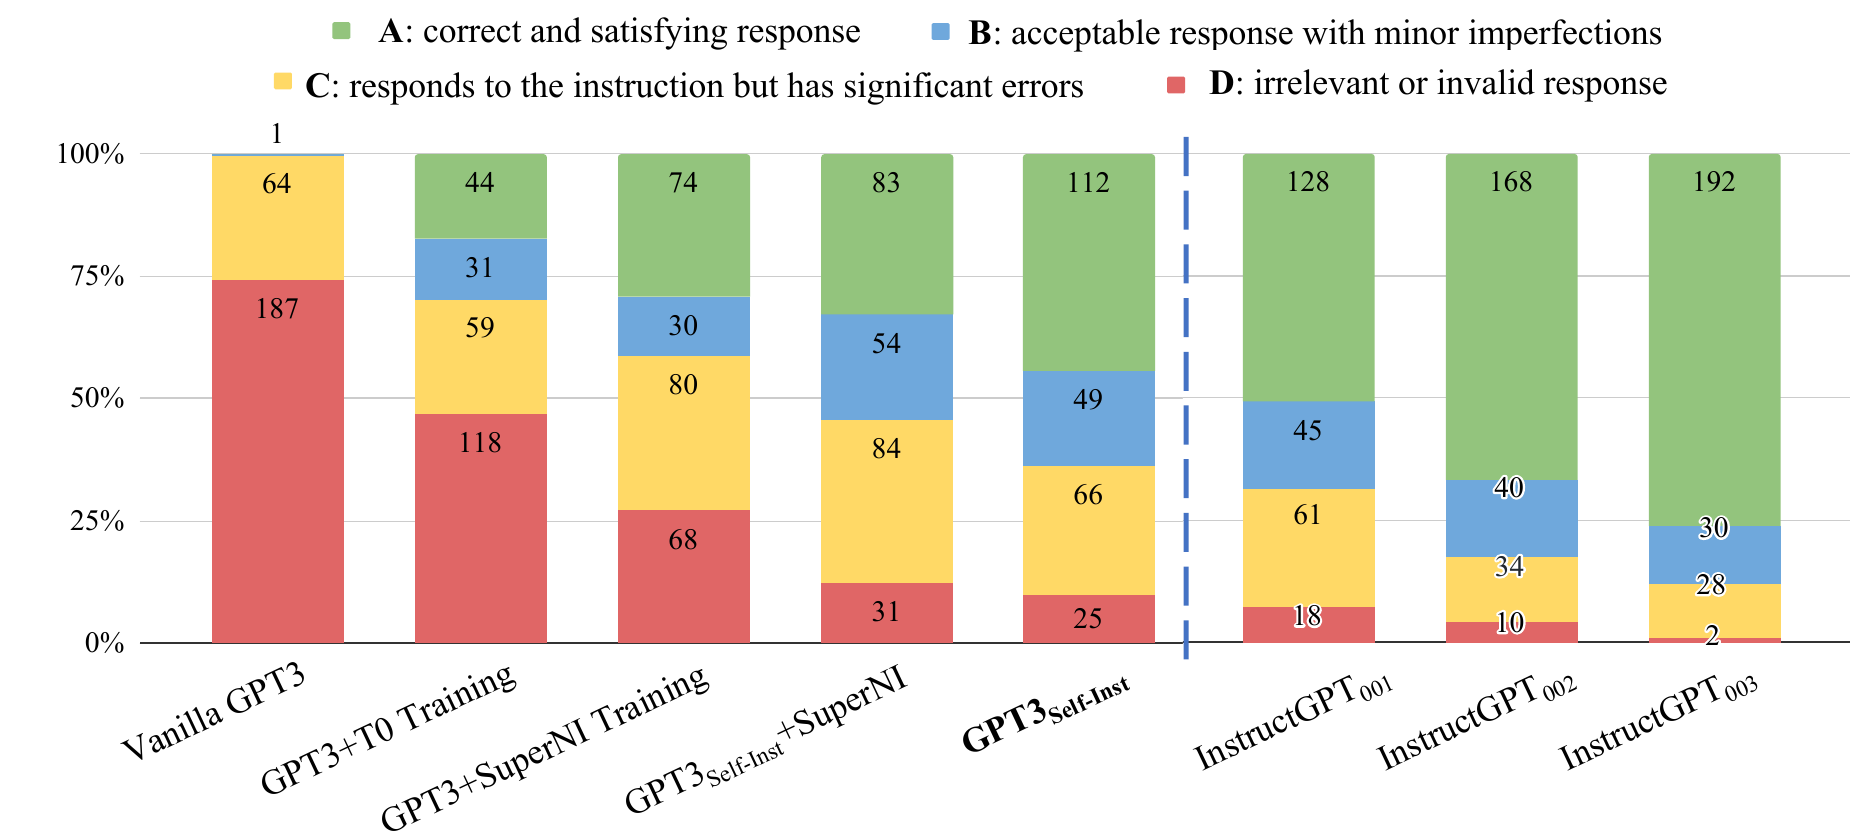
虛線左邊是 GPT-3 和它的各種微調版本,右邊是 OpenAI 的三代 InstructGPT。每個模型都回答同樣的 252 題,GPT3Self-Inst 有 44.4% 被評為 A,InstructGPT001 是 50.8%。
把 B 也算成可用的話,GPT3Self-Inst 是 63.9%,InstructGPT001 是 68.7%,差不到 5 個百分點,這就是摘要說的「只差 5%」。它也明顯勝過用 T0 或 SuperNI 資料微調的 GPT-3。不過 InstructGPT002 和 003 就是另一個等級了,003 有超過四分之三的回答被評為 A。
資料越多越好,品質更重要
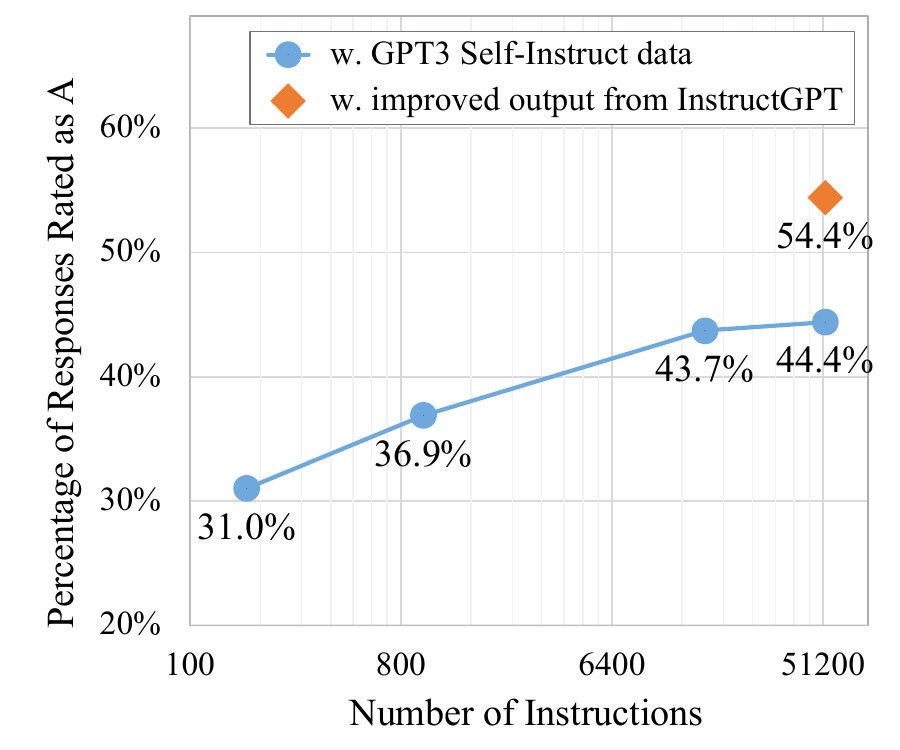
藍線是拿不同數量的 Self-Instruct 指令微調,評為 A 的比例從 31.0% 升到 44.4%,但過了約 1.6 萬條之後就幾乎不動了。在 SuperNI 上,飽和得更早,幾百條指令就到頂;作者推測是因為這批資料和典型的 NLP 任務差很多。
橘色那個點更有意思。作者保留所有指令和輸入,只把輸出改由 InstructGPT003 重寫一次,再拿去微調 GPT-3,A 的比例直接跳到 54.4%,多了 10 個百分點。換句話說,是把 InstructGPT003 的能力蒸餾到這批題目上。
這個實驗的花費也寫在附錄裡。當時 davinci 每 1,000 個 token 收 0.02 美元,產生整份資料大約 600 美元;在全部資料上微調 GPT-3,是 338 美元。
限制
作者自己列了三點:
- 長尾:模型擅長的是預訓練資料裡常見的東西,Self-Instruct 的收穫可能也集中在常見的任務,碰到少見或很有創意的指令就容易失靈。
- 依賴大模型:方法靠的是語言模型本身的歸納偏誤,可能只在大模型上有效,運算資源不夠的人就用不了。
- 放大偏誤:反覆自我生成,可能把社會偏見越放越大;分類題的標籤難以平衡,也反映了模型原本的偏好。
還有一點值得補充。Self-Instruct 沒有替模型帶來新知識,題目和答案都出自 GPT-3 本身;它教會的是「看到指令要怎麼回應」。只把輸出換成 InstructGPT003 重寫,評為 A 的比例就從 44.4% 跳到 54.4%,也說明了這一點。
後來的事
三個月後,Stanford 的 Alpaca 把這套流程搬到 LLaMA 上。他們從同樣的 175 個種子出發,改用 text-davinci-003 產生 52,000 筆指令示範,產生資料花了不到 500 美元,微調 LLaMA-7B 不到 100 美元。Alpaca 的說明也寫得很清楚,它只限學術研究使用,一個原因是 LLaMA 本身是非商業授權,另一個是 OpenAI 的使用條款禁止用它的輸出開發和 OpenAI 競爭的模型。
之後,用強模型產生指令資料成了常見做法,作法也越來越講究。2024 年的 Tülu 3 先準備大量「人物設定」,再請 GPT-4o 扮演這些人出題,用來增加題目的多樣性,和 Self-Instruct 混入模型產物的想法一脈相承。
結論
Self-Instruct 只用 175 個人寫的種子任務,就讓 GPT-3 產生 5 萬多條指令,微調後在 SuperNI 上追到 InstructGPT001 的水準,在 252 道真實用途的題目上也只差不到 5 個百分點。產生資料大約花了 600 美元,在全部資料上微調 GPT-3 是 338 美元。
想自己做指令資料的話,這篇的四個步驟現在看起來仍然很實用,混入少量模型產物增加多樣性、分類題先定標籤再寫輸入、用相似度擋掉重複、再用規則清掉明顯的垃圾。最該留意的是品質,作者抽查 200 條,指令、輸入、輸出三者都沒問題的只有 54%,能用,但別太相信。
後來照著做的人,大多只留下這套出題流程,把「自己」換成了更強的老師。Alpaca 改請 text-davinci-003 出題作答,Tülu 3 請 GPT-4o 扮演各種人物出題;論文裡只把輸出換成 InstructGPT003 重寫,A 的比例就多了 10 個百分點,早就暗示了這一步。