原始论文
DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models
- 发表版本
- 正式发表信息尚未核实
- arXiv 首次提交
- arXiv:2402.03300
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{deepseekdeepseekmath2024,
  title = {{DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models}},
  author = {Zhihong Shao and Peiyi Wang and Qihao Zhu and Runxin Xu and Junxiao Song and Xiao Bi and Haowei Zhang and Mingchuan Zhang and Y. K. Li and Y. Wu and Daya Guo},
  year = {2024},
  eprint = {2402.03300},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2402.03300}
}
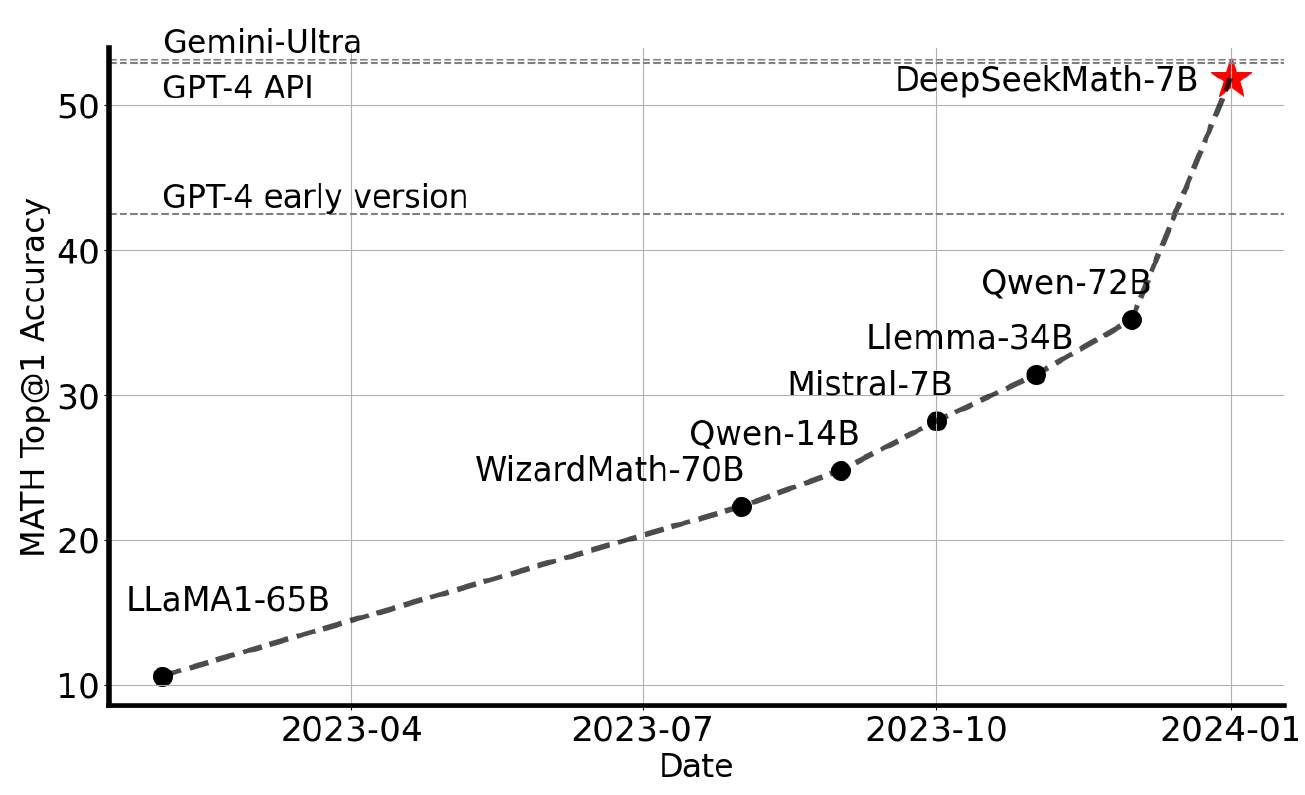
2024 年初,在竞赛数学的评测 MATH 上,GPT-4 和 Gemini Ultra 已经过了 50%,开源模型却还差得很远。这些闭源模型用了什么数据、怎么训练,外界都不清楚。
DeepSeek 的 Shao、Wang、Zhu 等人想做一个开源的数学模型,而且只用 7B 参数。他们做了两件事:从公开的 Common Crawl 网页里,捞出 1,200 亿个 token 的数学数据;再提出一种比 PPO 更省资源的强化学习算法,叫做 GRPO。
结果 DeepSeekMath 7B 不用任何外部工具、不用投票,在 MATH 上拿到 51.7%,接近 Gemini Ultra 和 GPT-4;采样 64 次投票,是 60.9%。
定义问题
这篇要回答两个问题。
第一,好的数学数据从哪里来?现有的数学语料大多来自 arXiv 论文,或是规模不大的网页集合。公开的网页里到底有没有足够多、质量够好的数学内容?
第二,监督微调之后,强化学习还能再推多远?PPO 是当时最常用的做法,但它需要额外训练一个和模型一样大的价值模型,成本很高。
解决问题
一、从 Common Crawl 捞数学网页
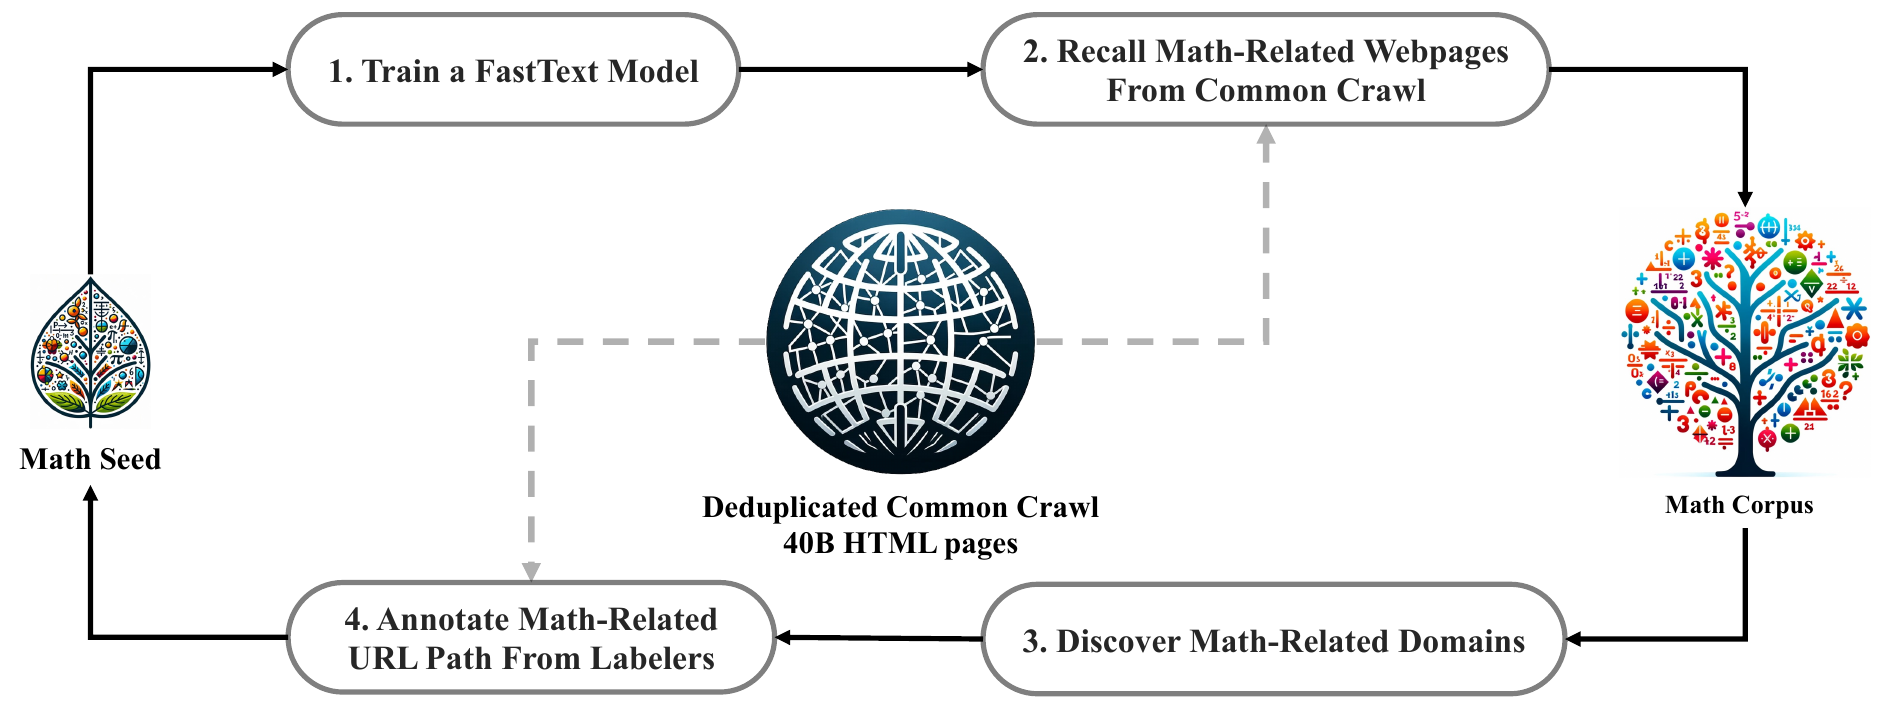
流程是一个循环:
- 训练分类器:拿高质量的数学网页集合 OpenWebMath 当种子,随机取 50 万条当正例,再从 Common Crawl 随机取 50 万个网页当负例,训练一个 fastText 分类器。
- 召回网页:先把 Common Crawl 去重,剩下 400 亿个 HTML 网页。用分类器打分,只保留分数最高的一部分。第一轮保留前 400 亿个 token。
- 找出数学域名:第一轮的分类器只见过 OpenWebMath,正例不够多样,漏掉了很多数学网页。作者把网页按域名分组,如果某个域名有超过 10% 的网页被收进来,就把它当成数学相关的域名,例如 mathoverflow.net。
- 人工标注 URL:在这些域名里,由人标出哪些 URL 路径是数学内容,例如 mathoverflow.net/questions。这些路径下还没被收集的网页,加回种子数据,重新训练分类器。
跑了四轮之后,得到 3,550 万个网页、1,200 亿个 token。第四轮收集到的数据,有将近 98% 在第三轮就已经收过了,于是停止。
为了避免评测题目混进训练数据,只要一段文字和 GSM8K、MATH、CMATH、AGIEval 这些评测的任何子串有连续 10 个词完全相同,就整段删掉;评测文字不到 10 个词、但至少有 3 个词的,则用精确匹配。
数据好不好,用小模型试
作者拿 1.3B 的 DeepSeek-LLM,在各个数学语料上各训练 1,500 亿个 token,比较效果:
| 数学语料 | 大小 | GSM8K | MATH | CMATH |
|---|---|---|---|---|
| 不加数学训练 | - | 2.9 | 3.0 | 12.3 |
| MathPile | 8.9B | 2.7 | 3.3 | 1.2 |
| OpenWebMath | 13.6B | 11.5 | 8.9 | 16.8 |
| Proof-Pile-2 | 51.9B | 14.3 | 11.2 | 19.9 |
| DeepSeekMath Corpus | 120.2B | 23.8 | 13.6 | 41.5 |
整理自原论文 Table 1,节选部分列;少样本思维链,单位为 %。
DeepSeekMath Corpus 在每一项上都领先。它也包含中文的数学网页,所以中文的 CMATH 提升特别多;只收英文的语料,在中文评测上几乎没有帮助,MathPile 甚至让 CMATH 从 12.3% 掉到 1.2%。
另一个优势是大。其他语料比较小,训练 1,500 亿个 token 要重复看好几遍,模型的表现很快就饱和了。
DeepSeekMath-Base 7B
基底模型从 DeepSeek-Coder-Base-v1.5 7B 开始,继续训练 5,000 亿个 token。数据的比例是 56% DeepSeekMath Corpus、4% 数学代码 AlgebraicStack、10% arXiv、20% GitHub 代码、10% 中英文的通用网页。
| 模型 | 大小 | GSM8K | MATH |
|---|---|---|---|
| Minerva | 540B | 58.8 | 33.6 |
| Mistral | 7B | 40.3 | 14.3 |
| Llemma | 34B | 54.0 | 25.3 |
| DeepSeekMath-Base | 7B | 64.2 | 36.2 |
整理自原论文 Table 2,节选部分行与列;少样本思维链,单位为 %。
在 MATH 上,DeepSeekMath-Base 比其他开源的基底模型高出 10 个百分点以上,也超过了 Google 的 Minerva 540B。Minerva 建立在 PaLM 上,又加训了数学数据,参数量是 DeepSeekMath 的 77 倍。
数学训练也让通用能力变好了。和起点的 DeepSeek-Coder-Base-v1.5 相比,MMLU 从 42.9% 升到 54.9%,BBH 从 42.9% 升到 59.5%;因为训练数据里还有代码,写代码的能力大致保住了。
先学代码,再学数学
「学写代码能提升推理能力」是一个常听到、但没被好好验证过的说法。作者用 1.3B 的模型做了对照实验:
| 训练方式 | GSM8K | MATH | GSM8K(用 Python) | MATH(用 Python) |
|---|---|---|---|---|
| 通用文本 400B → 数学 150B | 19.1 | 14.4 | 14.3 | 6.7 |
| 代码 400B → 数学 150B | 21.9 | 15.3 | 17.4 | 9.4 |
| 只训练数学 150B | 20.5 | 13.1 | 11.4 | 6.5 |
| 代码 400B 和数学 150B 混在一起 | 17.6 | 12.1 | 19.7 | 13.5 |
整理自原论文 Table 6,节选部分行与列;单位为 %。
先学代码再学数学,不管用不用 Python 解题,都比先学通用文本好。这也是作者选择从代码模型开始训练的原因。
把代码和数学混在一起训练,用 Python 解题的能力最好,也比较不会忘记怎么写代码;但不用工具时的数学推理反而变差。作者猜测是 1.3B 的模型太小,难以同时吸收两种数据。
arXiv 论文没有帮助:数学语料常常包含 arXiv 论文,但作者发现,只用 arXiv 训练,不管是 1.3B 还是 7B 的模型,在各种数学评测上都没有明显进步,有时还会退步。作者也提醒这个结论有局限:可能只是这些评测测不出来,和其他数据混合、或模型更大时,结果也可能不同。
监督微调
数学指令数据有 77.6 万条,涵盖中英文、从小学到大学水平的题目。解答有三种格式:思维链、程序思维(写 Python 程序求解),以及自然语言推理和代码工具交替使用的格式。训练 500 步,批大小 256,学习率 ,得到 DeepSeekMath-Instruct 7B,MATH 在不用工具时是 46.8%,用工具时是 57.4%。
二、GRPO:拿掉价值模型
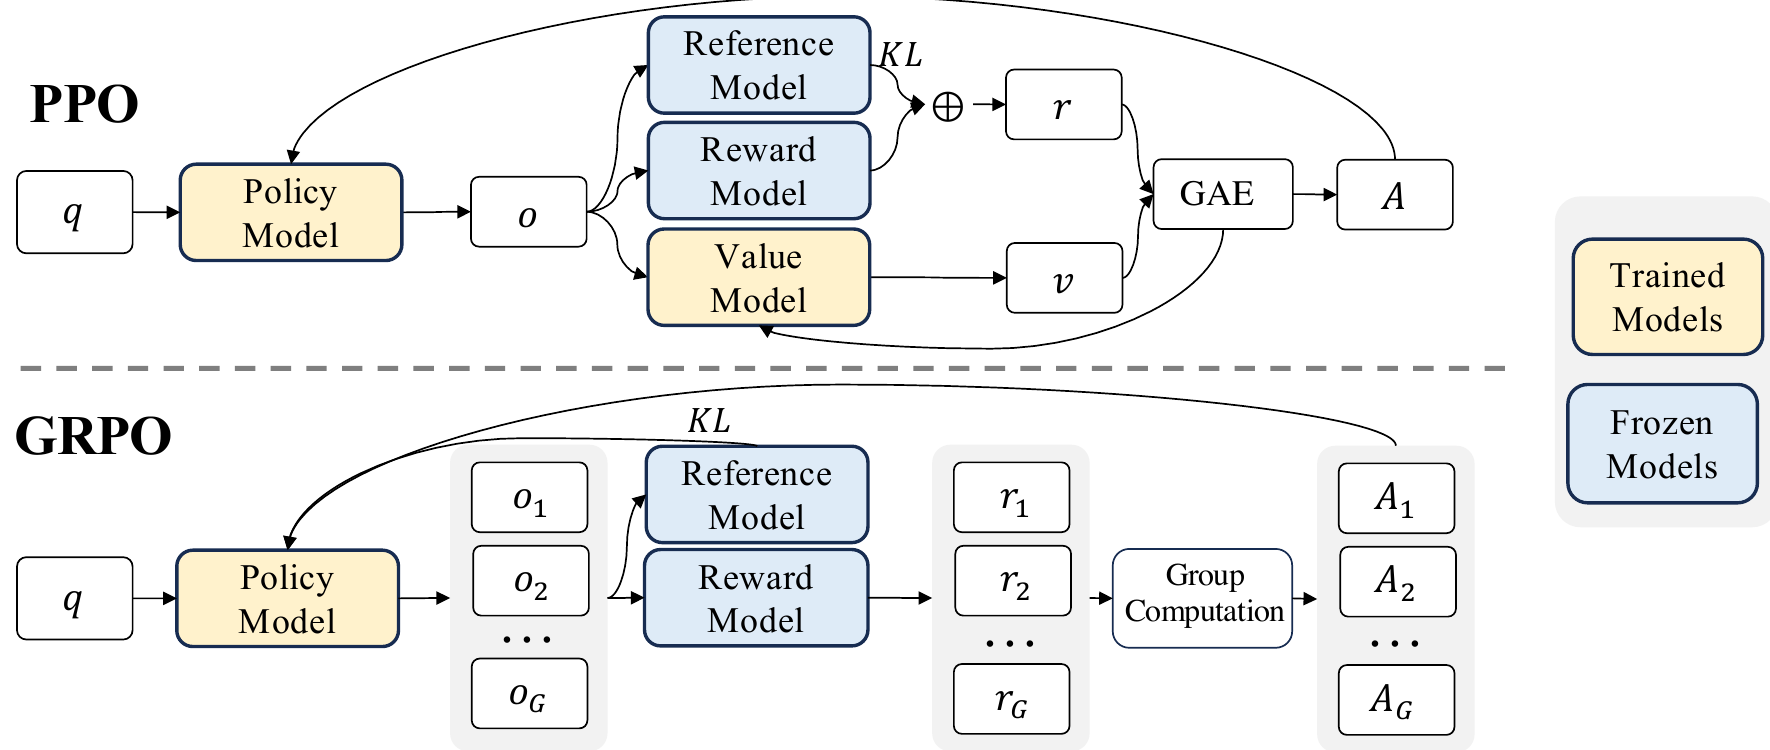
PPO 的目标是:
其中优势 要用 GAE 计算,需要一个学出来的价值函数。这个价值模型通常和策略模型一样大,显存和计算量都要多一倍。而且语言模型的奖励通常只在最后一个 token 给出,要训练一个在每个 token 上都准确的价值函数,本身就很难。
GRPO 的想法很直接。同一道题,让模型写 个回答,用这组回答的平均奖励作为基准,比平均好的就鼓励,比平均差的就惩罚,不再需要价值模型:
这里 是新旧策略在第 个回答第 个 token 上的概率比。
结果监督下,奖励模型给每个回答打一个分数,再用组内的均值和标准差做标准化,这个回答里的每个 token 都用同一个值作为优势:
用答对 1 分、答错 0 分的奖励算算看:
import statistics

def group_advantages(rewards, eps=1e-8):
    """GRPO 的结果监督:同一题的 G 个回答,用组内的均值和标准差把奖励标准化"""
    mean = statistics.mean(rewards)
    std = statistics.pstdev(rewards)          # 这里用总体标准差
    return [round((r - mean) / (std + eps), 2) for r in rewards]

# 同一题采样 8 个回答,答对得 1 分、答错得 0 分
for rewards in ([1, 0, 0, 1, 0, 0, 0, 0], [1, 1, 1, 1, 1, 1, 1, 0], [1] * 8):
    print(rewards, "→", group_advantages(rewards))

# [1, 0, 0, 1, 0, 0, 0, 0] → [1.73, -0.58, -0.58, 1.73, -0.58, -0.58, -0.58, -0.58]
# [1, 1, 1, 1, 1, 1, 1, 0] → [0.38, 0.38, 0.38, 0.38, 0.38, 0.38, 0.38, -2.65]
# [1, 1, 1, 1, 1, 1, 1, 1] → [0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0]
难题里少数答对的回答,得到很大的正优势;简单题里唯一答错的那个,被重重惩罚。全部答对(或全部答错)的题目,每个回答的优势都是 0,这一题对训练没有任何贡献,采样的计算等于白花了。
过程监督下,过程奖励模型给每个回答的每一步打分,同样用全部步骤分数的均值和标准差做标准化。一个 token 的优势,是它之后所有步骤的标准化分数之和。
KL 的处理也不一样。PPO 把 KL 惩罚加在每个 token 的奖励里;GRPO 直接把 KL 加在损失函数上,避免干扰优势的计算。KL 用的是下面这个估计量,它是无偏的,而且不会小于 0:
和直接用两个概率的对数比相比:
import math

def kl_estimate(p_theta, p_ref):
    """原论文式 (4):π_ref/π_θ − log(π_ref/π_θ) − 1,不会小于 0"""
    ratio = p_ref / p_theta
    return ratio - math.log(ratio) - 1

for p_theta, p_ref in [(0.5, 0.5), (0.6, 0.5), (0.4, 0.5), (0.9, 0.3)]:
    print(f"π_θ={p_theta}  π_ref={p_ref}  log(π_θ/π_ref)={math.log(p_theta / p_ref):+.3f}  式(4)={kl_estimate(p_theta, p_ref):.3f}")

# π_θ=0.5  π_ref=0.5  log(π_θ/π_ref)=+0.000  式(4)=0.000
# π_θ=0.6  π_ref=0.5  log(π_θ/π_ref)=+0.182  式(4)=0.016
# π_θ=0.4  π_ref=0.5  log(π_θ/π_ref)=-0.223  式(4)=0.027
# π_θ=0.9  π_ref=0.3  log(π_θ/π_ref)=+1.099  式(4)=0.432
对数比有正有负,单个 token 的估计可能是负的;式 (4) 在两个分布一样时是 0,其他时候都是正的,差距越大,值越大。
迭代式 GRPO:训练久了,旧的奖励模型可能跟不上策略模型。作者用策略模型新的采样结果生成新的奖励模型训练数据,加上 10% 的旧数据一起继续训练奖励模型,再把参考模型换成当前的策略模型,继续训练。
训练设置
- 数据:只用 SFT 数据里和 GSM8K、MATH 相关、思维链格式的约 14.4 万道题。其他题目刻意不用,以便观察强化学习对没训练过的评测有什么影响。
- 奖励模型:按 Math-Shepherd 的方式构建训练数据,从 DeepSeekMath-Base 7B 开始训练,学习率 。
- 策略模型:学习率 ,KL 系数 0.04,每题采样 64 个回答,最长 1,024 个 token,批大小 1,024;每次采样之后只更新一次。
讨论
结果
| 模型 | GSM8K | MATH | MGSM-zh | CMATH |
|---|---|---|---|---|
| Gemini Ultra | 94.4 | 53.2 | - | - |
| GPT-4 | 92.0 | 52.9 | - | 86.0 |
| DeepSeek-LLM-Chat 67B | 84.1 | 32.6 | 74.0 | 80.3 |
| Instruct 7B | 82.9 | 46.8 | 73.2 | 84.6 |
| RL 7B | 88.2 | 51.7 | 79.6 | 88.8 |
整理自原论文 Table 5 中思维链、不用工具的部分,节选部分行;Instruct 7B 和 RL 7B 是 DeepSeekMath 的两个 7B 模型;单位为 %。
GRPO 让 GSM8K 从 82.9% 升到 88.2%,MATH 从 46.8% 升到 51.7%,超过了 7B 到 70B 的所有开源模型,也超过了大部分闭源模型,只是仍略低于 GPT-4 和 Gemini Ultra。
强化学习只用了 GSM8K 和 MATH 的英文题目,但中文的 MGSM-zh 和 CMATH 也一起进步了。允许用工具时,MATH 从 57.4% 升到 58.8%,同样有进步,尽管强化学习的数据全是思维链格式。
一个统一的视角
作者把各种微调方法写成同一个形式。它们的梯度都长这样:
差别只在三个地方:数据来源 (题目和回答从哪里来)、奖励函数 (信号从哪里来),以及梯度系数 (每个 token 该鼓励或惩罚多少)。
- SFT:人准备的数据,每个 token 的系数都是 1。
- 拒绝采样微调(RFT):用 SFT 模型自己采样,只留答对的,答对系数是 1、答错是 0。这和 STaR 的筛选是同一回事。
- 在线 RFT:同样的规则,但改从正在训练的模型采样。
- DPO:用 SFT 模型采样成对的回答,用成对的损失训练。
- PPO 和 GRPO:从正在训练的模型采样,系数由奖励决定,可正可负,大小也不同。
在 1.3B 的 Instruct 模型上比较这几种方法,作者得到几个观察:
- 在线采样比离线好:在线 RFT 一开始和 RFT 差不多,训练到后期明显胜出,因为模型和 SFT 模型的差距越来越大,自己采样的数据才跟得上。
- 惩罚错的比只鼓励对的好:GRPO 胜过在线 RFT。在线 RFT 不惩罚错的回答,对所有答对的回答也都一视同仁;GRPO 会根据奖励的大小调整鼓励和惩罚的力度。
- 过程监督比结果监督好:GRPO 搭配过程监督,胜过搭配结果监督。
- 迭代有用:这一项改在 7B 的 Instruct 模型上做,迭代式强化学习明显提升了表现,尤其是第一轮。
强化学习到底改变了什么
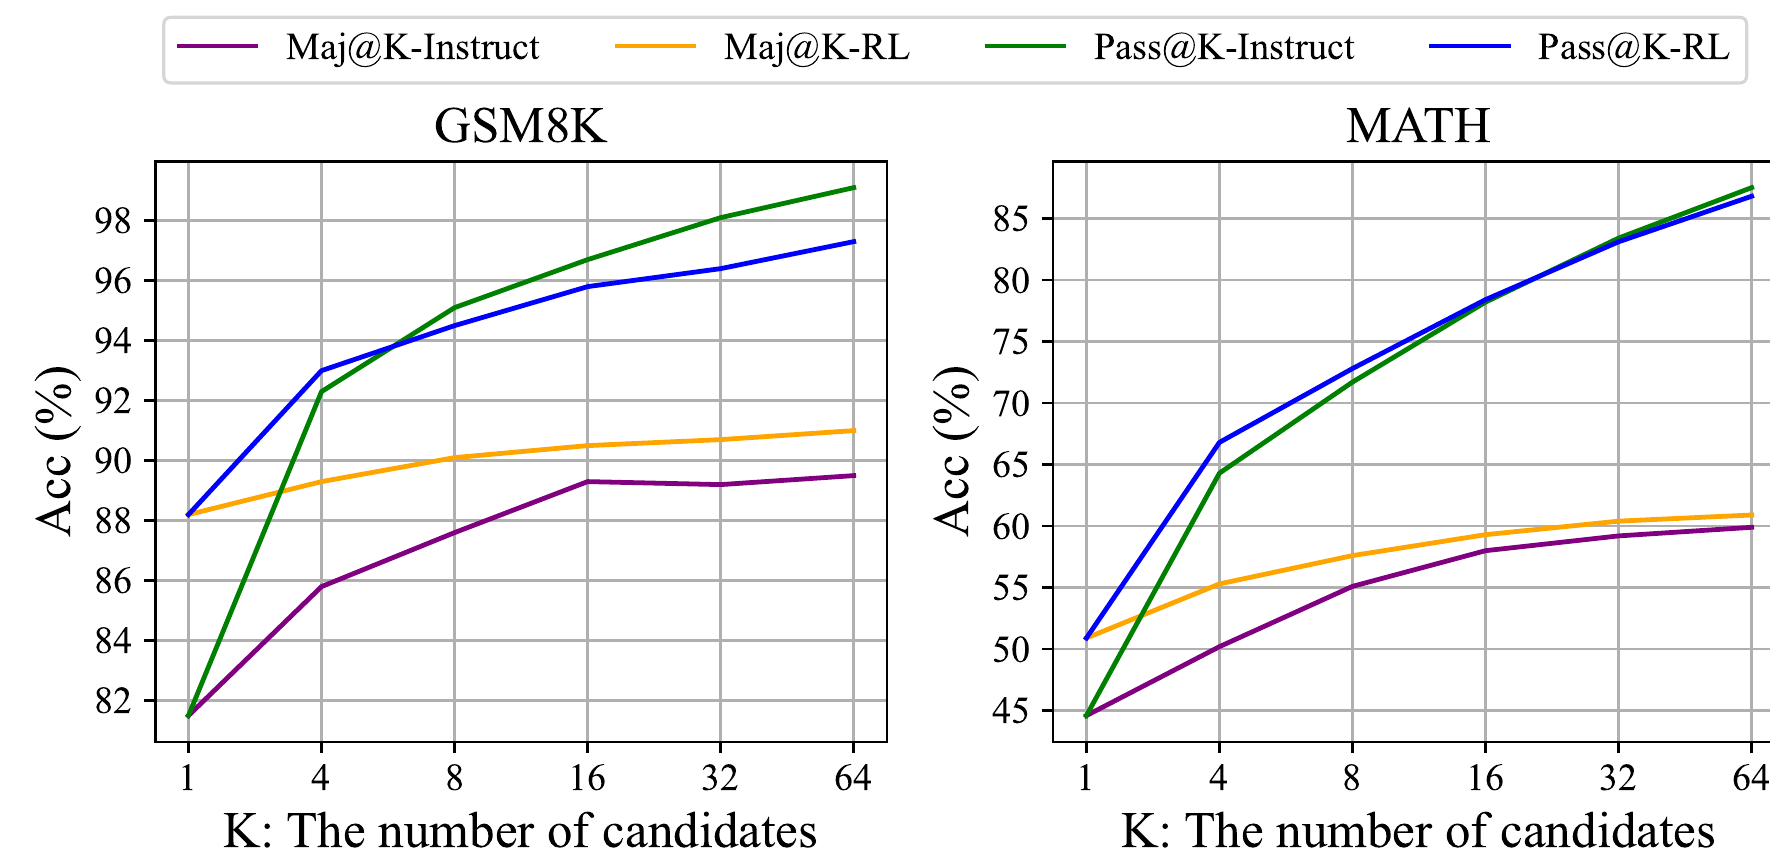
这张图是整篇最值得细看的。Maj@K 是采样 次、投票选出的答案对不对;Pass@K 是采样 次、只要有一次答对就算对。
强化学习提升了 Maj@K,却没有提升 Pass@K。采样次数足够多时,原本的 Instruct 模型也能答对同样多的题目。作者的解读是,强化学习让输出的分布更稳定,把原本就排在前几名的正确答案推到最前面;它没有让模型学会原本完全不会的题目。
作者在结尾也提到,他们只用了 SFT 阶段的题目和最简单的 nucleus 采样,这可能是只有 Maj@K 进步的原因。未来想试试分布外的题目、搭配树搜索等更进阶的采样方式。
限制
- 几何和证明比较弱:模型处理不了三角形、椭圆相关的题目,作者认为可能是预训练和微调数据的选择有偏差。
- 少样本能力不如 GPT-4:GPT-4 给了示例会进步,DeepSeekMath 给不给示例都差不多,作者归因于模型规模。
- 奖励信号不可靠:现有的方法都完全相信奖励模型的信号,但就连人工仔细标注的 PRM800K,也被发现大约有 20% 的标注是错的。作者认为需要能承受噪声奖励的强化学习算法。
后来的事
不到一年后,DeepSeek-R1 用的就是 GRPO,但把奖励换成了简单的规则:答案对不对、格式对不对。不用神经网络的奖励模型,也就没有奖励模型被钻漏洞的问题。DeepSeek-R1-Zero 甚至跳过监督微调,直接从基底模型开始强化学习。GRPO 之后成了开源推理模型最常用的强化学习算法之一。
GRPO 本身也被仔细检查过。2025 年 3 月的 Dr. GRPO 指出,GRPO 的目标函数有一个优化上的偏差,会在训练中人为地拉长回答,错误的回答尤其明显,并提出了一个无偏的修正版本。
Figure 7 的观察,一年后也被放大检验了。2025 年 4 月,Yue 等人在 Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model? 里,用更大的 比较强化学习前后的模型: 小的时候,强化学习后的模型更好; 大的时候,基底模型的 pass@k 反而更高。他们的结论是,这类强化学习得到的推理能力,来自基底模型,也受限于基底模型。这和这篇论文自己在 2024 年画出的那张图,说的是同一件事。
结论
DeepSeekMath 用 7B 的参数,在 MATH 上不用工具、不投票拿到 51.7%,接近当时的 GPT-4。功劳分成两半:一半是从 Common Crawl 迭代捞出的 1,200 亿个 token 的数学网页,一半是拿掉价值模型、用同一题的一组回答互相比较的 GRPO。
这篇的分析部分常被忽略,其实很有分量。先学代码比较好、arXiv 没什么用、在线采样胜过离线、惩罚错的比只奖励对的有效,都是后来的人反复用到的经验。
最诚实的是 Figure 7。作者自己画了出来,强化学习只提升了投票的准确率,没有提升「至少答对一次」的比例,并老老实实写下:进步可能来自把正确答案往前推,而不是能力变强。一年后,整个领域花了不少力气,又重新确认了一次这件事。