原始論文
DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models
- 發表版本
- 正式發表資訊尚未核實
- arXiv 首次提交
- arXiv:2402.03300
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{deepseekdeepseekmath2024,
  title = {{DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models}},
  author = {Zhihong Shao and Peiyi Wang and Qihao Zhu and Runxin Xu and Junxiao Song and Xiao Bi and Haowei Zhang and Mingchuan Zhang and Y. K. Li and Y. Wu and Daya Guo},
  year = {2024},
  eprint = {2402.03300},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2402.03300}
}
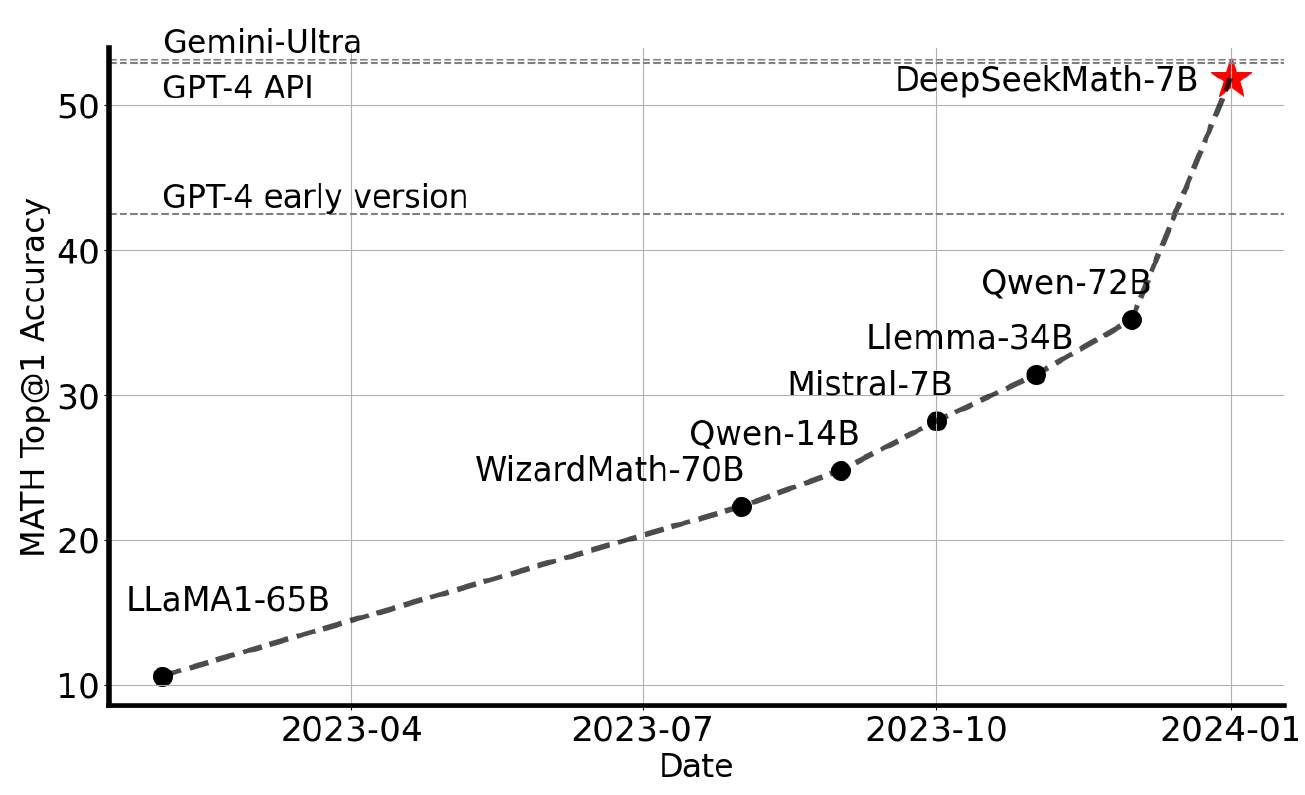
2024 年初,競賽數學的評測 MATH 上,GPT-4 和 Gemini Ultra 已經過了 50%,開源模型卻還差得很遠。這些封閉模型用了什麼資料、怎麼訓練,外界都不清楚。
DeepSeek 的 Shao、Wang、Zhu 等人想做一個開源的數學模型,而且只用 7B 參數。他們做了兩件事:從公開的 Common Crawl 網頁裡,撈出 1,200 億個 token 的數學資料;再提出一種比 PPO 省資源的強化學習演算法,叫做 GRPO。
結果 DeepSeekMath 7B 不用任何外部工具、不用投票,在 MATH 上拿到 51.7%,接近 Gemini Ultra 和 GPT-4;取樣 64 次投票,是 60.9%。
定義問題
這篇要回答兩個問題。
第一,好的數學資料從哪裡來?現有的數學語料大多來自 arXiv 論文,或是規模不大的網頁集合。公開的網頁裡到底有沒有足夠多、品質夠好的數學內容?
第二,監督式微調之後,強化學習能再推多遠?PPO 是當時最常用的做法,但它需要額外訓練一個和模型一樣大的價值模型,成本很高。
解決問題
一、從 Common Crawl 撈數學網頁
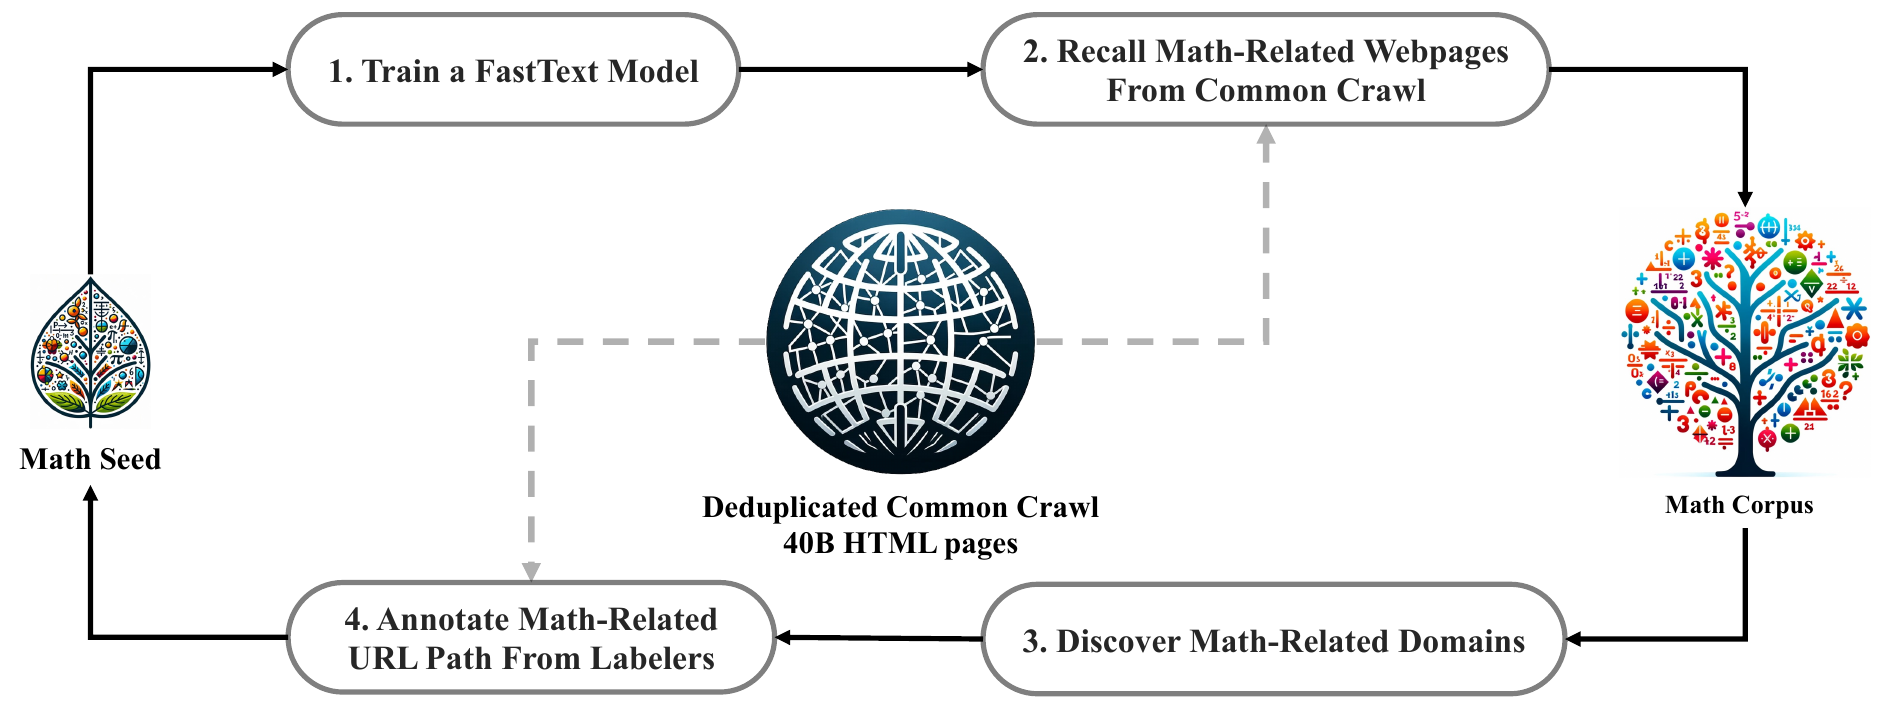
流程是一個迴圈:
- 訓練分類器:拿高品質的數學網頁集合 OpenWebMath 當種子,隨機取 50 萬筆當正例,再從 Common Crawl 隨機取 50 萬個網頁當負例,訓練一個 fastText 分類器。
- 召回網頁:先把 Common Crawl 去重,剩下 400 億個 HTML 網頁。用分類器打分,只保留分數最高的一部分。第一輪保留前 400 億個 token。
- 找出數學網域:第一輪的分類器只看過 OpenWebMath,正例不夠多樣,漏掉了很多數學網頁。作者把網頁按網域分組,如果某個網域有超過 10% 的網頁被收進來,就把它當成數學相關的網域,例如 mathoverflow.net。
- 人工標註網址:在這些網域裡,由人標出哪些網址路徑是數學內容,例如 mathoverflow.net/questions。這些路徑下還沒被收集的網頁,加回種子資料,重新訓練分類器。
跑了四輪之後,得到 3,550 萬個網頁、1,200 億個 token。第四輪收集到的資料,有將近 98% 在第三輪就已經收過了,於是停止。
為了避免評測題目混進訓練資料,只要一段文字和 GSM8K、MATH、CMATH、AGIEval 這些評測的任何子字串有連續 10 個詞完全相同,就整段刪掉;評測文字不到 10 個詞、但至少有 3 個詞的,則用完全比對。
資料好不好,用小模型試
作者拿 1.3B 的 DeepSeek-LLM,在各個數學語料上各訓練 1,500 億個 token,比較效果:
| 數學語料 | 大小 | GSM8K | MATH | CMATH |
|---|---|---|---|---|
| 不加數學訓練 | - | 2.9 | 3.0 | 12.3 |
| MathPile | 8.9B | 2.7 | 3.3 | 1.2 |
| OpenWebMath | 13.6B | 11.5 | 8.9 | 16.8 |
| Proof-Pile-2 | 51.9B | 14.3 | 11.2 | 19.9 |
| DeepSeekMath Corpus | 120.2B | 23.8 | 13.6 | 41.5 |
整理自原論文 Table 1,節錄部分欄;少樣本思維鏈,單位為 %。
DeepSeekMath Corpus 在每一項都領先。它也包含中文的數學網頁,所以中文的 CMATH 提升特別多;只收英文的語料,在中文評測上幾乎沒有幫助,MathPile 甚至讓 CMATH 從 12.3% 掉到 1.2%。
另一個優勢是大。其他語料比較小,訓練 1,500 億個 token 要重複看好幾遍,模型的表現很快就飽和了。
DeepSeekMath-Base 7B
基礎模型從 DeepSeek-Coder-Base-v1.5 7B 開始,繼續訓練 5,000 億個 token。資料的比例是 56% DeepSeekMath Corpus、4% 數學程式碼 AlgebraicStack、10% arXiv、20% GitHub 程式碼、10% 中英文的一般網頁。
| 模型 | 大小 | GSM8K | MATH |
|---|---|---|---|
| Minerva | 540B | 58.8 | 33.6 |
| Mistral | 7B | 40.3 | 14.3 |
| Llemma | 34B | 54.0 | 25.3 |
| DeepSeekMath-Base | 7B | 64.2 | 36.2 |
整理自原論文 Table 2,節錄部分列與欄;少樣本思維鏈,單位為 %。
在 MATH 上,DeepSeekMath-Base 比其他開源的基礎模型高出 10 個百分點以上,也超過 Google 的 Minerva 540B。Minerva 建立在 PaLM 上,又加訓練了數學資料,參數是 DeepSeekMath 的 77 倍。
數學訓練也讓一般能力變好。和起點的 DeepSeek-Coder-Base-v1.5 相比,MMLU 從 42.9% 升到 54.9%,BBH 從 42.9% 升到 59.5%;因為訓練資料裡還有程式碼,寫程式的能力大致保住了。
先學程式,再學數學
「學寫程式能提升推理能力」是一個常聽到、但沒被好好驗證的說法。作者用 1.3B 的模型做了對照實驗:
| 訓練方式 | GSM8K | MATH | GSM8K(用 Python) | MATH(用 Python) |
|---|---|---|---|---|
| 一般文字 400B → 數學 150B | 19.1 | 14.4 | 14.3 | 6.7 |
| 程式 400B → 數學 150B | 21.9 | 15.3 | 17.4 | 9.4 |
| 只訓練數學 150B | 20.5 | 13.1 | 11.4 | 6.5 |
| 程式 400B 和數學 150B 混在一起 | 17.6 | 12.1 | 19.7 | 13.5 |
整理自原論文 Table 6,節錄部分列與欄;單位為 %。
先學程式再學數學,不管用不用 Python 解題,都比先學一般文字好。這也是作者選擇從程式模型開始訓練的原因。
把程式和數學混在一起訓練,用 Python 解題的能力最好,也比較不會忘記怎麼寫程式;但不用工具時的數學推理反而變差。作者猜測是 1.3B 的模型太小,同時吸收兩種資料有困難。
arXiv 論文沒有幫助:數學語料常常包含 arXiv 論文,但作者發現,只用 arXiv 訓練,不管是 1.3B 還是 7B 的模型,在各種數學評測上都沒有明顯進步,有時還退步。作者也提醒這個結論有限制:可能只是這些評測量不到,和其他資料混合、或模型更大時,結果也可能不同。
監督式微調
數學指令資料有 77.6 萬筆,涵蓋中英文、從小學到大學程度的題目。解答有三種格式:思維鏈、程式思維(寫 Python 程式求解),以及自然語言推理和程式工具交替使用的格式。訓練 500 步,batch 256,學習率 ,得到 DeepSeekMath-Instruct 7B,MATH 在不用工具時是 46.8%,用工具時是 57.4%。
二、GRPO:拿掉價值模型
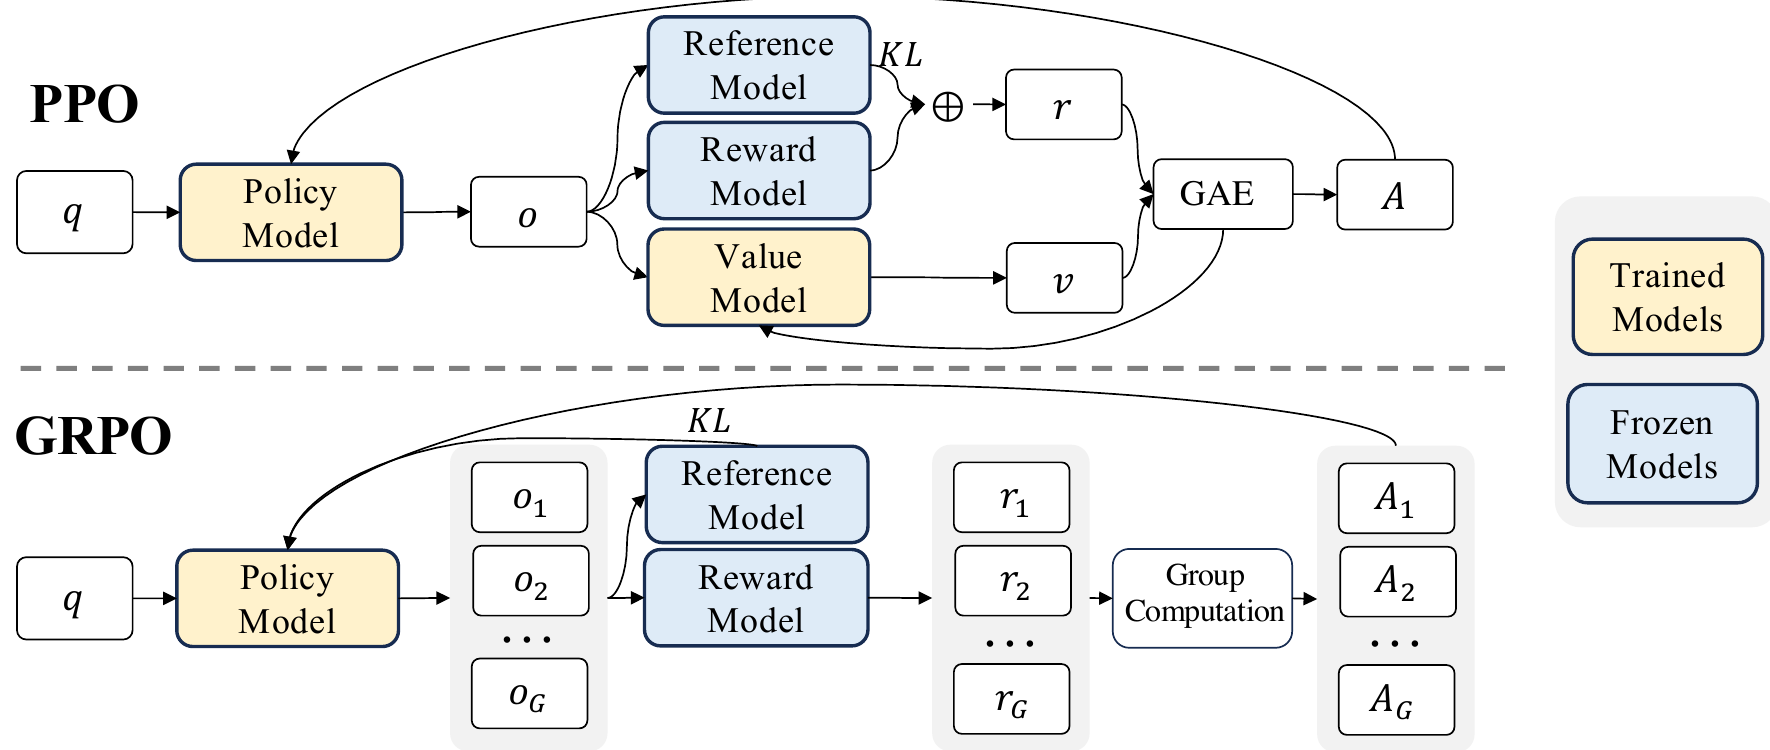
PPO 的目標是:
其中優勢 要用 GAE 計算,需要一個學出來的價值函數。這個價值模型通常和策略模型一樣大,記憶體和計算量都多一倍。而且語言模型的獎勵通常只在最後一個 token 給出,要訓練一個在每個 token 都準確的價值函數,本身就很難。
GRPO 的想法很直接。同一道題,讓模型寫 個回答,用這組回答的平均獎勵當基準,比平均好的就鼓勵,比平均差的就懲罰,不再需要價值模型:
這裡 是新舊策略在第 個回答第 個 token 的機率比值。
結果監督下,獎勵模型替每個回答打一個分數,再用組內的平均和標準差標準化,這個回答裡的每個 token 都用同一個值當優勢:
用答對 1 分、答錯 0 分的獎勵算算看:
import statistics

def group_advantages(rewards, eps=1e-8):
    """GRPO 的結果監督:同一題的 G 個回答,用組內的平均和標準差把獎勵標準化"""
    mean = statistics.mean(rewards)
    std = statistics.pstdev(rewards)          # 這裡用母體標準差
    return [round((r - mean) / (std + eps), 2) for r in rewards]

# 同一題取樣 8 個回答,答對得 1 分、答錯得 0 分
for rewards in ([1, 0, 0, 1, 0, 0, 0, 0], [1, 1, 1, 1, 1, 1, 1, 0], [1] * 8):
    print(rewards, "→", group_advantages(rewards))

# [1, 0, 0, 1, 0, 0, 0, 0] → [1.73, -0.58, -0.58, 1.73, -0.58, -0.58, -0.58, -0.58]
# [1, 1, 1, 1, 1, 1, 1, 0] → [0.38, 0.38, 0.38, 0.38, 0.38, 0.38, 0.38, -2.65]
# [1, 1, 1, 1, 1, 1, 1, 1] → [0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0]
難題裡少數答對的回答,得到很大的正優勢;簡單題裡唯一答錯的那個,被重重懲罰。全部答對(或全部答錯)的題目,每個回答的優勢都是 0,這一題對訓練沒有任何貢獻,取樣的計算等於白花了。
過程監督下,過程獎勵模型替每個回答的每一步打分,同樣用全部步驟分數的平均和標準差標準化。一個 token 的優勢,是它之後所有步驟的標準化分數加總。
KL 的處理也不一樣。PPO 把 KL 懲罰加在每個 token 的獎勵裡;GRPO 直接把 KL 加在損失函數上,避免干擾優勢的計算。KL 用的是下面這個估計式,它是無偏的,而且不會小於 0:
和直接用兩個機率的對數比值相比:
import math

def kl_estimate(p_theta, p_ref):
    """原論文式 (4):π_ref/π_θ − log(π_ref/π_θ) − 1,不會小於 0"""
    ratio = p_ref / p_theta
    return ratio - math.log(ratio) - 1

for p_theta, p_ref in [(0.5, 0.5), (0.6, 0.5), (0.4, 0.5), (0.9, 0.3)]:
    print(f"π_θ={p_theta}  π_ref={p_ref}  log(π_θ/π_ref)={math.log(p_theta / p_ref):+.3f}  式(4)={kl_estimate(p_theta, p_ref):.3f}")

# π_θ=0.5  π_ref=0.5  log(π_θ/π_ref)=+0.000  式(4)=0.000
# π_θ=0.6  π_ref=0.5  log(π_θ/π_ref)=+0.182  式(4)=0.016
# π_θ=0.4  π_ref=0.5  log(π_θ/π_ref)=-0.223  式(4)=0.027
# π_θ=0.9  π_ref=0.3  log(π_θ/π_ref)=+1.099  式(4)=0.432
對數比值有正有負,單一個 token 的估計可能是負的;式 (4) 在兩個分布一樣時是 0,其他時候都是正的,差距越大值越大。
迭代式 GRPO:訓練久了,舊的獎勵模型可能跟不上策略模型。作者用策略模型新的取樣結果產生新的獎勵模型訓練資料,加上 10% 的舊資料一起繼續訓練獎勵模型,再把參考模型換成目前的策略模型,繼續訓練。
訓練設定
- 資料:只用 SFT 資料裡和 GSM8K、MATH 相關、思維鏈格式的約 14.4 萬題。其他題目刻意不用,以便觀察強化學習對沒訓練過的評測有什麼影響。
- 獎勵模型:照 Math-Shepherd 的方式建構訓練資料,從 DeepSeekMath-Base 7B 訓練,學習率 。
- 策略模型:學習率 ,KL 係數 0.04,每題取樣 64 個回答,最長 1,024 個 token,batch 大小 1,024;每次取樣之後只更新一次。
討論
結果
| 模型 | GSM8K | MATH | MGSM-zh | CMATH |
|---|---|---|---|---|
| Gemini Ultra | 94.4 | 53.2 | - | - |
| GPT-4 | 92.0 | 52.9 | - | 86.0 |
| DeepSeek-LLM-Chat 67B | 84.1 | 32.6 | 74.0 | 80.3 |
| Instruct 7B | 82.9 | 46.8 | 73.2 | 84.6 |
| RL 7B | 88.2 | 51.7 | 79.6 | 88.8 |
整理自原論文 Table 5,思維鏈、不用工具的部分,節錄部分列;Instruct 7B 和 RL 7B 是 DeepSeekMath 的兩個 7B 模型;單位為 %。
GRPO 讓 GSM8K 從 82.9% 升到 88.2%,MATH 從 46.8% 升到 51.7%,超過 7B 到 70B 的所有開源模型,也超過大部分封閉模型,只是仍略低於 GPT-4 和 Gemini Ultra。
強化學習只用了 GSM8K 和 MATH 的英文題目,但中文的 MGSM-zh 和 CMATH 也一起進步了。允許用工具時,MATH 從 57.4% 升到 58.8%,同樣有進步,雖然強化學習的資料全是思維鏈格式。
一個統一的觀點
作者把各種微調方法寫成同一個形式。它們的梯度都長這樣:
差別只在三個地方:資料來源 (題目和回答從哪裡來)、獎勵函數 (訊號從哪裡來),以及梯度係數 (每個 token 該鼓勵或懲罰多少)。
- SFT:人準備的資料,每個 token 的係數都是 1。
- 拒絕取樣微調(RFT):用 SFT 模型自己取樣,只留答對的,答對係數是 1、答錯是 0。這和 STaR 的篩選是同一件事。
- 線上 RFT:同樣的規則,但改從正在訓練的模型取樣。
- DPO:用 SFT 模型取樣成對的回答,用成對的損失訓練。
- PPO 和 GRPO:從正在訓練的模型取樣,係數由獎勵決定,可正可負,大小也不同。
在 1.3B 的 Instruct 模型上比較這幾種方法,作者得到幾個觀察:
- 線上取樣比離線好:線上 RFT 一開始和 RFT 差不多,訓練到後期明顯勝出,因為模型和 SFT 模型的差距越來越大,自己取樣的資料才跟得上。
- 懲罰錯的比只鼓勵對的好:GRPO 勝過線上 RFT。線上 RFT 不懲罰錯的回答,所有答對的回答也都一視同仁;GRPO 會依獎勵的大小調整鼓勵和懲罰的力道。
- 過程監督比結果監督好:GRPO 搭配過程監督,勝過搭配結果監督。
- 迭代有用:這一項改在 7B 的 Instruct 模型上做,迭代式強化學習明顯提升了表現,尤其是第一輪。
強化學習到底改變了什麼
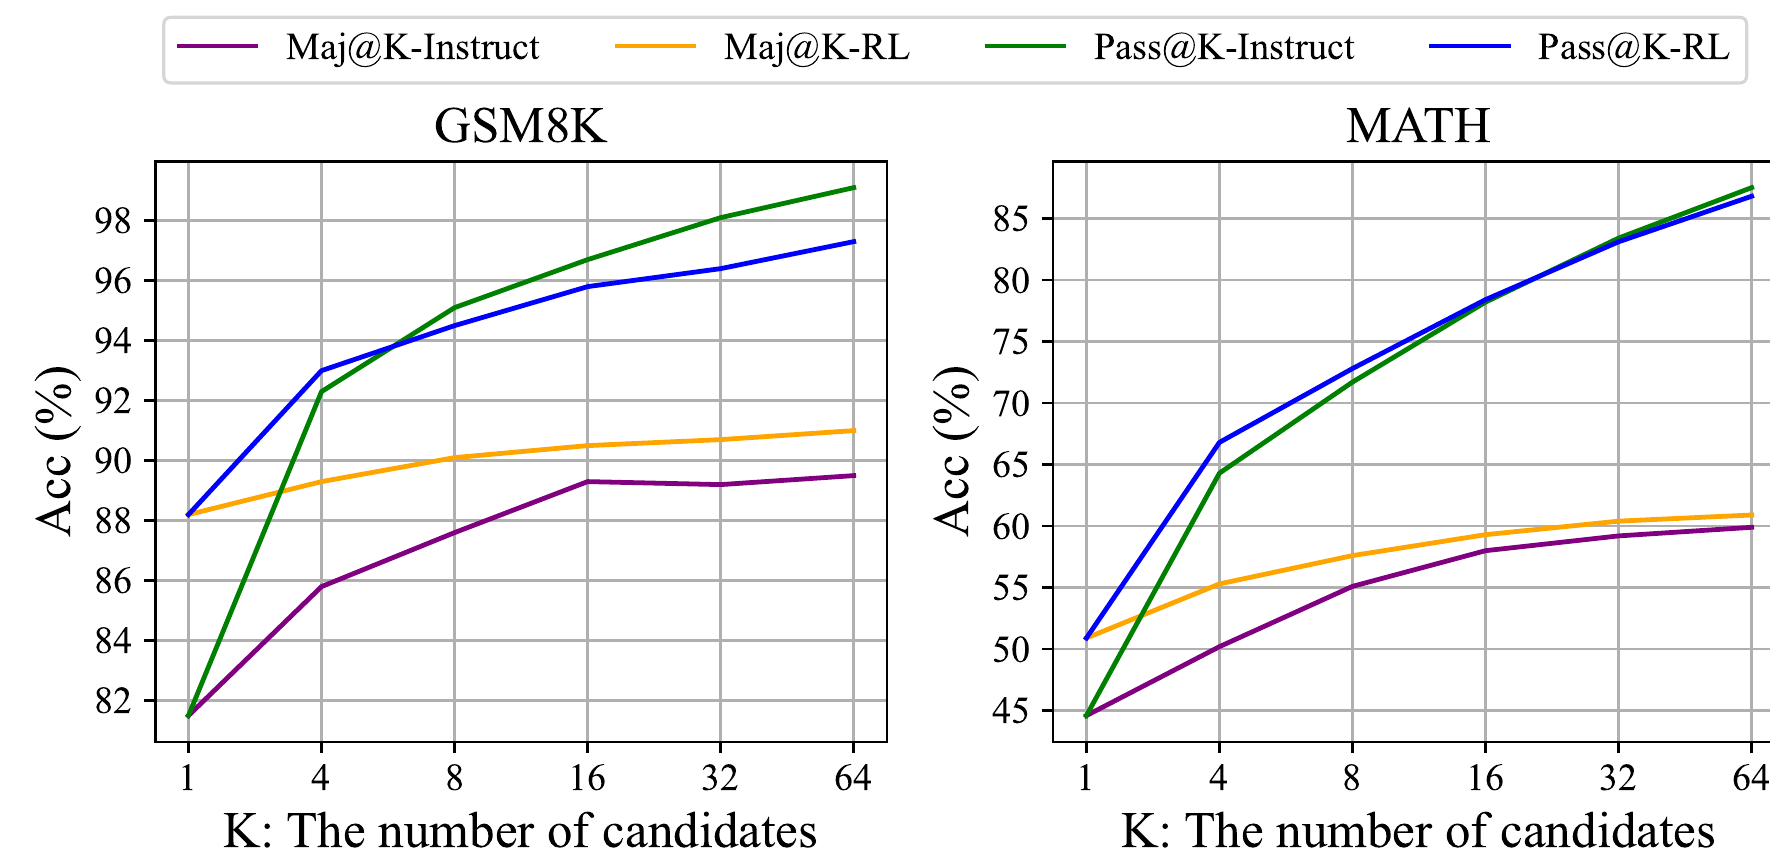
這張圖是整篇最值得細看的。Maj@K 是取樣 次、投票選出的答案對不對;Pass@K 是取樣 次、只要有一次答對就算對。
強化學習提升了 Maj@K,卻沒有提升 Pass@K。取樣次數夠多時,原本的 Instruct 模型也能答對同樣多的題目。作者的解讀是,強化學習讓輸出的分布更穩定,把原本就排在前幾名的正確答案推到最前面;它沒有讓模型學會原本完全不會的題目。
作者在結尾也提到,他們只用了 SFT 階段的題目和最簡單的 nucleus 取樣,這可能是只有 Maj@K 進步的原因。未來想試試分布外的題目、搭配樹搜尋等更進階的取樣方式。
限制
- 幾何和證明比較弱:模型處理不了三角形、橢圓相關的題目,作者認為可能是預訓練和微調資料的選擇有偏差。
- 少樣本能力不如 GPT-4:GPT-4 給了範例會進步,DeepSeekMath 給不給範例都差不多,作者歸因於模型規模。
- 獎勵訊號不可靠:現有的方法都完全相信獎勵模型的訊號,但連人工仔細標註的 PRM800K,也被發現大約有 20% 的標註是錯的。作者認為需要能承受雜訊獎勵的強化學習演算法。
後來的事
不到一年後,DeepSeek-R1 用的就是 GRPO,但把獎勵換成了簡單的規則:答案對不對、格式對不對。不用神經網路的獎勵模型,也就沒有獎勵模型被鑽漏洞的問題。DeepSeek-R1-Zero 甚至跳過監督式微調,直接從基礎模型開始強化學習。GRPO 之後成了開源推理模型最常用的強化學習演算法之一。
GRPO 本身也被仔細檢查過。2025 年 3 月的 Dr. GRPO 指出,GRPO 的目標函數有一個最佳化上的偏差,會在訓練中人為地拉長回答,錯誤的回答尤其明顯,並提出了一個無偏的修正版本。
Figure 7 的觀察,一年後也被放大檢驗。2025 年 4 月,Yue 等人在 Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model? 裡,用更大的 比較強化學習前後的模型: 小的時候,強化學習後的模型比較好; 大的時候,基礎模型的 pass@k 反而更高。他們的結論是,這類強化學習得到的推理能力,來自基礎模型、也受限於基礎模型。這和這篇論文自己在 2024 年畫出的那張圖,說的是同一件事。
結論
DeepSeekMath 用 7B 的參數,在 MATH 上不用工具、不投票拿到 51.7%,接近當時的 GPT-4。功勞分成兩半:一半是從 Common Crawl 迭代撈出的 1,200 億個 token 的數學網頁,一半是拿掉價值模型、用同一題的一組回答互相比較的 GRPO。
這篇的分析部分常被忽略,其實很有分量。程式先學比較好、arXiv 沒什麼用、線上取樣勝過離線、懲罰錯的比只獎勵對的有效,都是後來的人反覆用到的經驗。
最誠實的是 Figure 7。作者自己畫出來,強化學習只提升了投票的準確率,沒有提升「至少答對一次」的比例,並老實寫下:進步可能來自把正確答案往前推,而不是能力變強。一年後,整個領域花了不少力氣,又重新確認了一次這件事。