原論文
The Road Less Scheduled
- 発表先
- NeurIPS 2024国際会議
- arXiv への初回投稿
- arXiv:2405.15682
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{optimizersschedulefree2024,
  title = {{The Road Less Scheduled}},
  author = {Aaron Defazio and Xingyu Alice Yang and Harsh Mehta and Konstantin Mishchenko and Ahmed Khaled and Ashok Cutkosky},
  year = {2024},
  eprint = {2405.15682},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2405.15682}
}
2024 年 8 月 1 日、MLCommons が第 1 回 AlgoPerf 学習アルゴリズムコンテストの結果を発表した。
AlgoPerf を聞いたことがなければ説明しておくと、これはオプティマイザと学習手順そのものを競うコンテストだ。モデル、データ、ハードウェア(V100 を 8 枚)はすべて固定で、8 つのタスクを指定の検証スコアまで誰がいちばん速く学習させられるかを見る。タスクは機械翻訳、画像分類、MRI 再構成、音声認識、分子グラフ、クリック率予測にまたがる。部門は二つある。外部チューニング部門では、ハイパーパラメータの探索範囲を提出すると、主催者がそこから 5 組の設定を抽出して試してくれる。セルフチューニング部門では学習の外でハイパーパラメータを探索できず、手法は 1 回の学習の中ですべてのタスクに自力で対処しなければならない。最もよくあるやり方は一つの設定ですべてをこなすことで、その埋め合わせとして学習時間の上限が 3 倍に緩められている。
セルフチューニング部門で主催者のベースラインに勝った投稿は一つだけだった。Meta と Samsung の研究者が提出した Schedule Free AdamW で、スコアは 0.8542。ベースラインは NAdamW に線形ウォームアップと cosine 減衰を組み合わせたもので 0.8194、ほかの 4 件はすべて 0.4 未満だった。この手法の最大の特徴は、学習率スケジュールをまったく使わず、何ステップ学習するかを前もって知る必要もないことだ。
その背後にある論文の題は〈The Road Less Scheduled〉。Frost の〈The Road Not Taken〉にある「less traveled」の一節をもじったもので、結論の節では実際に原詩を引用している。第一著者は Meta FAIR の Aaron Defazio で、彼の以前の D-Adaptation も「学習率をどう設定するか」という問題を扱っていた。コードは 4 月に schedulefree パッケージとして PyPI に公開され、論文が arXiv に載ったのは 5 月末になってからだった。
問題の定義
スケジュールには終点が要る
現在最もよく使われる学習率スケジュールは cosine と線形減衰で、どちらも総ステップ数 がわかっていないと曲線が描けない。 を誤ると代償は小さくない。Chinchilla の付録の測定では、cosine の周期を実際のステップ数より 25% 以上長く設定すると、モデルははっきり悪くなる。学習の途中で延長したくなっても、計画を立て直さなければならない。
平均化は理論上は優秀、実際にはいまひとつ
もう一つの道は、スケジュールを使わずにパラメータを平均することだ。Polyak–Ruppert 平均は最も古典的なやり方で、SGD はいつもどおり固定のステップサイズで進み、それとは別に、通ってきたすべての点の平均を保持する。
によって、 はちょうど の等重み平均になる。古典的な収束理論に従えば、凸で Lipschitz な問題では、最後の一歩の ではなく を出力すべきだ。ところが実際には、この平均は SGD の最後の一歩よりずっと悪い。著者らはこれを、最適化の分野の通説(folk-law)だとしている。
近年の理論はさらに、線形減衰スケジュールそのものが、最後の一歩で最悪ケースの最適レートを達成できることを示した。スケジュールと平均化は理論上ほぼ同じ役割を果たすが、スケジュールのほうは を先に知っておく必要がある。そこで著者らは問うた。実際の性能ではスケジュールに追いつき、しかも理論保証も手放さない平均化の方法はあるだろうか。
問題の解決
三つの系列
Schedule-Free SGD の更新は式 (3) から (5) だ。
出発点は 。三つの系列にはそれぞれ役割がある。
- はベース系列で、下で動くオプティマイザがここで一歩ずつ進む。ここでは普通の SGD だ。
- は評価系列で、 の等重み平均であり、最終的に出力するモデルでもある。
- は勾配を計算する位置で、 と のあいだを内挿する。
Polyak–Ruppert 平均と比べると、増えたのは 1 行目だけだ。勾配を 上ではなく、 と のあいだにある 上で計算する。
二つの極端
は をどちら寄りにするかを決める。 なら で、勾配を 上で計算するので Polyak–Ruppert 平均になる。 なら で、勾配を平均点で計算する。これは primal averaging と呼ばれ、やはり最悪ケースで最適な保証を持つが、一般には収束が遅すぎて実用的でないとされている。
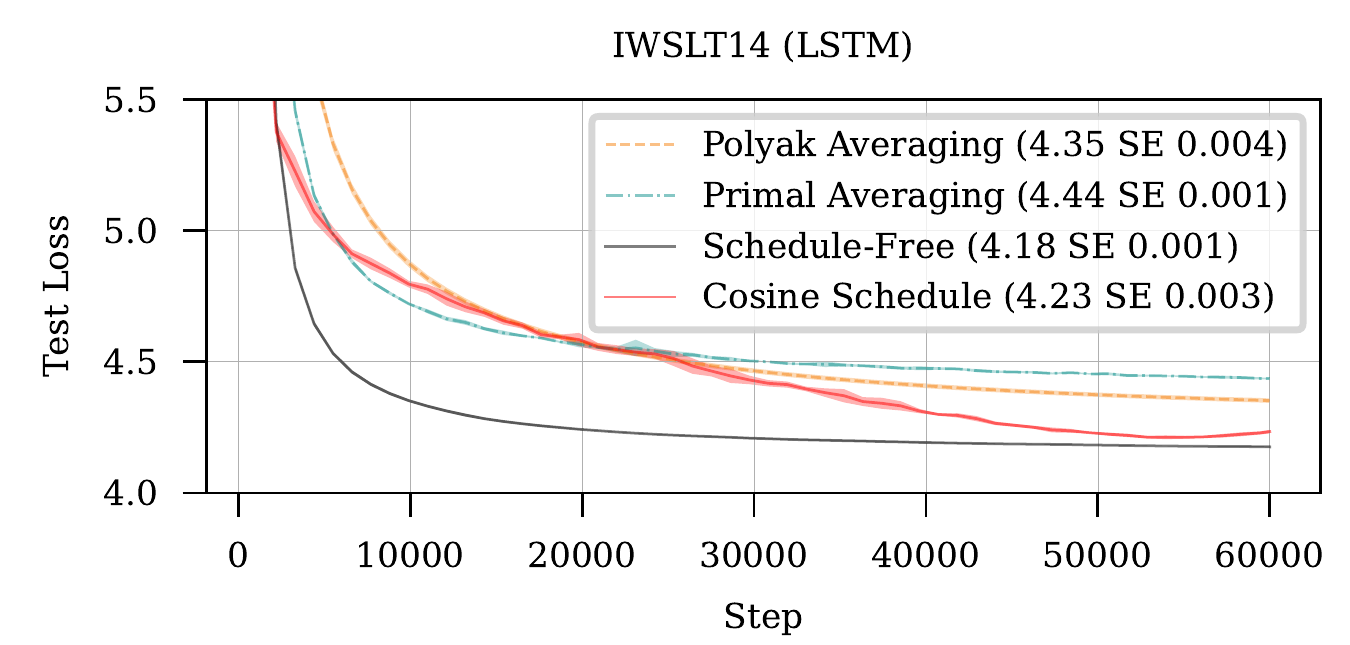
この図は IWSLT14 独英の LSTM だ。両極端はどちらも調整済みの cosine スケジュールに負けていて、Polyak 平均は最終的に 4.35、primal averaging は 4.44、cosine は 4.23。Schedule-Free は中間をとって とし、最終的に 4.18、しかも最初の 1 万ステップでどれよりも速く下がっている。
著者らの説明では、 は より速く動くので、内挿によって Polyak 平均の収束の速さという長所が保たれる。一方で は のほうへ引き寄せられるので、勾配を計算する位置が出力するモデルから離れすぎず、安定性が増す。
もう一つのモーメンタム
の役割はモーメンタムによく似ていて、論文でも普通の指数移動平均(EMA)モーメンタムと比べている。第 ステップの勾配 が に入るときの即時の影響は で、 なら になる。ここは EMA モーメンタムと同じだ。違うのは残りの 90% の扱いだ。EMA モーメンタムはその後のおよそ 10 ステップで大部分を足し終える。Schedule-Free は という平均を通して、それをごくゆっくりと加えていく。
このモーメンタムには、理論上の副作用がない。Theorem 1 によれば、 が凸関数で、各サンプルの損失 がすべて -Lipschitz、サンプルが独立同分布のとき、( は出発点から最適解までの距離)とすれば、 のどんな に対しても次が成り立つ。
これは非平滑な凸問題における最適レートで、定数まで同じだ。対照的に、EMA モーメンタムは同じ設定のもとで、最悪ケースの保証をかえって悪くしてしまう。
は減衰スケジュールそのものでは?
ここまで読んで、疑問が湧いたかもしれない。 の更新には が入っている。これは減衰していく学習率そのものではないか。
ある意味ではそのとおりだ。著者らは Figure 4 で、各ステップの勾配が最終的に と にそれぞれどれだけの割合で含まれるかを示している。
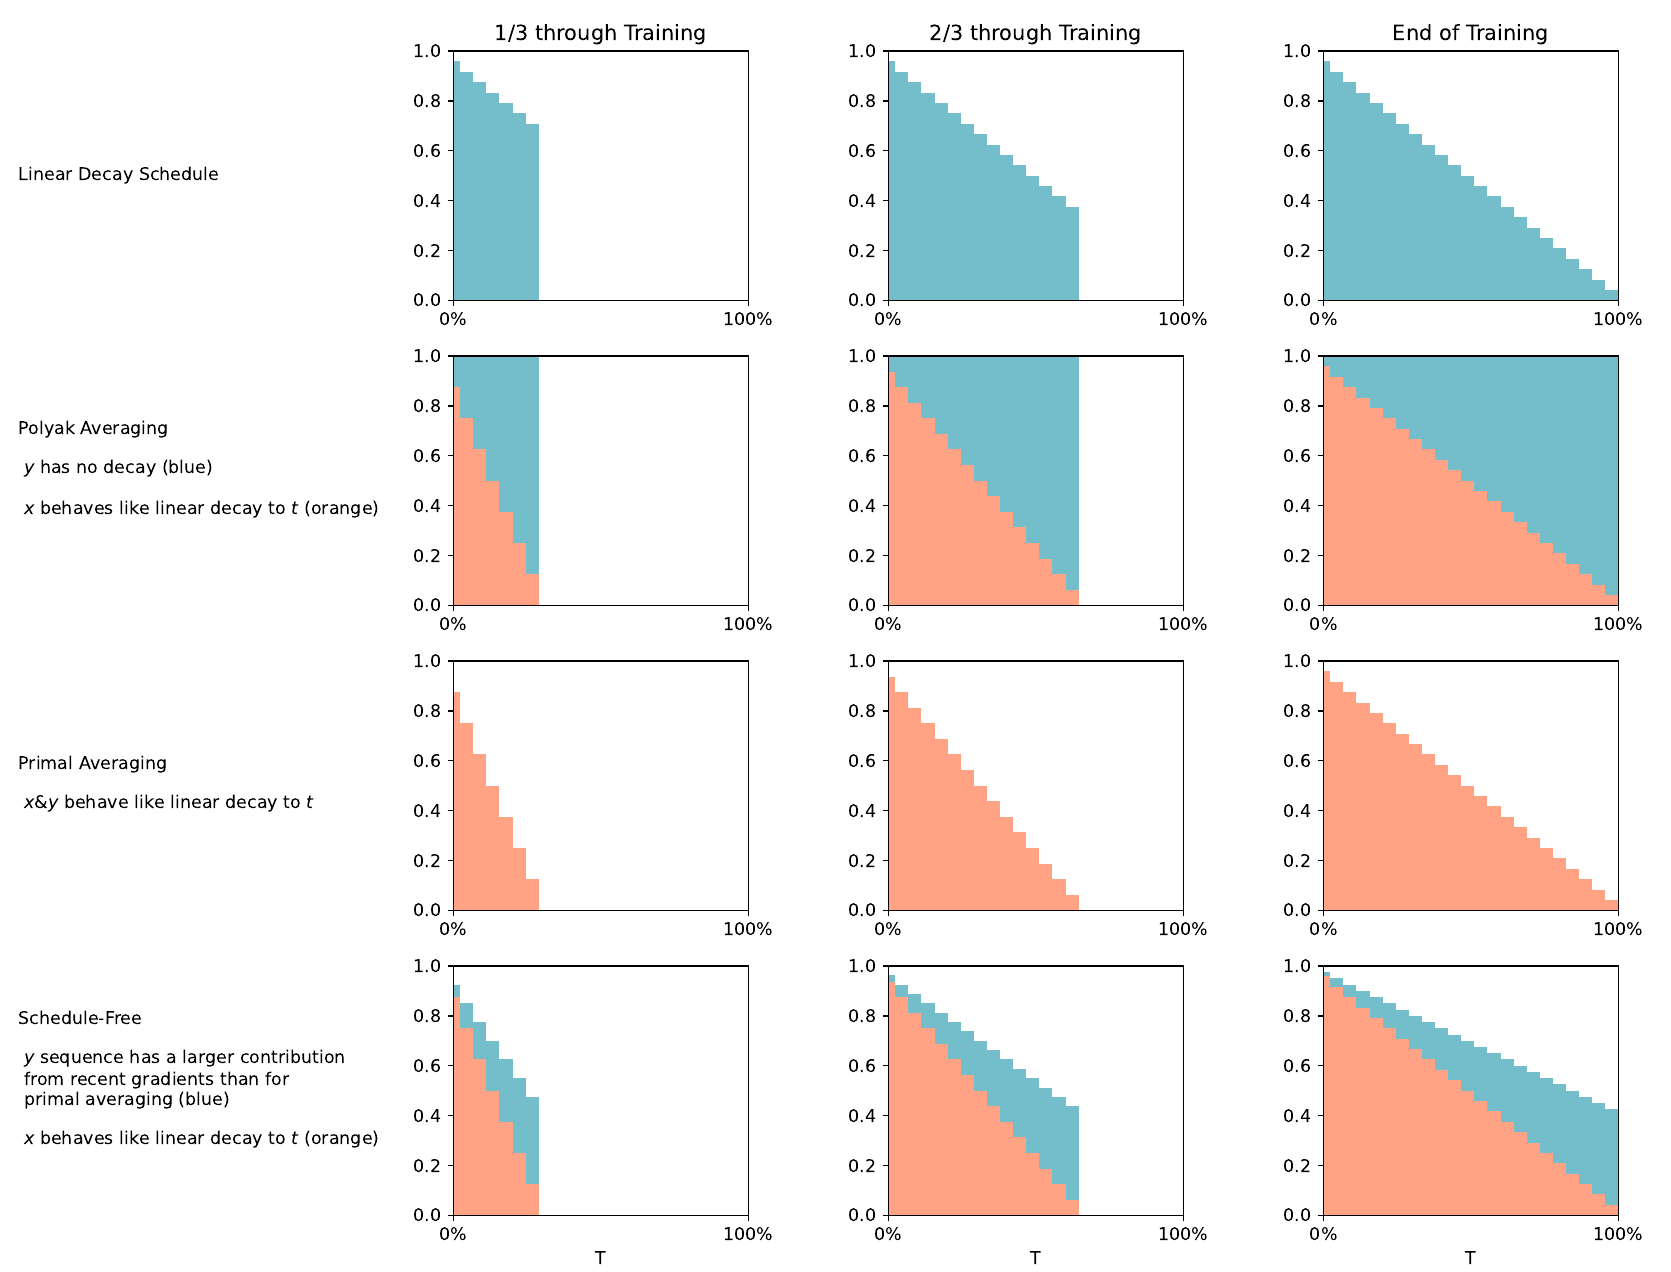
まず 1 行目を見よう。線形減衰スケジュールが 1/3、2/3、終点まで進んだとき、各ステップの勾配はその時点の学習率に応じてパラメータに足し込まれ、後になるほど歩幅が小さいので、斜面の形になる。ただし、この斜面の終点は に固定されている。
次に下の 3 行の橙の部分、つまり を見る。三つの平均化手法の は、どの時点でも終点がちょうど現在の にある線形減衰のような形をしている。平均化がスケジュールの代わりになれる理由はここにある。平均化は実は一つのスケジュールを暗に含んでいて、ただその終点が とともに前へ動いていくので、 を前もって知る必要がない。
青い部分は で、三つの手法の違いはここに出る。Polyak 平均の は そのものなので、各ステップの勾配がまるごと計算に入り、学習後期には最近の勾配の比重がスケジュールよりずっと大きい。primal averaging の は そのものなので、最近の勾配は小さく抑え込まれ、前半の収束が遅い。Schedule-Free はその中間で、最近の勾配の比重を少しだけ補強している。
付録 B はこれを代数で書いている。 をベースオプティマイザの一歩、 とすると、等重み平均で が固定のとき、 が各ステップで実際に動く量は次のようになる。
つまり、モーメンタム項に 倍のベースの歩幅を足したものだ。 を時間とともに変え、ちょうど にとると、モーメンタム項の係数がすっかり消え、残るのは線形減衰スケジュールになる。Schedule-Free は を固定する道を選んだので、 が要らない。
理論はどこまでカバーしているか
Theorem 1 は、実はより一般的な Theorem 2 の特殊ケースだ。Theorem 2 では、 を生成するのは任意のオンライン学習アルゴリズムでよく、平均の重み と内挿係数 も任意にとれる。それらの regret を確率的最適化の収束保証に変換する、一種の online-to-batch conversion である。 とすれば古典的な Polyak 平均、 とすれば primal averaging(Defazio の以前の研究で heavy-ball モーメンタムと等価だと指摘されている)、 とすれば線形減衰スケジュールの最後の一歩の保証が得られる。付録 C ではさらにこれを等式に締め直し、平滑な問題での加速レートを導いている。
条件もはっきりさせておこう。これらの保証はどれも凸問題についてのものだ。Theorem 1 のステップサイズ には が隠れていて、いつでも成り立つ に置き換えると、実際の性能はひどく悪い。実務で使われているのは、ずっと大きな固定のステップサイズ だ。Theorem 3 は、学習中に確認できるある条件のもとでなら、これほど大きなステップサイズでも最適レートが得られることを示している。著者らは 4.1 節のすべての問題でこの条件を確かめ、どれでも成り立っていた。ただし、確率的な問題で大きなステップサイズがいつ使えるのかはまだ完全には理解されていないと、彼ら自身も認めている。
もう一つの傍証は二次関数から来ている。著者らは 20 次元の二次問題をランダムに 10 個生成し、 と を掃引した。ステップサイズが小さいときは はほとんど影響しない。ステップサイズが大きいときは、 であることが収束の鍵になる。
Schedule-Free AdamW
ベースオプティマイザを AdamW に替えたものが Algorithm 1 だ。
- 。内挿でモーメンタムを置き換える。
- 上で勾配 を計算する。
- 。
- 。ウォームアップとバイアス補正をどちらも学習率に組み込む。
- 。
- 。
- 。
AdamW と違う点がいくつかある。
- 一次モーメントがない。 は内挿に使われるので、保存するのは 、、 だけでよく、メモリは AdamW と同じだ。SGD 版のメモリも、モーメンタムつき SGD と同じになる。
- ウォームアップはやはり必要。 著者らは 4.4 節で、この手法にも学習率のウォームアップは依然として必要だとはっきり書いている。
- 平均の重みが学習率に連動する。 ウォームアップがある場合、著者らは平均の重みに を使う。ウォームアップ中の学習率が小さいステップは、平均の中での比重も小さくなる。こうすると効果が大きく改善することを、著者らは見出した。ウォームアップが終われば、 は のペースで減っていく。
- 重み減衰は で計算する。 で計算することもできるが、ImageNet や NanoGPT などの問題では で計算したほうがはっきり良い。
実装の細部
学習時には で勾配を計算し、評価時には を使うので、モデルのパラメータは両者のあいだで切り替える必要がある。公式の PyTorch 実装は を 1 つ余分に保存するだけで、パラメータ自体のバッファには学習時は 、評価時は を入れる。 から が解けるので、optimizer.eval() はこの内挿を行い、optimizer.train() で に戻す。
ここからいくつかの使い方のルールが出てくる。model.train() を呼ぶところでは一緒に optimizer.train() を、model.eval() を呼ぶところでは optimizer.eval() を呼ぶ。チェックポイントを保存する前にも eval モードに切り替えること。そうしないと、保存されるのは ではなく になる。PyTorch の step closure に対応したコードなら、closure 版を使えばこうした切り替えを省ける。
いちばん厄介なのは BatchNorm だ。BN の running mean と variance は学習時、つまり 上で蓄積されるので、 に切り替えると統計量が合わなくなる。公式 README が示している修正は、評価の前に で学習バッチを数十個流し、統計量を蓄積し直すことだ。
model.train()
optimizer.eval()
with torch.no_grad():
    for batch in itertools.islice(train_loader, 50):
        model(batch)
model.eval()
LayerNorm のようにバッチ統計量に頼らない正規化層なら、この問題はない。README はさらに、フレームワークが fp16 のパラメータを別にキャッシュしている場合(一部の GradScaler がそうする)、それも手動で更新して、評価に が使われるようにする必要があると注意している。
議論
実験設定
著者らは、これは現時点で最大規模のオプティマイザ評価の一つだとしている。全部で 28 の問題があり、12 のロジスティック回帰、9 の深層学習タスク、AlgoPerf の 7 タスクからなる。深層学習タスクのうち、CIFAR-10、CIFAR-100、SVHN、ImageNet では Schedule-Free SGD を、IWSLT14、DLRM、fastMRI、MAE の微調整、NanoGPT では Schedule-Free AdamW を使う。
比較のやり方は、両者ともグリッド上で学習率と重み減衰を掃引し、Schedule-Free はさらに 0.9 と 0.98 の二つの から一つを選ぶというものだ。階段状のスケジュールが慣例になっているタスクでは、それも加えて比べている。
1 回の学習でフロンティア全体を描く
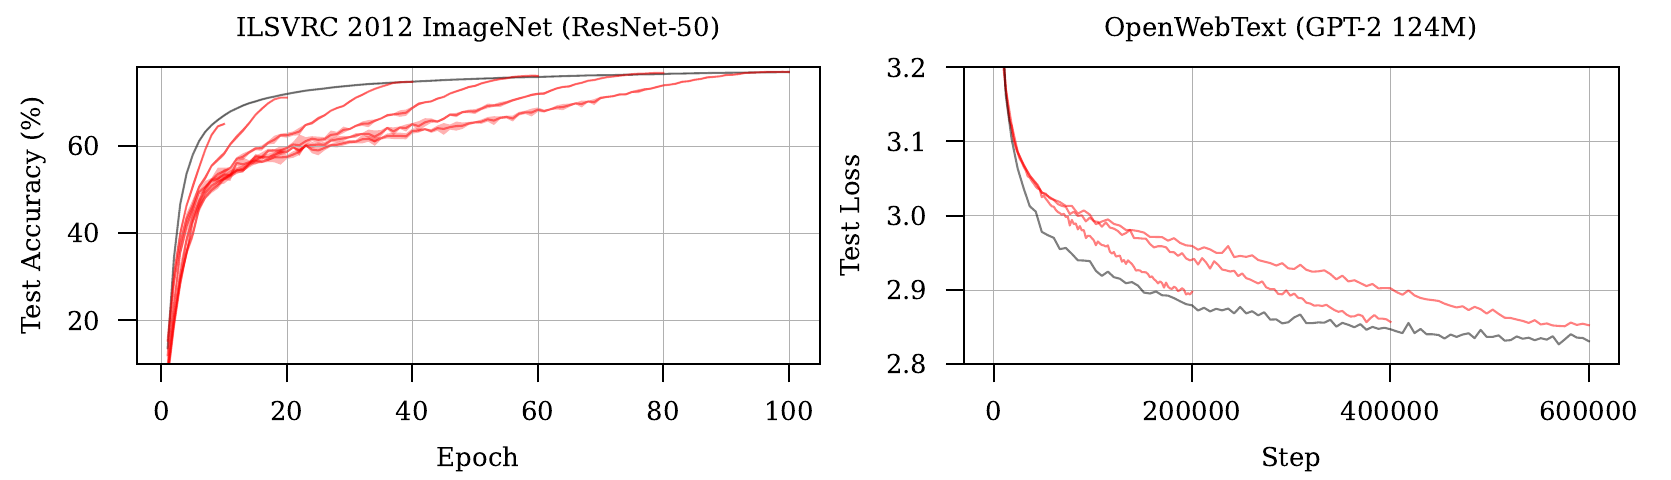
赤線は長さの異なる複数の cosine スケジュールで、どれも自分の終点に着いてはじめて最良になる。それらの終点をつなぐと、「学習時間対性能」のフロンティアになる。黒線は 1 回しか学習していないのに、どの時点でもこのフロンティアに沿っていて、GPT-2 のほうではほとんどの時間で赤線より下にある。言い換えれば、どこで学習を止めても、その長さに合わせて前もって cosine を 1 本調整しておいたのとほぼ同じになる。
九つの深層学習タスク
| タスク | 指標 | Schedule-Free | 最良スケジュール |
|---|---|---|---|
| CIFAR-10 | 正解率 | 96.03 | 95.73 |
| CIFAR-100 | 正解率 | 78.71 | 77.41 |
| SVHN | 正解率 | 98.40 | 98.27 |
| ImageNet | 正解率 | 76.90 | 76.90 |
| IWSLT14 | 損失 ↓ | 4.18 | 4.23 |
| fastMRI | SSIM | 0.9112 | 0.9110 |
| Criteo | 正解率 | 0.7915 | 0.7906 |
| MAE 微調整 | 正解率 | 83.54 | 83.52 |
| GPT-2 124M | 損失 ↓ | 2.831 | 2.853 |
原論文 Figure 2 と Figure 5 の凡例をもとに整理。「最良スケジュール」列は著者らが調整した cosine または線形減衰スケジュール。ImageNet は ResNet-50、GPT-2 124M は OpenWebText 上の NanoGPT の設定。
7 つのタスクで調整済みのスケジュールに勝ち(fastMRI と Criteo の差はごく小さい)、ImageNet と MAE の微調整では引き分けた。差が最も大きいのは CIFAR-100 で、1.3 ポイント上回った。ImageNet では両者とも 76.90% で、階段状スケジュールは 76.49% だ。
これらの数字の裏には、見ておきたい設定がいくつかある。
- 学習率がずっと大きい。 CIFAR-10 での Schedule-Free の学習率は 10 で、cosine は 0.2。ImageNet では 1.5 対 0.05、NanoGPT では 0.005 対 0.0005 だ。著者らは、発散せずに大きな学習率を使えることが、収束が速い理由の一つかもしれないと考えている。
- NanoGPT には特別な扱いが要る。 では学習の途中で損失が急に上がり、0.98 にしてようやく安定した。勾配クリッピングもオフにしなければならず、著者らはこれが決定的に重要だと述べている。
- 勾配がつぶれない。 CIFAR-10 で cosine スケジュールの SGD は、後期に訓練損失が 0 近くまで下がり、勾配ノルムも 0 近くまでつぶれて、その後はほとんど学習が進まない。Schedule-Free にはこの現象がない。著者らは、これが CIFAR と SVHN で特に良い理由かもしれないと考えている。
付録では、同じタスク群での Polyak 平均と primal averaging の結果も補っていて、どちらもはっきり後れをとっている。ImageNet ではそれぞれ 72.84% と 69.78%、NanoGPT では Polyak 平均の損失がそのまま発散した。
AlgoPerf
論文中の AlgoPerf の結果は、著者らが自分でコンテストのルールに従い、NAdamW のベースラインと 10 個の乱数シードで比べたものだ。ResNet-50 のタスクは除外されている。AdamW も NAdamW も目標に届かないからだ。残る 7 タスクでは、Schedule-Free AdamW は WMT、ViT、fastMRI、OGBG で速く、Conformer と Criteo では互角、DeepSpeech ではわずかに遅かった。著者らはこの二つのタスクでの結果を BatchNorm のせいだとしている。Conformer と DeepSpeech はどちらも BN を使っていて、コンテストのコードフレームワークでは 上で BN の統計量を計算し直すのが難しい。
付録には、セルフチューニング部門で使った設定も載っている。学習率 0.0025、、、重み減衰約 0.081、ウォームアップ 2% で、平均の重みにはさらに を掛けている。
公式の結果は、MLCommons の発表と、主催者がのちに ICLR 2025 で発表した分析にある。セルフチューニング部門では Schedule Free AdamW がベースラインを上回った唯一の投稿で、平均学習時間は約 8% 短く、8 つの基本タスクのうち 4 つで最速だった。外部チューニング部門のベースラインと比べても、両者がともに学習に成功した 7 タスクで、ハイパーパラメータ調整なしで約 10% 速かった。同じチームは 5 組の設定を持つ版で外部チューニング部門にも参加して 2 位(0.7077)となり、Distributed Shampoo の 0.7784 に敗れた。両者がともに成功した 7 タスクでは、Shampoo はセルフチューニング版の Schedule-Free AdamW より約 24% 速かった。
ちょっとした裏話もある。セルフチューニング部門の賞金は、結局授与されなかった。MLCommons の発表によれば、複数の参加作品の所属がワーキンググループの議長と重なっていたため、授与条件を満たさなかったという。
モーメンタムへの敏感さ
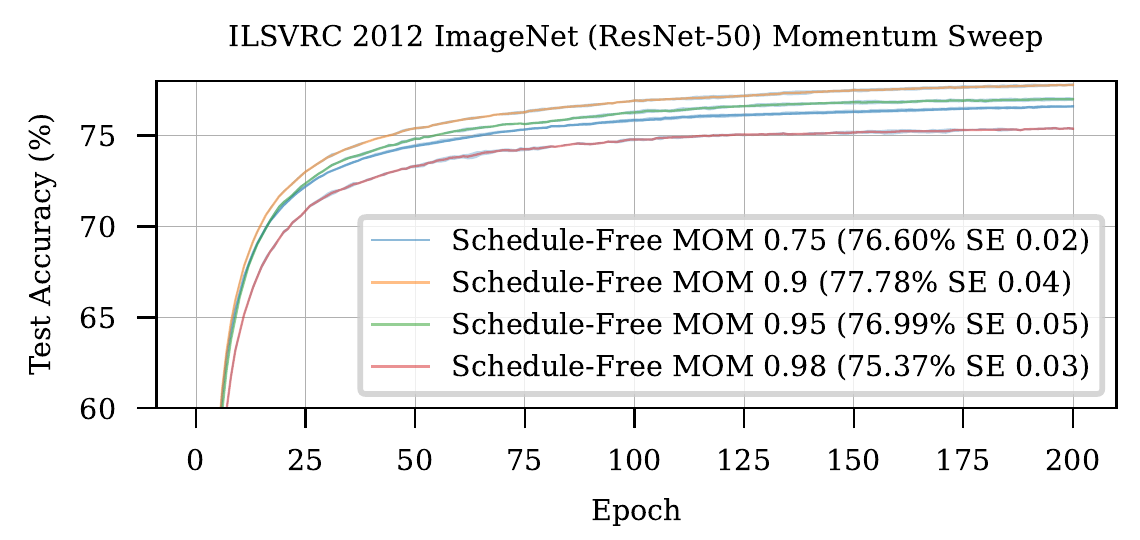
最適な が学習の長さによって変わるなら、「 を知らなくてよい」は問題をスケジュールからモーメンタムへ移しただけになる。著者らは ImageNet で普段より長い 200 エポックを走らせ、4 通りのモーメンタムを掃引した。どの時点で止めて見ても、最良は だった。学習率への敏感さも cosine スケジュールと同程度で、学習がごく短い(25 エポック以内)ときだけ、大きめの学習率のほうが良かった。
ただ、ほかの証拠はここまで楽観的ではない。NanoGPT 自体が を 0.98 に調整する必要があったし、公式 README にも、学習が特に長いときは を 0.95 や 0.98 に上げる必要があるかもしれないと書かれている。Hägele ら(NeurIPS 2024)は 2.1 億パラメータの言語モデルで、Schedule-Free AdamW と「一定の学習率に最後だけ線形クールダウンをつけたもの」(WSD に近い)を比べた。 でははっきり悪く、学習の後半では損失がむしろ上がった。 にすると非常に良かったが、どちらの設定もクールダウンスケジュールに並ばれるか上回られた。なお、彼らはどちらの側についても、それ以上のハイパーパラメータ調整はしていない。
限界
著者らが結論で明言しているように、最大の実務上の制約は、学習率と重み減衰を掃引し直す必要があることだ。最適値がスケジュールを使う場合と異なるからである。ほかに注意すべき点は、大半がすでに触れたものだ。
- ウォームアップは依然として必要だ。論文の実験の多くはウォームアップを総学習量の 5% に設定していて、AlgoPerf の設定は 2% だった。厳密に言えば、ここでは学習の長さを使っている。
- BN は 上で統計量を計算し直す必要がある。学習と評価ではモードを切り替える必要があり、チェックポイントを保存するときも同じだ。
- 理論がカバーするのは凸問題だけで、大きなステップサイズがいつ使えるかについてはまだ完全な理論がない。
- は長時間の言語モデル学習では比較的敏感だ。
結論
Schedule-Free は三つの系列で学習率スケジュールを置き換える。ベースオプティマイザは 上で一歩ずつ進み、 は の平均で、勾配は両者のあいだの 上で計算する。平均化そのものが、終点が刻々と動いていく線形減衰スケジュールを暗に含んでいるので、 を前もって知る必要がない。凸問題では、どんな でも最悪ケースの最適レートが保たれる。9 つの深層学習タスクのうち 7 つで勝ち、2 つで引き分け、AlgoPerf 2024 のセルフチューニング部門で 1 位をとった。
試してみたいなら、オプティマイザを替えたうえで、model.train()、model.eval() の隣に対応する optimizer.train()、optimizer.eval() を加え、チェックポイントを保存する前には eval に切り替えること。BN のあるモデルでは、評価の前に で統計量を計算し直す。学習率はスケジュール版の 1〜10 倍(AdamW)か 10〜50 倍(SGD)から試し始め、 はまず 0.9、学習がとても長ければ 0.95、0.98 へ上げる。ウォームアップはそのまま残しておく。
名前は Schedule-Free でも、Algorithm 1 の 8 行目にはしっかり と書いてある。