原始論文
SGDR: Stochastic Gradient Descent with Warm Restarts
- 發表版本
- ICLR 2017會議
- arXiv 首次提交
- arXiv:1608.03983
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{optimizerssgdr2016,
  title = {{SGDR: Stochastic Gradient Descent with Warm Restarts}},
  author = {Ilya Loshchilov and Frank Hutter},
  year = {2016},
  eprint = {1608.03983},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1608.03983}
}
打開 PyTorch 的 torch.optim.lr_scheduler,有兩個排程器的說明文件都指向同一篇論文。
一個是 CosineAnnealingWarmRestarts,名字已經把來歷寫得很清楚。另一個是 CosineAnnealingLR,說明文件同樣引用這篇論文,卻特別補了一句,說 SGDR 雖然有週期性的重啟,這個實作做的是沒有重啟的 cosine 退火。
一篇題目裡寫著「重啟」的論文,後來在大型模型的訓練設定裡留下來的,多半是沒有重啟的那一半。我們就從頭看看,2016 年 Ilya Loshchilov 和 Frank Hutter 到底提出了什麼,重啟原本又想解決什麼問題。
如果你沒聽過這兩位作者,先補一點背景。他們當時在德國弗萊堡大學,Hutter 的研究主軸是超參數最佳化與 AutoML;Loshchilov 之前做過不少演化策略 CMA-ES 的研究,論文第 2 節回顧重啟策略時,引用的就有他自己 2012 年的工作。在不用梯度的最佳化裡,「跑一陣子、整個重來」是對付多峰函數的老招數,而且常見做法是每重啟一次,就把取樣的族群加倍。這篇論文把重啟的習慣帶進了 SGD。
定義問題
2016 年訓練 ResNet 一類的網路,主流是 SGD 加動量,也就是論文的式 (3)(4):
作者在引言裡說,這樣訓練最難的部分,剩下學習率怎麼排、權重衰減要多少。這篇拿來當基準的 Wide ResNet(WRN),學習率從 0.1 開始,在第 60、120、160 個 epoch 各乘 0.2,總共訓練 200 個 epoch。
這種階梯式排程有兩個麻煩。第一,在哪裡降、降多少,都是要調的超參數。第二,模型要等到學習率降下來之後才會變好;如果第 100 個 epoch 就得停,手上的模型還卡在高學習率的階段,誤差很大。作者用 anytime performance 描述後者,意思是不論在哪個時間點停下來,手上都有一個夠好的模型。
這篇的目標就是改善 SGD 的 anytime performance。學習率要怎麼排,才能讓訓練隨時可以停,最後又不輸給調好的階梯排程?
解決問題
熱重啟
作者的做法是每隔 個 epoch,模擬一次 SGD 的重新開始。這個重啟不從頭訓練。參數 原封不動當成新的起點,只把學習率拉回高點,再讓它降下來。原文也指出,學習率拉高多少,決定了之前累積的資訊(例如動量)還保留多少。
Cosine 退火
在第 次執行裡,學習率依式 (5) 逐個 batch 遞減:
是上次重啟以來跑了幾個 epoch。它每個 batch 都會更新,所以可以是 0.1、0.2 這種小數。代幾個點進去:
- ,,學習率是 。
- ,,學習率剛好在兩端的中間。
- ,,學習率降到 。
所以這條曲線一開始降得很慢,中段接近直線,快結束時又放慢,在低學習率停留一段時間。CIFAR 實驗裡每次執行的 與 都固定為 0.05 和 0。作者提到,每次重啟時把這兩個值往下調也許有好處,但為了少一點超參數,沒有這樣做。
與
週期長度由兩個數決定。 是第一次執行的長度,之後每重啟一次,週期就乘上 。用論文最常出現的 、 算一次:
| 第幾次執行 | 週期長度 | 結束於 epoch |
|---|---|---|
| 1 | 10 | 10 |
| 2 | 20 | 30 |
| 3 | 40 | 70 |
| 4 | 80 | 150 |
| 5 | 160 | 310 |
在 200 個 epoch 的預算裡,完整跑完的只有前四次,第五次跑到一半就結束了。換成 、,重啟會落在第 1、3、7、15、31、63、127 個 epoch。
週期加倍的用意,是先用很短的週期快速拿到一個堪用的模型,再用愈來愈長的週期換更好的結果,和前面提到演化策略每次重啟就把族群加倍是同一個思路。另一種設定是 ,每 個 epoch 重啟一次;當 時,整個訓練就只有一條 cosine,完全沒有重啟。這條線後面會變得很重要。
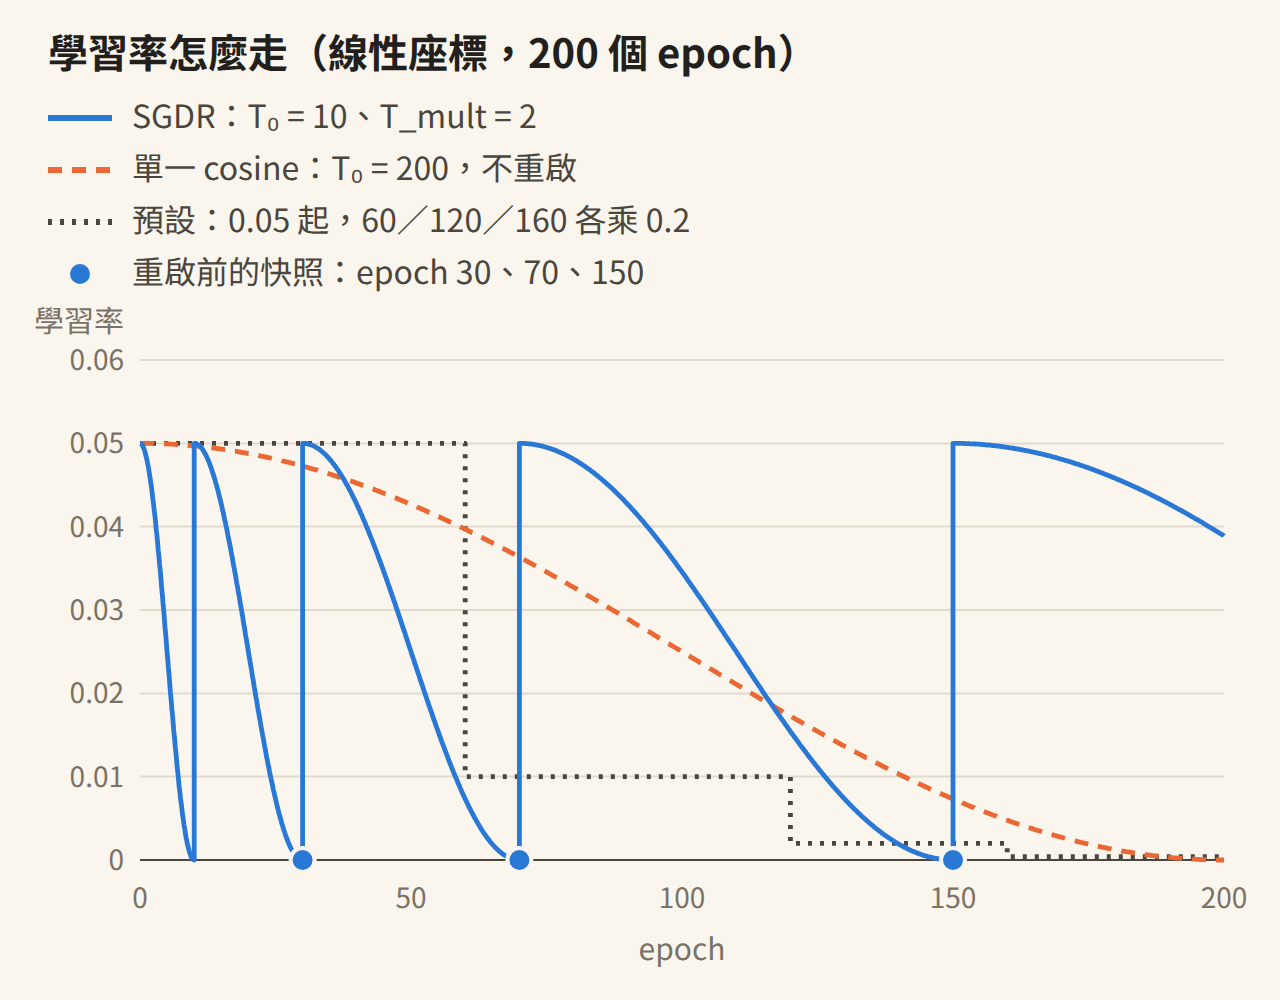
原論文畫這幾條排程時用的是對數座標,作者自己也承認對數軸讓人看不出 cosine 的形狀,所以這裡改用線性座標重畫。藍線每次掉到 0 就立刻跳回 0.05;橘色虛線則從 0.05 一路慢慢降到 0。
要交出哪一個模型?
學習率突然拉高,模型會暫時變差,所以 SGDR 不一定交出最後一步的參數。第一次重啟之前,推薦的就是最新的 ;之後則交出最近一次跑完的週期結尾,也就是學習率剛降到 的那個模型。以上表為例,訓練到第 200 個 epoch 時,SGDR 交出的是第 150 個 epoch 的模型。作者強調,這個規則不需要另外切一份驗證集來挑模型。
為什麼要重啟
第 2 節回顧了兩條脈絡。不用梯度的最佳化拿重啟來對付多峰函數;用梯度的最佳化則多半拿重啟來加快收斂,例如 O'Donoghue 與 Candès(2012)發現 Nesterov 加速法在動量用過頭時會週期性地震盪,於是在目標函數變大、或動量方向與負梯度夾成鈍角時重啟。
隨機梯度的情況不同,單一 batch 的損失與梯度太吵,這些判斷條件沒辦法直接搬來用,要先平均(例如每個 epoch 一次)才行。作者選了最簡單的版本,按固定時程重啟。他們在討論裡也說得很保守,SGDR 的主要目的是改善 anytime performance,沒有宣稱觀察到任何和多峰性有關的效果。
討論
實驗設定
主要實驗是在 CIFAR-10 和 CIFAR-100 上訓練 WRN-28-10(28 層、每層濾波器數是原始 ResNet 的 10 倍,約 3,650 萬參數)。作者先重現 WRN 原論文的設定,動量 0.9、權重衰減 0.0005、批次大小(batch size)128、200 個 epoch,資料增強用水平翻轉,以及 4 像素反射填補後的隨機裁切。和原設定只差兩處,一是只減去逐像素平均、不做 ZCA 白化,二是動量用式 (3)(4) 的一般版本,不用 Nesterov 動量。
單一模型
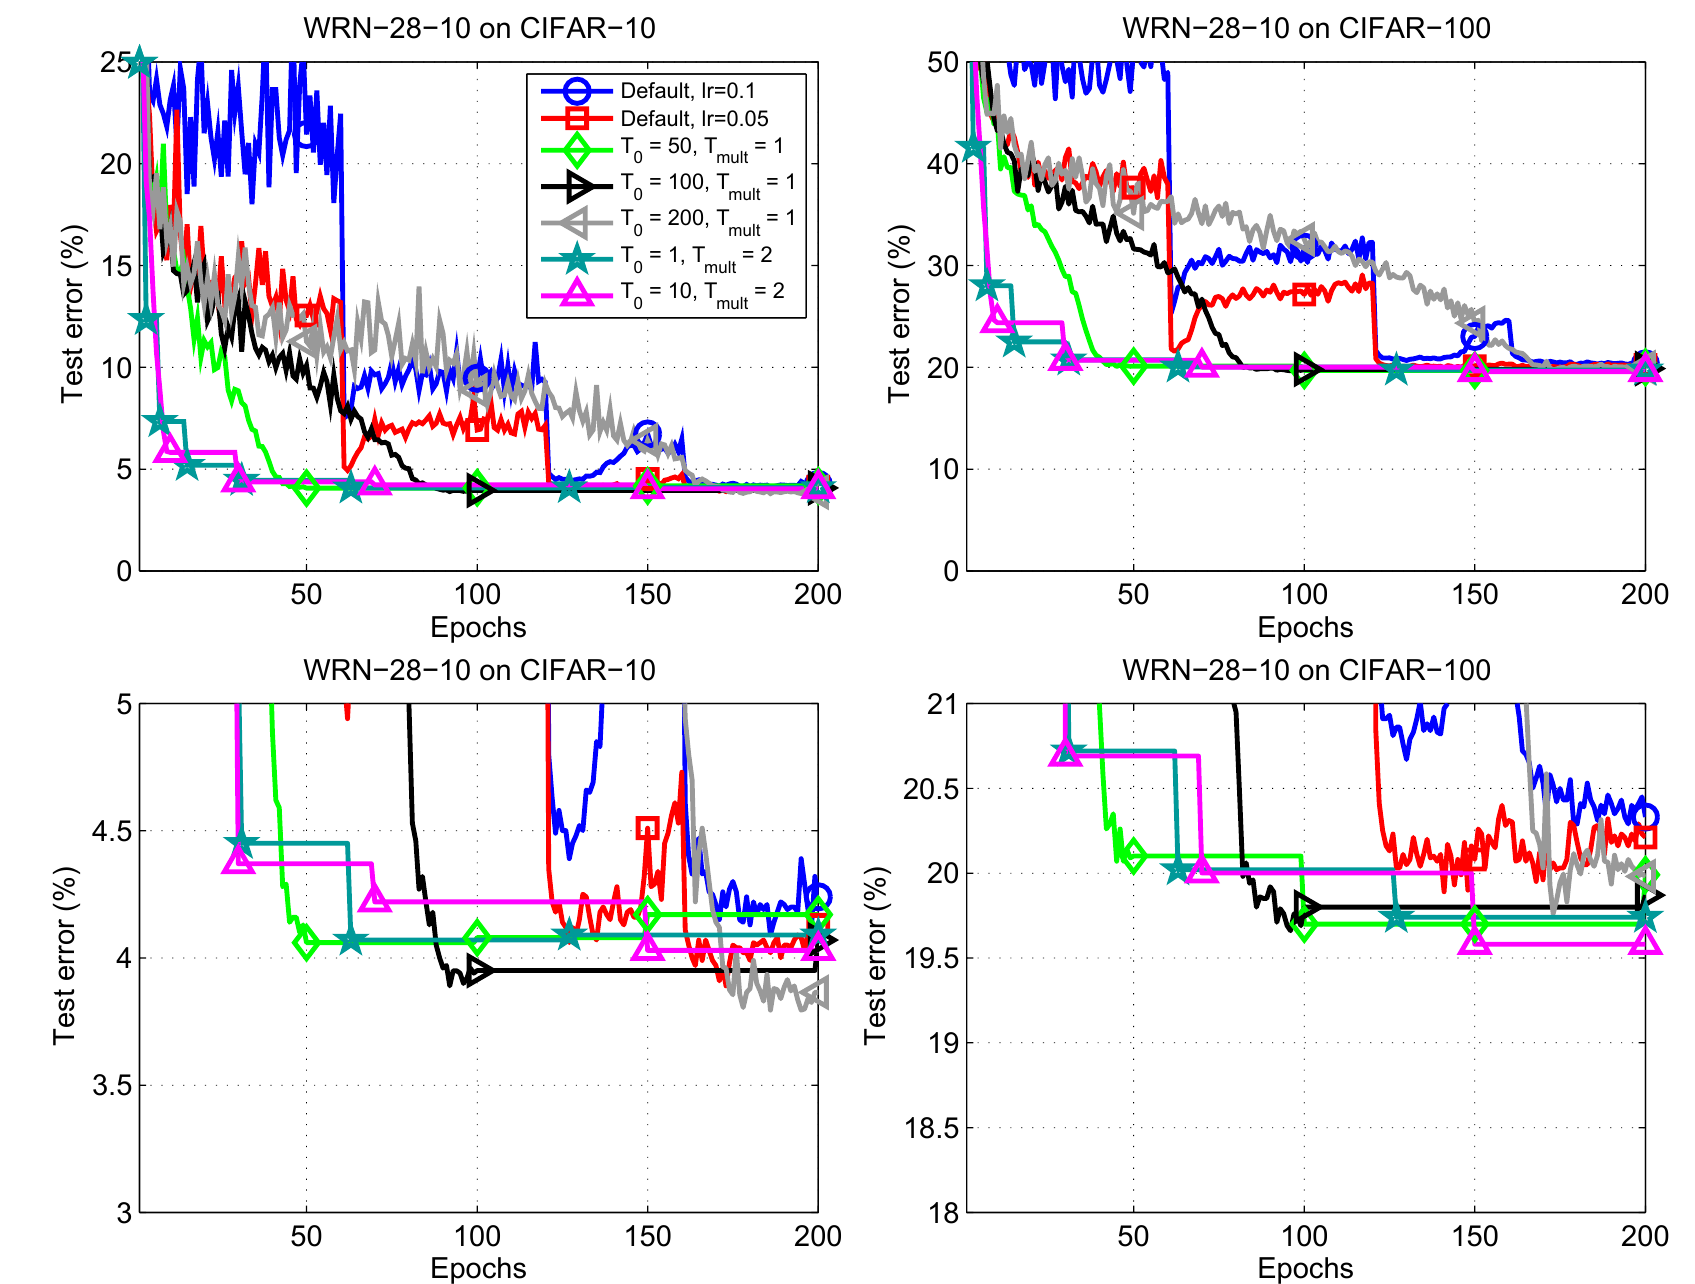
先看上排。藍線和紅線是預設排程,在第 60 個 epoch 降學習率之前,CIFAR-10 的測試誤差都在 12% 以上,降過一次之後也還在 7% 到 10% 之間;CIFAR-100 那邊,紅線在兩次降學習率之間甚至往上爬。SGDR 的線畫的是推薦解,所以呈階梯狀;週期加倍的綠星()和洋紅三角()在幾十個 epoch 內就掉到低誤差區。下排把同一組結果放大,可以看到最後幾個 epoch 誰高誰低。
作者的結論是,SGDR 能用 2 到 4 倍少的 epoch,達到 CIFAR-10 約 4%、CIFAR-100 約 20% 的測試誤差。最終數字整理如下:
| WRN-28-10 的排程 | CIFAR-10 | CIFAR-100 |
|---|---|---|
| 預設,η₀ = 0.1 | 4.24 | 20.33 |
| 預設,η₀ = 0.05 | 4.13 | 20.21 |
| T₀ = 50,T_mult = 1 | 4.17 | 19.99 |
| T₀ = 100,T_mult = 1 | 4.07 | 19.87 |
| T₀ = 200,T_mult = 1 | 3.86 | 19.98 |
| T₀ = 1,T_mult = 2 | 4.09 | 19.74 |
| T₀ = 10,T_mult = 2 | 4.03 | 19.58 |
整理自原論文 Table 1;測試誤差(%),五次執行的中位數。
讀這張表要注意兩件事。第一,差距多半只有零點幾個百分點,每組只跑五次,作者在表說明裡也寫了,粗體只是標出較好的數字,沒有做統計檢定。第二,CIFAR-10 上最好的單一模型是 3.86%,來自 、,也就是一條完整的 cosine、完全沒有重啟。作者據此認為 WRN 原本的階梯排程可能不是最好的選擇;但這組設定的 anytime performance 也最差,直到最後幾個 epoch 才追上來。
省下來的時間,作者拿去訓練更寬的 WRN-28-20(1.458 億參數,計算量約為 3 到 4 倍)。CIFAR-10 好了約 0.25 個百分點,CIFAR-100 好了 0.5 到 1 個百分點,、 拿到 3.74% 與 18.70%。只看前 50 個 epoch,WRN-28-20 配上還沒重啟過的 ,在 CIFAR-100 上已經低於 19%,而 WRN-28-10 不論用哪種排程,都沒有好過 19.5%。
附錄的訓練曲線還補了一個觀察。到第 120 個 epoch 左右為止,SGDR 的訓練損失都降得比預設排程快;之後預設排程開始過擬合,測試損失往上走,SGDR 只有輕微的過擬合。
免費的快照集成
SGDR 的 arXiv 初版出來之後,Huang 等人的 Snapshot Ensembles 拿它的週期做集成。每次重啟前,學習率剛降到最低,模型停在一個不錯的位置,把這些快照存下來,就能在不增加訓練成本的情況下湊出一組模型。這篇的正式版回頭檢驗,這個想法在 WRN 上是否成立。
做法是用 、 的 SGDR 訓練 WRN-28-10,在第 30、70、150 個 epoch 存快照,也就是排程圖上的三個藍點。推論時,把各快照 softmax 輸出的機率等權平均。
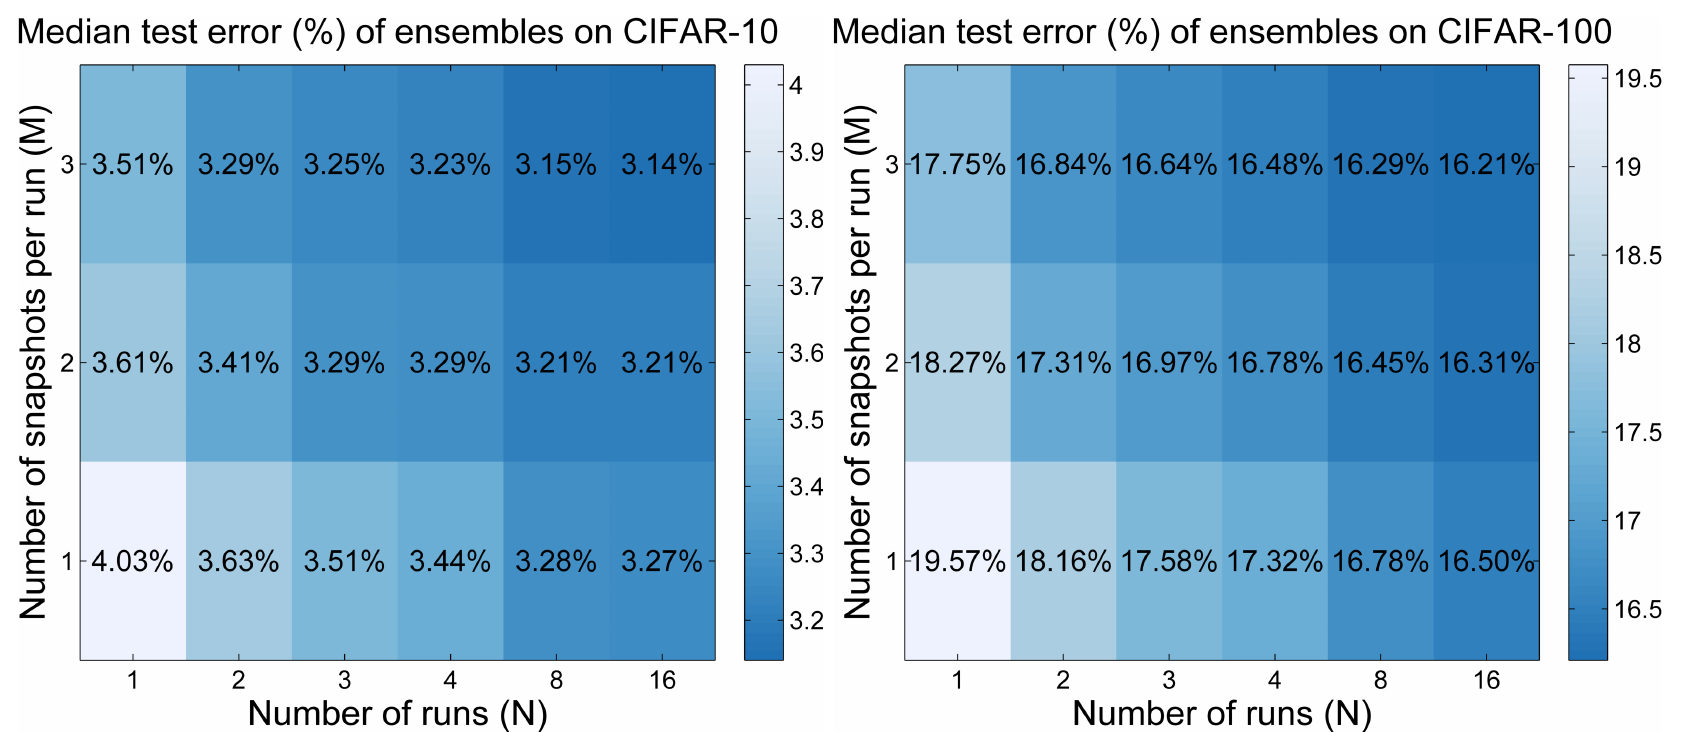
橫軸是獨立訓練幾次(),縱軸是每次取幾個快照()。左下角是單一模型,CIFAR-10 4.03%、CIFAR-100 19.57%(16 次的中位數)。往上走到 ,同一次訓練的三個快照就降到 3.51% 與 17.75%。要靠獨立訓練達到相近的效果,得跑 次(3.51% 與 17.58%),所以在這個設定下,快照大約省了三倍的訓練量。
快照從哪裡來也很重要。如果只拿最後三個 epoch(148、149、150)的模型做集成,結果和只用第 150 個 epoch 的模型一樣,沒有改善。重啟前的快照有用,是因為它們來自不同的週期,預測彼此有差異。
兩種做法可以疊在一起。3 次訓練各取 3 個快照,誤差降到 3.25% 與 16.64%;16 次訓練各取 3 個快照,就是摘要裡的 3.14% 與 16.21%,論文宣稱的當時 CIFAR 最佳結果,只是那是 48 個模型的集成。兩個資料集的趨勢也不完全一樣。CIFAR-10 上 9 個快照(、)的 3.25%,已經和 16 個獨立模型的 3.27% 相當;CIFAR-100 上,16 個獨立模型的 16.50% 仍然比 9 個快照的 16.64% 好一點。
EEG 與降採樣 ImageNet
為了說明方法不只適用於 CIFAR,作者另外做了兩組實驗。
第一組是腦電圖(EEG)資料,14 位受試者、每人約 1,000 次試驗,要分類實際的左右手與腳的動作,網路沿用 Schirrmeister 等人設計的卷積網路。基準排程要先決定總 epoch 數(從 30 到 480),再按比例在固定的時間點把學習率降 10 倍;預算給得越多,結果越好。SGDR 不必事先決定預算,最後的表現和基準差不多,中途的表現更好。用快照做集成也有效。中位數約 9% 的參考誤差,取單次訓練的快照能再降 1 到 2 個百分點,結合兩組學習率的快照則能降 2 到 3 個百分點。
第二組用的是作者自己做的降採樣 ImageNet,1,000 類與影像都和原本相同,只是用 box downsampling 縮成 32 × 32(這份資料集後來在 2017 年另外發表)。每張影像的平均像素少了兩個數量級,所以比原本的 ImageNet 難;類別更多,物體又常只佔畫面一小塊,也比 CIFAR 難。在 WRN-28-10 上比較預設排程與兩組 SGDR,各用 4 種初始學習率(0.05、0.025、0.01、0.005)。、、 的 SGDR 拿到 top-1 39.24%、top-5 17.17% 的誤差,和 AlexNet 在原解析度 ImageNet 上的 40.7% 與 18.2% 相當。這組實驗只跑了約 40 個 epoch,作者自己也稱之為初步結果;和 AlexNet 的比較跨了解析度與模型,只能當作參考座標。
作者對這組結果的解讀是,初始學習率選得好不好影響很大,而 SGDR 每個週期都從初始值一路掃到 0,等於試過一整段學習率,減輕了選錯初始值的傷害。
重啟真的是重點嗎?
CIFAR-10 上最好的單一模型,WRN-28-10 的 3.86% 與 WRN-28-20 的 3.66%,都來自沒有重啟的 。作者在討論裡也寫,即使完全不重啟,式 (5) 這個積極的排程和預設排程相比也很有競爭力,而且只需要初始學習率和總 epoch 數兩個超參數。
後續研究把這件事說得更明白。Gotmare 等人(ICLR 2019)用 mode connectivity 分析 SGDR 的軌跡,在 CIFAR-10 上訓練 VGG-16,排程同樣是 、。第 30 與 150、第 70 與 150 個 epoch 的模型之間,連線上的訓練損失確實比兩端高,表示重啟後參數越過了一道障礙;但第 70 與 150 個 epoch 的模型既不算區域極小值,看起來也不在不同的盆地裡,所以「跳出區域極小值」的說法可能過於簡化。他們在註腳裡另外提到,實驗中一直表現不錯的,是在整個預算裡做一次 cosine(或線性)衰減,他們推測真正起作用的是衰減,重啟的貢獻比較小。
實務上大家也是這樣用的。fast.ai 在 2017 年的課程用 cycle_len 和 cycle_mult 推廣過 SGDR;到了 2018 年底的 fastai v1,維護者在論壇上回覆,這個寫法已經不能用了,預設改成 1cycle。後來的大型訓練,多半只跑一個 cosine 週期:
- Bag of Tricks(He 等人,2018)在 ImageNet 上用的是「簡化版」,學習率沿 cosine 從初始值一路降到 0(暖身階段另計)。
- GPT-3 用 cosine 把學習率降到原本的 10%,橫跨 2,600 億個 token,之後維持在 10%;前 3.75 億個 token 線性暖身。
- LLaMA 的 cosine 排程讓最終學習率等於最大值的 10%,前 2,000 步暖身。
只跑一個週期,就得事先知道總步數,SGDR 想處理的問題又回來了。Chinchilla 的附錄把代價量化了,cosine 週期設得比實際訓練步數長 25% 以上,模型就會明顯變差。之後的 WSD(暖身、固定、衰減三段式的排程)、WSM 和 Schedule-Free,處理的都是這件事。
結論
SGDR 把學習率排程寫成一條公式。每個週期從 沿 cosine 降到 ,週期長度由 和 決定,週期結束就把學習率拉回高點重來。在 CIFAR 上,它用 2 到 4 倍少的 epoch 達到和階梯排程相當的誤差,重啟前的快照還能免費組成集成;而 CIFAR-10 上最好的單一模型,來自一條不重啟的 cosine。
如果你知道總共要訓練多久,最省事的做法是一個完整的 cosine 週期,讓 等於總步數,需要的話在前面加暖身,CosineAnnealingLR 就是這個版本。只有想做快照集成、或真的不知道預算的時候,才值得搬出 CosineAnnealingWarmRestarts;這時記得照論文的規則,交出週期結尾的模型,而不是最後一步。
PyTorch 這兩個排程器的名字,其實已經替你選好了。不打算重啟的話,挑名字短的那個就好。