原始論文
The Road Less Scheduled
- 發表版本
- NeurIPS 2024會議
- arXiv 首次提交
- arXiv:2405.15682
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{optimizersschedulefree2024,
  title = {{The Road Less Scheduled}},
  author = {Aaron Defazio and Xingyu Alice Yang and Harsh Mehta and Konstantin Mishchenko and Ahmed Khaled and Ashok Cutkosky},
  year = {2024},
  eprint = {2405.15682},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2405.15682}
}
2024 年 8 月 1 日,MLCommons 公布了第一屆 AlgoPerf 訓練演算法競賽的結果。
如果你沒聽過 AlgoPerf,它比的是優化器與訓練流程本身。模型、資料和硬體(8 張 V100)都固定,看誰最快把 8 個任務訓練到指定的驗證分數,任務橫跨機器翻譯、影像分類、MRI 重建、語音辨識、分子圖與點擊率預測。比賽分兩組。外部調參組可以給一個超參數搜尋範圍,主辦方替你抽 5 組設定來試;自調參組不能在訓練之外搜尋超參數,方法必須在單次訓練裡自己應付所有任務,最常見的做法就是一份設定通吃,作為補償,訓練時間上限放寬到 3 倍。
自調參組只有一份投稿贏過主辦方的基準,就是 Meta 與 Samsung 研究員提交的 Schedule Free AdamW,分數 0.8542;基準是 NAdamW 加線性暖身與 cosine 衰減,0.8194;其他四份都在 0.4 以下。這個方法最大的特點,是完全不用學習率排程,也不必事先知道要訓練多少步。
背後的論文叫〈The Road Less Scheduled〉,題目借用了 Frost〈The Road Not Taken〉裡「less traveled」那一句,結論一節也真的引了原詩。第一作者是 Meta FAIR 的 Aaron Defazio,他之前的 D-Adaptation 也在處理「學習率怎麼設」這件事。程式碼 4 月就以 schedulefree 套件上了 PyPI,論文到 5 月底才放上 arXiv。
定義問題
排程需要終點
現在最常用的學習率排程是 cosine 和線性衰減,兩者都要先知道總步數 ,曲線才畫得出來。 設錯了代價不小,Chinchilla 的附錄量過,cosine 週期設得比實際步數長 25% 以上,模型就明顯變差;訓練到一半想延長,也得重新規劃。
平均在理論上很好,實際上很差
另一條路是不排程,改成平均參數。Polyak–Ruppert 平均是最古典的做法,SGD 照常用固定步長走,另外維護一個所有走過的點的平均:
讓 剛好是 的等權平均。依照經典的收斂理論,凸的 Lipschitz 問題該交出 ,而不是最後一步的 。實際上,這個平均比 SGD 的最後一步差很多,作者稱之為最佳化領域的民間共識。
近年的理論又指出,線性衰減排程本身就能讓最後一步達到最差情況下的最佳速率。排程和平均在理論上扮演差不多的角色,但排程得先知道 。作者於是問,有沒有一種平均方法,實際表現追得上排程,又不放棄理論保證?
解決問題
三個序列
Schedule-Free SGD 的更新是式 (3) 到 (5):
起點 。三個序列各有分工:
- 是基礎序列,底下的優化器在這裡走步,這裡就是一般的 SGD。
- 是評估序列, 的等權平均,也是最後交出去的模型。
- 是算梯度的位置,在 和 之間內插。
和 Polyak–Ruppert 平均比,只多了第一行,梯度不在 上算,改在 與 之間的 上算。
兩個極端
控制 偏向哪一邊。 時 ,梯度在 上算,就是 Polyak–Ruppert 平均。 時 ,梯度在平均點上算,這叫 primal averaging,同樣有最差情況的最佳保證,但一般認為收斂太慢,不實用。
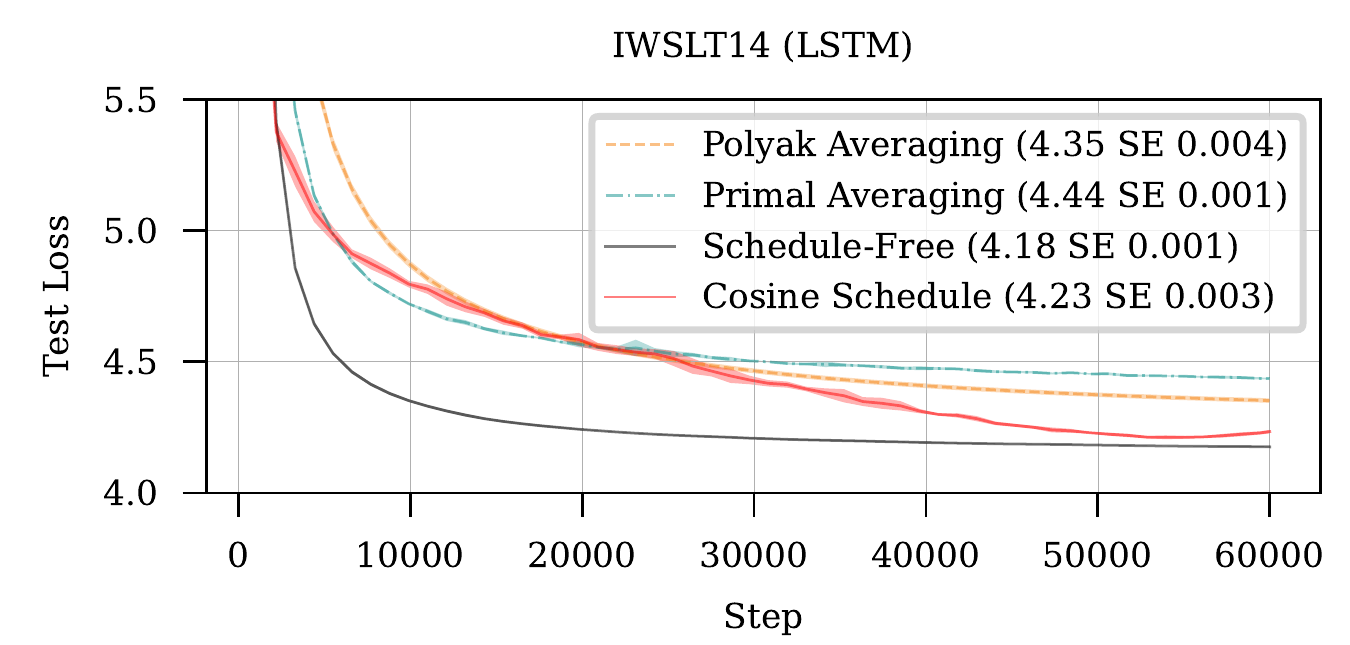
這張圖是 IWSLT14 德翻英的 LSTM。兩個極端都輸給調好的 cosine 排程,Polyak 平均最後是 4.35,primal averaging 是 4.44,cosine 是 4.23。Schedule-Free 取中間,,最後 4.18,而且前 1 萬步就降得比誰都快。
作者的解釋是, 移動得比 快,所以內插保留了 Polyak 平均收斂快的優點; 又被拉向 ,讓算梯度的位置不會離交出去的模型太遠,增加穩定性。
另一種動量
的角色很像動量,論文也把它和一般的指數移動平均(EMA)動量比較。第 步的梯度 進入 時,立即的影響是 , 時就是 ,這和 EMA 動量一樣。差別在剩下的 90%。EMA 動量在接下來大約 10 步內就把大部分加完;Schedule-Free 則是透過 這個平均,非常緩慢地把它加進來。
這種動量在理論上沒有副作用。Theorem 1 說,若 是凸函數、每個樣本的損失 都是 -Lipschitz、樣本獨立同分布,取 ( 是起點到最佳解的距離),那麼對 裡的任何 :
這是非光滑凸問題的最佳速率,連常數都一樣。相比之下,EMA 動量在同一個設定下,反而會讓最差情況的保證變差。
不就是遞減排程嗎?
讀到這裡你可能會問, 的更新裡有一個 ,這不就是一個遞減的學習率嗎?
某種意義上是的。作者用 Figure 4 說明,每一步的梯度最後在 與 裡各佔多少比例:
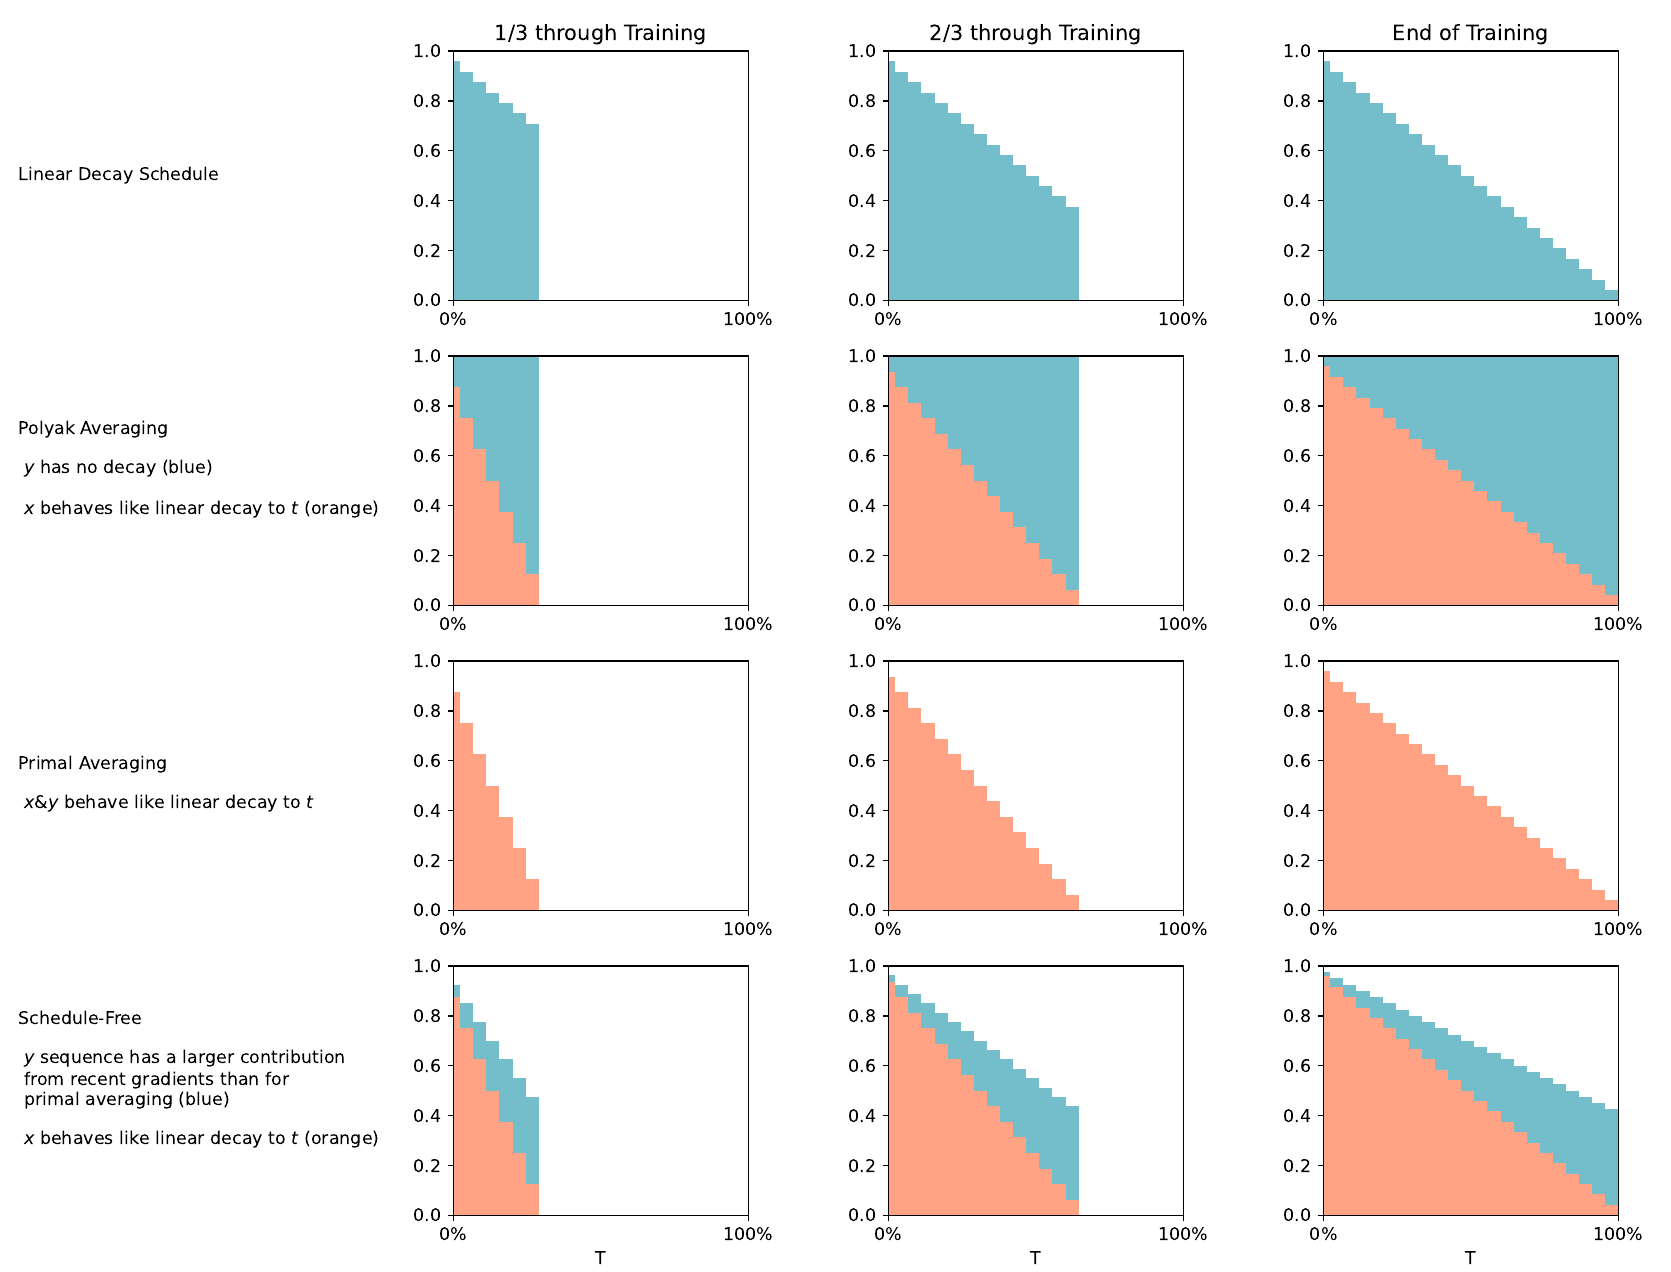
先看第一列。線性衰減排程走到 1/3、2/3、終點時,每一步的梯度依當時的學習率被加進參數,越後面的步伐越小,所以是一個斜坡;但這個斜坡的終點固定在 。
再看下面三列的橘色部分,也就是 。三種平均方法的 ,在每個時間點都長得像一個終點就在當下 的線性衰減。平均能取代排程,原因就在這裡。它其實隱含了一個排程,只是這個排程的終點會跟著 往前移,不必事先知道 。
藍色部分是 ,三種方法的差別在這裡。Polyak 平均的 就是 ,每一步的梯度都完整算進去,訓練後期近期梯度的份量比排程大得多;primal averaging 的 就是 ,近期梯度被壓得很小,前期收斂慢;Schedule-Free 在兩者之間,對近期梯度的份量稍微補強。
附錄 B 把這件事寫成代數。令 是基礎優化器的一步,,那麼在等權平均、 固定時, 每一步的實際移動量是:
也就是一個動量項,加上 倍的基礎步伐。如果讓 隨時間變化,恰好取成 時,動量項的係數會整個消掉,剩下的就是線性衰減排程。Schedule-Free 選擇固定 ,所以不需要 。
理論涵蓋到哪裡
Theorem 1 其實是更一般的 Theorem 2 的特例。Theorem 2 允許任意的線上學習演算法產生 、任意的平均權重 與內插係數 ,把它們的 regret 轉成隨機最佳化的收斂保證,也就是一種 online-to-batch conversion。設 得到經典的 Polyak 平均, 得到 primal averaging(Defazio 先前的研究指出它等價於 heavy-ball 動量), 則得到線性衰減排程的最後一步保證。附錄 C 再把它收緊成等式,推出光滑問題上的加速速率。
條件也要說清楚。這些保證都在凸問題上;Theorem 1 的步長 裡還藏著 ,換成任何時候都成立的 ,實際效果又很差。實務上大家用的是大得多的固定步長 。Theorem 3 說明在一個可以於訓練中檢查的條件下,這麼大的步長也能拿到最佳速率;作者在 4.1 節所有問題上檢查過,條件都成立,但他們也承認,隨機問題下大步長何時可用,還沒有完整的理解。
另一個佐證來自二次函數。作者隨機生成 10 個 20 維的二次問題,掃過 和 。步長小的時候 幾乎沒有影響;步長大的時候, 是收斂的關鍵。
Schedule-Free AdamW
把基礎優化器換成 AdamW,就是 Algorithm 1:
- ,用內插取代動量。
- 在 上算梯度 。
- 。
- ,把暖身與偏差修正都併進學習率。
- 。
- 。
- 。
有幾個地方和 AdamW 不一樣。
- 沒有一階動差。 拿去做內插了,所以只需要存 、 和 ,記憶體和 AdamW 一樣;SGD 版本也和 SGD 加動量一樣。
- 還是要暖身。 作者在 4.4 節直說,這個方法仍然需要學習率暖身。
- 平均的權重跟著學習率走。 有暖身時,作者改用 當平均的權重,暖身期間學習率小的那幾步,在平均裡的份量也跟著變小;他們發現這樣做效果大幅改善。暖身結束後, 就回到 的速度遞減。
- 權重衰減算在 上。 也可以算在 上,但在 ImageNet 與 NanoGPT 等問題上,算在 明顯比較好。
實作細節
訓練時算梯度要用 ,評估時要用 ,所以模型參數得在兩者之間切換。官方 PyTorch 實作只多存一份 ,參數本身的緩衝區在訓練時存 、評估時存 。由 可以解出 ,optimizer.eval() 做的就是這個內插,optimizer.train() 再換回 。
這帶來幾條使用規則。model.train() 的地方要一起呼叫 optimizer.train(),model.eval() 的地方要呼叫 optimizer.eval(),存 checkpoint 前也要切到 eval 模式,否則存下來的是 而不是 。如果程式支援 PyTorch 的 step closure,可以改用 closure 版本,省掉這些切換。
BatchNorm 最麻煩。BN 的 running mean 與 variance 是在訓練時、也就是在 上累積的,換成 之後統計量就對不上。官方 README 給的修正是評估前用 跑幾十個訓練批次,重新累積統計量:
model.train()
optimizer.eval()
with torch.no_grad():
    for batch in itertools.islice(train_loader, 50):
        model(batch)
model.eval()
LayerNorm 這類不靠批次統計量的正規化層就沒有這個問題。README 另外提醒,如果框架另外快取了一份 fp16 參數(某些 GradScaler 會這樣做),也要手動更新,確保評估用的是 。
討論
實驗設定
作者稱這是目前規模最大的優化器評測之一,總共 28 個問題,包括 12 個邏輯迴歸、9 個深度學習任務,以及 AlgoPerf 的 7 個任務。深度學習任務裡,CIFAR-10、CIFAR-100、SVHN、ImageNet 用 Schedule-Free SGD,IWSLT14、DLRM、fastMRI、MAE 微調與 NanoGPT 用 Schedule-Free AdamW。
比較的方式是兩邊都在網格上掃學習率與權重衰減,Schedule-Free 另外在 0.9 與 0.98 兩個 中挑一個;在習慣用階梯排程的任務上,也加上階梯排程一起比。
一次訓練,畫出整條前緣
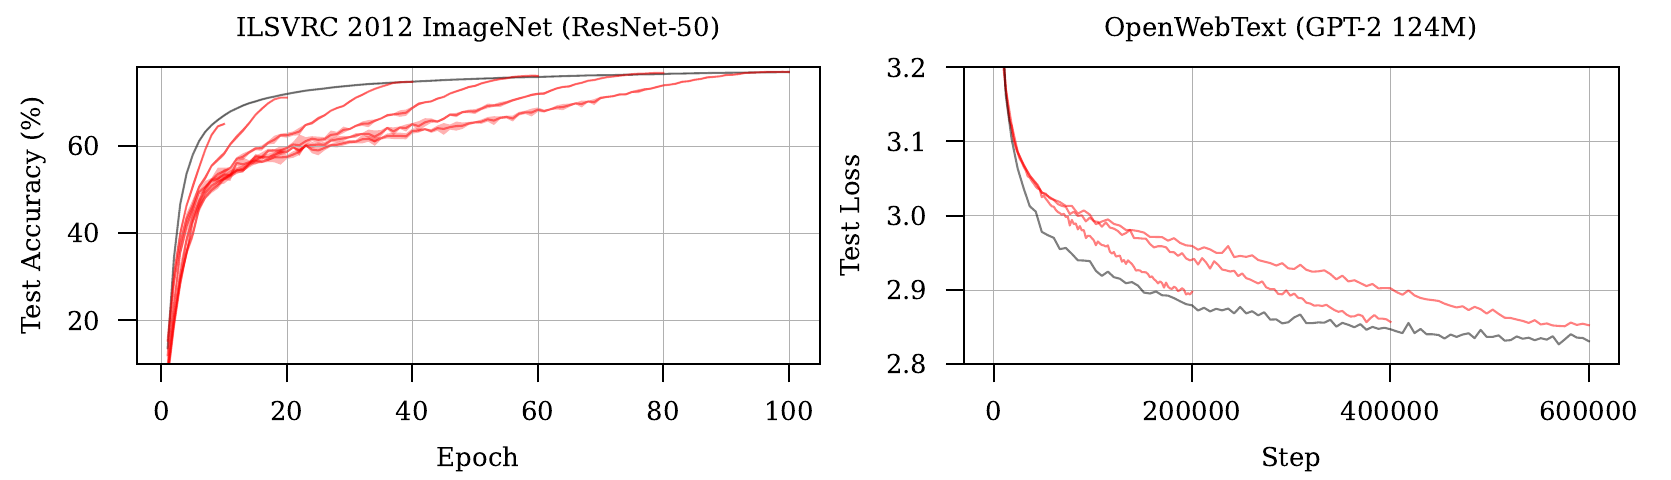
紅線是多條長度不同的 cosine 排程,每一條都要到自己的終點才最好;把這些終點連起來,就是「訓練時間對表現」的前緣。黑線只訓練一次,卻在每個時間點都貼著這條前緣,GPT-2 那邊甚至在大部分時間都在紅線下方。換句話說,訓練到哪裡停,都差不多等於事先為那個長度調好了一條 cosine。
九個深度學習任務
| 任務 | 指標 | Schedule-Free | 最佳排程 |
|---|---|---|---|
| CIFAR-10 | 準確率 | 96.03 | 95.73 |
| CIFAR-100 | 準確率 | 78.71 | 77.41 |
| SVHN | 準確率 | 98.40 | 98.27 |
| ImageNet | 準確率 | 76.90 | 76.90 |
| IWSLT14 | 損失 ↓ | 4.18 | 4.23 |
| fastMRI | SSIM | 0.9112 | 0.9110 |
| Criteo | 準確率 | 0.7915 | 0.7906 |
| MAE 微調 | 準確率 | 83.54 | 83.52 |
| GPT-2 124M | 損失 ↓ | 2.831 | 2.853 |
整理自原論文 Figure 2 與 Figure 5 的圖例。最佳排程欄是作者調好的 cosine 或線性衰減排程;ImageNet 用 ResNet-50,GPT-2 124M 是 NanoGPT 在 OpenWebText 上的設定。
七個任務贏過調好的排程(fastMRI 與 Criteo 的差距很小),ImageNet 與 MAE 微調打平。差距最大的是 CIFAR-100,多了 1.3 個百分點;ImageNet 上兩者都是 76.90%,階梯排程是 76.49%。
這些數字背後有幾個設定值得一看。
- 學習率大很多。 CIFAR-10 上 Schedule-Free 的學習率是 10,cosine 是 0.2;ImageNet 是 1.5 對 0.05;NanoGPT 是 0.005 對 0.0005。作者認為,能用更大的學習率而不發散,可能是收斂較快的原因之一。
- NanoGPT 要特別處理。 時損失會在訓練中途快速上升,要改成 0.98 才穩定;梯度裁剪也必須關掉,作者說這一點很關鍵。
- 梯度沒有崩掉。 在 CIFAR-10 上,用 cosine 排程的 SGD 到了後期訓練損失接近 0,梯度範數也跟著崩到接近 0,之後幾乎學不動;Schedule-Free 沒有這個現象。作者認為這可能是它在 CIFAR 與 SVHN 上特別好的原因。
附錄還補了 Polyak 平均與 primal averaging 在同一組任務上的結果,兩者都明顯落後。ImageNet 上分別是 72.84% 與 69.78%,NanoGPT 上 Polyak 平均的損失直接發散。
AlgoPerf
論文裡的 AlgoPerf 結果,是作者自己照比賽規則、拿 NAdamW 基準跑 10 個隨機種子的比較。ResNet-50 任務被排除,因為 AdamW 與 NAdamW 都到不了目標。剩下 7 個任務,Schedule-Free AdamW 在 WMT、ViT、fastMRI、OGBG 上較快,Conformer 和 Criteo 打平,DeepSpeech 稍慢。作者把這兩個任務的表現歸因於 BatchNorm,Conformer 與 DeepSpeech 都用 BN,而比賽的程式框架不方便在 上重算 BN 統計量。
附錄也列出了自調參組用的那一份設定,學習率 0.0025、、、權重衰減約 0.081、暖身 2%,平均的權重另外乘上 。
官方的結果則在 MLCommons 的公告與主辦方後來在 ICLR 2025 發表的分析裡。自調參組裡,Schedule Free AdamW 是唯一勝過基準的投稿,平均訓練時間快約 8%,在 8 個基礎任務中有 4 個最快;拿它和外部調參組的基準比,在雙方都訓練成功的 7 個任務上,它不調參也快了約 10%。同一組人也帶著 5 組設定的版本參加外部調參組,拿到第二名(0.7077),輸給 Distributed Shampoo 的 0.7784;在雙方都成功的 7 個任務上,Shampoo 比自調參的 Schedule-Free AdamW 快約 24%。
還有一個小插曲。自調參組的獎金最後沒有頒出。MLCommons 的公告寫著,由於多份參賽作品的單位與工作小組主席重疊,未達頒獎條件。
對動量的敏感度
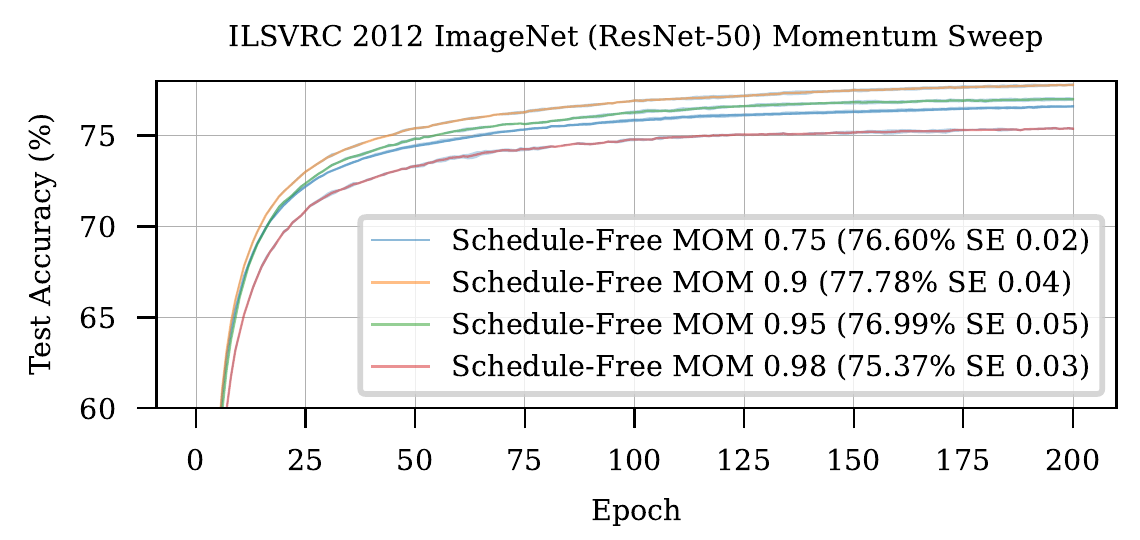
如果最佳的 會隨訓練長度改變,「不用知道 」就只是把問題從排程搬到動量上。作者在 ImageNet 上跑了比平常長的 200 個 epoch,掃四種動量。不論在哪個時間點停下來看,最好的都是 。學習率的敏感度也和 cosine 排程差不多,只有訓練很短(25 個 epoch 以內)時,大一點的學習率比較好。
不過其他證據沒有這麼樂觀。NanoGPT 本身就得把 調到 0.98;官方 README 也寫著,訓練特別長時可能要把 提高到 0.95 或 0.98。Hägele 等人(NeurIPS 2024)在 2.1 億參數的語言模型上,拿 Schedule-Free AdamW 和「固定學習率加最後一段線性冷卻」(類似 WSD)比較。 時明顯較差,訓練後段損失甚至往上走;換成 表現很好,但兩組設定都被冷卻排程追平或超越。他們也沒有再為任何一方多調超參數。
限制
作者在結論裡寫得很明白,最主要的實務限制是得重新掃學習率與權重衰減,因為最佳值和用排程時不同。其他需要留意的地方,前面大多已經提過。
- 暖身仍然需要。論文的實驗大多把暖身設成總訓練量的 5%,AlgoPerf 的設定是 2%,嚴格說來,這裡還是用到了訓練長度。
- BN 需要在 上重算統計量;訓練與評估要切換模式,存 checkpoint 也一樣。
- 理論只涵蓋凸問題,大步長何時可用還沒有完整的理論。
- 對長時間的語言模型訓練比較敏感。
結論
Schedule-Free 用三個序列取代學習率排程。基礎優化器在 上走步, 是 的平均,梯度在兩者之間的 上計算。平均本身隱含了一個終點隨時移動的線性衰減排程,所以不必事先知道 ;在凸問題上,任何 都保有最佳的最差情況速率。9 個深度學習任務中它贏了 7 個、平手 2 個,並拿下 AlgoPerf 2024 自調參組的第一名。
想試用的話,換掉優化器之後,記得在 model.train()、model.eval() 旁邊加上對應的 optimizer.train()、optimizer.eval(),存 checkpoint 前切到 eval;有 BN 的模型,評估前用 重算統計量。學習率從排程版本的 1 到 10 倍(AdamW)或 10 到 50 倍(SGD)開始試, 先用 0.9,訓練很長時往 0.95、0.98 調,暖身照留。
畢竟名字叫 Schedule-Free,Algorithm 1 的第 8 行還是寫著 。