原論文
Accurate, Large Minibatch SGD: Training ImageNet in 1 Hour
- 発表先
- 正式な発表先は未確認
- arXiv への初回投稿
- arXiv:1706.02677
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{optimizerslargeminibatchsgd2017,
  title = {{Accurate, Large Minibatch SGD: Training ImageNet in 1 Hour}},
  author = {Priya Goyal and Piotr Dollár and Ross Girshick and Pieter Noordhuis and Lukasz Wesolowski and Aapo Kyrola and Andrew Tulloch and Yangqing Jia and Kaiming He},
  year = {2017},
  eprint = {1706.02677},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1706.02677}
}
8 枚の Tesla P100 で ResNet-50 を訓練すると、バッチサイズ 256 で ImageNet の 90 エポックを走り切るのに 29 時間かかる。
2017 年 6 月、Facebook のチームは同じモデルを 256 枚の GPU に載せ、バッチサイズを 8,192 にして、1 時間で訓練を終えた。検証セットの top-1 誤差は、もとと 0.14 ポイントしか違わない。著者リストには Ross Girshick、Piotr Dollár、Kaiming He がいて、Caffe の作者 Yangqing Jia もいる。
GPU が 32 倍に増えて、時間は 29 分の 1 になった。ハードウェアを積み上げただけの成績に見える。しかしこの技術報告が最も多くの紙幅を割いているのは、ハードウェア以外の部分だ。バッチが 32 倍になったら学習率をどう調整するか、訓練の最初になぜ問題が起きるのか、BatchNorm をどう計算するか、そして間違えて書いてもそのまま動いてしまい、結果だけが悪くなるいくつかの実装の細部である。
問題の定義
同期型の分散 SGD では、 個の worker(この論文では 枚の GPU)がそれぞれ 件のデータで勾配を計算し、勾配を合計したあと、全員が同じ結果でパラメータを更新する。各ステップで見るデータは 件になる。
各カードに十分な仕事を与えるには をあまり小さくできないので、GPU が増えるほど全体のバッチは大きくなる。同じ 90 エポックを走らせるなら、バッチが 32 倍になれば更新回数は 32 分の 1 になる。
当時、大きなバッチの評判はあまり良くなかった。Krizhevsky は 2014 年に、学習率をバッチに比例して大きくするやり方を使ったが、バッチを 128 から 1,024 に増やすと誤差が 1 ポイント増えた。Keskar ら(2017)は、大きなバッチは鋭い極小値に収束し、汎化が悪くなると主張した。5,120 のバッチで精度を落とさなかった例もあるが、ハイパーパラメータを探索せずに済む調整規則は示されていなかった。
この論文が答えようとしているのは、バッチを 256 からどんどん大きくしていくとき、単純な規則一つだけで、どのハイパーパラメータも調整し直さずに、小さなバッチの精度を保てるか、という問いだ。できないなら、どこで壊れるのか?
問題の解決
線形スケーリング則
著者らの規則はたった一文だ。バッチを 倍にしたら、学習率も 倍にする。重み減衰などほかのハイパーパラメータは一切変えない。
なぜ 倍なのか? で一度たどってみよう。小さなバッチの SGD の 1 ステップは次のとおりだ。
二つの小さなバッチ 、 で続けて 2 ステップ進むと、2 ステップ目の勾配は で計算される。
二つの小さなバッチを大きさ の大きなバッチ一つにまとめ、学習率 で 1 ステップだけ進むと、
二つの式の違いは 2 か所だけだ。一つは 2 番目の小さなバッチの勾配を で計算するか で計算するか、もう一つは前の係数だ。パラメータが 1 ステップ進んでも勾配があまり変わらない、つまり なら、二つの式を等しくするには 、つまり とすればよい。 個の小さなバッチに一般化したものが、論文の式 (3)(4) と だ。
著者ら自身もこれは強い仮定だと述べ、少なくとも二つの場合には明らかに成り立たないと指摘している。一つ目は訓練の始まりで、ネットワークの変化が速く、隣り合う数ステップの勾配が大きく違う。二つ目は、バッチをどこまでも大きくはできないことだ。結果はかなり広い範囲で安定しているが、ある点を越えると精度が急速に悪くなり、ImageNet ではその点はおよそ 8k だ。
一つ目の場合は、ウォームアップに任せる。
ウォームアップ
以前の ResNet の論文は定数ウォームアップを使っていた。最初の数エポックは、小さな固定の学習率を使う。著者らは 8k のバッチでそれをまねて、最初の 5 エポックは 、その後いきなり に切り替えてみたが、それでは足りないことがわかった。低い学習率から切り替えた瞬間に、訓練誤差が急激に跳ね上がる。
そこで彼らは段階的ウォームアップ(gradual warmup)に変えた。 から始めて各ステップで一定量ずつ足し、5 エポック後にちょうど に達するようにして、そのあとはもとのスケジュールにつなぐ。
8k のバッチの場合を計算してみよう。ImageNet の訓練セットは約 128 万枚で、1 エポックは約 156 ステップ、5 エポックは約 780 ステップだ。学習率を 0.1 から 3.2 まで上げるには、1 ステップあたり約 0.004 ずつ足すことになる。著者らは、結果はウォームアップの長さにあまり敏感でないとも述べている。
BatchNorm のバッチ
BatchNorm は一つのバッチの中で平均と分散を計算するので、各データの損失は自分自身だけでなく、同じバッチのほかのデータにも依存するようになる。著者らは式 (5) でこのことをはっきり書いている。BN がある場合、訓練セットは「大きさ のすべての部分集合」と考えることができ、部分集合の一つひとつが独立した一つのサンプルになる。
つまり BN のバッチサイズ は、損失関数の定義の一部だ。 が変われば BN の統計量のランダムさも変わり、最適化の目標そのものが別のものになる。そこで著者らは worker ごとの を固定し、GPU を増やすときは だけを増やす。BN の統計量も各 worker の中で個別に計算し、worker をまたいで同期しない。こうすることで通信を節約でき、さらに重要なのは、異なるバッチサイズの実験が同じ目標を最適化するようになることだ。原文はさらに、 を変えたいなら、分散訓練のパラメータではなく、BN のハイパーパラメータとして調整すべきだとわざわざ述べている。
四つの実装の落とし穴
第 3 節には、「間違えて書いても訓練はできるが、誤差が予想より高くなる」細部が四つ挙げられていて、それぞれが一つの Remark にまとめられている。
重み減衰。 重み減衰は、実は損失の L2 項の勾配だ。各データの損失を と書くと、SGD の更新は式 (8) になる。
実際には、逆伝播で計算するのは交差エントロピーの項だけで、 は別に足される。だから交差エントロピー損失に を掛けても、大きくなるのは後ろの項だけで、重み減衰の項は変わらず、学習率に を掛けたのとは効果が違う。これが Remark 1 で、交差エントロピー損失をスケーリングすることと、学習率をスケーリングすることは別物だ。
モーメンタム補正。 モーメンタム SGD には、よく使われる書き方が二つある。参照となる書き方は式 (9) で、モーメンタムバッファ は勾配だけを蓄積し、学習率はパラメータを更新するときに初めて掛ける。
もう一つの書き方は式 (10) で、学習率をバッファに吸収させ、 とする。
学習率が固定なら、二つは完全に等価だ。学習率が変わると違いが出る。 に入っているのは古い学習率を掛けた履歴なので、式 (9) と一致させるには、更新のときにまず を掛けなければならない。著者らはこの比をモーメンタム補正と呼び、学習率を大きく上げたとき()に補正しないと、履歴の項が小さすぎて訓練が不安定になることを見出した。学習率を下げるときは、この補正はそれほど重要ではない。これが Remark 2 で、式 (10) の書き方を使うなら、学習率を変えたらモーメンタム補正をしなければならない。
勾配の集約。 正しい大バッチの勾配は、 件のデータの勾配を合計して で割ったものだ。各 worker の損失層はふつう自分の 件ですでに平均を取っていて、allreduce が行うのは平均ではなく合計なので、 が一つ足りない。著者らは、この を損失にそのまま入れ、損失の入力に関する勾配だけをスケーリングして、勾配ベクトル全体をスケーリングし直す手間を省くことを勧めている。これが Remark 3 で、各 worker の損失は自分の ではなく、全体のバッチ で割らなければならない。原文はさらに、「学習率に を掛けず、損失は でだけ割る」ことで互いに打ち消し合わせるのは誤りで、重み減衰の計算もずれてしまうと注意している。理由は Remark 1 だ。
データのシャッフル。 SGD の理論は毎回ランダムにサンプリングすることを仮定しているが、実装ではエポックごとに訓練セットを一度シャッフルする。シャッフルを使うベースラインと公平に比べるため、エポックごとにランダムな並べ替えを一つだけ作り、それを 個に分けて各 worker に配る。これが Remark 4 だ。各 worker が協調せずにそれぞれシャッフルすると、振る舞いが大きく変わることがあり、実験の結論を汚してしまう。
通信
1 台のサーバーの 8 枚のカードを超えると、勾配はネットワーク越しに集約しなければならない。層ごとの勾配のあいだにはデータの依存関係がないので、ある層の勾配が計算でき次第 allreduce を始め、同時に次の層の計算を続けて、通信を逆伝播の陰に隠す。
allreduce は 3 段階に分かれる。まずサーバー内で 8 枚のカードのバッファを足し合わせ、次にサーバーをまたいで合計し、最後に各カードへブロードキャストして戻す。サーバーをまたぐ部分については、著者らは recursive halving/doubling と ring の二つのアルゴリズムを実装した。32 台のサーバー(256 枚のカード)では、前者が後者より 3 倍速い。これらはすべて Facebook がオープンソースにした Gloo に入っていて、Caffe2 と組み合わせて動かす。
ハードウェアは Facebook の Big Basin サーバーで、1 台に 8 枚の P100 が載り、NVLink で相互接続されている。サーバーのあいだは一般的な 50 Gbit のイーサネットだ。著者らは帯域幅も見積もっている。ResNet-50 は約 2,500 万パラメータ、つまり 100 MB だ。P100 1 枚での逆伝播は約 120 ミリ秒。allreduce のネットワーク通信量はデータ量の約 2 倍なので、ピーク時に必要なのは 200 MB / 0.125 s = 1,600 MB/s、約 12.8 Gbit/s で、追加のオーバーヘッドを含めて約 15 Gbit/s。50 Gbit で足りる。
議論
実験設定
主なベンチマークは ImageNet-1k の top-1 検証誤差だ。モデルは fb.resnet.torch 版の ResNet-50(stride 2 を 3×3 畳み込みに置く)で、Nesterov モーメンタム 0.9、重み減衰 0.0001 で、BN の と には適用しない。すべてのバッチサイズで 90 エポック訓練し、参照学習率は 、第 30、60、80 エポックでそれぞれ 10 で割る。、 のときは、もとの 0.1 になる。
初期化にも細部がもう一つある。各残差ブロックの最後の BN の を 0 で初期化し、最初は信号がショートカットだけを通るようにする。著者らは、これがすべてのモデルに役立ち、大きなバッチでは特にはっきり効くことを見出した。
ランダム性にも配慮している。各モデルは最後の 5 エポックの誤差の中央値を取り、さらに独立した 5 回の訓練の平均と標準偏差を報告する。ベースライン(バッチ 256)の誤差は 23.60% ± 0.12 だ。バッチ 12k 以上はハードウェアの制約があるため、1 台のサーバー上で勾配の累積によってシミュレートしている。著者らは、結果が本物の分散訓練と等価であることを確認済みだとしている。
三種類のウォームアップ
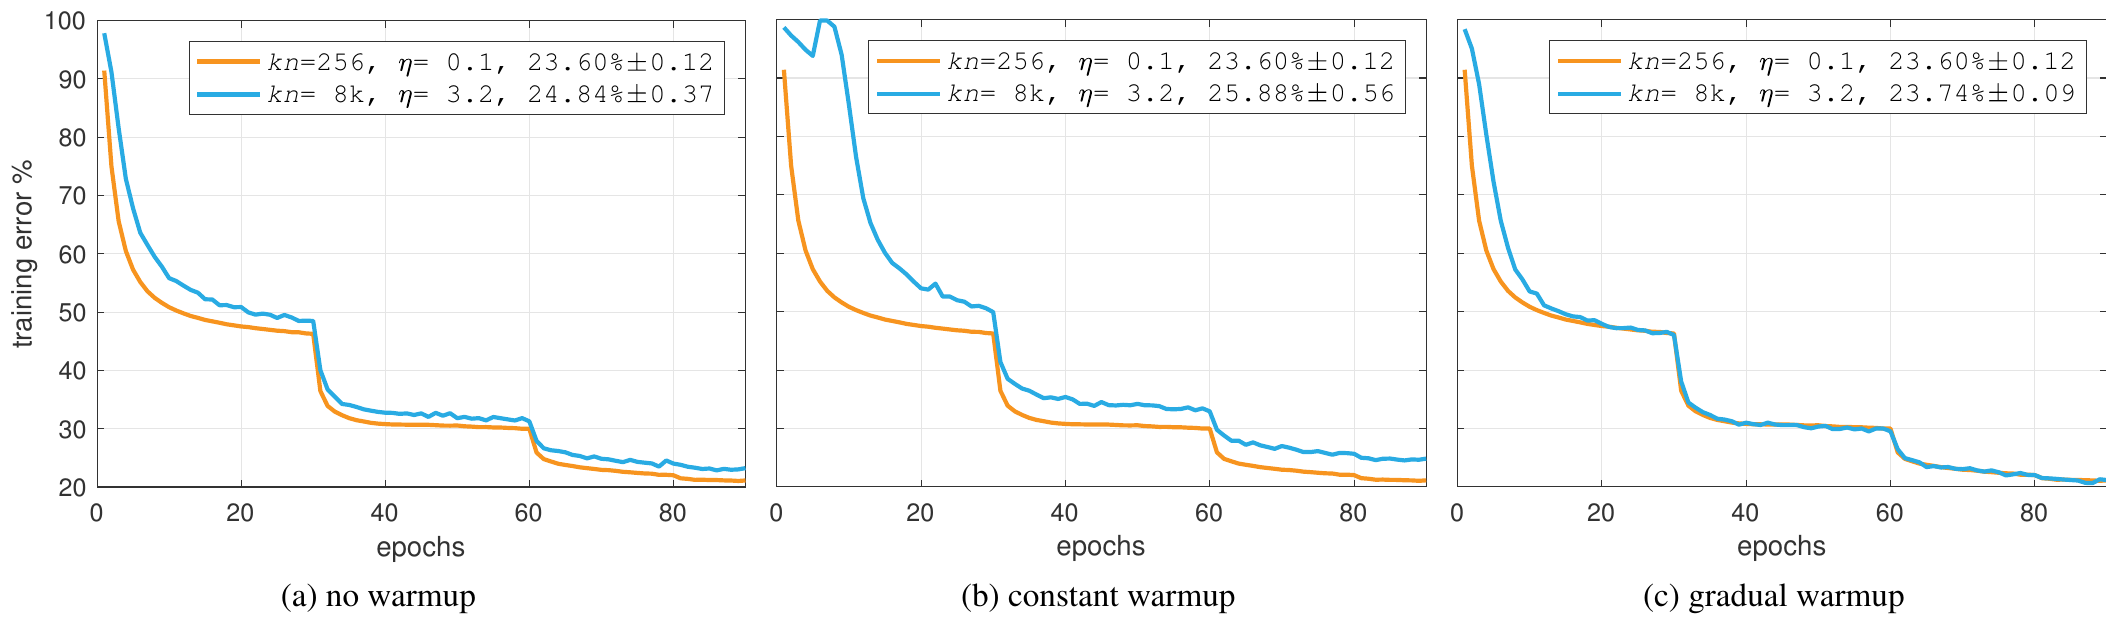
3 枚とも、橙の線はバッチ 256 のベースライン、青の線はバッチ 8k、学習率 3.2 だ。凡例のパーセンテージは検証誤差を表す。
- ウォームアップなし(a):青線は最初から最後まで橙線の上にある。最終的な訓練誤差は約 2.1 ポイント高く、検証誤差も約 1.2 ポイント高い(24.84%)。著者らはこれをもとに、検証誤差が高くなるのは主に訓練誤差から来ていて、過学習によるものではないと判断している。
- 定数ウォームアップ(b):最初の 5 エポックの低い学習率は確かに誤差を下げるが、3.2 に切り替えた途端に誤差が急激に跳ね上がり、その後二度と完全には追いつかない。検証誤差はかえって最悪になる(25.88%)。
- 段階的ウォームアップ(c):青線は最初は学習率が小さいため高めだが、約 20 エポック後には橙線と重なる。検証誤差は 23.74% で、ベースラインとの差は 0.14 ポイントしかなく、標準偏差そのものが約 0.1 ある。
訓練曲線まで一致することは、この論文が繰り返し強調している点だ。著者らはこれをもとに、大きなバッチの難しさは主に最適化にあり、訓練誤差が追いつきさえすれば、この範囲では汎化が悪くなる兆候は見られないと主張している。
8k が天井
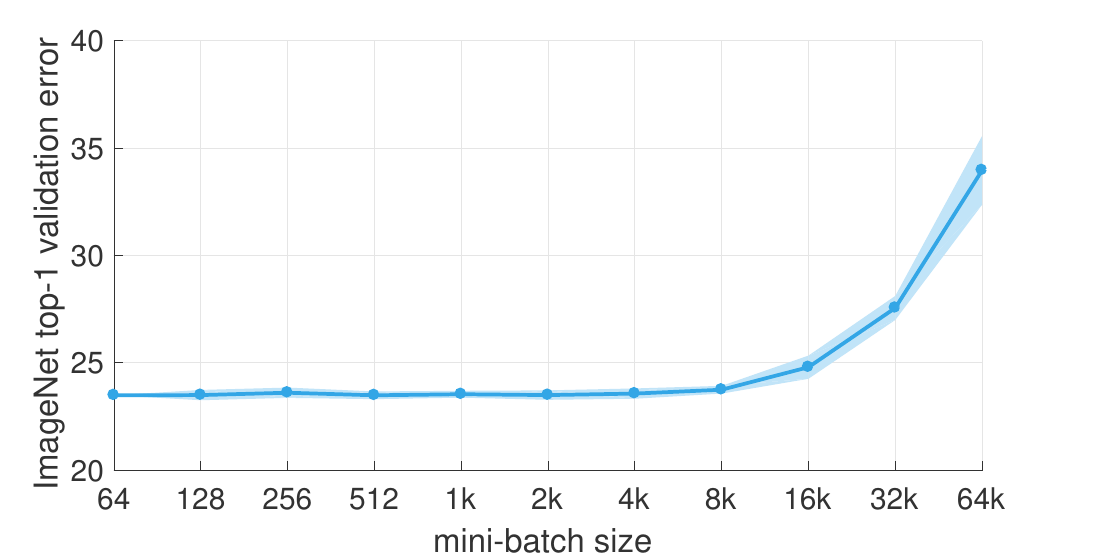
すべてのバッチで線形スケーリング則を使い、256 より大きいバッチにはさらに 5 エポックの段階的ウォームアップを加えている。64 から 8k までは誤差がほぼ水平な線になり、8k を越えると上がりはじめる。16k は 24.79%、32k は 27.55%、64k は 33.96% だ。それより先では、線形規則での訓練はそのまま発散する。
訓練曲線にも違いが見える。
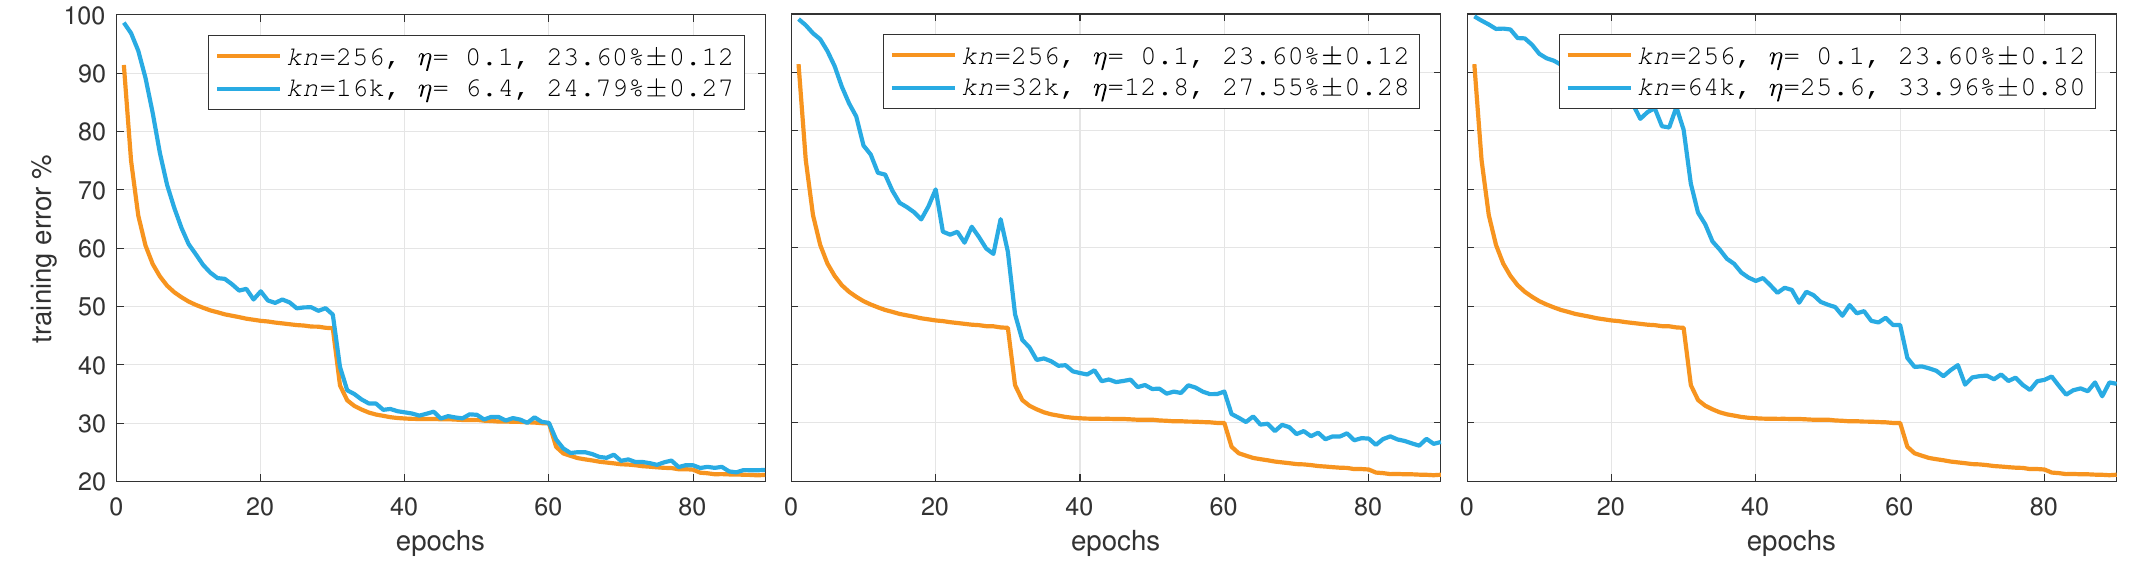
バッチが 8k 以内なら、ウォームアップの区間を除いて、訓練曲線はベースラインとぴったり重なる。16k 以上になると、2 本の線は訓練全体を通してはっきりした差がある。そこで著者らは、新しい設定を比べるときは訓練曲線を早期の指標として使えると勧めている。曲線が合わなければ、最終的な検証誤差もたいてい合わない。
ResNet-101 の状況もほぼ同じだ。8k のバッチの誤差は 22.36% で、256 のバッチの 22.08% より 0.28 ポイント高く、著者らは 8k が ResNet-101 にとってもすでに境界にあると考えている。256 枚の P100 での訓練には 92.5 分かかる。
天井はデータが増えれば上がるのか? 著者らは ImageNet-5k に切り替えた。ImageNet-22k から 4,000 クラスを補い、合計 680 万枚と、もとの約 5 倍で、評価はやはり ImageNet-1k の検証セットで 1,000 クラス分類を行う。誤差曲線の形は ImageNet-1k とほとんど同じで、8k のバッチは 256 より 0.26 ポイント高いだけ(25.83% から 26.09%)、折れ曲がる点は後ろにずれなかった。データが 5 倍になっても、使えるバッチは大きくならなかった。
ほかのスケーリング規則
線形規則は、たまたま最良なのか? 著者らは 256 と 8k の 2 種類のバッチで、いくつかの学習率を試した。
| バッチ | 学習率 η | top-1 誤差 |
|---|---|---|
| 256 | 0.05 | 23.92 |
| 256 | 0.10 | 23.60 |
| 256 | 0.20 | 23.68 |
| 8k | 0.05 · 32 | 24.27 |
| 8k | 0.10 · 32 | 23.74 |
| 8k | 0.20 · 32 | 24.05 |
| 8k | 0.10 | 41.67 |
| 8k | 0.10 · √32 | 26.22 |
原論文 Table 2a をもとに整理。ResNet-50、5 回の訓練の平均(%)。
バッチ 256 の最良値は 0.1、バッチ 8k の最良値は 0.1 × 32 = 3.2 で、ちょうど線形規則が出す答えだ。学習率をバッチに合わせて大きくしない(0.10)と、誤差は 41.67% にもなる。Krizhevsky は勾配の推定値の標準偏差から平方根規則を導いた。 を使い、同じ段階的ウォームアップを組み合わせても、誤差は 26.22% だ。
8k のバッチは、学習率にもバッチ 256 より敏感だ。係数を 0.1 から 0.05 か 0.2 に変えると、バッチ 256 では 0.1 から 0.3 ポイントの差にとどまるが、8k のバッチでは 0.3 から 0.5 ポイントの差が出る。著者らの勧めは、実際に使うときは、崩壊点に近いところにバッチを選ばないことだ。
残差ブロックの γ = 0
各残差ブロックの最後の BN の を 0 で初期化すると、バッチ 256 では 23.84% から 23.60% に、8k では 24.11% から 23.74% に下がる。大きなバッチのほうが恩恵が大きく、著者らはこれも、大きなバッチが最適化の難しさの影響を受けやすいことを示していると考えている。この手はのちに torchvision に取り込まれた。ResNet のコンストラクタには zero_init_residual という引数があり、コードのコメントはこの論文を引用して、0.2 から 0.3 ポイント改善すると書いている。
検出とセグメンテーションへの転移
ImageNet の精度はたいてい最終目的ではなく、事前学習した特徴量がほかのタスクで使えるかどうかこそ、みなが気にするところだ。著者らは 256 から 16k のバッチで事前学習した ResNet-50 を Mask R-CNN の初期化に使い、COCO で物体検出とインスタンスセグメンテーションを行った。バッチごとに 5 つのモデルを事前学習し、合計 35 個の Mask R-CNN を訓練した。ほかのハイパーパラメータはすべて Mask R-CNN の元論文どおりだ。
| 事前学習のバッチ | top-1 誤差 | box AP | mask AP |
|---|---|---|---|
| 256 | 23.60 | 35.9 | 33.9 |
| 1k | 23.53 | 35.9 | 33.9 |
| 4k | 23.56 | 35.8 | 33.8 |
| 8k | 23.74 | 35.8 | 33.9 |
| 16k | 24.79 | 35.1 | 33.2 |
原論文 Table 3a をもとに整理。一部の行を抜粋。COCO minival、5 回の平均(%)。
ImageNet の誤差が保たれている限り(8k 以内)、検出とセグメンテーションの AP はほとんど完全に同じだ。16k では ImageNet の誤差が高くなり、COCO の AP もそれにつれて 0.7 から 0.8 ポイント下がった。
線形規則そのものも Mask R-CNN に使える。Mask R-CNN のバッチの概念は分類とは違い、バックボーンはカード 1 枚につき画像 2 枚を処理し、各画像からさらに 512 個の RoI を取って、分類、ボックス回帰、マスクの 3 種類の損失を計算する。著者らは 1、2、4、8 枚のカードで訓練し、学習率をカード数に比例して大きくした(0.0025 から 0.02)。box AP は 35.6 から 35.7、mask AP は 33.5 から 33.7 で、ほとんど差がない。原文は、Mask R-CNN の 8 枚のカードでのデフォルト設定が、もともと暗黙のうちにこの規則を使っていたことにも触れている。
どれくらい速いか
バッチを 256 から 11k(44 倍)に増やしても、1 ステップの時間は 12% しか増えない。エポックあたりに換算すると、16 分以上から約 30 秒まで縮む。このときは 352 枚のカード(44 台のサーバー)を使っている。8 枚のカードのベースラインからの理想的な外挿と比べると、8 枚から 256 枚へ拡張したときの効率は約 90% で、しかも使っているのは一般的なイーサネットだ。
その後
8k という天井は、すぐに挑戦を受けた。2 か月後、You らは LARS の論文の要旨で、線形スケーリングとウォームアップのこのやり方は汎用性が足りず、訓練が発散しうると率直に書き、層ごとに学習率を調整するやり方に変えて、ResNet-50 のバッチを 32k まで押し上げた。
Shallue ら(JMLR 2019)は 35 のワークロードで、バッチサイズと訓練ステップ数の関係を体系的に測定した。「バッチを 2 倍にすればステップ数が半分になる」完全なスケーリングの区間はタスクによって大きく異なり、最良の学習率も線形規則や平方根規則どおりに変わるとは限らないことを見出した。同時に、大きなバッチが汎化を損なう証拠も見つからなかった。照らし合わせると、線形スケーリング則は完全なスケーリングの区間の中での経験則と考えるのがふさわしく、その範囲を超えたらハイパーパラメータを調整し直す必要がある。
一方、ウォームアップは残り、大きなバッチ以外の場面でも使われるようになった。Adam と組み合わせた Transformer はほぼ必ずウォームアップを必要とし、のちに Pre-LN と RAdam がそれぞれ、これに説明を与えた。
結論
この論文は三つのことで ResNet-50 のバッチを 256 から 8k まで押し上げた。学習率をバッチに比例して大きくすること、最初の 5 エポックで段階的にウォームアップすること、そして BN を各カードで固定の 32 件のデータで計算することだ。8k のバッチの誤差 23.74% は、256 のバッチの 23.60% との差が標準偏差程度で、訓練曲線も一致し、検出とセグメンテーションへの転移の効果も悪くならなかった。8k を越えると、同じやり方は効かなくなりはじめる。
実際に 1 枚のカードから 8 枚のカードに移るとき、この論文で最も実用的なのは、むしろ第 3 節だ。学習率をカード数に合わせて大きくし、ウォームアップを加えたら、損失を割っているのが全体のバッチかカード 1 枚分のバッチか、大きくしたのが学習率か損失だけか(後者だと重み減衰がずれる)、そしてフレームワークのモーメンタムバッファに学習率が掛け込まれていないかも確かめておきたい。これらを間違えて書いても、モデルはそのまま収束し、誤差が少し高くなるだけなので、とても気づきにくい。
5 か月後、Preferred Networks の論文のタイトルは〈Extremely Large Minibatch SGD: Training ResNet-50 on ImageNet in 15 Minutes〉で、1,024 枚の P100 と 32k のバッチを使った。(タイトルはほとんどそのままで、Accurate が Extremely に、1 Hour が 15 Minutes に変わっただけだ。)