原論文
Large Batch Optimization for Deep Learning: Training BERT in 76 minutes
- 発表先
- ICLR 2020国際会議
- arXiv への初回投稿
- arXiv:1904.00962
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{optimizerslamb2019,
  title = {{Large Batch Optimization for Deep Learning: Training BERT in 76 minutes}},
  author = {Yang You and Jing Li and Sashank Reddi and Jonathan Hseu and Sanjiv Kumar and Srinadh Bhojanapalli and Xiaodan Song and James Demmel and Kurt Keutzer and Cho-Jui Hsieh},
  year = {2019},
  eprint = {1904.00962},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1904.00962}
}
LARS は ICLR 2018 に投稿され、不採択になった。査読の結論はかなり具体的で、ImageNet という一つのタスクでしか検証していないこと、ハイパーパラメータが増えること、層ごとに学習率をスケーリングすることに理論的な根拠がないことを指摘していた。
1 年後、LARS の第一著者 Yang You は Google Brain の学生研究員となり、これらの指摘すべてに応えた論文を持ち帰ってきた。新しいタスクは BERT、新しいオプティマイザは LAMB で、収束定理も二つついている。題名にも遠慮はなく、「76 分」とはっきり書いてある。
問題の定義
BERT-Large の事前学習は 2 段階に分かれていて、まず長さ 128 の系列で 90 万ステップ、最後の 10 万ステップは長さ 512 に切り替える。バッチはどちらも 512。16 個の TPUv3 で約 3 日かかる(論文の測定では 81.4 時間)。
時間を縮めたければ、マシンを増やしてバッチを大きくするのがいちばん素直だが、既存の二つの道はどちらも行き詰まっていた。一つは LARS で、ResNet-50 では ImageNet の学習を数分にまで縮めたのに、BERT ではうまくいかない。
| バッチ | 512 | 4K | 8K | 16K | 32K |
|---|---|---|---|---|---|
| LARS | 90.72 | 90.54 | 90.55 | 89.59 | 発散 |
| LAMB | 91.75 | 91.14 | 91.26 | 91.35 | 91.48 |
原論文 Table 2 をもとに整理。SQuAD v1.1 開発セットの F1、一部の列を抜粋。公式 BERT-Large の F1 は 90.395。
もう一つは、BERT がもともと使っていた AdamW だ。著者らは 3 通りの調整を試した。BERT のデフォルトのまま、LAMB のハイパーパラメータの流用、そして自前での再調整だ。16K で F1 は 88.1 にとどまり、目標の 90.4 に届かなかった。付録の調整表では、ウォームアップを短めにした設定はすべて発散している。1 段目 64K、2 段目 32K の混合バッチになると、「長時間調整しても妥当な結果が得られなかった」。
Adam の要素ごとの適応という利点を残したまま、LARS 流の層ごとの信頼比率を加えて、BERT を 32K まで持ちこたえさせることはできるだろうか。これがこの論文の答えようとする問いだ。
問題の解決
2 段階の改造
著者らはまず、LARS を任意のベースオプティマイザにかぶせられる汎用の戦略として抽象化した。ベースのアルゴリズム(SGD または Adam)の層ごとの更新を とすると、これを次のように変える。
- 各層の更新をまず単位長に正規化する:。
- 学習率に層ごとに を掛ける。 は重みのノルムのある関数だ。
SGD をベースにすると、第 層の更新は次のようになる。
1 段階目では方向だけを残し、勾配の大きさは捨てる。これで更新にはバイアスが生じるが、著者らは、バッチがとても大きいときは勾配の方向はおおむね信頼でき、バイアスは小さいと考えている。利点は、勾配が急に極端に大きくなったり小さくなったりしても、それがそのまま更新に拡大されないことだ。2 段階目では、更新の大きさを重みに合わせる。実務では、著者らは次を使う。
つまり重みのノルムを上下限のあいだに挟み込み、初期化直後でノルムがとても小さい層やとても大きい層が、とんでもない比率を受け取らないようにする。、 を実際にいくつに設定したかは、論文に書かれていない。
なら、全体の学習率は を掛けたものになり、これはまさに LARS の trust ratio だ。著者らはさらに、この比をその層の勾配の Lipschitz 定数の逆数の大まかな推定とも解釈していて、曲率の大きい層は自動的に小さな歩幅で進む。
LAMB
ベースを Adam に替えたものが LAMB(Layer-wise Adaptive Moments optimizer for Batch training)だ。各ステップでは、まず Adam どおりに一次・二次モーメントを計算してバイアス補正する。
続いて分離型の重み減衰を加え、それから層全体に trust ratio のスケーリングをかける。
ここには 2 層の適応がある。 が層の中で要素ごとに歩幅を調整し、trust ratio が層と層のあいだで、重みに対する更新の比率をそろえる。重み減衰をノルムの内側に置いたのは著者らの意図的な選択で、減衰項と Adam の更新が一緒になって、その層がどれだけ進むかを決める。デフォルト値は 、、、 で、学習率は BERT 本来の線形減衰 を使う。著者らはさらに、 のとき LAMB は signSGD に退化し、学習率にその層の次元の平方根が掛かることも指摘している。
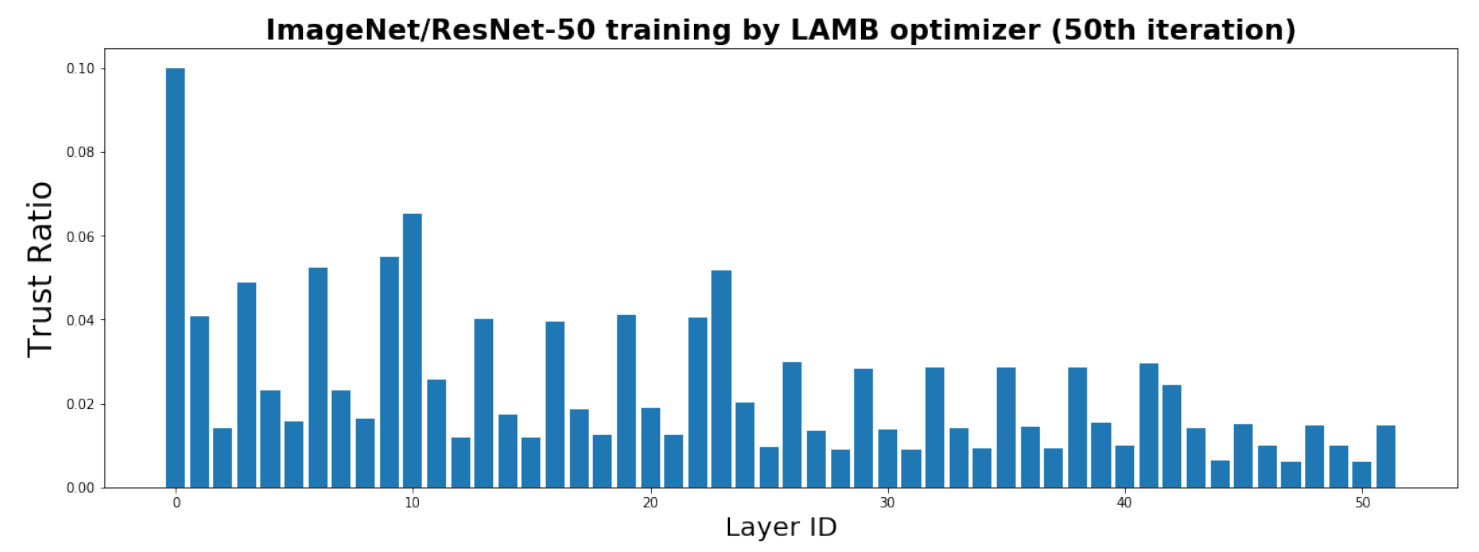
この付録の図は、ResNet-50 の学習が 50 回目のイテレーションに達した時点での各層の trust ratio を記録したものだ。横軸は層の番号、縦軸は比率。最初の層が最も高く約 0.10、後段で最も低い数層は 0.006 前後しかなく、十数倍の差がある。同じ残差ブロックの中の数層は、高低が交互に並ぶ。著者らはこれを、trust ratio が「学習の遅い層」を加速していると解釈している。
収束解析
これは、LARS が当時補うよう求められていた部分だ。著者らは 正則化つきの非凸確率的最適化の設定で、損失が第 層について -smooth であると仮定し、(最も急な層)と ( 層の平均)を定義した。
比較対象は SGD だ。バッチサイズ が総ステップ数 に等しく、学習率を適切に選んだとき、SGD の上界は で決まる。直感は LARS の層ごとの比の表と同じで、ネットワーク全体で一つの学習率を共有すると、最も急な層に合わせるしかない。
LARS(Theorem 2)と LAMB(Theorem 3)の上界は に置き換わる。前提には次のようなものがある。
- 、つまりバッチが総ステップ数と同じオーダーまで大きい。
- 解析は 、重み減衰 の場合だけ。
- には正の上下限 がある。
- LAMB の に依存する上界は、さらに と各層のパラメータ数が等しいことを要求する。 のときはより悪い上界しか得られていない。著者らは、 のときの実際の性能は のときより良いはずだと考えていて、これを今後の研究課題としている。
両者の収束の基準も違う。SGD が測るのは勾配ノルムの 2 乗、LARS が測るのは各層の勾配ノルムを合計したものの 2 乗だ。著者らは付録で、勾配が曲率やノイズより「密」なときに限って LARS の上界が SGD に勝り、そうでなければ SGD の上界のほうが良いと説明している。言い換えれば、この二つの定理が示しているのは、ある条件のもとでは層ごとのスケーリングに利点があるということで、実験で使った 、 は定理の範囲に入っていない。
議論
3 日から 76 分へ
BERT の実験は公式のデータ(Wikipedia 25 億語と BooksCorpus 8 億語)と SQuAD v1.1 の微調整手順をそのまま使い、微調整の設定は一切変えていない。LAMB が調整するのは学習率一つだけで、バッチを大きくするときはそれすら調整し直さず、平方根ルールでスケーリングする。バッチ 512 では を使い、バッチが倍になるごとに を掛けて、32K では になる。ウォームアップの割合は、総ステップ数の 1/320 から 1/5 まで段階的に増やしていく。エポック数は固定なので、バッチが大きいほどステップ数は少なくなる。
| バッチ | ステップ数 | TPUv3 | 時間 | F1 |
|---|---|---|---|---|
| 512(公式) | 1000k | 16 | 81.4 h | 90.395 |
| 512 | 1000k | 16 | 82.8 h | 91.752 |
| 4K | 125k | 128 | 693.6 m | 91.137 |
| 16K | 31,250 | 512 | 200.0 m | 91.345 |
| 32K | 15,625 | 1024 | 101.2 m | 91.475 |
| 64K/32K | 8,599 | 1024 | 76.19 m | 90.584 |
原論文 Table 1 をもとに整理。一部の行を抜粋。
32K は、系列長 512 のときに TPUv3 Pod 1 台分(1,024 チップ)に収まる上限だ。15,625 ステップのうち、長さ 128 で 14,063 ステップ、長さ 512 で 1,562 ステップを走らせ、約 100 分。64 倍の資源で 49.1 倍の高速化を得た。
さらに速くするため、著者らは 2 段階で異なるバッチを使った。1 段目は系列が短いのでバッチを 131,072 まで広げられるが、65,536 から上ではもう速くならないので、1 段目は 65,536、2 段目は 32,768 に戻す。バッチを大から小に切り替えると学習が乱れるので、著者らは 2 段目の最初で学習率を 0 からもう一度ウォームアップし、そのあと通常どおり減衰させた。これで合計 8,599 ステップ、76 分になった。
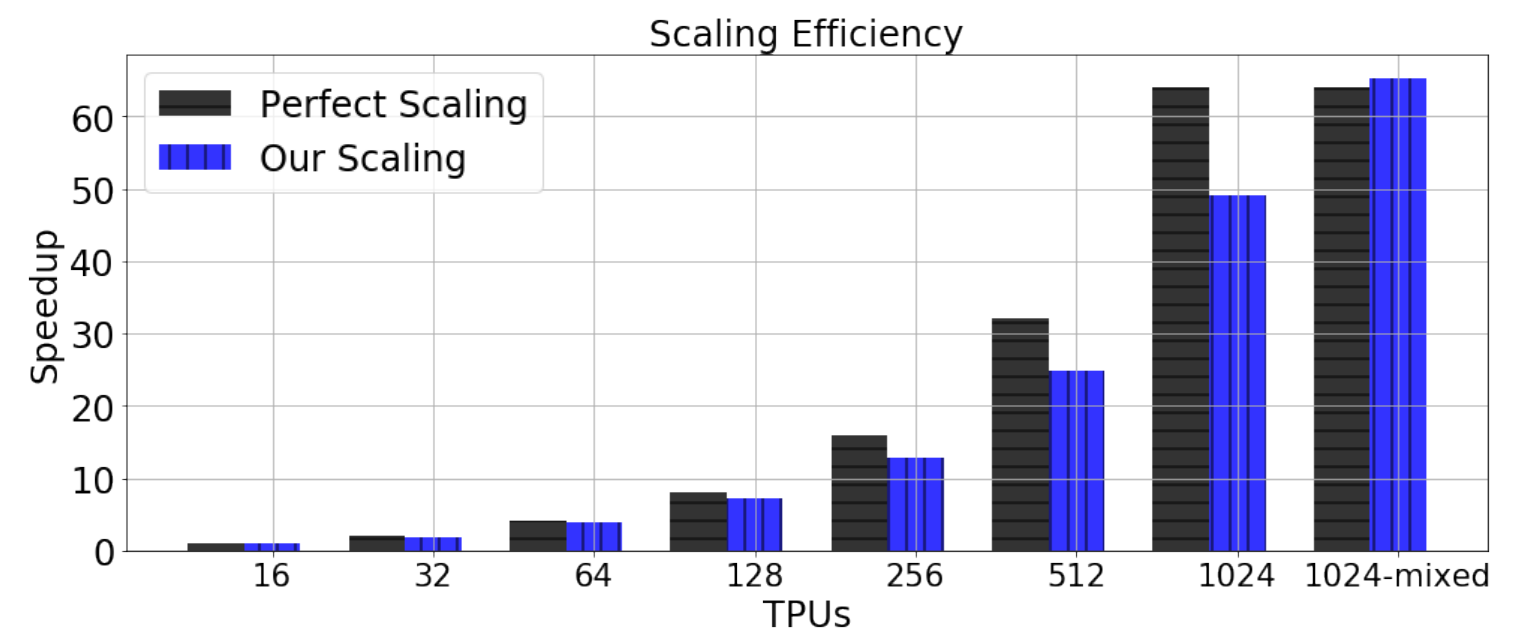
黒い棒が理想的な線形高速化、青が実測だ。1,024 チップ、バッチ 32K では 49 倍しか出ていない。著者らはこの差を勾配同期の通信量のせいだとしている。BERT には 3 億のパラメータがあり、ResNet-50 は 2,500 万しかない。右端の混合バッチは 65.2 倍で、理想値を超えているのは不思議なことではない。ステップ数が、32K 固定のときよりほぼ半分に減っているからだ。
76 分という数字は、F1 と合わせて読む必要がある。混合バッチの 90.584 は公式 BERT の 90.395 より高いが、LAMB 自身のすべての設定の中では最も低く、ほかの設定はどれも 91.1 から 91.9 のあいだにある。
ImageNet
ResNet-50 では、著者らは LAMB のような適応的手法でもモーメンタム SGD の水準に届くことを示そうとした。バッチ 16K、90 エポックで、AdaGrad、Adam、AdamW は十分に調整しても 55.38%、66.04%、67.27% にとどまった。Goyal らのウォームアップと段階的減衰を組み合わせても 72.01%、73.48%、73.07% までだ。Goyal らが報告したモーメンタム SGD は 75.20%、LAMB は 76.66% だった。バッチ 512 から 32K まで一切調整し直さなくても、LAMB の top-1 はすべて 76.42% から 77.11% のあいだに収まり、最も低いのは 32K だった。LARS と比べると、32K で 76.4% 対 76.3% である。
Reality Check
2 年後、Google の Nado らは〈A Large Batch Optimizer Reality Check〉で BERT の実験をやり直した。結論は副題にそのまま書かれていて、従来の汎用オプティマイザでどのバッチサイズにも十分に対応できる、というものだ。
彼らは同じ 2 段階の設定と同じステップ数を使い、LAMB を Adam に戻すことだけをして、きちんと調整し直した。
| バッチ | ステップ数 | LAMB | Adam |
|---|---|---|---|
| 32K | 15,625 | 91.48 | 91.58 |
| 64K/32K | 8,599 | 90.58 | 91.04 |
| 64K | 7,818 | – | 90.46 |
Nado らの Table 3 をもとに整理。SQuAD v1.1 開発セットの F1。LAMB の数値は LAMB 論文から引用。
バッチ 32K では、Adam の事前学習損失も低く、1.277 対 1.342 だった。全体を 64K で通すと、Adam は 7,818 ステップで 90.46 に達し、LAMB の混合バッチより 700 ステップ以上少ない。
両者の条件はどこが違ったのか。Nado らは、LAMB 論文の Adam を不利にしたかもしれない実装上の細部を二つ挙げている。一つは、BERT のオープンソースコードの Adam にはバイアス補正がなく、バイアス補正それ自体にウォームアップの効果があることだ。もう一つは、BERT の学習率スケジュールには減衰の開始点に段差があり、減衰がウォームアップ期間中に誤って適用されていたことで、このコードは GitHub 上の 3,000 を超える BERT 学習コードのコピーに存在していた。調整にかけた力も違う。Nado らは 2 段階の事前学習それぞれについて、学習率、、、ウォームアップ曲線の指数、重み減衰を探索し、各段階で約 30 回の試行、64K の 2 段目では 130 回を費やした。 は に固定している。逆に言えば、彼らは LAMB を走らせ直してはおらず、比べているのはステップ数で、実際に計測した実時間(wall-clock)ではない。彼らの論点は、Adam のほうが計算が単純なので、最適化されたシステムでは同じステップ数で遅くなることはない、というものだ。
彼らは ResNet-50(バッチ 32,768、6,000 ステップ)でも、LAMB をそのまますべてのパラメータに適用してみたが、結果は 27.3% にとどまった。BatchNorm のパラメータとバイアス項を Adam に切り替えると 76.3% に戻った。層ごとの正規化は一部のパラメータにはたしかに有害になりうるのに、LAMB 論文はそうしたパラメータをどう扱ったかを説明していない。彼らは議論の中で、LARS と LAMB の更新規則と「大きいバッチ」との結びつきは、モーメンタムや Adam と比べて特に深いものではないと書いている。収束の上界が頼る仮定(モーメンタムなし、)は実務からかけ離れていて、Adam でも同様の上界が証明できる。
別の角度からの話が MoCo v3 だ。Chen、Xie、He は 2021 年に自己教師あり手法で ViT を学習したとき LAMB も試していて、ViT-B/16、バッチ 4096 の設定で、学習率 のとき LAMB は 72.5% と AdamW をわずかに上回った。ところが学習率を 、 にすると、正解率は 1.6 ポイント、6.0 ポイント下がった。Chen らは、LAMB は学習率に敏感すぎるので、アブレーションの比較に使うには不便だと考えた。
結論
81 時間から 76 分へ。LAMB がそれを実現したのは、LARS の層ごとの信頼比率を Adam に移植したうえで、1,024 個の TPUv3、混合バッチ、2 段目での再ウォームアップを組み合わせたからだ。LARS に欠けていた収束定理も補った。その後の検証では、Adam の実装に欠陥がなく、各段階をきちんと調整すれば、同じバッチとステップ数で LAMB に負けないことが示された。定理が成り立つ条件も、実際の学習とは大きく離れている。
LAMB に替える前には、ライブラリが実装しているのがどの版なのか、バイアス補正、、勾配の事前正規化がそれぞれあるかどうか、LayerNorm とバイアス項が trust ratio の対象から外されているかどうかを、まず確かめよう。そのうえで同じステップ数を使い、バイアス補正つきの Adam をきちんと一組調整して対照にする。
76 分の記録に最後に並んだのは、LAMB が置き換えようとした Adam だった。しかも、より少ないステップ数で。