原始論文
Accurate, Large Minibatch SGD: Training ImageNet in 1 Hour
- 發表版本
- 正式發表資訊尚未核實
- arXiv 首次提交
- arXiv:1706.02677
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{optimizerslargeminibatchsgd2017,
  title = {{Accurate, Large Minibatch SGD: Training ImageNet in 1 Hour}},
  author = {Priya Goyal and Piotr Dollár and Ross Girshick and Pieter Noordhuis and Lukasz Wesolowski and Aapo Kyrola and Andrew Tulloch and Yangqing Jia and Kaiming He},
  year = {2017},
  eprint = {1706.02677},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1706.02677}
}
用 8 張 Tesla P100 訓練 ResNet-50,批次大小(batch size)256,跑完 ImageNet 的 90 個 epoch 要 29 個小時。
2017 年 6 月,Facebook 的團隊把同一個模型搬到 256 張 GPU 上,批次大小調成 8,192,一個小時就訓練完,驗證集 top-1 誤差和原本只差 0.14 個百分點。作者名單裡有 Ross Girshick、Piotr Dollár、何愷明,也有 Caffe 的作者賈揚清。
GPU 多了 32 倍,時間短了 29 倍,看起來像是硬體堆出來的成績。這篇技術報告花最多篇幅交代的,是硬體以外的部分,包括批次變成 32 倍時學習率要怎麼調、訓練一開始為什麼會出事、BatchNorm 要怎麼算,以及幾個寫錯了也照樣能跑、只是結果會變差的實作細節。
定義問題
同步的分散式 SGD 裡, 個 worker(這篇就是 張 GPU)各拿 筆資料算梯度,把梯度加總之後,大家用同一個結果更新參數。每一步看到的資料就是 筆。
要讓每張卡都有事做, 不能太小,於是 GPU 越多,總批次就越大。同樣跑 90 個 epoch,批次大 32 倍,更新次數就少了 32 倍。
當時大批次的名聲不太好。Krizhevsky 在 2014 年用過學習率隨批次線性放大的做法,但批次從 128 加到 1,024 時,誤差多了 1 個百分點。Keskar 等人(2017)則主張大批次會收斂到尖銳的極小值,泛化變差。也有人在 5,120 的批次上沒有損失準確率,但沒有給出不用搜尋超參數的調整規則。
這篇想回答的是,批次從 256 一路放大,能不能只靠一條簡單的規則、不重新調任何超參數,就保住小批次的準確率?如果不行,壞在哪裡?
解決問題
線性縮放規則
作者的規則只有一句,批次乘上 ,學習率也乘上 。權重衰減等其他超參數一律不動。
為什麼是乘 ?我們拿 走一次。小批次的 SGD 一步是:
用兩個小批次 、 連走兩步,第二步的梯度是在 上算的:
把兩個小批次合成一個大小 的大批次,只走一步,學習率是 :
兩式只差在兩個地方,一是第二個小批次的梯度算在 還是 ,二是前面的係數。如果參數走一步之後梯度變化不大,也就是 ,兩式要相等,就得讓 ,也就是 。推廣到 個小批次,就是論文的式 (3)(4) 與 。
作者自己也說這是很強的假設,並指出至少有兩種情況它顯然不成立。第一是訓練剛開始,網路變化很快,相鄰幾步的梯度差很多。第二是批次不能無限放大;結果在很大的範圍內都穩定,但過了某個點,準確率會迅速變差,在 ImageNet 上這個點大約是 8k。
第一種情況,就交給暖身處理。
暖身
先前 ResNet 論文用過常數暖身,前幾個 epoch 先用一個小的固定學習率。作者試著在 8k 批次上照做,前 5 個 epoch 用 ,之後直接跳到 ,結果發現不夠用,從低學習率切出來的那一刻,訓練誤差會突然暴衝。
於是他們改用漸進暖身(gradual warmup),從 開始,每一步加一個固定的量,5 個 epoch 後剛好到達 ,之後再接回原本的排程。
我們算一下 8k 批次的情況。ImageNet 訓練集約 128 萬張,一個 epoch 約 156 步,5 個 epoch 約 780 步。學習率要從 0.1 爬到 3.2,每一步大約加 0.004。作者也提到,結果對暖身長度並不敏感。
BatchNorm 的批次
BatchNorm 會在一個批次裡算平均與變異數,所以每筆資料的損失不再只跟自己有關,也跟同一批的其他資料有關。作者在式 (5) 把這件事寫清楚。有了 BN,訓練集可以想成「所有大小為 的子集合」,每個子集合才是一筆獨立的樣本。
這代表 BN 的批次大小 是損失函數定義的一部分。 一變,BN 統計量的隨機程度就跟著變,最佳化的目標也就換了一個。所以作者固定每個 worker 的 ,增加 GPU 時只增加 ;BN 的統計量也在每個 worker 內各自計算,不跨 worker 同步。這樣做省了通訊,更重要的是讓不同批次大小的實驗最佳化的是同一個目標。原文還特別說,如果要改 ,應該把它當作 BN 的超參數來調,而不是分散式訓練的參數。
四個實作陷阱
第 3 節列了四個「寫錯了也能訓練,只是誤差比預期高」的細節,每個都整理成一條 Remark。
權重衰減。 權重衰減其實是損失裡 L2 項的梯度。把每筆資料的損失寫成 ,SGD 更新就變成式 (8):
實務上反向傳播只算交叉熵那一項, 是另外加上去的。所以把交叉熵損失乘上 ,只會放大後面那一項,權重衰減那一項沒動,效果和把學習率乘上 不一樣。這就是 Remark 1,縮放交叉熵損失和縮放學習率是兩回事。
動量修正。 動量 SGD 有兩種常見寫法。參考寫法是式 (9),動量緩衝區 只累積梯度,學習率在更新參數時才乘:
另一種寫法是式 (10),把學習率吸收進緩衝區,令 :
學習率固定時,兩者完全等價。學習率一改變就不同了。 裡面存的是舊學習率乘過的歷史,要和式 (9) 保持一致,更新時得先把它乘上 ,作者稱這個比值為動量修正。作者發現,學習率大幅拉高()時如果不修正,歷史項會偏小,訓練就不穩;學習率下降時,這個修正沒那麼關鍵。這就是 Remark 2,用式 (10) 的寫法時,改了學習率就要做動量修正。
梯度聚合。 正確的大批次梯度,是把 筆資料的梯度加總後除以 。每個 worker 的損失層通常已經對自己的 筆取平均,而 allreduce 做的是加總,不是平均,所以還少了一個 。作者建議直接把這個 放進損失裡,只縮放損失對輸入的梯度,省得再去縮放整個梯度向量。這就是 Remark 3,每個 worker 的損失要除以總批次 ,不是除以自己的 。原文也提醒,用「學習率不乘 、損失只除以 」來互相抵銷是錯的,權重衰減會跟著算錯,原因就是 Remark 1。
資料洗牌。 SGD 的理論假設每次都隨機抽樣,實作上則是每個 epoch 把訓練集洗一次牌。為了和用洗牌的基準公平比較,每個 epoch 只產生一份隨機排列,再切成 份分給各個 worker。這是 Remark 4。各 worker 自己洗牌、互不協調,行為可能明顯不同,污染實驗結論。
通訊
要超過一台伺服器的 8 張卡,梯度就得透過網路聚合。不同層的梯度之間沒有資料相依,所以某一層的梯度一算好就開始 allreduce,同時繼續算下一層,讓通訊藏在反向傳播後面。
allreduce 分三段,先在伺服器內把 8 張卡的緩衝區加起來,再跨伺服器加總,最後廣播回每張卡。跨伺服器的部分,作者實作了 recursive halving/doubling 與 ring 兩種演算法;在 32 台伺服器(256 張卡)上,前者比後者快 3 倍。這些都放在 Facebook 開源的 Gloo 裡,搭配 Caffe2 執行。
硬體是 Facebook 的 Big Basin 伺服器,每台 8 張 P100,用 NVLink 互連,伺服器之間是一般的 50 Gbit 乙太網路。作者估算過頻寬。ResNet-50 約 2,500 萬參數,也就是 100 MB;單張 P100 的反向傳播約 120 毫秒;allreduce 的網路流量約是資料量的 2 倍,所以峰值需要 200 MB / 0.125 s = 1,600 MB/s,約 12.8 Gbit/s,加上額外開銷約 15 Gbit/s,50 Gbit 夠用。
討論
實驗設定
主要基準是 ImageNet-1k 的 top-1 驗證誤差。模型是 fb.resnet.torch 版的 ResNet-50(stride 2 放在 3×3 卷積上),Nesterov 動量 0.9,權重衰減 0.0001、不套用在 BN 的 與 。所有批次大小都訓練 90 個 epoch,參考學習率 ,在第 30、60、80 個 epoch 各除以 10;、 時就是原本的 0.1。
初始化還有一個細節,每個殘差區塊最後一個 BN 的 初始化為 0,讓訊號一開始只走捷徑。作者發現這對所有模型都有幫助,對大批次尤其明顯。
隨機性也照顧到了。每個模型取最後 5 個 epoch 誤差的中位數,再報告 5 次獨立訓練的平均與標準差。基準(256 批次)的誤差是 23.60% ± 0.12。批次 12k 以上受限於硬體,是在單台伺服器上用梯度累積模擬的;作者表示已驗證過結果和真的分散式訓練等價。
三種暖身
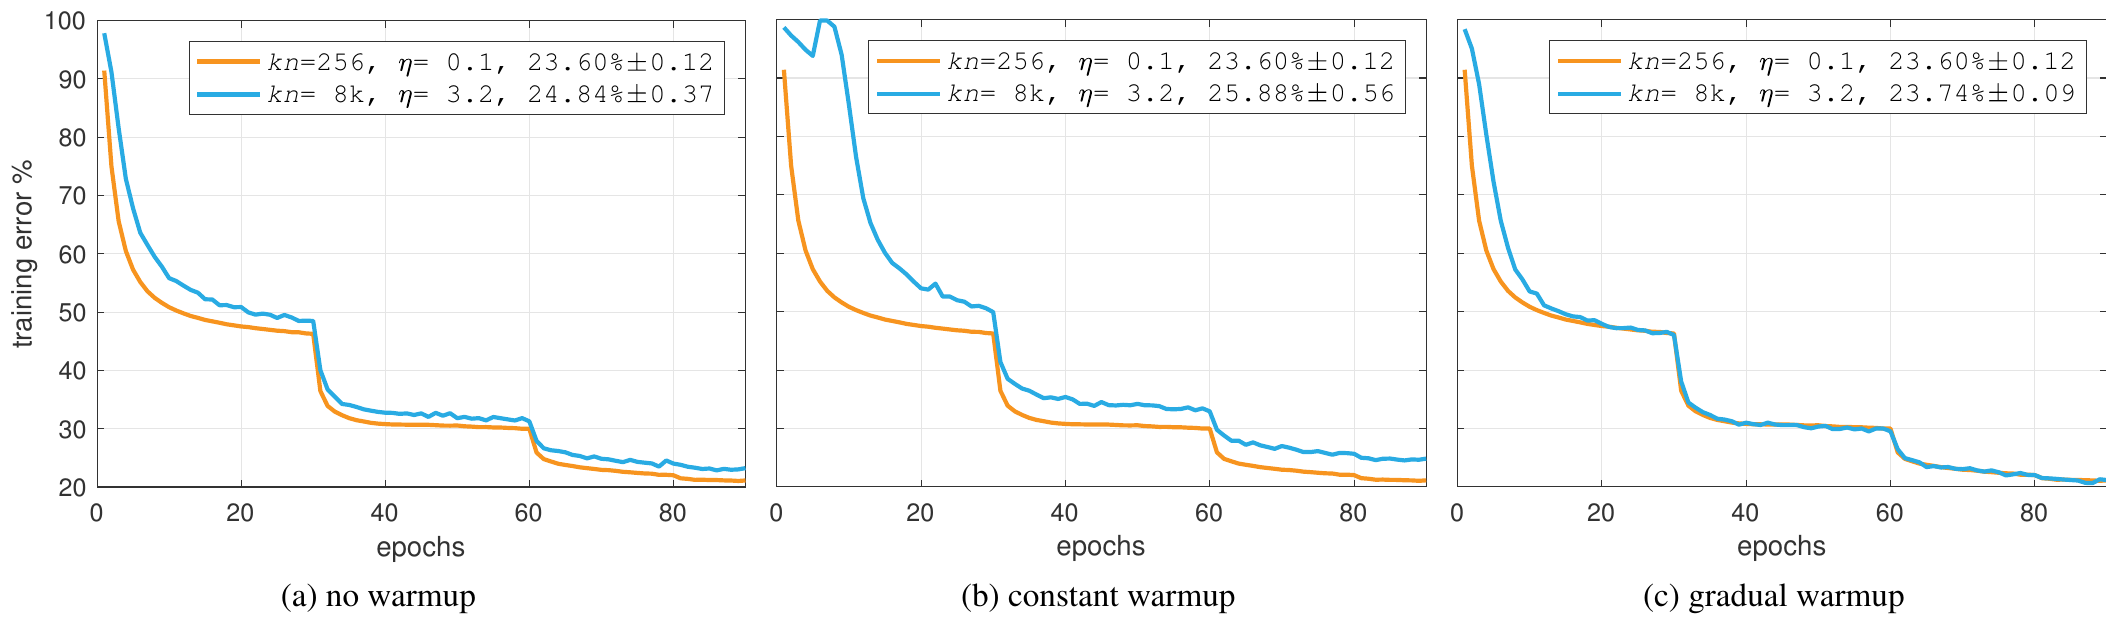
三張圖的橘線都是 256 批次的基準,藍線是 8k 批次、學習率 3.2。圖例裡的百分比是驗證誤差。
- 不暖身(a):藍線從頭到尾都在橘線上面。最後的訓練誤差高了約 2.1 個百分點,驗證誤差也高了約 1.2 個百分點(24.84%)。作者據此判斷,驗證誤差變高主要來自訓練誤差,而不是過擬合。
- 常數暖身(b):前 5 個 epoch 的低學習率確實能讓誤差下降,但一切到 3.2,誤差立刻暴衝,之後再也沒有完全追上,驗證誤差反而最差(25.88%)。
- 漸進暖身(c):藍線一開始因為學習率小而偏高,大約 20 個 epoch 後就和橘線重合,驗證誤差 23.74%,和基準只差 0.14 個百分點,而標準差本身就約 0.1。
連訓練曲線都對得上,是這篇反覆強調的一點。作者據此主張,大批次的困難主要在最佳化,只要訓練誤差追得上,在這個範圍內看不到泛化變差的跡象。
8k 是天花板
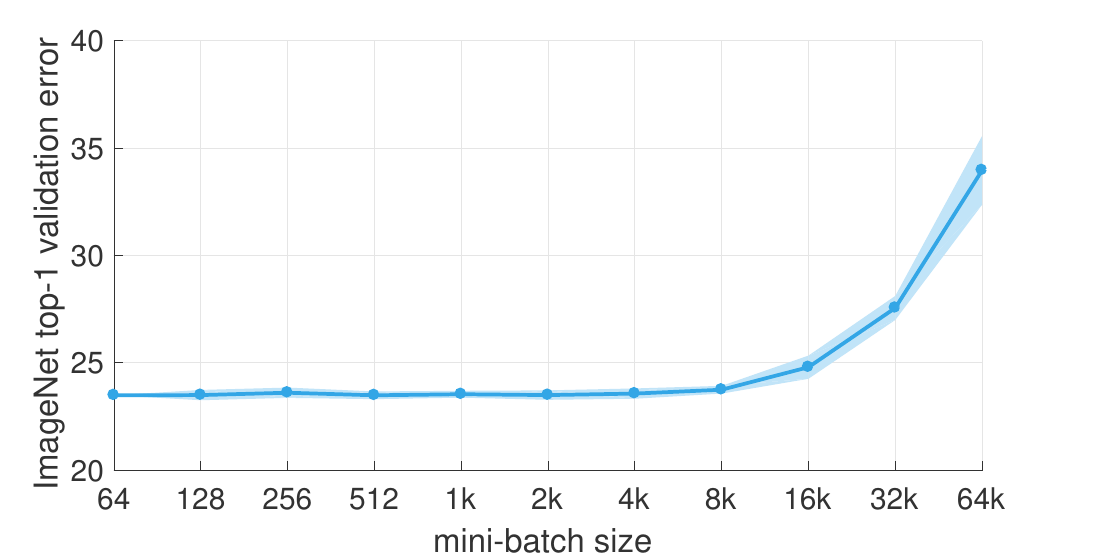
所有批次都用線性縮放規則,大於 256 的批次再加上 5 個 epoch 的漸進暖身。從 64 到 8k,誤差幾乎是一條水平線;過了 8k 開始上升,16k 是 24.79%、32k 是 27.55%、64k 是 33.96%。再往上,線性規則的訓練直接發散。
訓練曲線也看得出差別。
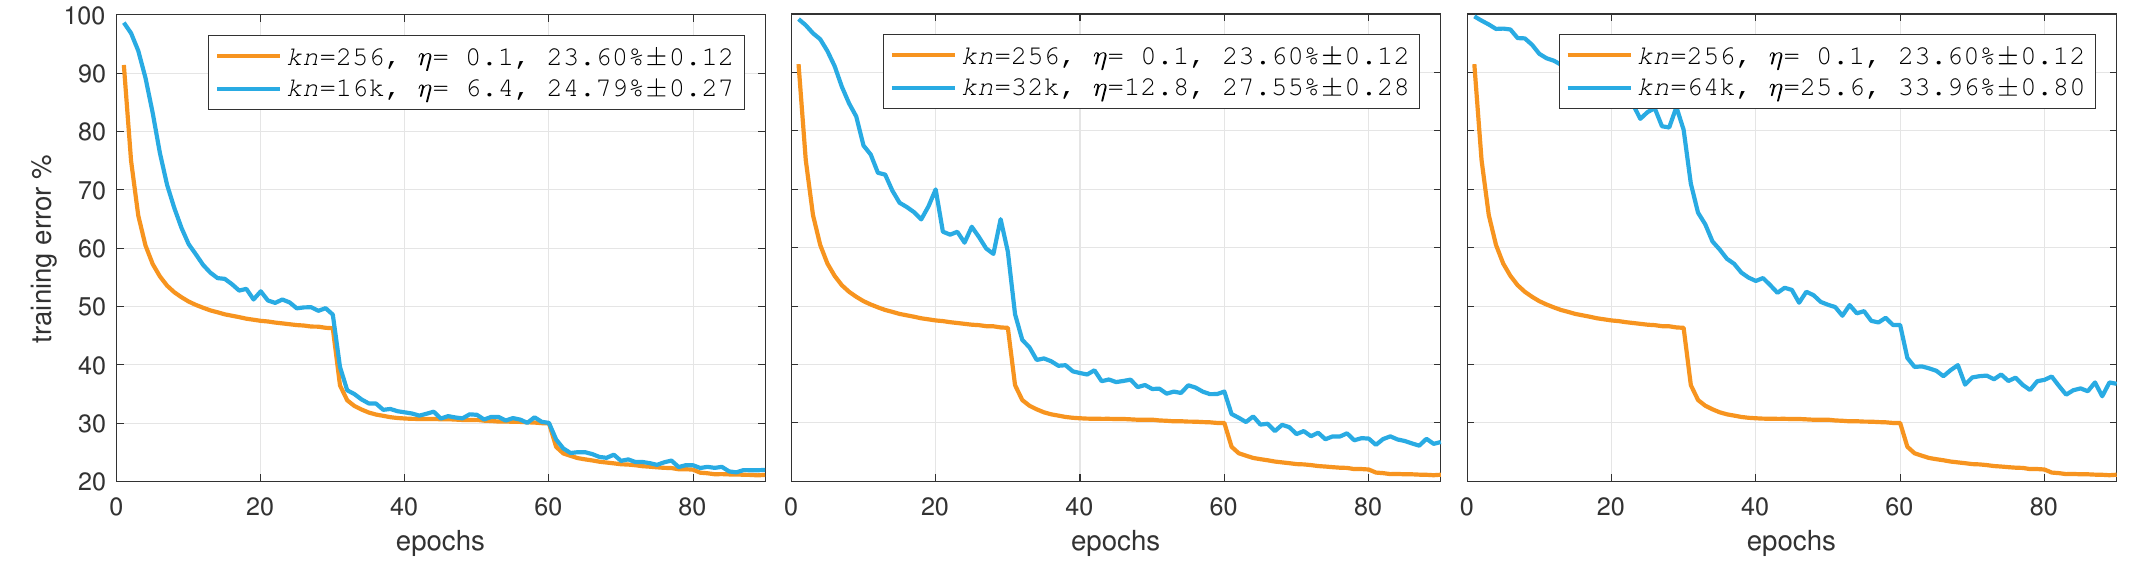
批次在 8k 以內時,除了暖身那段,訓練曲線都和基準疊在一起。到了 16k 以上,兩條線在整個訓練過程都有明顯的落差。作者因此建議,比較新設定時可以把訓練曲線當作早期指標,曲線對不上,最後的驗證誤差多半也對不上。
ResNet-101 的情況差不多。8k 批次的誤差是 22.36%,比 256 批次的 22.08% 高 0.28 個百分點,作者認為 8k 對 ResNet-101 也已經在邊緣;用 256 張 P100 訓練需要 92.5 分鐘。
天花板會不會隨著資料變多而升高?作者換成 ImageNet-5k,用 ImageNet-22k 補了 4,000 類,總共 680 萬張,約為原本的 5 倍,仍然在 ImageNet-1k 的驗證集上評估 1,000 類分類。誤差曲線的形狀和 ImageNet-1k 幾乎一樣,8k 批次只比 256 高 0.26 個百分點(25.83% 到 26.09%),轉折點沒有往後移。資料多 5 倍,能用的批次並沒有跟著變大。
其他縮放規則
線性規則是不是剛好最好?作者在 256 和 8k 兩種批次下各試了幾種學習率:
| 批次 | 學習率 η | top-1 誤差 |
|---|---|---|
| 256 | 0.05 | 23.92 |
| 256 | 0.10 | 23.60 |
| 256 | 0.20 | 23.68 |
| 8k | 0.05 · 32 | 24.27 |
| 8k | 0.10 · 32 | 23.74 |
| 8k | 0.20 · 32 | 24.05 |
| 8k | 0.10 | 41.67 |
| 8k | 0.10 · √32 | 26.22 |
整理自原論文 Table 2a;ResNet-50,5 次訓練的平均(%)。
256 批次的最佳值是 0.1,8k 批次的最佳值是 0.1 × 32 = 3.2,正好是線性規則給的答案。學習率不跟著放大(0.10)時,誤差高達 41.67%。Krizhevsky 從梯度估計的標準差推導出平方根規則,用 ,搭配同樣的漸進暖身,誤差仍是 26.22%。
8k 批次對學習率也比 256 批次敏感。乘數從 0.1 改成 0.05 或 0.2,256 批次只差 0.1 到 0.3 個百分點,8k 批次差了 0.3 到 0.5 個百分點。作者的建議是,實際使用時,批次不要選在接近崩潰點的地方。
殘差區塊的 γ = 0
把每個殘差區塊最後一個 BN 的 初始化為 0,256 批次從 23.84% 降到 23.60%,8k 批次從 24.11% 降到 23.74%;大批次受益較多,作者認為這也說明大批次更容易受最佳化困難影響。這一招後來進了 torchvision,ResNet 的建構函式有一個 zero_init_residual 參數,程式註解就引用這篇論文,寫著能改善 0.2 到 0.3 個百分點。
遷移到偵測與分割
ImageNet 的準確率通常不是最終目的,預訓練的特徵能不能用在其他任務,才是大家在意的。作者把 256 到 16k 批次預訓練的 ResNet-50 拿去初始化 Mask R-CNN,在 COCO 上做物件偵測與實例分割。每種批次預訓練 5 個模型,一共訓練 35 個 Mask R-CNN,其餘超參數全照 Mask R-CNN 原論文。
| 預訓練批次 | top-1 誤差 | box AP | mask AP |
|---|---|---|---|
| 256 | 23.60 | 35.9 | 33.9 |
| 1k | 23.53 | 35.9 | 33.9 |
| 4k | 23.56 | 35.8 | 33.8 |
| 8k | 23.74 | 35.8 | 33.9 |
| 16k | 24.79 | 35.1 | 33.2 |
整理自原論文 Table 3a,節錄部分列;COCO minival,5 次的平均(%)。
只要 ImageNet 誤差維持住(8k 以內),偵測與分割的 AP 幾乎完全一樣;16k 的 ImageNet 誤差變高,COCO 的 AP 也跟著掉了 0.7 到 0.8 個百分點。
線性規則本身也能用在 Mask R-CNN 上。Mask R-CNN 的批次概念和分類不同,骨幹網路每張卡吃 2 張影像,每張影像再取 512 個 RoI 去算分類、框回歸與遮罩三種損失。作者用 1、2、4、8 張卡訓練,學習率依卡數線性放大(0.0025 到 0.02),box AP 介於 35.6 到 35.7、mask AP 介於 33.5 到 33.7,幾乎沒有差別。原文也提到,Mask R-CNN 用 8 張卡的預設設定,本來就默默套用了這條規則。
跑多快
批次從 256 加到 11k(44 倍),每一步的時間只多了 12%;換算成每個 epoch,從 16 分鐘以上降到約 30 秒,這時用的是 352 張卡(44 台伺服器)。和 8 卡基準的理想外推相比,從 8 張卡擴展到 256 張卡的效率約 90%,而且用的是一般的乙太網路。
後來的事
8k 這個天花板很快就被挑戰了。兩個月後,You 等人在 LARS 的論文摘要裡直說,線性縮放加暖身這套做法不夠通用,訓練可能發散;他們改成逐層調整學習率,把 ResNet-50 的批次推到 32k。
Shallue 等人(JMLR 2019)則在 35 個工作負載上系統地量測批次大小與訓練步數的關係,發現「批次加倍、步數減半」的完美縮放區間在不同任務之間差異極大,最佳學習率也不一定照線性或平方根規則變化;他們同時沒有找到大批次會傷害泛化的證據。對照起來,線性縮放規則比較適合當成完美縮放區間內的經驗法則,超出那個範圍就得重新調參。
暖身則留了下來,而且用到了大批次以外的地方。Transformer 搭配 Adam 幾乎都要暖身,後來 Pre-LN 與 RAdam 對此各自提出了解釋。
結論
這篇靠三件事把 ResNet-50 的批次從 256 推到 8k,分別是學習率隨批次線性放大、前 5 個 epoch 漸進暖身,以及 BN 在每張卡上用固定的 32 筆資料計算。8k 批次的誤差 23.74%,和 256 批次的 23.60% 相差在標準差附近,訓練曲線也對得上,偵測與分割的遷移效果沒有變差;過了 8k,同一套做法就開始失效。
真的要從 1 張卡換到 8 張卡時,這篇最實用的反而是第 3 節。學習率照卡數放大、加上暖身之後,還要確認損失除的是總批次還是單卡批次,放大的是學習率還是只是損失(後者會讓權重衰減失準),以及框架的動量緩衝區有沒有把學習率乘進去。這幾個地方寫錯,模型照樣會收斂,只是誤差高一點,很難察覺。
五個月後,Preferred Networks 的論文題目叫〈Extremely Large Minibatch SGD: Training ResNet-50 on ImageNet in 15 Minutes〉,用了 1,024 張 P100 和 32k 的批次。(題目幾乎照抄,Accurate 換成了 Extremely,1 Hour 換成了 15 Minutes。)