原論文
UCMCTrack: Multi-Object Tracking with Uniform Camera Motion Compensation
- 発表先
- AAAI 2024国際会議
- arXiv への初回投稿
- arXiv:2312.08952
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingucmctrack2023,
  title = {{UCMCTrack: Multi-Object Tracking with Uniform Camera Motion Compensation}},
  author = {Kefu Yi and Kai Luo and Xiaolei Luo and Jiangui Huang and Hao Wu and Rongdong Hu and Wei Hao},
  year = {2023},
  eprint = {2312.08952},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2312.08952}
}
運動だけに頼る追跡手法が何より苦手なのは、カメラが動くことだ。
人はじっと立っているのに、カメラが向きを変えると、画面上のその人の位置は大きくずれる。カルマンフィルタが予測したボックスと新しく検出したボックスが合わなくなり、IoU は 0 に落ちて、追跡が途切れる。
よくある解決策は二つある。外観特徴を加えるか、カメラ運動補償(CMC)を行うかだ。後者はフレームごとにカメラがどう動いたかを推定し、軌跡の位置を補正し直す。BoT-SORT、StrongSORT、Deep OC-SORT はどれもこうしている。どちらの方法も効くが、どちらも余分な計算が要る。フレームごとのカメラ運動補償では、毎フレーム特徴点を抽出し、オプティカルフローを計算するか画像の位置合わせを行う必要があり、動画の解像度が上がるとかなり重くなる。
長沙理工大学の Kefu Yi、Kai Luo、Wei Hao らが提案した UCMCTrack は、視点を変えた。画面上で追うより、一人ひとりを地面に投影し直して追えばいい。カメラの揺れは、運動モデルの中のノイズとして扱う。動画全体で一組の固定された補償パラメータだけを使い、フレームごとに計算する必要はない。
問題の定義
著者らが答えようとしたのは、運動の手がかりだけを使い、カメラの移動にも強く、しかもフレームごとのカメラ運動補償をせずに済ませられないか、という問いだ。
彼らは、問題は IoU と画像平面にあると考えた。
IoU は最もよく使われる関連付けの距離だが、二つのボックスが重なっていなければ 0 になってしまう。カメラの揺れ、低いサンプリングレート、対象の速い動きは、どれも予測ボックスと検出ボックスを完全に引き離す。GIoU、DIoU、C-BIoU といった改良は、重ならないボックスにもスコアを出せるようにしたが、どれもまだ画像平面の上で計算している。
画像平面上の位置には、カメラの運動と透視による変形が混ざり込んでいる。同じように一歩前へ出ても、カメラに近い人は画面上で大きく動き、遠くの人は少ししか動かない。人が実際に歩いているのは地面の上で、本当に規則的な運動は、地面の上で見て初めてわかるはずだ。
SparseTrack は推定した疑似深度を使い、Quo Vadis は位置を鳥瞰図に投影して距離を計算する。どちらもこの方向へ一歩進んだが、まだ IoU と組み合わせて使っていて、投影がもたらす不確かさも扱っていない。
問題を解く
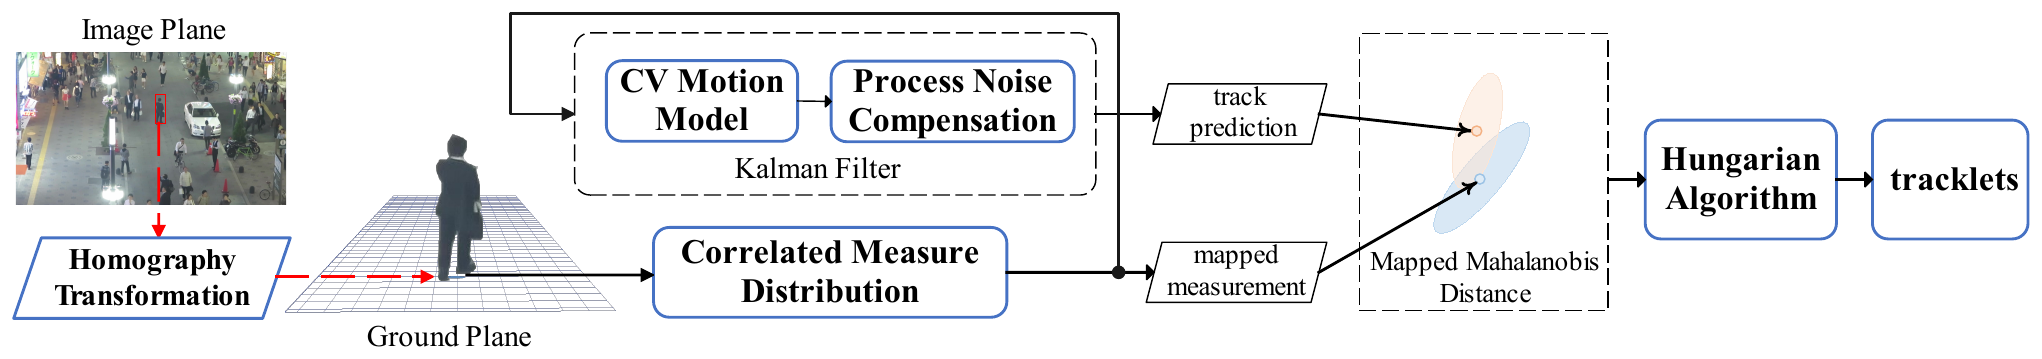
UCMCTrack はあくまで検出してから関連付ける方式で、運動の手がかりだけを使う。変えたのは、どこで運動モデルを立てるか、何の距離でマッチングするか、そしてカメラの揺れをどう扱うかだ。
地面の上で運動モデルを立てる
ある人の検出ボックスの底辺の中点を取ると、おおよそ足が地面を踏んでいる位置になる。カメラの内部パラメータと外部パラメータを使い、この点を画像座標 から地面座標 へ投影する。
はカメラの内部パラメータと外部パラメータからなる投影行列、 はスケール係数だ。
カルマンフィルタも地面の上で回す。状態は地面上の位置と速度 だけで、最も単純な等速モデルを使う。SORT 系列がボックスの中心、面積、縦横比を追うのとは違い、ここではボックスの大きさをまったく気にしない。
投影したら、誤差も一緒に投影する
検出器の誤差は画像の上で生じる。著者らは、画像上の誤差は二つの方向で独立で、その大きさはボックスの幅と高さに比例すると仮定する。
は検出ノイズ係数、、 は検出ボックスの幅と高さだ。
この誤差を地面に投影すると、もう二つの方向で独立ではなくなる。投影の一次近似を使うと、地面上の誤差の共分散は次のようになる。
は投影行列 の逆行列の要素と地面上の位置からなる。 は対角行列ではなく、地面上の誤差が 、 の二方向で強く相関していることを示す。著者らはこれを相関観測分布(Correlated Measurement Distribution、CMD)と呼ぶ。
これは直感的にも納得がいく。斜め上から見下ろして撮ると、画面上で人が上下に数ピクセルずれただけでも、地面に投影すれば視線の方向に沿って前後に大きく違ってくることがある。だから地面上の不確かさは真円ではなく、視線の方向に沿って引き伸ばされ、しかも傾いた楕円になる。
IoU の代わりにマハラノビス距離を使う
地面上の予測と不確かさを伴う観測がそろえば、マッチングの距離にはマハラノビス距離を使う。著者らはこれを写像マハラノビス距離(Mapped Mahalanobis Distance、MMD)と呼び、三つのステップで計算する。
- 残差:。 は地面に投影した観測、 はカルマンフィルタが予測した状態だ。
- 残差の共分散:。 は予測の共分散だ。
- 正規化したマハラノビス距離:
第一項はふつうのマハラノビス距離で、残差は不確かさの大きい方向ではあまり減点されず、不確かさの小さい方向では大きく減点される。第二項の は、不確かさそのものも勘定に入れる。不確かさが大きいほど距離のベースが高くなるので、ひどくぼやけた観測が「何でもありうる」せいで安易にマッチしてしまうことはない。
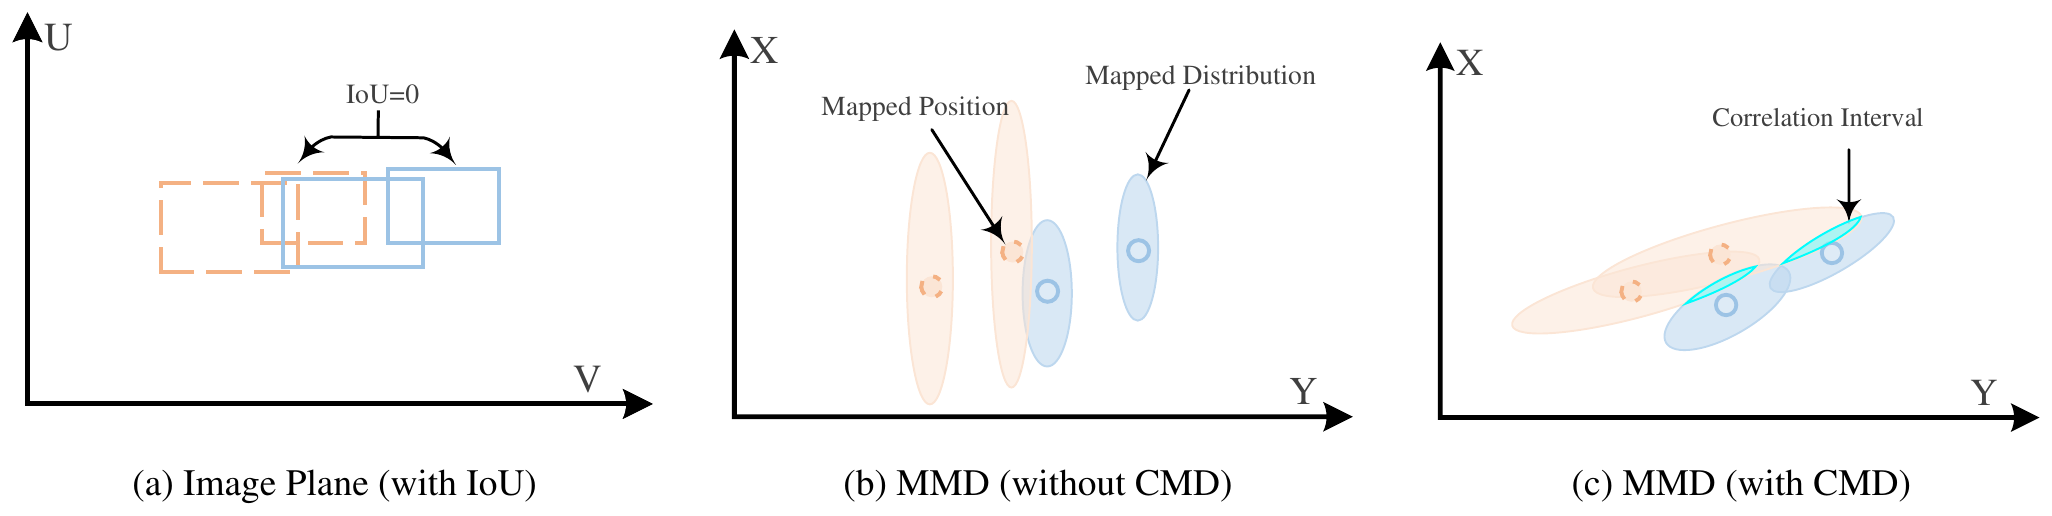
この図は三つの状況を並べている。(a) 画像上の二組のボックスは重ならず、IoU はまったく役に立たない。(b) 地面上で距離を計算するように変えても、誤差を二つの方向で独立だとみなすと、楕円はどれもまっすぐ立ったままで、いちばん近いのはかえって間違ったほうになる。(c) 相関観測分布を使うと、楕円は本当の不確かさの方向に沿って傾き、そこで初めて正しいマッチングが浮かび上がる。
カメラの揺れをノイズとして扱う
最後はカメラの運動だ。著者らは、カメラがフレームごとにどう動いたかを推定せず、それを加速度を生むノイズ源とみなす。時間間隔 の間に、未知の加速度 は位置と速度をそれぞれ次のように変える。
これを行列 にまとめると、カルマンフィルタのプロセスノイズの共分散は次のようになる。
、 はプロセス補償係数と呼ばれ、それぞれカメラの傾きと回転による運動のノイズを吸収する。プロセスノイズを大きくすると、カルマンフィルタは新しい観測をより信じ、予測が大きくずれるのを許すようになるので、カメラが揺れて生じた変位で追跡が途切れることはなくなる。
この二つの係数は同じ動画の中では一定で、これがタイトルにある「一様なカメラ運動補償」(Uniform Camera Motion Compensation)の意味だ。フレームごとのカメラ運動補償と比べて、画像処理は一切要らない。著者らによれば、検出結果が与えられれば、UCMCTrack は CPU 一つで毎秒 1,000 フレーム以上を処理できる。
残りの流れは SORT と同じだ。ハンガリアン法でマッチングし、マッチしなかった軌跡は見失った時間を積算して、しきい値を超えたら削除する。マッチせず、しかも信頼度が十分に高い検出は、新しい軌跡を作る。手法全体で IoU は使わず、外観特徴もない。
カメラパラメータはどこから来るのか
点を地面に投影するには、カメラの内部パラメータと外部パラメータが必要だ。KITTI には用意されているが、MOT17、MOT20、DanceTrack にはどれもないので、著者らが手作業で推定した。
公式のコードには推定ツールが付いていて、ユーザーは三つの回転角、焦点距離、平行移動量を手で調整し、画面上の仮想的な地面のグリッドを画像の中の地面に合わせる。README にも、こうして推定したパラメータはそれほど正確とは限らないが、UCMCTrack にはこれで十分だと書かれている。
議論
検出にはすべて ByteTrack が公開した YOLOX の重みを流用し、KITTI では PermaTrack の検出結果を使う。UCMCTrack+ は ECC による画像の位置合わせを追加したバージョンで、StrongSORT のやり方と同じだ。
主な結果
| 手法 | MOT17 HOTA | MOT17 IDF1 | DanceTrack HOTA | DanceTrack AssA |
|---|---|---|---|---|
| ByteTrack | 63.1 | 77.3 | 47.3 | 31.4 |
| OC-SORT | 63.2 | 77.5 | 55.1 | 40.4 |
| C-BIoU | 64.1 | 79.7 | 60.6 | 45.4 |
| SparseTrack | 65.1 | 80.1 | 55.5 | 39.1 |
| BoT-SORT* | 65.0 | 80.2 | — | — |
| Deep OC-SORT* | 64.9 | 80.6 | 61.3 | 45.8 |
| UCMCTrack | 64.3 | 79.0 | 63.4 | 51.1 |
| UCMCTrack+ | 65.8 | 81.1 | 63.6 | 51.3 |
原論文 Table 1、Table 2 をもとに整理。テストセット。*の付いた手法は外観特徴も使う。
- MOT17: 画像の位置合わせを加えない UCMCTrack は 64.3 で、ほかの運動だけの手法と同じくらいだ。加えた UCMCTrack+ は 65.8 で、外観特徴を使った BoT-SORT や Deep OC-SORT よりも高い。
- DanceTrack: 差はもっと大きい。UCMCTrack の HOTA は 63.4 で、C-BIoU より 2.8 高く、関連付けの AssA は 45.4 から 51.1 になった。位置だけに頼る運動モデルが、ダンサーを相手に、外観を加えた Deep OC-SORT に勝ったわけだ。
- MOT20: UCMCTrack は 62.8 で、MotionTrack と並び、SparseTrack の 63.4 をやや下回り、外観を使う Deep OC-SORT(63.9)よりも低い。ここでは画像の位置合わせの有無で結果は変わらない。おそらく MOT20 のカメラがもともと固定されているからだ。
- KITTI: 10 FPS で、カメラが車と一緒に動く運転のデータセットだ。UCMCTrack の車の HOTA は 77.1 で、OC-SORT の 76.5 より高い。ところが画像の位置合わせを加えた UCMCTrack+ は、逆に 74.2 に落ちる。著者らは、画像の位置合わせのパラメータの推定が不正確だったためだと推測している。
各部品の貢献
アブレーションは ByteTrack を基準に、MOT17 と DanceTrack の検証セットで一つずつ置き換えていく。
| 設定 | MOT17 HOTA | MOT17 IDF1 | DanceTrack HOTA | DanceTrack IDF1 |
|---|---|---|---|---|
| ByteTrack(IoU) | 68.4 | 77.1 | 47.9 | 47.3 |
| MMD に置換 | 68.1 | 75.9 | 46.3 | 43.8 |
| +相関観測分布 | 70.4 | 79.7 | 55.1 | 53.9 |
| +プロセスノイズ補償 | 72.0 | 82.2 | 60.4 | 62.6 |
原論文 Table 4 をもとに整理。検証セット。
- IoU をマハラノビス距離に置き換えただけでは、かえって悪くなる。 著者らの説明では、IoU は位置とボックスの高さを同時に考慮するが、MMD は地面上の一点しか見ない。将来は高さの情報を MMD に加えられるとも述べている。
- 相関観測分布を加えると、IoU を上回る。 DanceTrack では 46.3 から 55.1 に跳ね上がり、9 ポイント近く増えた。誤差の形が正しく投影されて初めて、地面上の距離に意味が出る。
- プロセスノイズ補償でさらに大きく伸びる。 MOT17 で 1.6 ポイント、DanceTrack で 5.3 ポイント増え、IDF1 はさらに 8.7 ポイント増えた。
3 点目については、著者ら自身も、DanceTrack の動画の大部分にははっきりした視点の移動がなく、カメラはほとんど固定されていると述べている。では、ここでプロセスノイズ補償は何を補償しているのか。以下は本稿の推測だ。プロセスノイズを大きくすると、カルマンフィルタは新しい観測をより信じ、より大きな予測誤差を許すようになる。それが吸収しているのは、カメラの揺れよりも、ダンサー自身が急に向きや速さを変えることで生じるずれのほうだろう。この見方をすれば、OC-SORT がカルマンフィルタに手を入れたのや、C-BIoU がボックスを広げたのと、実は同じ問題を扱っていることになる。
フレームごとの補償は、まだ要るのか
| 設定 | MOT17 HOTA | DanceTrack HOTA |
|---|---|---|
| ByteTrack | 68.4 | 47.9 |
| ByteTrack+毎フレーム補償 | 71.0 | 47.6 |
| UCMCTrack | 72.0 | 60.4 |
| UCMCTrack+毎フレーム補償 | 73.0 | 59.2 |
原論文 Table 5 をもとに整理。検証セット。
MOT17 では、UCMCTrack 単独でも「ByteTrack にフレームごとの補償を加えたもの」より良く、両者を重ねるとさらに 1 ポイント伸びる。ところが DanceTrack では、フレームごとの補償を加えると、二つの手法のどちらもかえって悪くなる。著者らの説明では、DanceTrack のカメラはほとんど動かないので、画像の位置合わせをすると、重なり合った人にかえってわずかな変位が生じ、軌跡を取り違えてしまう。
補償係数はシーンに合わせて調整する
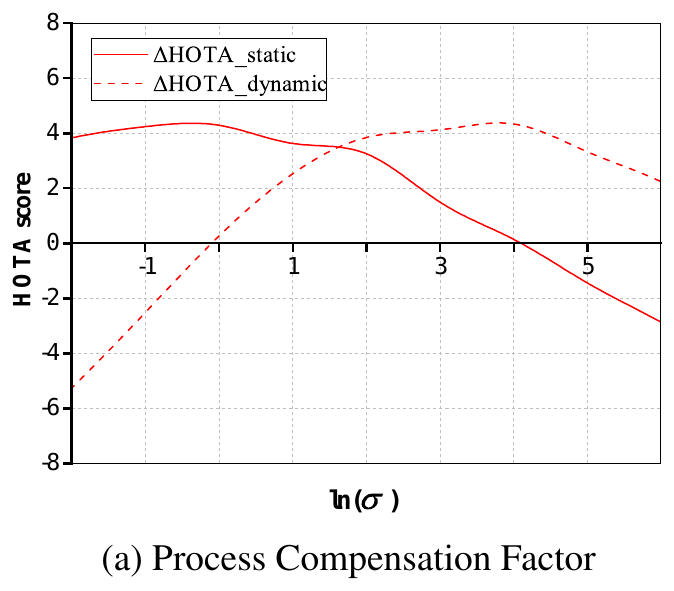
著者らは MOT17 検証セットをカメラが固定された組と移動する組に分け、さまざまな補償係数を試した。二組の曲線はほとんど正反対だ。カメラが固定された動画では補償係数は小さめが最も良く、大きすぎるとかえって基準より悪くなる。カメラが移動する動画では、補償係数を 付近まで大きくする必要があり、小さすぎると基準より 5 ポイント悪くなる。
だから「一様」とは同じ動画の中で一定という意味で、動画ごとにはやはり個別に設定しなければならない。一方、検出ノイズ係数 は 0.05 のとき最も良く、0.04 から 0.1 の間ならどれも影響は小さい。
カメラパラメータの推定を誤ったら
カメラパラメータは手作業で推定するので、どうしても誤差が出る。著者らは外部パラメータの三つの回転軸それぞれに誤差を加えてみた。鉛直軸まわりのヨーの誤差は、推定される地面をあまり変形させないので、影響はごく小さい。残る二つの軸の誤差が大きくなると、地面がはっきり歪み、性能もそれにつれて下がる。そうなったら、推定した地面が実際の地面と合うように、パラメータを調整し直すしかない。
これが、この手法を使うときに最も現実的なハードルでもある。公式コードの issue には、カメラパラメータをどう推定すればいいのか、全自動で推定できないのかを尋ねるものがいくつもある。
結論
UCMCTrack は、複数物体追跡を画像平面から地面へと引き戻した。検出ボックスの底辺の中点を地面に投影し、誤差も一緒に傾いた楕円として投影して、IoU の代わりにマハラノビス距離を使う。カメラの揺れはカルマンフィルタのプロセスノイズとして扱い、動画全体で一組のパラメータで済ませる。外観を使わず、フレームごとの画像の位置合わせもせずに、MOT17 と DanceTrack の両方で外観特徴を使う手法に追いつき、さらには上回った。
その代わりにカメラパラメータが必要になり、公開データセットの大半はそれを提供していないので、手作業で推定しなければならない。著者らも認めているとおり、この手法はすべての人が同じ平面の上に立っていると仮定していて、階段、観客席、坂道のような場面では成り立たない。
トラッカーが画面で見ているのは、投影された世界だ。それを地面に戻してやれば、不規則に見える多くの運動は、実は透視とカメラの揺れが生んだ錯覚にすぎない。