原論文
STORM: End-to-End Referring Multi-Object Tracking in Videos
- 発表先
- CVPR Findings 2026国際会議
- arXiv への初回投稿
- arXiv:2604.10527
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingstorm2026,
  title = {{STORM: End-to-End Referring Multi-Object Tracking in Videos}},
  author = {Zijia Lu and Jingru Yi and Jue Wang and Yuxiao Chen and Junwen Chen and Xinyu Li and Davide Modolo},
  year = {2026},
  eprint = {2604.10527},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2604.10527}
}
ふつうの複数物体追跡が追うのは、画面に映るすべての人、あるいはすべての車だ。実際に使うときには、そのうちのいくつかにしか関心がないことが多い。「サングラスをかけ、ノートパソコンを持ったあの人」「左の二人の子ども」「スキーをしている人と、その足元の板」といった具合だ。
一文で追う対象を名指しするこのタスクは、referring multi-object tracking(RMOT)と呼ばれる。モデルはまず記述を理解し、条件に合う物体を見つけ、それから追い続けなければならず、ふつうの追跡より一段多い。
Amazon の Zijia Lu、Davide Modolo らは、記述を理解することこそ大規模言語モデルの得意分野だと考えた。彼らが作った STORM はマルチモーダル大規模言語モデルで、動画と一文の記述を読み込み、各物体の各フレームでのボックスを直接テキストで書き出す。
問題の定義
既存のやり方は寄せ集め
これまでの RMOT の手法は、たいてい専用の検出器にテキストエンコーダを足し、検出結果を記述に従ってふるいにかけるものだった。このやり方は「赤い車」なら扱えるが、「絵の右にいるあの二人の演者」のような関係を含む記述は扱えない。
マルチモーダル大規模言語モデルで位置特定を行う手法は、複雑な言葉を理解できるが、ほとんどが単一の画像しか扱わない。動画に使うには別にトラッカーや検出器をつなぐ必要があり、言語モデルはテキストの理解だけを担い、「このボックスが次のフレームでどこへ行ったか」には直接関わらない。著者らは、いまのところ RMOT をエンドツーエンドで扱う手法は一つもないと指摘する。
データは少ないうえに乱れている
もっと大きな問題はデータだ。マルチモーダル大規模言語モデルには大量の質の高い訓練データが必要だが、RMOT のアノテーションは極めて高くつく。各フレームにボックスが要り、しかもそのボックスが一文の正確な記述と対応していなければならない。
既存のデータセットにはそれぞれ難がある。Refer-KITTI は交通シーンだけで、カテゴリは二種類しかない。LaSOT の記述はしばしば具体性に欠け、一本の動画に同じ種類の動物が何匹もいるのに、記述はどれのことかを言っていない。Elysium は規模が大きいが、ボックスと記述が食い違うものが少なくない。LaMOT は規模が小さく、多くの記述はカテゴリ名にすぎない。
問題を解く
すべてのボックスをテキストで書く
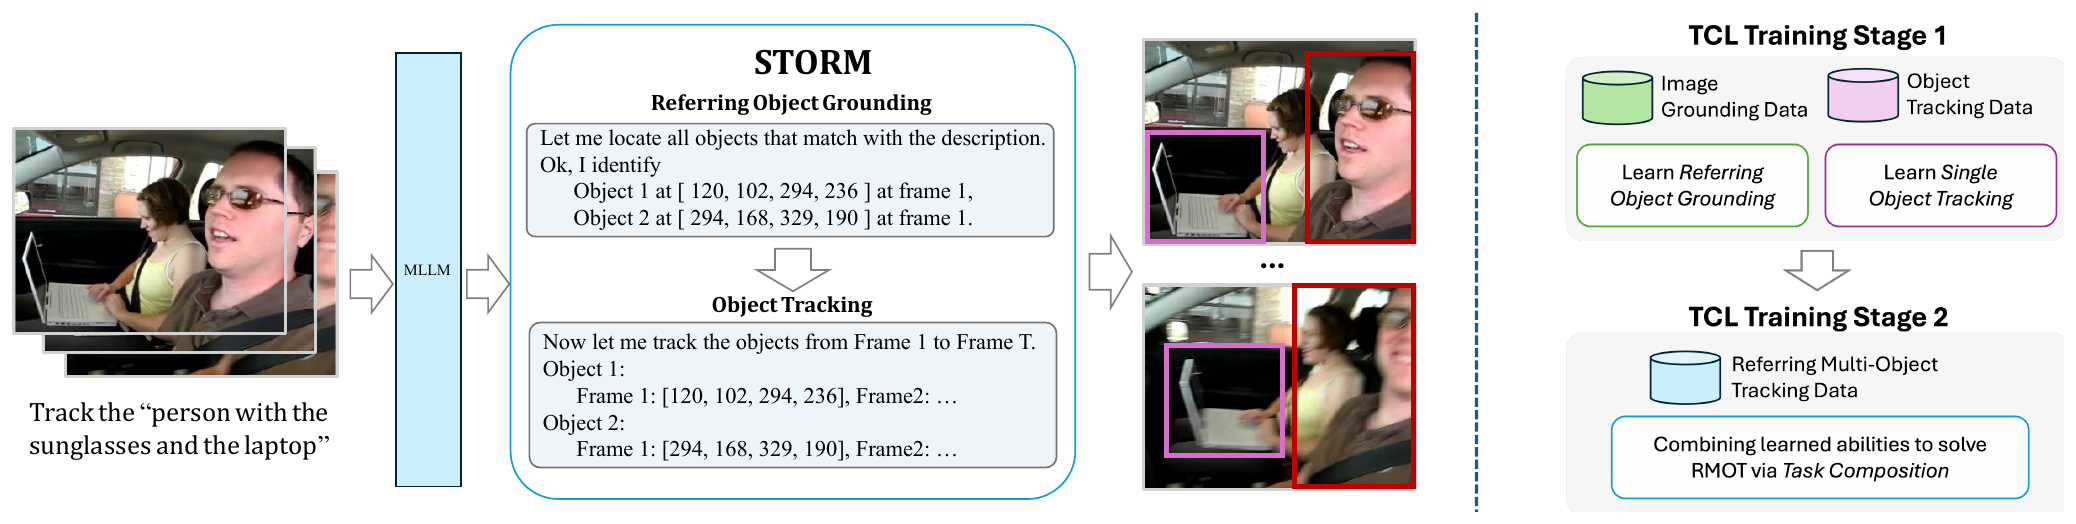
STORM のアーキテクチャは標準的な LLaVA 式の設計だ。視覚エンコーダが各フレームを視覚 token に変え、二層の MLP でテキスト空間に射影し、記述と一緒に 80 億パラメータの言語モデルに送る。視覚エンコーダには NaViT を使っていて、任意の解像度や縦横比を扱えるので、画面を無理に固定サイズに縮める必要がなく、正確な位置特定が求められるタスクには有利だ。
モデルの出力は一段のテキストで、形式は「Object 1: Frame 1: [x1, y1, x2, y2], Frame 2: …; Object 2: …」となる。物体ごとに一段で、各フレームでのボックスを順に書いていく。座標は画面上の絶対ピクセル位置だ。物体が一時的に隠れたり画面の外に出たりしたときは、空のボックスを出力する。訓練はふつうの次 token 予測で、交差エントロピー損失を使う。この過程全体に検出器もトラッカーもハンガリアン法もなく、身元の一貫性は言語モデル自身が保つ。「Object 1」の下に書かれたボックスは、すべて同じ物体だ。
動画が長すぎるときは、いくつかの区間に切り、前の区間の最後に予測したボックスを次の区間へのプロンプトにして、軌跡をつなぐ。
タスクを分解して学ぶ
RMOT のデータは少なすぎるので、著者らはこれをデータの豊富な二つのサブタスクに分解した。記述に基づく位置特定と追跡だ。
- 第一段階。 大量の画像の位置特定データで、記述に従って単一の画像の中で物体を見つけることを学ぶ。単一物体追跡のデータで、一つの物体をフレームからフレームへ追い続けることを学ぶ。さらに記述による単一物体追跡のデータを少し加えて、二つの能力を結びつける。
- 第二段階。 著者らが自作した STORM-Bench でファインチューニングする。訓練時には、モデルにまず推論の過程を書かせる。最初のフレームで記述されたすべての物体を見つけ、それから順に追跡する。二つのサブタスクの順序をモデルに明示的に教えているわけだ。
著者らはこのやり方を task-composition learning(TCL)と呼んでいる。
下から積み上げたデータセット
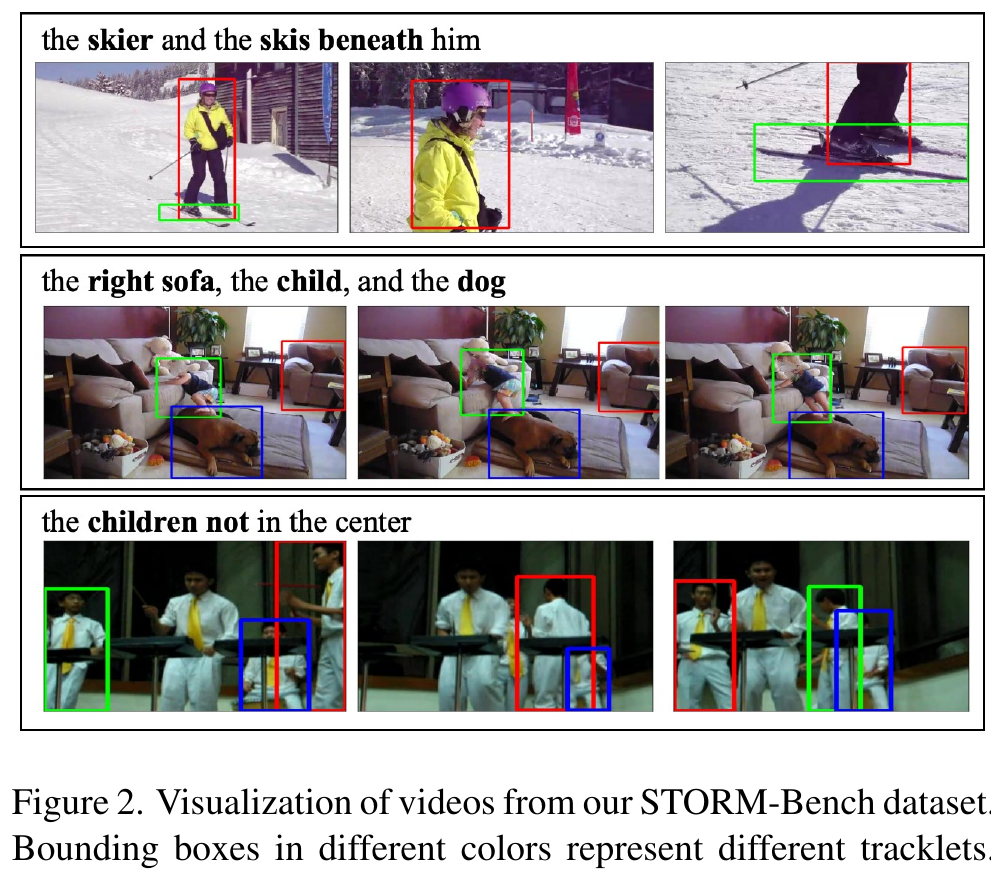
これまでの大規模なデータセットは、たいてい上から下へ作られていた。まず動画全体に記述を書き、次に Grounding-DINO で記述の中の名詞を探し、さらにトラッカーでボックスをつなぐ。どのステップも専門モデルに頼っていて、どこか一つで誤れば、その誤りがデータに残る。
STORM-Bench は逆の順序で作る。記述から物体を探すのは難しいが、物体が与えられていれば、その記述を書くのは比較的やさしい。著者らはこの非対称性を利用した。データは VidOR の上に作られていて、このデータセットにはもともと日常の物体の正解ボックスがある。
- 物体ごとに記述を書く。 動画の上で対象の物体に赤枠を描き、Qwen2.5-VL にそれを記述させる。さらに別のモデルに、その記述がこの物体一つだけに対応しているかを検証させる。検証では入力を三通りに変える。元の動画に赤枠をつけたもの、枠の外をぼかしたもの、物体だけを切り抜いたものだ。三つすべてを通過した記述だけを残す。
- 複数物体の記述を組み立てる。 動画内のすべての物体の記述を推論の得意な言語モデルに渡し、ランダムに選んだいくつかの物体について、共通する属性や互いを区別する属性を見つけさせ、一文の記述にまとめさせる。たとえば「棚の上の楽器」や「女の子と、その後ろを走る猫」だ。さらにマルチモーダルモデルに動画とボックスを照らし合わせてもう一度検証させる。
最終的に、訓練動画 1.5 万本、テスト動画 714 本、合わせて 20 万文の記述と 7.37 万本の物体軌跡が得られ、80 カテゴリをカバーしている。一つの記述が指す物体は平均 3 個で、平均の長さは英単語 12.2 語と、LaMOT の 3.8、Elysium の 2.1 よりずっと長い。
議論
参照表現による複数物体追跡
| 手法 | HOTA | AssA | IDF1 | ID スイッチ |
|---|---|---|---|---|
| Grounding DINO + OC-SORT | 31.7 | 56.5 | 27.3 | 2,953 |
| Qwen2.5-VL + OC-SORT | 37.9 | 62.6 | 38.6 | 2,767 |
| VisionLLMv2 + OC-SORT | 45.3 | 58.9 | 44.6 | 12,097 |
| LaMOT | 46.7 | 56.1 | 48.8 | 7,972 |
| STORM(STORM-Bench のみ) | 34.8 | 56.8 | 36.4 | 2,832 |
| STORM | 66.7 | 82.6 | 78.3 | 183 |
原論文 Table 4 をもとに整理。STORM-Bench テストセット。
直接比べられるエンドツーエンドの手法はないので、著者らはフレームごとに位置特定できるいくつかのモデルにそれぞれボックスを作らせ、OC-SORT で軌跡につないだ。LaMOT は公式の重みを使い、STORM-Bench でファインチューニングした。
STORM の HOTA は 66.7 で、最良の LaMOT より 20 ポイント高い。ID スイッチはわずか 183 回で、LaMOT は 7,972 回だ。これは完全に公平な比較ではない。STORM-Bench は著者ら自身のデータセットで、アノテーションのやり方も STORM の訓練データと出どころが同じだ。それでも ID スイッチが四十倍以上違うことは、この点だけでは説明しにくい。フレームごとに位置特定してからつなぐ手法は、どのフレームでも人を取り違えうる。STORM は軌跡全体を同じ「Object 1」の下に書くので、身元はもともと入れ替わりにくい。
同じ表で、STORM-Bench だけで訓練した STORM は HOTA が 34.8 しかなく、Qwen2.5-VL に OC-SORT をつないだものより低い。第一段階の位置特定と追跡の事前訓練を加えると、66.7 に跳ね上がる。アーキテクチャだけでは足りず、分解して学ぶ訓練方式こそが主な要因だ。
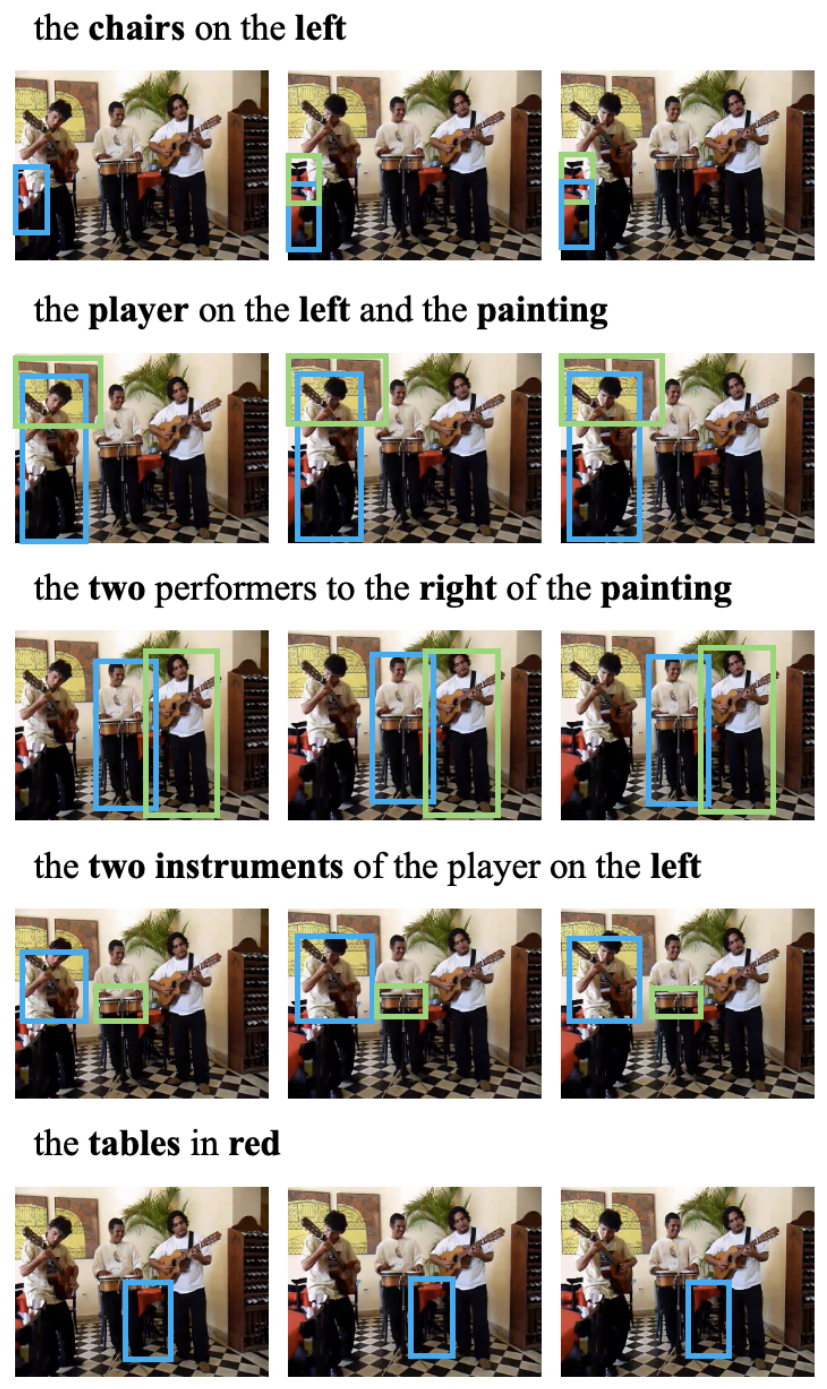
この図から、記述の柔軟さがわかる。同じ動画、同じモデルで、記述は物体の位置(左の椅子)、物体同士の関係(絵の右にいる二人の演者)、所属(左のミュージシャンの楽器二つ)を指せるし、異なるカテゴリを混ぜる(ミュージシャンと絵)こともできる。
分解して学ぶ効果
| 画像の位置特定 | 単一物体追跡 | 記述付き単一物体追跡 | 記述付きの成績 |
|---|---|---|---|
| 100 万 | 0 | 10 万 | 77.4 |
| 100 万 | 0 | 100 万 | 84.1 |
| 100 万 | 90 万 | 10 万 | 83.0 |
原論文 Table 5 をもとに整理。データ量は訓練サンプル数、成績は記述による単一物体追跡のテスト結果。
記述による単一物体追跡のデータは、ふつうの単一物体追跡よりアノテーションが高くつく。この表から、ふつうの追跡データ 90 万件に記述付きのデータ 10 万件を組み合わせると、記述付きのデータを 100 万件使ったときに近い成績になることがわかる。安いサブタスクのデータで、高価な完全タスクのデータを代替できる。
RMOT のデータそのものの量も試している。5 千件で HOTA 26.4、1 万件で 53.4、1.2 万件で 63.3、1.5 万件で 66.7 だ。1.2 万件あたりから伸びが緩やかになり始めるので、著者らはデータセットを 1.5 万件で止めた。
画像の位置特定と単一物体追跡
STORM は動画向けに設計されているが、画像の位置特定でもなお競争力がある。RefCOCO の検証セットと testA、RefCOCO+ の testA、RefCOCOg のテストセットでは、どれも表の中で最も高い。残りのいくつかの列では、それぞれほかのモデルがわずかに上回る。たとえば RefCOCO の testB では、MiniGPT-v2 が 85.3、STORM が 83.8 だ。
単一物体追跡の Elysium で、最初のフレームのボックスを与えた場合、STORM の AUC は 89.8、Elysium は 88.7 だ。短い記述で対象を指定した場合は、84.1 対 83.3 になる。著者らが記述をより長く具体的に書き直すと、両者の AUC はほとんど同じ(87.4 対 87.5)になり、STORM のほうが precision はやや高い。
速度
座標をテキストで一つずつ書き出すことの代償は速度だ。付録では、物体を一つだけ追う場合、動画が 32 フレームでも 256 フレームでも、速度は毎秒 3.3 フレーム前後だ。ところが対象が増えると遅くなる。
| 対象の数 | 書き出すボックス | 時間 | ボックスあたり |
|---|---|---|---|
| 1 | 64 | 19.7 秒 | 0.31 秒 |
| 8 | 512 | 143.3 秒 | 0.28 秒 |
時間は原論文の付録 Table 7(64 フレームの動画)をもとに整理。ボックスあたりの時間は本稿で計算。
かかる時間は書き出すボックスの数にほぼ比例し、ボックス一つあたり約 0.3 秒だ。対象を 8 つ追うと、64 フレームの動画に 2 分あまりかかり、換算すると毎秒半フレームにも満たない。
著者らは付録で、とても長い動画や対象が十個を超える場合には、出力するテキストの系列が長くなりすぎて、モデルは苦戦するとも述べている。残る誤差はおもに位置特定にある。記述がとてもあいまいだったり場面がひどく混んでいたりすると、ボックスが不正確になる。
結論
STORM は参照表現による複数物体追跡を、丸ごと一つのマルチモーダル大規模言語モデルに任せた。動画を読み、記述を読み、各物体の各フレームでのボックスをテキストで書き出す。身元は出力の構造によって保たれるので、ID スイッチは驚くほど少ない。
これを本当に成り立たせているのは訓練方式だ。完全なタスクのデータが少なすぎるので、まず大量の画像の位置特定データと単一物体追跡データで二つの能力を別々に学ばせ、少量の完全なデータでそれらをつなぐ。自作の STORM-Bench は「先に物体があり、それから記述を書く」やり方で、上から下へアノテーションするときに積み重なる誤りを避けている。
ただ、どのボックスもテキストで一つひとつ書き出さなければならないので、追うものが多いほど、書くのに時間がかかる。