原始論文
STORM: End-to-End Referring Multi-Object Tracking in Videos
- 發表版本
- CVPR Findings 2026會議
- arXiv 首次提交
- arXiv:2604.10527
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{multiobjecttrackingstorm2026,
  title = {{STORM: End-to-End Referring Multi-Object Tracking in Videos}},
  author = {Zijia Lu and Jingru Yi and Jue Wang and Yuxiao Chen and Junwen Chen and Xinyu Li and Davide Modolo},
  year = {2026},
  eprint = {2604.10527},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2604.10527}
}
一般的多目標追蹤,要追的是畫面上所有的人,或所有的車。實際使用時,我們常常只關心其中幾個:「戴墨鏡、拿著筆電的那個人」,「左邊那兩個小孩」,「滑雪的人和他腳下的雪板」。
用一句話指定要追哪些東西,這個任務叫做 referring multi-object tracking(RMOT)。模型得先聽懂描述,找出符合的物體,再一路追下去,比一般的追蹤多了一層。
亞馬遜的 Zijia Lu、Davide Modolo 等人認為,聽懂描述正是大型語言模型的強項。他們做了 STORM,一個多模態大型語言模型,讀進影片和一句描述,直接用文字寫出每個物體在每一幀的框。
定義問題
現有做法是拼起來的
過去的 RMOT 方法,大多是在專門的偵測器上加一個文字編碼器,讓偵測結果依描述過濾。這種做法處理得了「紅色的車」,處理不了「畫右邊的那兩位表演者」這種牽涉關係的描述。
用多模態大型語言模型做定位的方法,看得懂複雜的語言,但大多只處理單張影像。要用在影片上,就得另外接一個追蹤器或偵測器,語言模型只負責理解文字,沒有直接參與「這個框在下一幀跑到哪裡」。作者指出,到目前為止,沒有一個方法是端到端處理 RMOT 的。
資料又少又亂
更大的問題是資料。多模態大型語言模型需要大量高品質的訓練資料,但 RMOT 的標註極其昂貴:每一幀都要有框,框還要和一句精確的描述對得上。
現有的資料集各有毛病。Refer-KITTI 只有交通場景、兩種類別;LaSOT 的描述常常不夠具體,一段影片裡有好幾隻同類的動物,描述卻沒說是哪一隻;Elysium 規模大,但有不少框和描述對不上;LaMOT 規模小,很多描述只是類別名稱。
解決問題
用文字寫出所有的框
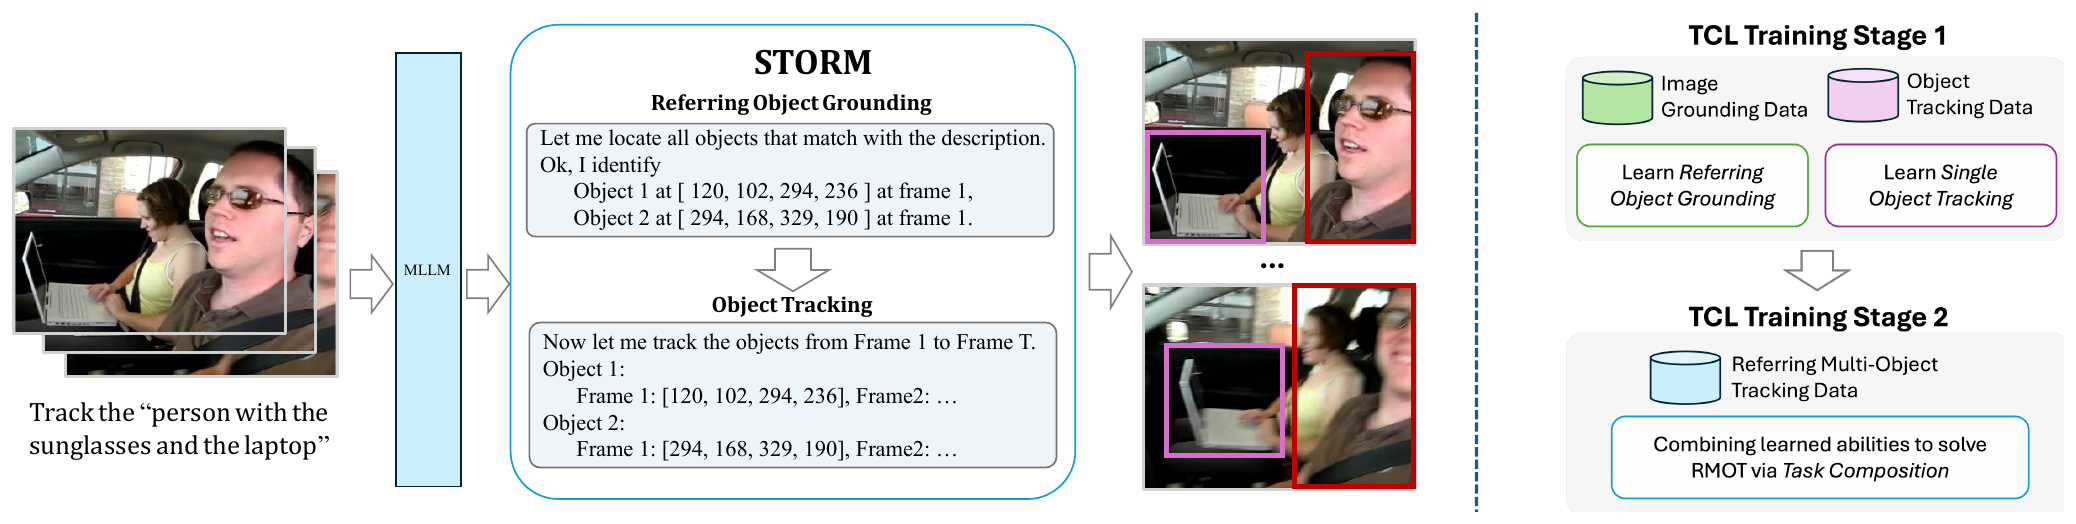
STORM 的架構是標準的 LLaVA 式設計:視覺編碼器把每一幀變成視覺 token,經過兩層 MLP 投影到文字空間,和描述一起送進一個 80 億參數的語言模型。視覺編碼器用的是 NaViT,可以處理任意解析度和長寬比,不必把畫面硬縮成固定大小,對需要精確定位的任務比較有利。
模型的輸出就是一段文字,格式是「Object 1: Frame 1: [x1, y1, x2, y2], Frame 2: …; Object 2: …」,每個物體一段,依序寫出它在每一幀的框。座標是畫面上的絕對像素位置。物體暫時被擋住或離開畫面時,輸出一個空框。訓練就是一般的下一個 token 預測,用交叉熵損失。整個過程沒有偵測器、沒有追蹤器、沒有匈牙利演算法,身分的一致性由語言模型自己維持:寫在「Object 1」底下的框,就是同一個物體。
影片太長時,就切成幾段,前一段最後預測的框當作下一段的提示,把軌跡接起來。
把任務拆開來學
RMOT 的資料太少,作者的辦法是把它拆成兩個資料豐富的子任務:依描述定位和追蹤。
- 第一階段。 用大量的影像定位資料,學會依描述在單張影像上找到物體;用單物體追蹤資料,學會把一個物體一幀一幀跟下去;再加一點描述式的單物體追蹤資料,把兩種能力接在一起。
- 第二階段。 在作者自建的 STORM-Bench 上微調。訓練時讓模型先寫出推理的過程:先在第一幀找出所有被描述的物體,再依序追蹤。這是把兩個子任務的順序明確地教給模型。
作者把這個做法叫做 task-composition learning(TCL)。
由下而上的資料集
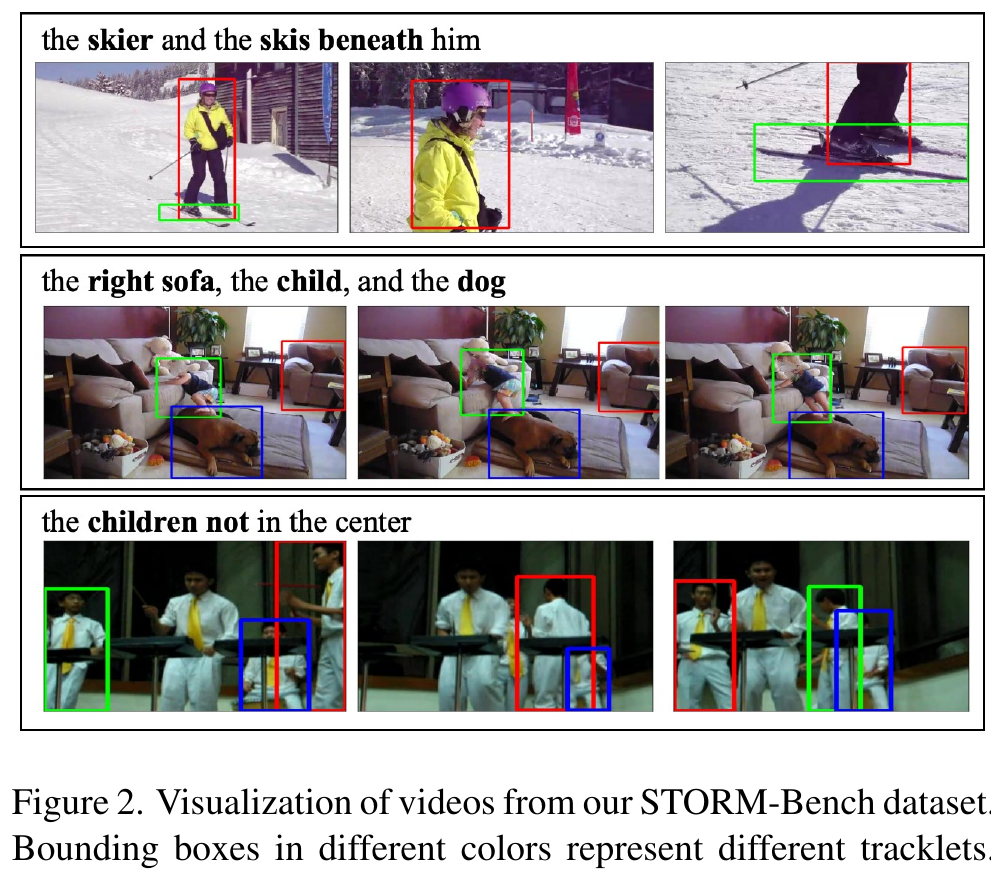
過去的大型資料集多是由上而下產生的:先為整段影片寫描述,再用 Grounding-DINO 找出描述中的名詞,再用追蹤器把框串起來。每一步都依賴專家模型,任何一步出錯都會留在資料裡。
STORM-Bench 反過來做。作者利用一個不對稱:依描述找物體很難,但給定一個物體,寫出它的描述相對容易。資料建立在 VidOR 上,這個資料集本來就有日常物體的真值框。
- 為每個物體寫描述。 在影片上把目標物體畫上紅框,請 Qwen2.5-VL 描述它。再請另一個模型驗證這段描述是否只對應這一個物體,驗證時換三種輸入:原影片加紅框、框外模糊、只裁出物體。三種都通過的描述才保留。
- 組合多物體的描述。 把影片裡所有物體的描述交給一個擅長推理的語言模型,對隨機挑出的幾個物體,找出它們共同或彼此區別的屬性,寫成一句描述,例如「架上的樂器」或「女孩和跑在她後面的貓」。再請多模態模型對照影片和框驗證一次。
最後得到 1.5 萬段訓練影片、714 段測試影片,共 20 萬句描述、7.37 萬條物體軌跡,涵蓋 80 個類別。每句描述平均指向 3 個物體,平均長度 12.2 個英文字,比 LaMOT 的 3.8、Elysium 的 2.1 都長得多。
討論
描述式多目標追蹤
| 方法 | HOTA | AssA | IDF1 | ID 切換 |
|---|---|---|---|---|
| Grounding DINO + OC-SORT | 31.7 | 56.5 | 27.3 | 2,953 |
| Qwen2.5-VL + OC-SORT | 37.9 | 62.6 | 38.6 | 2,767 |
| VisionLLMv2 + OC-SORT | 45.3 | 58.9 | 44.6 | 12,097 |
| LaMOT | 46.7 | 56.1 | 48.8 | 7,972 |
| STORM(只用 STORM-Bench) | 34.8 | 56.8 | 36.4 | 2,832 |
| STORM | 66.7 | 82.6 | 78.3 | 183 |
整理自原論文 Table 4,STORM-Bench 測試集。
沒有端到端的方法可以直接比,作者讓幾個能逐幀定位的模型各自產生框,再用 OC-SORT 串成軌跡;LaMOT 則用官方權重,再在 STORM-Bench 上微調。
STORM 的 HOTA 是 66.7,比最好的 LaMOT 高了 20 分;ID 切換只有 183 次,LaMOT 是 7,972 次。這不完全是公平的比較,STORM-Bench 是作者自己的資料集,標註方式也和 STORM 的訓練資料同源。但 ID 切換差了四十多倍,很難只用這點解釋。逐幀定位再串接的方法,每一幀都可能找錯人;STORM 把整條軌跡寫在同一個「Object 1」底下,身分本來就不容易換。
同一張表裡,只用 STORM-Bench 訓練的 STORM,HOTA 只有 34.8,比 Qwen2.5-VL 加 OC-SORT 還低;加上第一階段的定位和追蹤預訓練,跳到 66.7。光有架構不夠,拆開學的訓練方式才是主因。
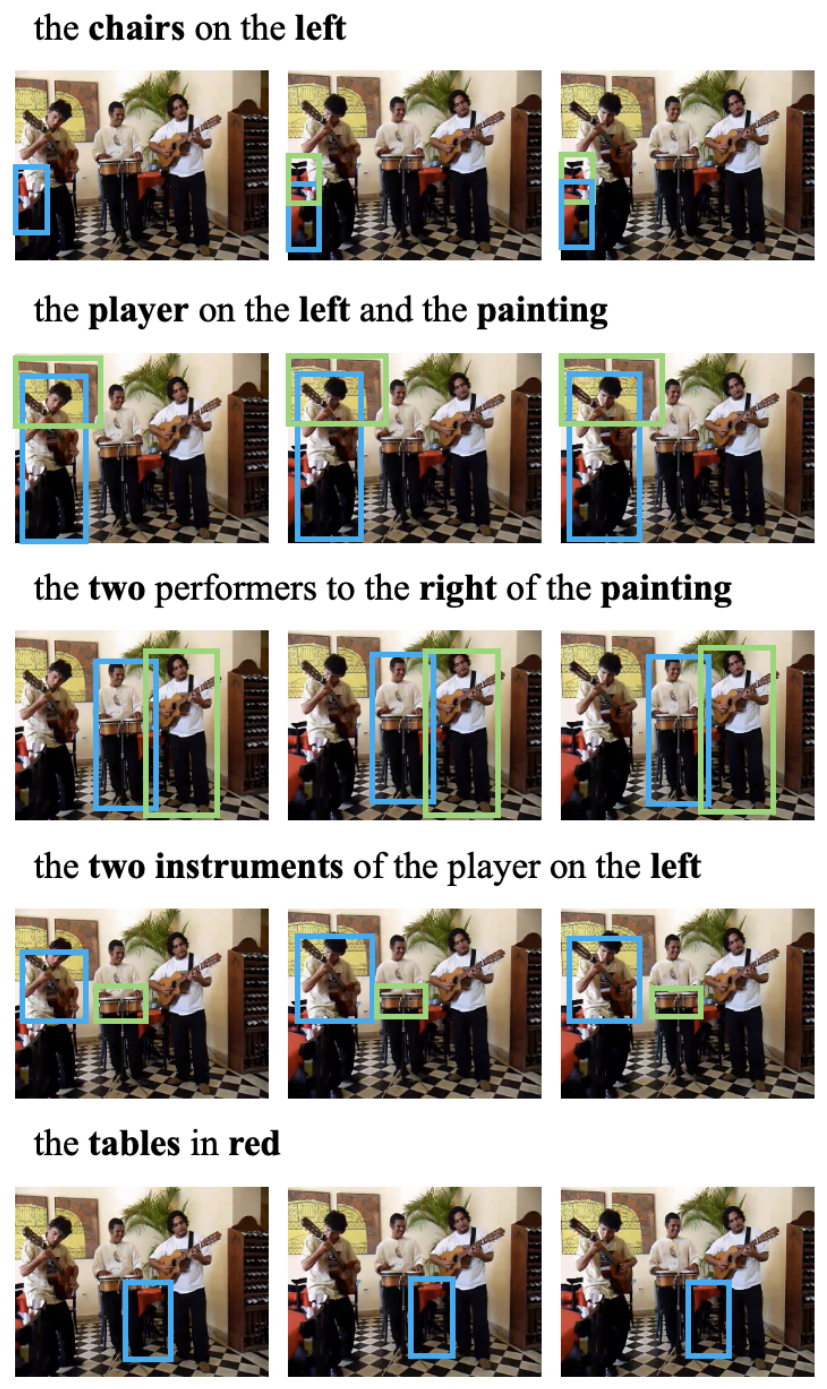
這張圖看得出描述的彈性。同一段影片,同一個模型,描述可以指物體的位置(左邊的椅子)、物體之間的關係(畫右邊的兩位表演者)、從屬(左邊樂手的兩件樂器),也可以混合不同類別(樂手和畫)。
拆開學的效果
| 影像定位 | 單物體追蹤 | 描述式單物體追蹤 | 描述式單物體追蹤成績 |
|---|---|---|---|
| 100 萬 | 0 | 10 萬 | 77.4 |
| 100 萬 | 0 | 100 萬 | 84.1 |
| 100 萬 | 90 萬 | 10 萬 | 83.0 |
整理自原論文 Table 5;資料量為訓練樣本數,成績為描述式單物體追蹤的測試結果。
描述式的單物體追蹤資料,標起來比一般的單物體追蹤貴。這張表顯示,用 90 萬筆一般的追蹤資料,搭配 10 萬筆描述式資料,成績就接近用 100 萬筆描述式資料。便宜的子任務資料,可以替代昂貴的完整任務資料。
RMOT 資料本身的用量也試過:5 千筆 HOTA 26.4,1 萬筆 53.4,1.2 萬筆 63.3,1.5 萬筆 66.7。大約 1.2 萬筆之後開始趨緩,作者因此把資料集停在 1.5 萬筆。
影像定位和單物體追蹤
STORM 雖然是為影片設計的,在影像定位上仍有競爭力。RefCOCO 的驗證集和 testA、RefCOCO+ 的 testA、RefCOCOg 的測試集上,它都是表中最高的;其餘幾欄則各有其他模型略高,例如 RefCOCO 的 testB,MiniGPT-v2 是 85.3,STORM 是 83.8。
單物體追蹤的 Elysium 上,給第一幀的框時,STORM 的 AUC 是 89.8,Elysium 是 88.7;用簡短描述指定目標時,是 84.1 對 83.3。作者把描述改寫得更長、更具體之後,兩者的 AUC 幾乎一樣(87.4 對 87.5),STORM 的精確度則略高。
速度
用文字一個一個寫出座標,代價是速度。附錄裡,只追一個物體時,不論影片是 32 幀還是 256 幀,速度都在每秒 3.3 幀左右。但目標一多就變慢:
| 目標數 | 要寫出的框 | 時間 | 每個框 |
|---|---|---|---|
| 1 | 64 | 19.7 秒 | 0.31 秒 |
| 8 | 512 | 143.3 秒 | 0.28 秒 |
時間整理自原論文附錄 Table 7(64 幀影片),每個框的時間為本文計算。
花的時間和要寫出的框數幾乎成正比,每個框大約 0.3 秒。追 8 個目標時,一段 64 幀的影片要兩分多鐘,換算下來每秒不到半幀。
作者也在附錄裡提到,很長的影片、或者超過十個目標時,輸出的文字序列會變得太長,模型就比較吃力。剩下的誤差主要在定位:描述很模糊或場景很擠時,框會不準。
結論
STORM 把描述式多目標追蹤,整個交給一個多模態大型語言模型:讀影片、讀描述,用文字寫出每個物體在每一幀的框。身分由輸出的結構維持,所以 ID 切換少得驚人。
真正讓它成立的是訓練方式。完整任務的資料太少,就先用大量的影像定位和單物體追蹤資料,把兩種能力分別學好,再用少量的完整資料把它們接起來。自建的 STORM-Bench 則用「先有物體、再寫描述」的方式,避開了由上而下標註時層層累積的錯誤。
只是每一個框都得用文字一筆一筆寫出來,要追的東西越多,寫得越久。