原論文
Visual Instruction Tuning
- 発表先
- NeurIPS 2023国際会議
- arXiv への初回投稿
- arXiv:2304.08485
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multimodalityllava2023,
  title = {{Visual Instruction Tuning}},
  author = {Haotian Liu and Chunyuan Li and Qingyang Wu and Yong Jae Lee},
  year = {2023},
  eprint = {2304.08485},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2304.08485}
}
OpenAI が 2023 年 3 月に発表した GPT-4 の技術報告には、画像を見て答える例がいくつか載っている。その一つは、タクシーの後ろに立ってアイロンをかけている男性の写真で、「この画像のどこが変わっているか」と聞かれた GPT-4 は、的確に答えていた。ただ、当時は画像を見る機能が公開されておらず、みんな報告書のスクリーンショットを眺めるしかなかった。
オープンソースの側では、LLaMA が公開されて間もなく、Alpaca や Vicuna が機械生成の指示データで LLaMA を微調整し、なかなかのチャットモデルを作っていた。ただし、どれもテキストだけだった。
一か月後、ウィスコンシン大学、Microsoft Research、コロンビア大学の Liu、Li らが LLaVA(Large Language and Vision Assistant)を発表し、指示チューニングを画像とテキストのマルチモーダルに持ち込んだ。この論文でいちばん面白いのはデータだ。彼らは GPT-4 に「画像を見ながらの対話」の訓練データを作ってもらったが、当時の GPT-4 は画像を見られず、使ったのはテキストしか受け付けない版だった。
問題の定義
それまでの視覚モデルは、たいてい一つのタスクに一つのモデルだった。分類、検出、セグメンテーション、画像キャプション生成はそれぞれ別に訓練され、言語は画像の内容を説明するためだけに使われていて、ユーザーが出せる指示はごく限られていた。
一方、Flamingo や BLIP-2 のような画像とテキストのモデルは、すでに画像を大規模言語モデルにつなげられるようになっており、キャプション生成や視覚的質問応答ではなかなかの成績を出していた。ただ、これらは大量の画像とテキストのペアで訓練されていて、「ユーザーの指示どおりに答える」練習は特にしていない。「この画像のどこが変わっているか」と聞いても、たいていは画像を説明するだけだ。
モデルに指示どおりに画像を見ることを覚えさせるには、「画像+指示+回答」のようなデータが必要になる。ネット上には CC から LAION まで、画像とテキストのペアがいくらでもあるが、画像つきの指示データはほとんどない。人に書いてもらうと時間がかかるうえ、どんな形で書くべきかも定まっていなかった。
問題を解く
画像を見られない GPT-4 に出題させる
いちばん簡単なのは、画像とテキストのペアをそのまま指示の形式に書き直すことだ。画像 にキャプション を組み合わせ、「この画像を簡潔に説明してください」のような質問 をランダムに一つ選ぶ。
Human : X_q X_v <STOP>
Assistant : X_c <STOP>
これは安上がりだが、質問も答えも単調で、推論はまったく含まれない。
著者らは代わりに、テキストしか受け付けない GPT-4(または ChatGPT)に先生役を頼んだ。画像を見られないのだから、画像を文字に翻訳して見せる。使うのは二種類の記号表現だ。
- キャプション:COCO の各画像には人が書いた説明が何文もあり、さまざまな角度から場面を説明している。
- バウンディングボックス:各物体のクラスと位置で、座標は 0 から 1 に正規化してある。
論文の例は、地下駐車場の写真だ。
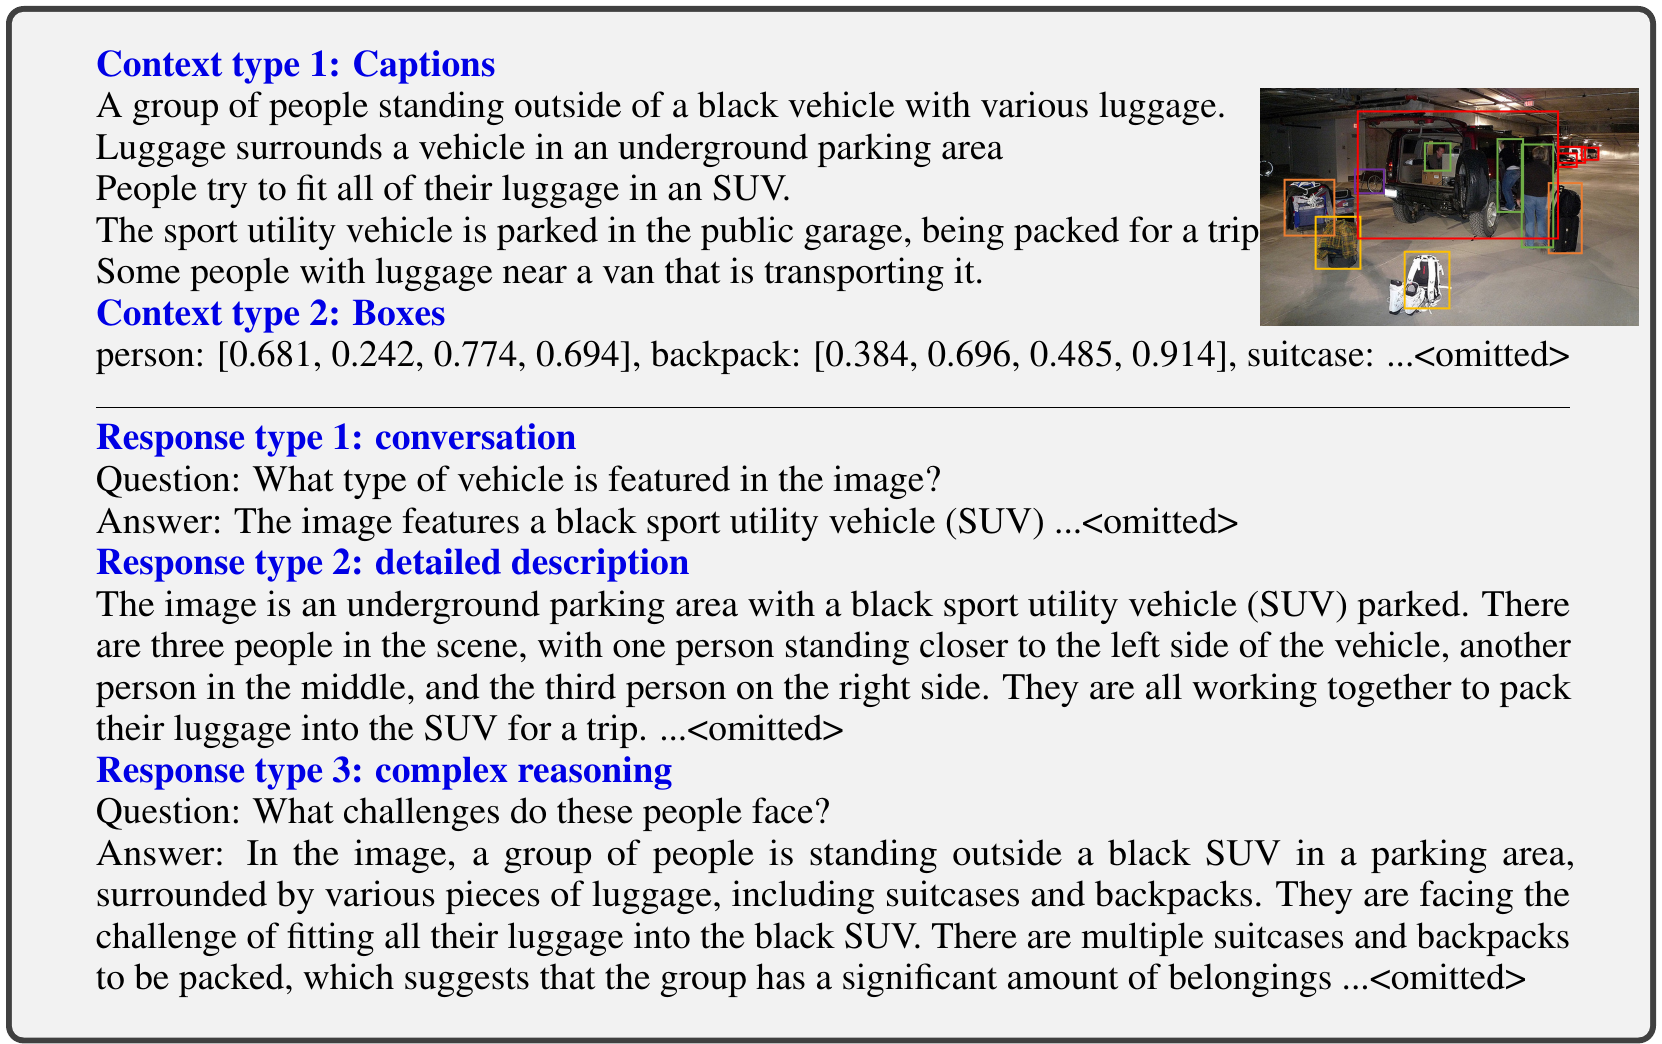
上半分が GPT-4 の受け取った内容のすべてで、キャプション五文とバウンディングボックスの列だ。右上の写真は論文が読者向けに載せたもので、GPT-4 自身には見えない。下半分は、GPT-4 がこれらの文字をもとに書いた三種類の回答だ。
そのうえで、三種類のデータを作らせる。
- 対話:ユーザーが尋ね、アシスタントが答える形を模したもので、アシスタントが本当にこの画像を見ているような口ぶりにする。質問は物体の種類、数、動作、位置、相対的な位置にわたり、答えがはっきりしていることだけを尋ねる。たとえば「写っているのは何の車ですか?」「黒いスポーツ用多目的車(SUV)です……」。
- 詳細な説明:あらかじめ用意した質問の一覧から、「この画像を詳しく説明してください」のような質問を一つランダムに選び、完全な説明を書かせる。たとえば「ここは地下駐車場で、黒い SUV が一台停まっています。画面には三人の人物がいて……一緒に SUV に荷物を積み込み、出かける準備をしています。」
- 複雑な推論:一歩ずつ推論する必要がある問題。たとえば「この人たちはどんな困難に直面していますか?」に対する答えは「周りにスーツケースやバックパックがいくつもあり、全部をこの SUV に詰め込むのは簡単ではありません……」。
どの種類も、まず著者らがいくつか例を手書きし、GPT-4 への少数ショットのプロンプトにする。これがデータ収集全体で唯一の人手によるアノテーションだ。最終的に 158K 件が得られた。内訳は対話 58K、詳細な説明 23K、複雑な推論 77K。著者らは初期の実験で ChatGPT と GPT-4 を比べており、GPT-4 が生成したデータのほうが一貫して良く、空間的な推論では特にはっきりしていた。
先生は画像を見られず、画像の文字による説明を読んだだけなのに、生徒は本当に画像を見て答えなければならない。この点には後でまた戻ってくる。
アーキテクチャ:線形射影一層
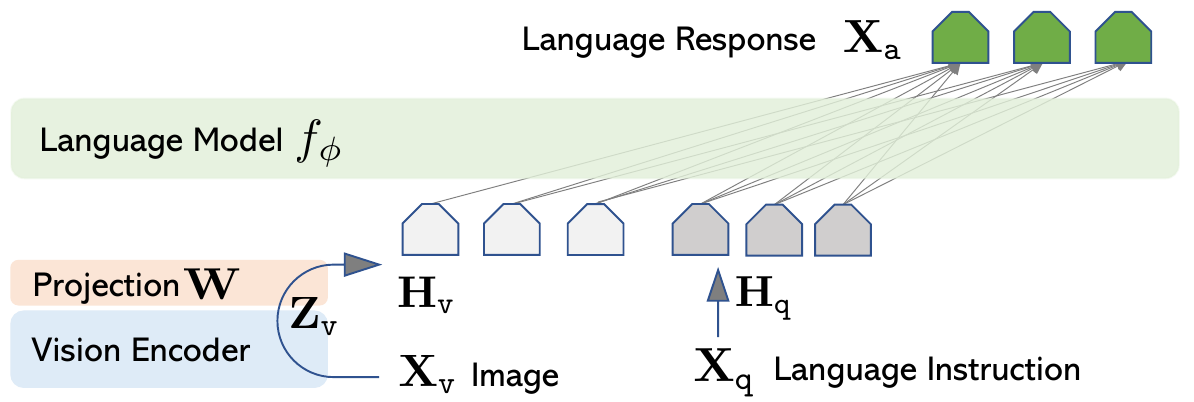
アーキテクチャはとても単純で、部品は三つだ。
- 視覚エンコーダ:事前学習済みの CLIP ViT-L/14。画像を小さなパッチに切り分け、パッチごとに特徴ベクトル を一つ出力する。著者らが使うのは、最後の Transformer 層の一つ前の層の特徴だ。
- 射影行列 :線形層一つで、画像の各特徴を言語モデルの単語埋め込みと同じ次元に変換する。。
- 言語モデル:Vicuna。ShareGPT でユーザーが共有した ChatGPT との対話で LLaMA を微調整したチャットモデルだ。著者らがこれを選んだのは、当時の公開重みの中で最も指示どおりに答えられたからだ。
変換が済めば、画像の特徴はテキストの単語埋め込みと同じ形になり、そのままつなげて言語モデルに入れられる。224×224 の画像なら、CLIP ViT-L/14 が 14×14 ピクセルごとにパッチを切り、1024 次元の特徴が 256 個できる。射影行列がこれを 5120 次元の視覚 token 256 個に変え、パラメータはバイアス込みで約 525 万だ。この 256 個の token は指示テキストの token の前につながる。言語モデルにとって、これらは意味が少し変わった「単語」の列にすぎない。
両者をつなぐのは、この 525 万パラメータの線形層だけだ。著者らは、Flamingo のゲート付きクロスアテンションや BLIP-2 の Q-Former のような、もっと複雑なつなぎ方もありうると述べているが、単純な射影ならデータまわりの実験を素早く回せるので、ひとまずこれを使った。
訓練:二段階
画像一枚ごとの複数ターンの対話を、一本の系列にまとめる。最初のターンでは画像を質問の前に置くか後ろに置くかをランダムに決め、以降のターンには質問だけを置く。損失はアシスタントの回答だけで計算し、どこで止まるべきかを示す <STOP>(実装上は ###)も含める。
第一段階:特徴のアラインメント。 CC3M から画像とテキストのペア 59.5 万組を選び出し、先ほどの簡単な書き換え方で一ターンの対話にする。視覚エンコーダも言語モデルも凍結し、射影行列 だけを訓練する。著者らに言わせれば、この段階は、凍結した言語モデルのために互換性のある「視覚トークナイザ」を訓練するようなものだ。A100 8 枚で 1 エポック回し、4 時間以内に終わる。
第二段階:エンドツーエンドの微調整。 視覚エンコーダは凍結したまま、射影層と言語モデルを一緒に訓練する。チャット版は先ほどの 158K の指示データで 3 エポック訓練し、約 10 時間かかる。ほかに ScienceQA 版も訓練し、質問と文脈を指示、推論過程と答えを回答とする。
議論
アイロンをかける男
著者らはまず、GPT-4 の報告にあったあの画像で試し、「この画像のどこが変わっているか?」と尋ねた。
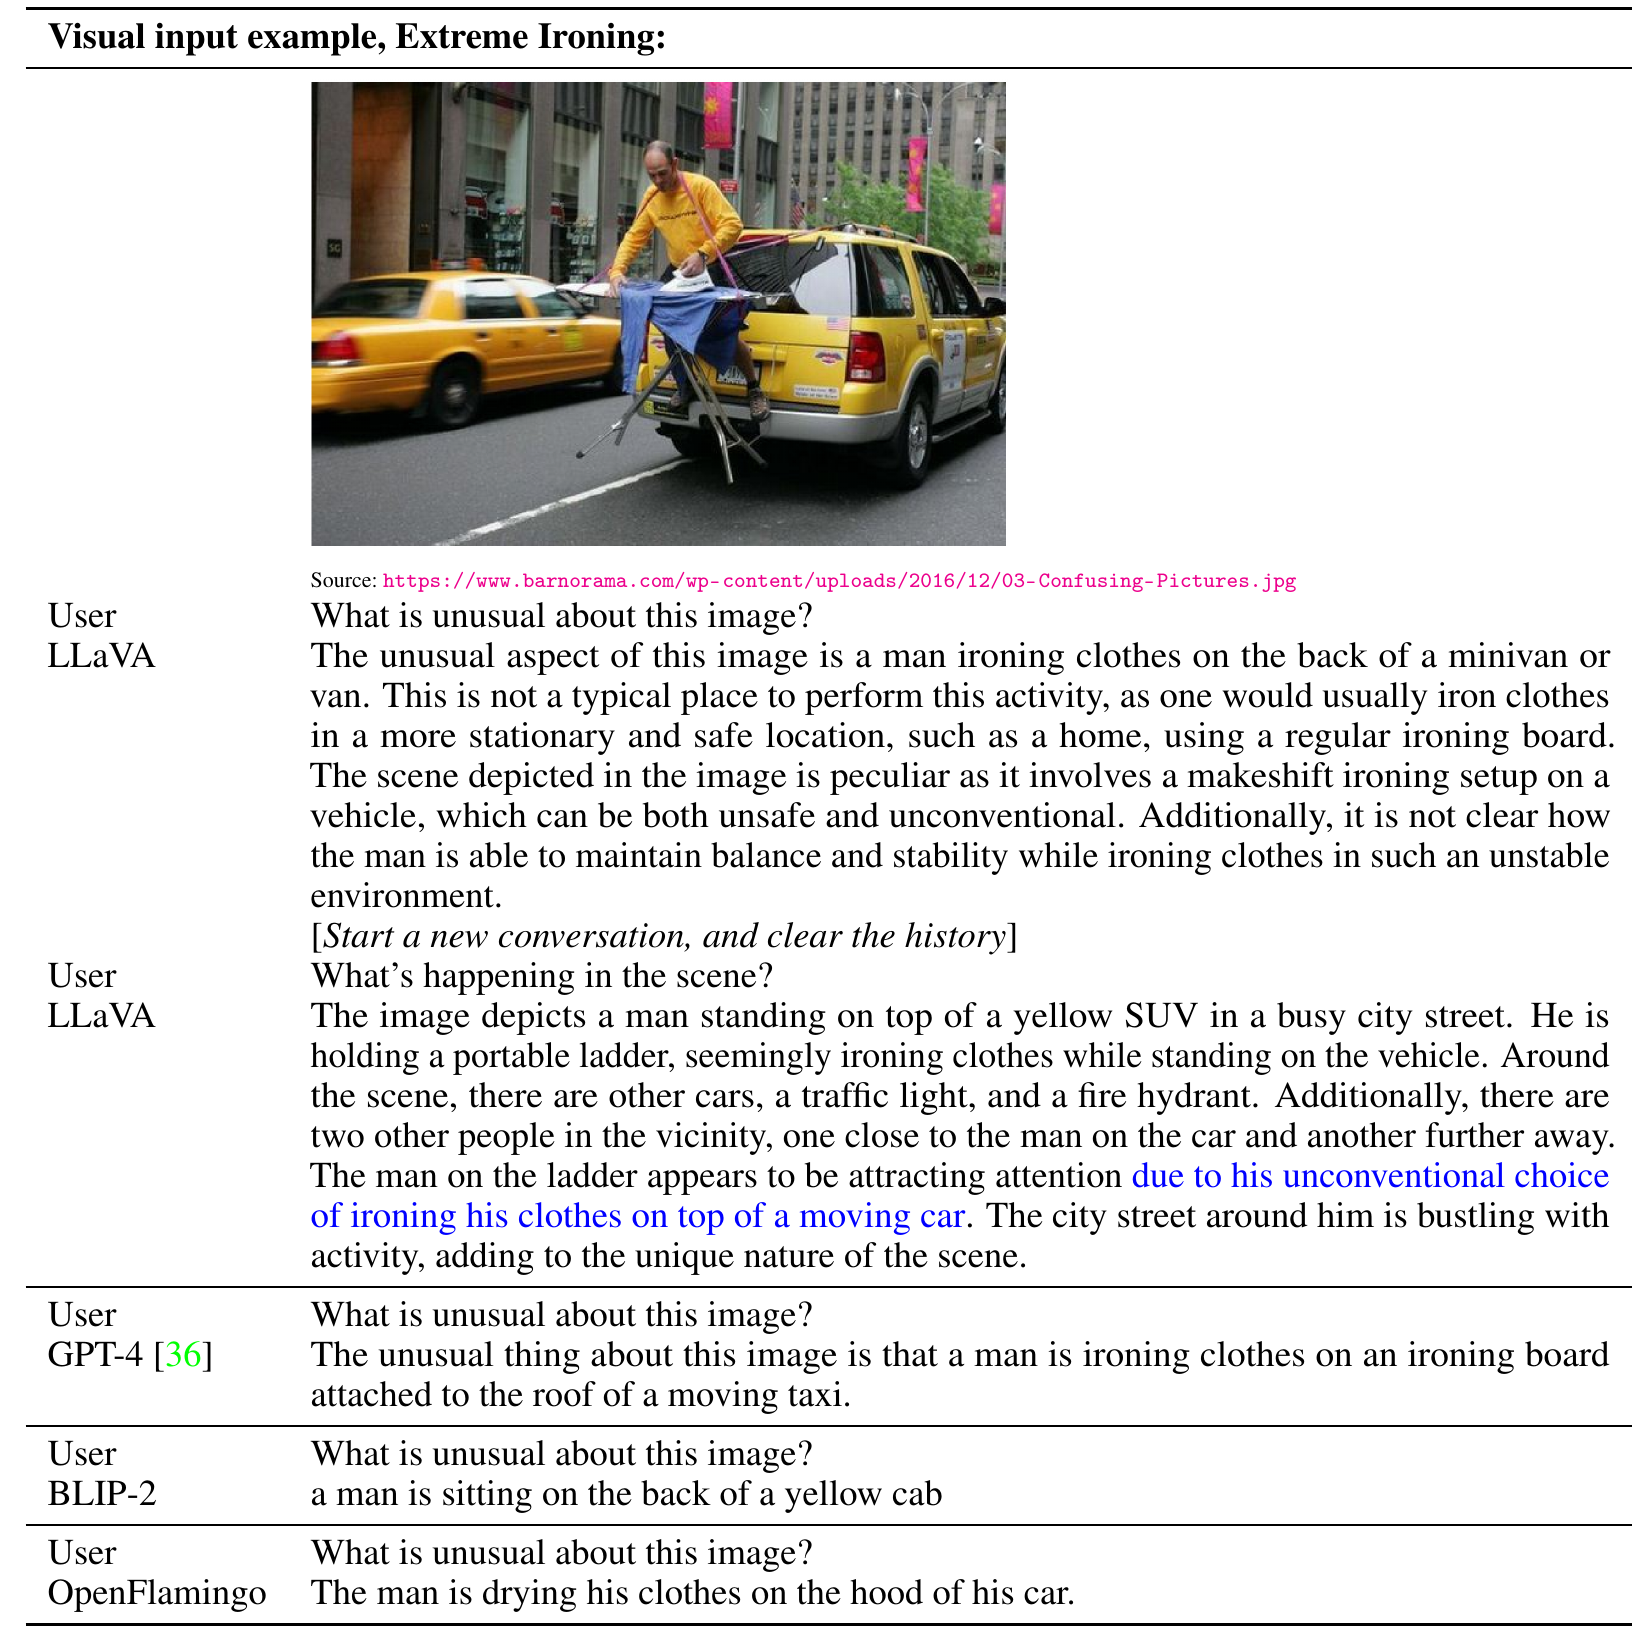
各モデルの回答を抜粋すると、次のとおり。
- LLaVA:変わっているのは、男性が小型のバンの後ろでアイロンをかけていることだ。普通は家でアイロン台を使ってかける……こんな不安定な場所でどうやってバランスを取っているのかもわからない。
- GPT-4:この画像の変わった点は、男性が走行中のタクシーの屋根の上で、固定されたアイロン台を使ってアイロンをかけていることだ。
- BLIP-2:男性が黄色いタクシーの後ろに座っている。
- OpenFlamingo:男性が自分の車のボンネットの上で服を干している。
BLIP-2 と OpenFlamingo はどちらも画面を説明しているだけで、その説明もあまり正しくない。LLaVA は質問に答えており、GPT-4 と同じ要点をつかんでいる。
著者らは別に新しい対話を始め、「画面で何が起きているか」とだけ尋ねた。LLaVA は街の様子を説明し終えたあと、この男性が走っている車の屋根の上でアイロンをかけているので人目を引いている、と自分から触れた。訓練データの画像は重複なしで約 8 万枚しかなく、この画像もその中には含まれていない。
GPT-4 を審査員にする
いくつかの例を見るだけでは足りないので、著者らは定量的な評価も設計した。LLaVA には画像を見て答えさせ、同時にテキストしか受け付けない GPT-4 には正解の文字による説明を読ませて答えさせ、これをおおよその上限とする。そのうえで、質問、文字による説明、二つの答えを GPT-4 に渡して採点させ、有用さ、関連性、正確さ、詳しさの四つの観点から 1 から 10 点をつける。報告される「相対スコア」は、LLaVA のスコアを GPT-4 のスコアで割ったものだ。
一つ目の評価セットは COCO の検証セットから 30 枚の画像を取り、各画像について同じ方法で三種類の問題を出したもので、合計 90 問。訓練データを変えて比べると次のようになる。
| 訓練データ | 対話 | 詳細な説明 | 複雑な推論 | 全体 |
|---|---|---|---|---|
| 全データ | 83.1 | 75.3 | 96.5 | 85.1 |
| 詳細な説明 + 複雑な推論 | 81.5 | 73.3 | 90.8 | 81.9 |
| 対話 + 5% 詳細な説明 + 10% 複雑な推論 | 81.0 | 68.4 | 91.5 | 80.5 |
| 対話のみ | 76.5 | 59.8 | 84.9 | 73.8 |
| 指示チューニングなし | 22.0 | 24.0 | 18.5 | 21.5 |
原論文 Table 4 をもとに整理。
指示チューニングをしていないモデルは 21.5 しかなく、微調整すると 70 を超え、差は 50 点以上ある。対話データだけだと 73.8 で、詳細な説明と複雑な推論を少し加えると 80.5 に上がり、しかも対話の問題のスコアまで一緒に上がる。三種類のデータをすべて使うのが最も良く、85.1 だ。
二つ目の評価セットはもっと難しく、24 枚の画像に 60 問。屋内外の場面、ミーム、絵画、スケッチなどを含み、各画像には人手で書いたごく詳細な説明がついている。
| モデル | 対話 | 詳細な説明 | 複雑な推論 | 全体 |
|---|---|---|---|---|
| OpenFlamingo | 19.3 | 19.0 | 19.1 | 19.1 |
| BLIP-2 | 54.6 | 29.1 | 32.9 | 38.1 |
| LLaVA | 57.3 | 52.5 | 81.7 | 67.3 |
原論文 Table 5 をもとに整理(三回の推論の平均)。
LLaVA は全体で 67.3 と、BLIP-2 より 29 点、OpenFlamingo より 48 点高い。
この二つの評価は、審査員も参照解答も GPT-4 なので、スコアはモデル同士の相対的な高低を比べるのにしか向かない。
よく見えていないところ
著者らは、LLaVA がうまく答えられない例も二つ選んでいる。
- 一蘭のラーメン:「これはどこの店か?」と聞かれて正しく答えるには、この店を見分けられ、しかも日本語が読めなければならない。付け合わせについて聞かれたら、ネットで調べる必要もありそうだ。
- 開いた冷蔵庫:「ブルーベリー味のヨーグルトはどこのブランドか?」と聞かれて Fage のロゴを読み取るには、高解像度の画像と十分な知識が必要だ。
いちばん面白いのは三つ目の質問だ。冷蔵庫にはヨーグルトもあり、イチゴも一パックあるが、イチゴ味のヨーグルトはない。「冷蔵庫にイチゴ味のヨーグルトはあるか?」と聞くと、LLaVA は「ある」と答えた。著者らの表現では、LLaVA はときどき画像を「小さなパッチをひと袋に詰めたもの」として扱い、ヨーグルトも見えたし、イチゴも見えたのに、両者の関係をつかめていない。
これは、先生が画像を見ずに教えるという訓練のやり方と切り離せない。GPT-4 が書いた答えがどれほど良くても、根拠はキャプションとバウンディングボックスだけだ。画像にはあっても説明に書かれていない細部を、生徒は学ぶ機会がない。
ScienceQA
ScienceQA は 21,000 問の科学の選択問題で、自然科学、社会科学、言語科学にわたり、図つきの問題もあれば文字だけの問題もある。LLaVA は推論過程を書いてから答えを書く形で 12 エポック訓練し、正解率は 90.92% と、当時の最高の 91.68% に迫った。
テキストしか受け付けない GPT-4 は、例二つの少数ショットのプロンプトで 82.69% を取れる。失敗した問題の多くは、「画像や図がない」と答えたせいだ。著者らは二通りの組み合わせを試した。
- GPT-4 が穴埋め:GPT-4 が答えられないときは LLaVA の答えを使う。90.97% で、LLaVA 単独とほぼ同じ。
- GPT-4 が審判:両者の答えが食い違うときは、問題と二つの答えをもう一度 GPT-4 に渡し、最終的な答えを出させる。92.53% で、当時の最高成績を更新した。
画像を見られない GPT-4 が、図つきの問題でさえ役に立つ。著者らの説明では、図つきの問題の中には実は図を見なくても答えられるものがあり、GPT-4 はそうした問題を見分けて、LLaVA の誤りの一部を正せる。
ScienceQA でのアブレーションをいくつか挙げる。
- CLIP の最後の層の特徴を使うと 89.96% で、最後から二番目の層より 0.96 低い。著者らは、最後の層は画像全体の抽象的な性質に寄っていて、最後から二番目の層のほうが局所的な細部を多く残しているのだろうと推測している。
- 推論と答えのどちらを先に書くかの比較には、最後の層の特徴が使われている。答えを先に書いて 12 エポック訓練すると 89.77%。推論を先に書くと、6 エポックで同じ 89.77% に達するが、その後はほとんど伸びない。著者らの結論は、推論を先にすると収束は速くなるが、最終的な成績への寄与は小さい、というものだ。
- 第一段階の特徴のアラインメントを飛ばして直接訓練すると、85.81% に落ちる。
- モデルを 13B から 7B に替えると、89.84% に落ちる。
その後
半年後、同じ著者グループが LLaVA-1.5 を発表した。変更点は多くない。画像の解像度を 336 ピクセルに上げ、線形射影を MLP に替え、さらに学術系の視覚的質問応答データを加えて、簡単な回答形式のプロンプトを添えた。13B 版は公開データ 120 万件だけを使い、A100 8 枚のマシン一台で約一日あれば訓練でき、11 個の評価で当時の最高成績を出した。
「視覚エンコーダ+射影層+言語モデル」という骨組みは扱いやすく、その後の多くのオープンソースのマルチモーダルモデルが受け継いだ。GPT-4 を審査員にして採点するやり方も、その後のモデル評価でますますよく見かけるようになった。
結論
指示データは、人が書かなくてもいい。マルチモーダルのものでさえそうだ。LLaVA は画像を文字に翻訳して GPT-4 に出題させ、158K 件のデータを得た。それから線形射影一層で CLIP を Vicuna につなぎ、二段階の訓練を合わせても A100 8 枚で半日あまりで終わる。それでいて画像を見ながら話す能力は、すでに GPT-4 の報告にあった例と比べられるほどになった。
この論文の訓練の順序は、そのまま真似する価値がある。まず両端を凍結して射影層だけを訓練し、画像の特徴を言語モデルの単語埋め込みに合わせる。それから言語モデルの凍結を解いて指示チューニングを行う。最初のステップを飛ばすと、ScienceQA で 5 ポイント下がる。
冷蔵庫にイチゴ味のヨーグルトは本当にあるのか? LLaVA は自信たっぷりに「ある」と言う。たぶん先生が教えてくれたのは、「冷蔵庫にはヨーグルトがあって、イチゴもある」ということだけだったのだろう。