原論文
Samba: Synchronized Set-of-Sequences Modeling for Multiple Object Tracking
- 発表先
- ICLR 2025国際会議
- arXiv への初回投稿
- arXiv:2410.01806
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingsamba2024,
  title = {{Samba: Synchronized Set-of-Sequences Modeling for Multiple Object Tracking}},
  author = {Mattia Segu and Luigi Piccinelli and Siyuan Li and Yung-Hsu Yang and Bernt Schiele and Luc Van Gool},
  year = {2024},
  eprint = {2410.01806},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2410.01806}
}
群舞を見ていると、ダンサーがてんでばらばらに踊ることはめったにないと気づく。隊形が左に動けば全員が一緒に左へ動き、一人がしゃがめば、隣の人が同時に跳び上がるかもしれない。鳥の群れが向きを変えるのも、選手がポジションを取るのも、同じ理屈だ。
これは追跡にとってとても役に立つ手がかりだ。あるダンサーが隠れてしまうと、いまどこにいるのかはわからないが、ほかのダンサーの動きを見れば、だいたいの見当はつく。
ところが、ほとんどのトラッカーは軌跡を一本ずつ別々に扱う。カルマンフィルタは軌跡一本につき一つ。MOTR のようなクエリで追跡する手法でも、各クエリは自分の前のフレームの情報だけを持って次へ受け渡される。ETH チューリッヒの Mattia Segu、Luc Van Gool らは、「各軌跡の長期の履歴」と「軌跡同士の関係」を同時に見られるモデルを作ろうとし、それを Samba と名づけた。Synchronized Mamba の略であり、息のそろった動きが身上のあのサンバでもある。
問題の定義
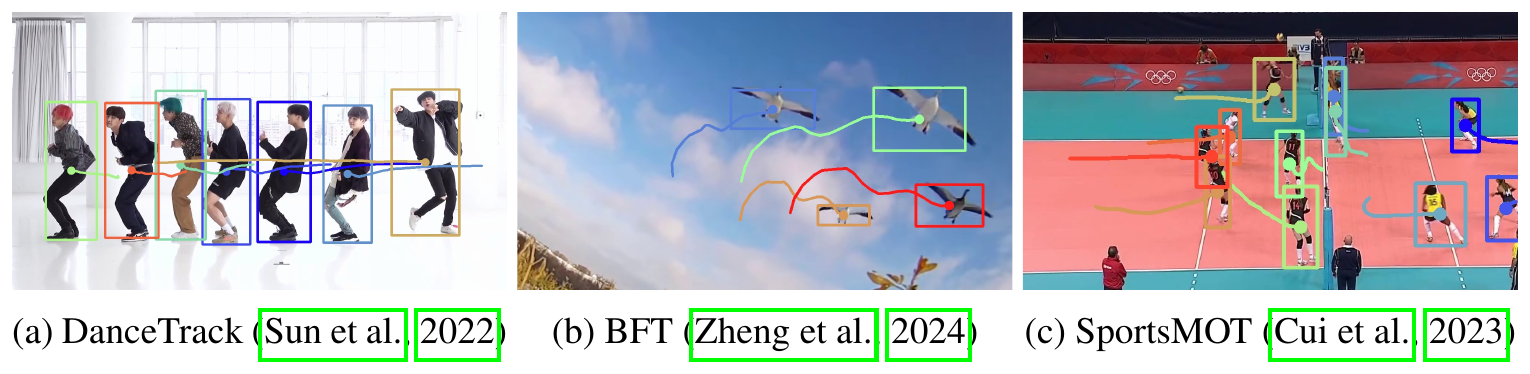
著者らが焦点を当てたのは「クエリで追跡する」路線、つまり TrackFormer や MOTR の系列だ。これらの手法は、各フレームで一組のトラッククエリを使い、前のフレームで追っていた人を画面の中で見つけ直し、そのクエリを次のフレームへ渡す。
この路線には三つの問題がある。
- 前のフレームしか見ない。 クエリはこのフレームから次のフレームへ渡されるだけで、それより前の履歴はうまく活かされていない。MeMOTR は長期記憶を加えたが、指数移動平均を使っているので、細部は平均されて消えてしまう。
- それぞれが勝手に追う。 各クエリは独立に受け渡され、ダンサー同士や鳥同士の協調関係はまったく使われていない。
- 遮蔽のときは凍結するしかない。 物体が隠れて検出の信頼度が低いとき、MeMOTR と MOTRv2 はクエリを凍結し、最後に見えたときの状態のまま、再び現れるのを待つ。長く隠れているほど、凍結した状態は本当の位置から離れていく。
問題を解く
全体のアーキテクチャ
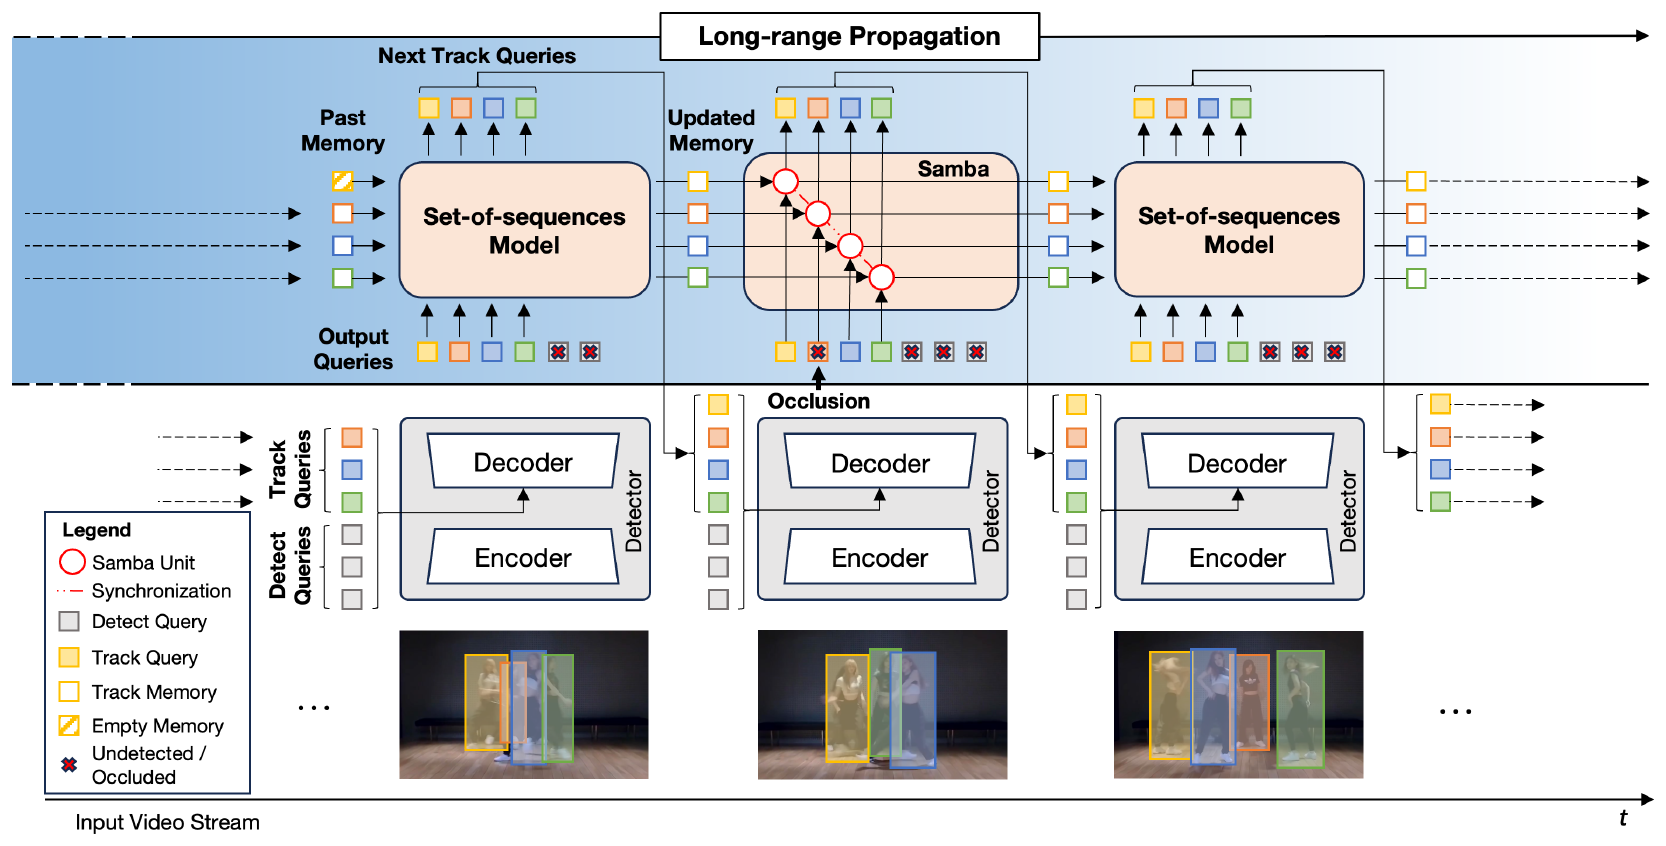
SambaMOTR の検出器は標準的な Deformable-DETR で、MOTR と同じだ。変えたのは「このフレームのクエリを次のフレームへどう渡すか」だ。
MOTR は小さなモジュールで、このフレームの出力をそのまま次のフレームのクエリに変換する。SambaMOTR はこれを Samba に置き換える。各軌跡が一つの系列で、Samba は状態空間モデルを使って、その軌跡が生まれてからいままでのすべての出力を一つの隠れ状態に圧縮し、隠れ状態から次のフレームのクエリを予測する。
Samba に送る前に、デコーダの出力にはボックス座標の位置エンコーディングも足され、モデルが外観と位置を同時に見られるようにする。Samba が出力するのは完全な新しいクエリではなく残差で、それをもとのクエリに足す。
同期した状態空間モデル
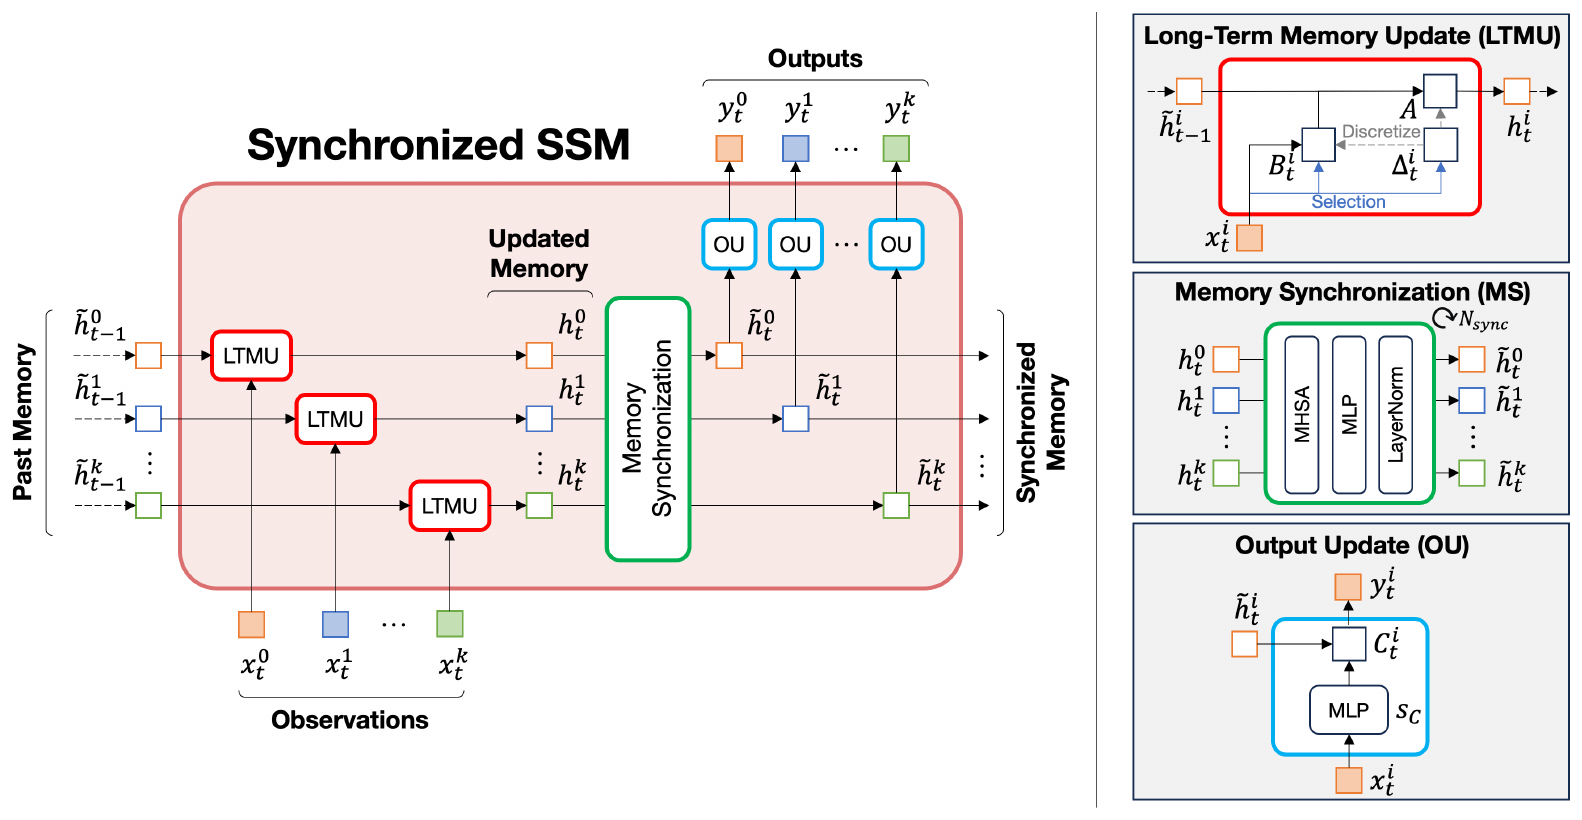
Samba の核心は「同期」だ。ふつうの Mamba では、各系列の隠れ状態は自分の入力だけで更新される。Samba は各ステップに同期を一つ追加する。
一行目は Mamba のもとの更新で、各軌跡が自分のこのフレームの観測で記憶を更新する。二行目が同期で、すべての軌跡の更新後の記憶を一緒にして、自己アテンションを何層か通し、互いに情報をやりとりさせる。三行目は同期後の記憶から出力を生成する。
自己アテンションには、ここでちょうど必要な二つの性質がある。軌跡が何本あっても扱えることと、軌跡の並び順に依存しないことだ。代償として計算量は軌跡の本数の二乗に比例する。ただし時間の長さに対しては線形のままなので、軌跡がどれだけ長くなっても追い続けられる。
MaskObs:信用できない観測は受け取らない
物体が隠れているときも、デコーダはクエリを出力するが、そのクエリはたいてい当てにならず、手前で隠している人を捉えてしまっているかもしれない。それをそのまま記憶の更新に使うと、誤りがどんどん積み重なる。
MaskObs は、検出の信頼度が 0.5 未満の観測を記憶の更新に入れない。
凍結と違うのは、記憶とクエリがそれでも毎フレーム先へ更新されていくことだ。ただしこのときの更新は、その軌跡自身の履歴と、同期の際にほかの見えている軌跡から得た情報だけに頼る。
この式を一次元に簡略化し、、 を 0.6 と 0.4 に固定して、違いを見てみよう。あるダンサー A の記憶が 1.0 だとする。このフレームで A は B に隠れ、デコーダの出力は実際には B に近く、値は 、信頼度は 0.3 しかない。次のフレームで A が再び現れ、観測は 1.0、信頼度は 0.9 だ。
| やり方 | 遮蔽されたフレーム | A が再び現れたあと |
|---|---|---|
| そのまま受け取る | ||
| MaskObs |
本稿で整理した計算例。実際のモデルでは 、 は入力に応じて変わり、記憶は高次元ベクトルだ。
そのまま受け取ると、B の情報が A の記憶に混ざり、A が戻ってきても回復するまで何フレームもかかる。マスクすれば、A の記憶の大部分は守られる。
長いクリップで訓練する
MOTR 系列は訓練のとき、毎回 5 フレームを取り、5 フレームすべてで勾配を計算する。5 フレームしか見ないのでは長期記憶は学べないし、クリップをそのまま長くするとメモリ使用量もそれにつれて増える。
著者らのやり方は、10 フレームのクリップを取り、前の 5 フレームは順伝播だけで勾配を計算せず、後ろの 5 フレームだけで逆伝播する、というものだ。こうすればメモリ使用量はほぼ同じなのに、モデルはより長い履歴の使い方を学べる。
議論
各設計の寄与
| 設定 | HOTA | AssA | IDF1 |
|---|---|---|---|
| MOTR | 54.2 | 40.2 | 51.5 |
| MeMOTR | 63.4 | 52.3 | 65.5 |
| 状態空間モデルに置き換え | 63.5 | 53.8 | 67.0 |
| +MaskObs | 64.8 | 54.3 | 68.1 |
| +同期 | 65.9 | 55.6 | 68.7 |
| +長いクリップで訓練 | 67.2 | 57.5 | 70.5 |
原論文 Table 4 をもとに整理。DanceTrack テストセット。
受け渡しモジュールを素の Mamba に替えるだけで、もう MeMOTR と互角になり、AssA はさらに 1.5 高い。そこから設計を一つ加えるごとに HOTA は 1 ポイント以上ずつ伸び、合計で MeMOTR より 3.8 高くなる。
付録にはもっと細かいアブレーションがいくつかある。
- 同期をどこに置くか。 このフレームの観測を加える前に同期すると HOTA 66.1 で、同期しない場合の 66.0 とほぼ同じだ。更新したあとに同期すると 67.2 になる。著者らの説明では、更新後に同期してはじめて、遮蔽された軌跡がほかの軌跡のこのフレームの情報で自分の欠けた部分を補える。
- 最も難しい六本の動画。 同期なしで成績が最も悪かった DanceTrack の動画を六本選ぶと、同期を加えることで平均 HOTA は 40.9 から 44.5 に、AssA は 25.1 から 28.3 に上がった。場面が乱れているほど、同期は役に立つ。
- 凍結か MaskObs か。 MeMOTR のように遮蔽時に凍結するやり方に替えると、HOTA は 67.2 から 65.9 に落ちる。
- 残差を予測するか、完全なクエリを予測するか。 次のフレームの完全なクエリを直接予測すると HOTA は 64.2 しかなく、残差を予測すると 67.2 になる。
三つのデータセット
| データセット | 表内で最強の相手 | 相手 HOTA | SambaMOTR HOTA | AssA の差 |
|---|---|---|---|---|
| DanceTrack | MeMOTR | 63.4 | 67.2 | +5.2 |
| BFT | OC-SORT | 66.8 | 69.6 | +4.9 |
| SportsMOT | TransTrack | 68.9 | 69.8 | +1.9 |
DanceTrack は原論文 Table 1、BFT は原論文 Table 2、SportsMOT は原論文 Table 3 をもとに整理。いずれも追加の訓練データは使っていない。
三つのデータセットすべてで一位で、しかも検出器は ResNet-50 の Deformable-DETR にすぎず、検出してから追跡する手法がよく使う YOLOX-X ではない。DanceTrack では、YOLOX-X を使う C-BIoU の DetA は 81.3 で SambaMOTR の 78.8 より高いが、AssA は 45.4 しかなく、SambaMOTR より 12 ポイント以上低い。
鳥の群れの BFT は、同期の価値をよく表している。鳥はほとんど見分けがつかないほど似ていて、外観では誰が誰だかわからないが、群れで一緒に向きを変える。SambaMOTR の AssA は 73.6 で、それまで最良だったクエリ型トラッカー TrackFormer より 12.5 高い。
MOT17 とほかの限界
付録では MOT17 の結果も報告している。SambaMOTR の HOTA は 58.8 で、MeMOTR と同じく、ByteTrack の 63.1 を大きく下回る。著者らは、MOT17 の歩行者はほとんどがまっすぐ歩いていて、訓練動画も 7 本しかないので、エンドツーエンドの手法はここでは有利にならないと考えている。
著者ら自身は二つの限界を挙げている。第一に、軌跡は一定のフレーム数を超えて非アクティブなままだと捨てられる。サッカー選手はよく何秒も画面の外に走り出ていき、戻ってきたときには新しい ID になっているので、長期の再識別を別につなぐ必要がある。第二に、同期には自己アテンションを使うので、計算量は軌跡の本数の二乗で増え、人が多いと遅くなる。推論速度は RTX 4090 一枚で 16 FPS だ。
結論
SambaMOTR は、クエリで追跡する手法に二つのものを加えた。一つは長期記憶だ。各軌跡は状態空間モデルで履歴全体を隠れ状態に圧縮し、しかも計算量は時間に対して線形だ。もう一つは同期だ。各ステップですべての軌跡の記憶に情報をやりとりさせ、ある軌跡が隠れたときに、ほかの軌跡の動きを参考にできる。
MaskObs は遮蔽時の扱いを、「凍結」から「怪しい観測は受け取らず、それでも推し進める」に変えた。この三つに長いクリップでの訓練を加えて、群舞、鳥の群れ、球技のどれでも従来の手法を上回った。
著者陣は MASA と大きく重なっている。MASA は動画をまったく使わずに外観の関連付けを学び、SambaMOTR は動画の中で時間と集団の関係を学ぶ。二本はちょうど両端から関連付けという問題に取り組んでいる。