原論文
MambaMOT: State-Space Model as Motion Predictor for Multi-Object Tracking
- 発表先
- ICASSP 2025国際会議
- arXiv への初回投稿
- arXiv:2403.10826
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingmambamot2024,
  title = {{MambaMOT: State-Space Model as Motion Predictor for Multi-Object Tracking}},
  author = {Hsiang-Wei Huang and Cheng-Yen Yang and Wenhao Chai and Zhongyu Jiang and Jenq-Neng Hwang},
  year = {2024},
  eprint = {2403.10826},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2403.10826}
}
2023 年末、Mamba は「選択的状態空間モデル」として登場し、長い系列で Transformer と互角に渡り合いながら、計算量は系列長に対して線形にしか増えなかった。それから数か月のあいだに、あらゆる分野でこれを持ち込もうとする人が現れた。
複数物体追跡で系列モデルを置くのに最も向いた場所は、運動予測だ。ある軌跡の過去数フレームのボックスが与えられたとき、次のフレームのボックスを予測する。これはもともと系列の問題で、SORT 以来ずっとカルマンフィルタが担ってきた。
ワシントン大学の Hsiang-Wei Huang、Jenq-Neng Hwang らがやったのは、まさにカルマンフィルタを Mamba に置き換えることだ。論文はわずか 4 ページで、発想もごく素直だが、二週間足らず前に出た DiffMOT と並べて見るのにちょうどいい。同じ問題に、一方は拡散モデル、もう一方は状態空間モデルで挑んでいる。
問題の定義
カルマンフィルタは、物体が短い時間なら等速で直進すると仮定する。歩行者はおおむねこの仮定に合うが、ダンサーや選手はそうはいかない。
OC-SORT は以前、こうした場面でのカルマンフィルタの二つの弱点を分析した。一つは状態のノイズに敏感なことだ。速度の推定が少しずれているだけで、物体が数フレーム検出されないと、予測位置は大きくずれてしまう。もう一つは誤差が時間とともに拡大することだ。新しい観測がないあいだ、カルマンフィルタは古い速度のままひたすら推し進めるしかない。
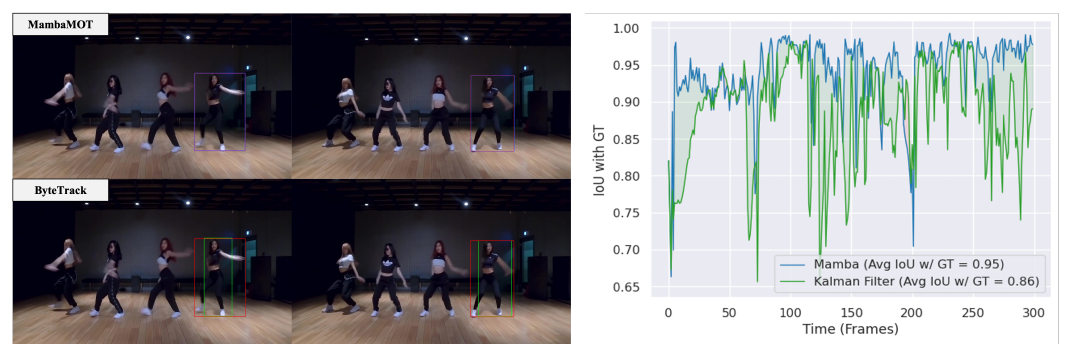
右の曲線は問題をよく表している。カルマンフィルタもたいていはうまく予測しているが、ダンサーが急に動きを変えるたびに緑線が下に落ち、何度か 0.75 を下回っている。IoU による関連付けにとって、こうした突然の外れこそ軌跡が途切れる瞬間だ。
著者らの考えは、運動を線形と仮定するより、ダンサーがふだんどう動くか、選手がふだんどう動くかをモデルにデータから学ばせたほうがいい、というものだ。
問題を解く
Mamba で次のボックスを予測する
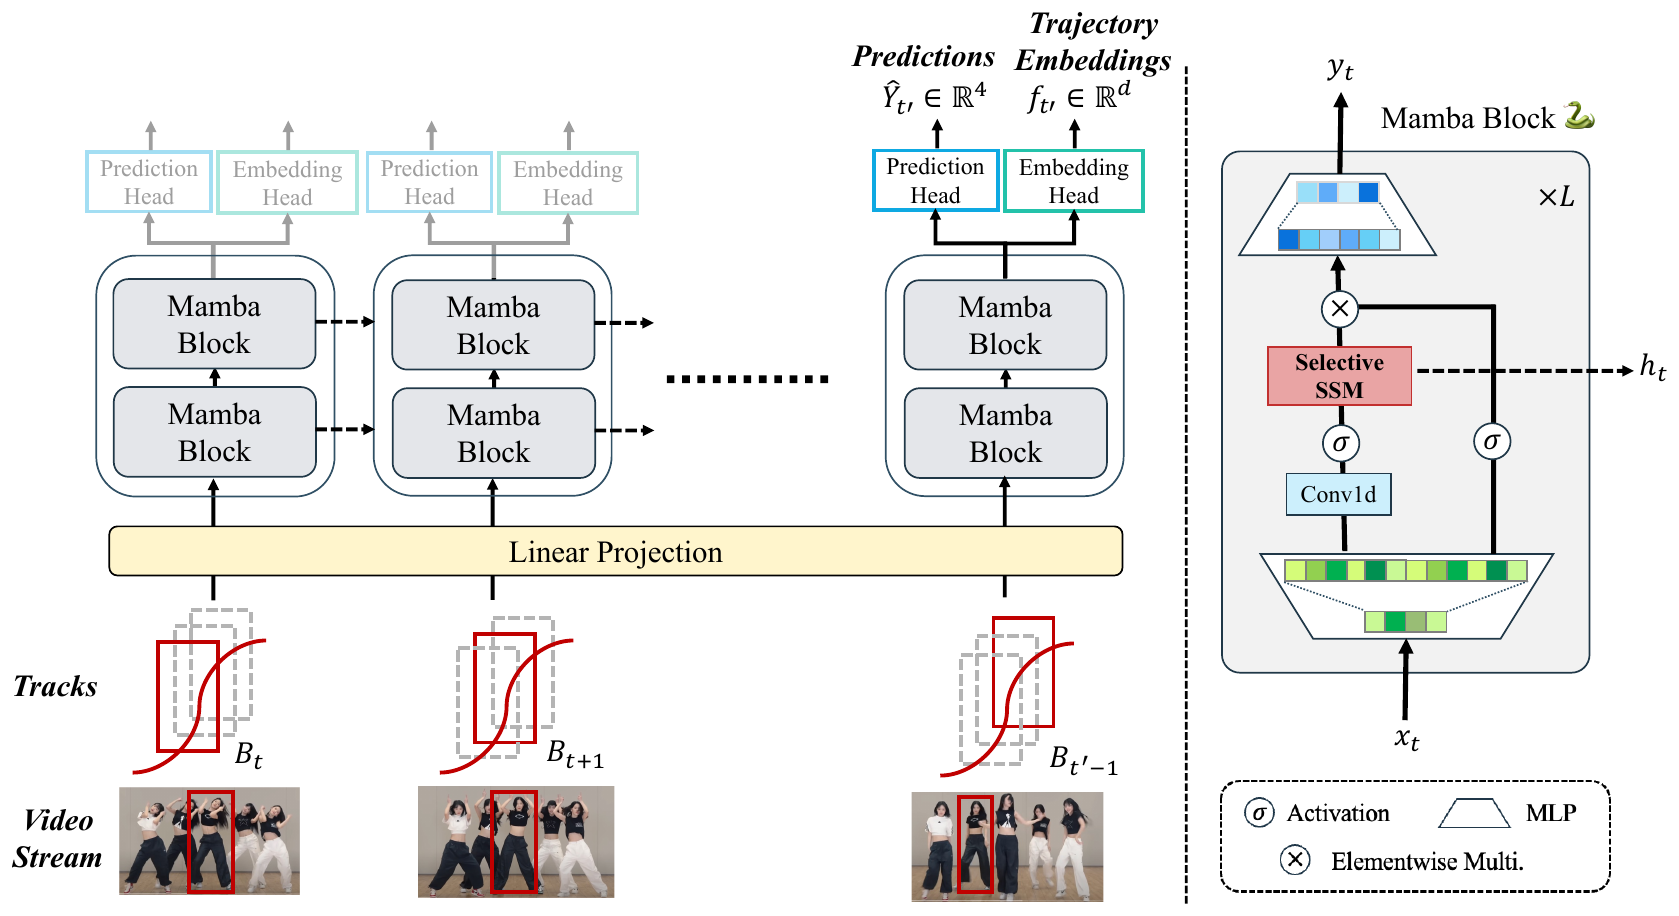
MambaMOT の運動モデルはとても小さい。入力はある軌跡の過去 フレームのボックスで、ボックス一つにつき四つの数字。まず一層の線形射影で 64 次元に上げ、二つの Mamba ブロックを通し、最後の MLP が次のフレームのボックスを出力する。訓練の損失は、予測ボックスと正解ボックスの GIoU に平均二乗誤差を足したものだ。
関連付けは ByteTrack をそのまま使う。高スコアのボックスをまず予測ボックスと IoU でマッチングし、残った軌跡を低スコアのボックスともう一度マッチングする。だから MambaMOT と ByteTrack の違いは、運動モデルという部品一つだけだ。
「選択的」とはどういうことか
Mamba の核心は一つの再帰式だ。
隠れ状態 は過去のすべての入力の要約で、新しい入力が来るたびに、古い要約をどれだけ残し、新しい入力をどれだけ取り込むかを決める。
従来の状態空間モデルでは 、 は固定で、毎ステップ残す量も取り込む量も同じだ。Mamba はこれらを入力に応じて変わるようにした。だから「選択的」と呼ばれる。論文ではこの二つの量を と と書いており、足し合わせるとちょうど 1 になる。
この式を一次元に簡略化すると、運動予測での意味が見えてくる。 とおくと、再帰式は次のようになる。
これは指数移動平均だ。ただし平滑化係数 は入力によって決まる。
振り向く例
入力を、ダンサーの各フレームの水平方向の速度に簡略化してみよう。直前の数フレーム、ダンサーはずっと右に向かっていて、1 フレームあたり 10 ピクセル、記憶の中は だ。このフレームで急に振り向き、速度は になる。
| やり方 | 平滑化係数 | 更新後の記憶 | 予測の向き |
|---|---|---|---|
| 固定係数 | 0.2 | 右のまま | |
| 選択的 | 0.8 | 左に変わる |
本稿で整理した計算例。実際のモデルの隠れ状態は高次元ベクトルで、出力はさらに MLP を通る。
係数が固定のモデルは、どの入力も同じように扱うので、古い傾向が新しい情報に塗り替えられるまで何フレームもかかる。選択的なモデルなら、こういう入力を見たら古い傾向は信用できない、新しい観測を大きく取り入れるべきだ、と学べる。
カルマンフィルタも実は観測に応じて調整するが、その調整幅はあらかじめ設定したノイズのパラメータで決まり、しかも背後にはいつも等速モデルがある。Mamba の調整のしかたは、データから学んだものだ。
MambaMOT+:ついでに軌跡の特徴も学ぶ
Mamba の隠れ状態が軌跡全体の運動パターンを覚えているのなら、それをさらに活用したい。著者らはそう考えた。MambaMOT+ は Mamba ブロックの出力に埋め込みヘッドを一つ追加し、この軌跡の特徴ベクトルを出力する。
この特徴の訓練にはコサイン埋め込み損失を使う。同じ軌跡から切り出した二つの区間は特徴が似るように、異なる軌跡の二つの区間は類似度が 0 を下回るように押し下げる。
追跡が終わったあと、すべての tracklet の特徴を総当たりで比べ、階層的クラスタリングで運動パターンの似たものをつなぐ。不合理な組み合わせをつながないよう、時間差が 50 フレームを超えるもの、空間的な距離が 50 ピクセルを超えるものはつながない。
著者らは、従来の tracklet の統合では別にシャムネットワークを訓練し、tracklet のペアごとに一回ずつ走らせる必要があるので計算量は になるが、MambaMOT+ は tracklet ごとに順伝播を一回走らせるだけで だと強調している。ただしクラスタリングでコサイン類似度を総当たりで比べるステップは依然として で、ベクトルの内積はネットワークを走らせるよりずっと安いというだけだ。
もう一点注意したいのは、この統合が動画全体を追跡し終えてから行われることだ。そのため MambaMOT+ はもはやオンライン手法ではない。
訓練データ
運動モデルの訓練データは、MOT17、DanceTrack、SportsMOT の訓練セットの軌跡から取る。毎回、長さが 2 から の区間をランダムに切り出し、 に満たないものはパディングで埋め、次のフレームの正解ボックスを目標にする。RTX 4080 一枚で 500 epoch 訓練する。
議論
DanceTrack と SportsMOT
| 手法 | HOTA | AssA | IDF1 |
|---|---|---|---|
| ByteTrack | 47.3 | 31.4 | 52.5 |
| OC-SORT | 54.6 | 40.2 | 54.6 |
| MambaMOT | 55.5 | 38.3 | 53.9 |
| MambaMOT+ | 56.1 | 39.0 | 54.9 |
原論文 Table I をもとに整理。DanceTrack テストセット。
同じ検出を使う ByteTrack と比べると、MambaMOT の HOTA は 8.2 高い。これが論文の主な売りだ。
ただ分解してみると、この 8.2 のうちかなりの部分は検出の側から来ている。ByteTrack の DetA は 71.6、MambaMOT は 80.8 で、AssA は 31.4 対 38.3 だ。運動モデルがおもに影響するのは関連付けなのに、同じ検出で DetA が 9 ポイント以上も違うのだから、表の中の両者は運動モデル以外の設定も違っている可能性がある。OC-SORT の DetA は 80.4 で MambaMOT に近く、これを比較対象にしたほうが公平だ。
OC-SORT と比べると、話は少し変わってくる。OC-SORT はカルマンフィルタに手を加えた手法で、MambaMOT の HOTA はそれより 0.9 高いだけ、AssA と IDF1 はむしろ低い。軌跡の統合を加えた MambaMOT+ で、ようやく IDF1 が 0.3 差で競り勝つ。
SportsMOT でも状況は似ている。同じ YOLOX 検出器を使って、MambaMOT の HOTA は 70.4、OC-SORT は 70.2 で、MambaMOT+ は 71.3 まで上がる。MambaMOT を ByteTrack の 62.0 と比べると、差は 8.4 だ。
足りないもの
この論文は短く、説明されていないことがいくつかある。
- アブレーションがない。 何フレーム入力するか、Mamba ブロックをいくつ使うか、GIoU 損失を外すとどうなるか、どれも実験がない。LSTM や Transformer に替えても同じくらい良いのかも、比べていない。
- 歩行者データセットの結果がない。 訓練データには MOT17 の軌跡が入っているのに、テストは DanceTrack と SportsMOT しか報告していない。
- データセットをまたぐ実験がない。 運動モデルは三つのデータセットの訓練軌跡で一緒に訓練され、そのうち二つのテストセットで評価されている。見たことのない種類の運動に移ったときにどうなるかは、論文では測っていない。
- 比較対象が不完全。 表の中で最強の相手は OC-SORT だ。同時期の DiffMOT は DanceTrack の HOTA が 62.3、Deep OC-SORT は 61.3 だが、どちらも載っていない。これらの手法は外観特徴も使っているので直接は比べられないが、この論文から Mamba そのものの立ち位置を判断するのは難しい。
DiffMOT のアブレーションが、側面からの参考になる。DiffMOT の枠組みの中では、同じ学習型の運動モデルでも、LSTM の HOTA は 51.2、Transformer は 54.6、拡散モデルは 55.7 で、カルマンフィルタは 46.8 だ。学習型の運動モデルは確かにカルマンフィルタより良いが、どの系列モデルを使うかでの差はずっと小さい。
速度
MambaMOT は GPU 一枚で 28.8 FPS で動く。著者らはこれを MOTR のようなエンドツーエンドの手法と比べていて、後者はたいてい 10 FPS に届かない。運動モデルは 64 次元の Mamba ブロック二つだけで、それ自体はとても軽い。
結論
MambaMOT は、カルマンフィルタを小さな Mamba に置き換えて、追跡が良くなるかどうかを確かめた。ダンサーや選手については答えは「良くなる」で、ByteTrack と比べて HOTA が一気に 8 ポイント以上伸びた。
選択的状態空間モデルの良さは、古い傾向と新しい観測のどちらを信じるかを入力に応じて決められることにあり、それこそ不規則な運動が最も必要とするものだ。ただ、OC-SORT のような改良型のカルマンフィルタ手法と比べると、優位はほんのわずかしか残らない。ほかの系列モデルよりこのタスクに向いているのかどうかについては、この論文は答えを出していない。