原論文
Beyond the Image Plane: World-Grounded Queries for Multi-Object Tracking
- 発表先
- 正式な発表先は未確認
- arXiv への初回投稿
- arXiv:2609.00924
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingplanet2026,
  title = {{Beyond the Image Plane: World-Grounded Queries for Multi-Object Tracking}},
  author = {Orcun Cetintas and Guillem Brasó and Tim Meinhardt and Laura Leal-Taixé},
  year = {2026},
  eprint = {2609.00924},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2609.00924}
}
カメラは立体の世界を平面の画面に写す。前後に立つ二人は画面上で重なり、カメラに向かって歩いてくる人は、画面上ではボックスが少し大きくなるだけだ。奥行きも、前後関係も、本当の移動方向も、投影のときに押しつぶされてしまう。
トラッカーに見えているのも、この平面だけだ。外観を比べるにしても、ボックスの重なりを比べるにしても、ボックスの移動を予測するにしても、すべて画像平面の上で行われ、こうしたあいまいさもまとめて受け継いでいる。
ここ一、二年で、VGGT や Depth Anything 3 のような幾何の基盤モデルは、ふつうの動画からシーン全体の立体構造とカメラパラメータを直接推定できるようになった。SUSHI、NOOUGAT の著者陣(Orcun Cetintas、Guillem Brasó、Tim Meinhardt、Laura Leal-Taixé)は、こうして推定した 3D の情報をトラッカーに入れたら、もっとはっきり見えるようになるのではないかと試してみた。
問題の定義
3D の情報を追跡に使うことは、実はずっと前から試されている。歩行者の見えている度合いを推定して遮蔽を推論するもの、軌跡を世界座標に変換するもの、3D の人体モデルを使うものがある。カルマンフィルタに奥行きの制約を加えたり、鳥瞰図の上で軌跡を予測したりする手法もある。
著者らによれば、こうしたやり方では 3D の情報が、特定のカテゴリに縛られている(たとえば歩行者にしか使えない)か、物体の表現ができあがったあとで、関連付けの段階に追加のルールやコストとして足されるかのどちらかだ。トラッカー内部の物体の表現は、依然として 2D のままだ。
もう一つの問題は時間だ。クエリで追跡するエンドツーエンドの手法は、訓練時にたいてい 2 から 10 フレームしか見ず、推論時に振り返れる範囲も限られている。PLANET が土台にしている MOTIP は過去 30 フレームを見られるが、ふつうの動画では一、二秒にすぎない。それより長く隠れている人は、記憶の外に出てしまう。
PLANET がやろうとするのは、クエリができあがる時点で 3D の情報を取り込み、しかもその情報をもっと長い時間範囲で使えるようにすることだ。
問題を解く
まずデータセットを 3D にする
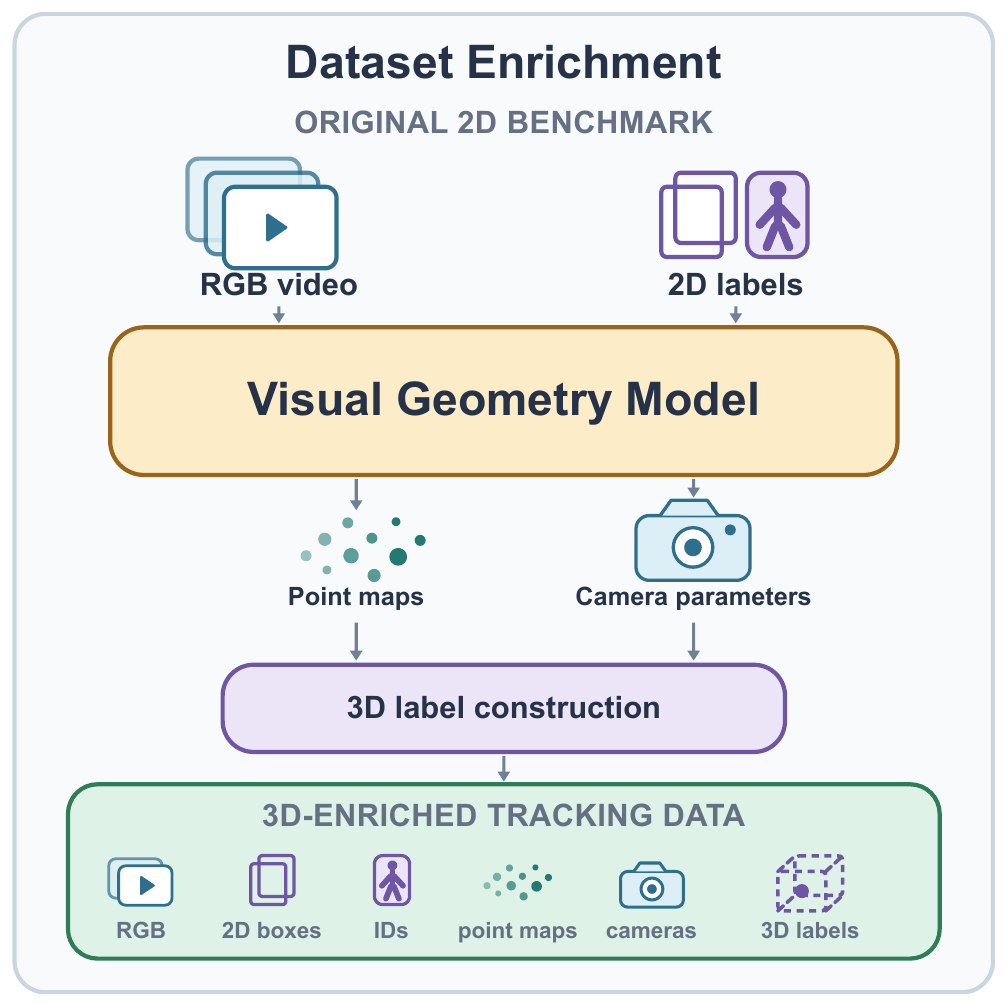
DanceTrack、SportsMOT、BFT といったデータセットには、2D のボックスしかない。最初のステップは、これらを 3D にすることだ。
著者らは Depth Anything 3 の長系列版で動画全体を処理する。互いに重なる時間窓で奥行きとカメラパラメータを推定し、ループクロージャで長時間にわたって蓄積するドリフトを抑える。推定した奥行きとカメラパラメータで逆投影すると、各フレームの各ピクセルが世界座標の一点に対応する。これを点群マップと呼ぶ。
点群マップはシーン全体のもので、どの点が誰に属するのかはまだわからない。著者らは、アノテーションされた 2D ボックスごとに、ボックス内の点群の平均位置を取り、それをその物体の 3D 中心とする。
- まったく隠れていないボックスは、そのまま採用する。
- 隠れているボックスは、中に前景と背景が混ざっているので、前後のフレームの奥行き、このフレームの奥行き、画面上のボックスの位置を総合して、どの部分がこの物体なのかを控えめに判断する。
- 同じ軌跡に沿って前後が一致しているかを確かめる。それでも確信が持てないものは無効とし、訓練には使わない。
こうした 3D 中心は位置だけで、物体の大きさや向きはなく、推定で得た「疑似ラベル」だ。
クエリができる時点で 3D を見せる
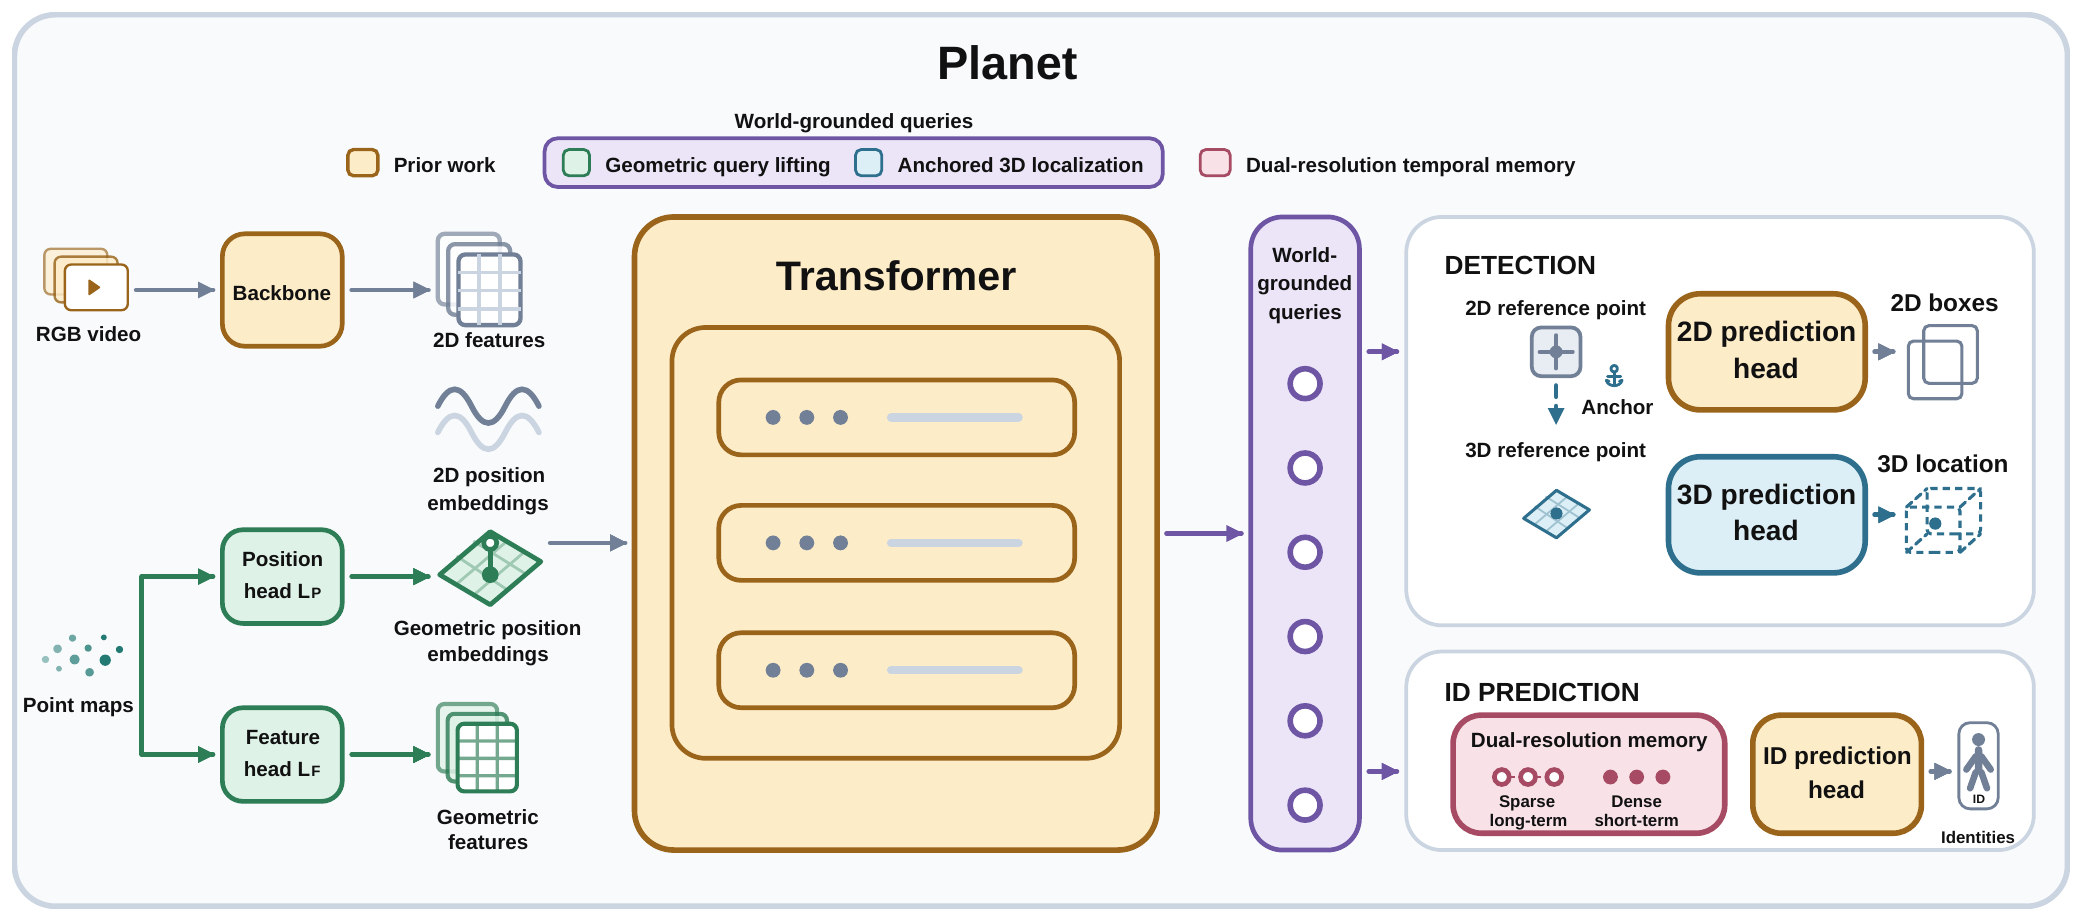
PLANET は MOTIP の上に作られている。MOTIP の特徴は、検出と身元の予測が同じ一組のクエリを共有することだ。各クエリはボックスを出力すると同時に、そのボックスがどの ID に属するかも予測する。だからクエリに 3D の情報を含ませれば、検出と関連付けの両方が恩恵を受ける。
著者らは二つのやり方で 3D をクエリに持ち込む。
幾何クエリリフティング。 点群マップを、学習可能な二つの小さなネットワークに通す。一つは幾何特徴を生成し、それをバックボーンの画像特徴に直接足す。もう一つは幾何の位置埋め込みを生成し、もとの 2D の位置エンコーディングと連結してから融合する。Transformer がクエリを更新するとき、見ている特徴にも位置にも、シーンの立体構造が含まれている。
アンカーつき 3D 位置推定。 Deformable DETR の各クエリには 2D の参照点があり、ボックスの予測を導くのに使われる。著者らはこの 2D 参照点を、点群マップを通して対応する 3D 参照点に持ち上げ、小さな 3D 予測ヘッドにクエリから残差を予測させて、物体の 3D 中心へと補正する。この予測は前に作った 3D 疑似ラベルで教師づけされる補助タスクだ。
補助タスクの目的は、物体が立体空間のどこにあるかを、クエリに自分で覚え込ませることだ。二人が画面上で重なっていても、一人が前、一人が後ろにいるなら、それぞれのクエリは異なる 3D 位置を持っているべきだ。
なぜ、独立した 3D 参照点を別に学ぶのではなく、2D 参照点に「アンカー」するのか? バックボーンと検出器は、すでに大量の 2D データでよい位置推定の能力を身につけているからだ。2D 参照点から出発すれば、3D の位置推定は補正量を学ぶだけで済み、一から学ぶ必要はない。
二重解像度メモリ:同じ席数でもっと遠くを見る
3D の情報が隠れた人を見分け直す助けになるのは、トラッカーがまだその人を覚えている場合に限られる。PLANET の三つ目の設計は、メモリ容量を増やさずに、振り返れる時間を延ばすことだ。
やり方は、メモリを半分ずつに分けることだ。半分は直近の連続した数フレームに割り当て、短い時間の細部を保つ。もう半分はもっと前の履歴に割り当て、数フレームおきに一フレームだけ取る。訓練時にはサンプリングの間隔もランダムに変え、間隔のまちまちな過去を見ることにモデルを慣れさせる。
論文は具体的な容量や間隔を示しておらず、見える範囲が MOTIP の 30 フレームから約 200 フレームに延びたとだけ述べている。仮の数字で感覚をつかんでみよう。
| やり方 | 席数 | 直近の連続 | それ以前 | 見える範囲 |
|---|---|---|---|---|
| すべて連続 | 30 | 30 | — | 30 フレーム |
| 二重解像度 | 30 | 15 | 15 個、12 フレームごとに 1 個 | 15 + 15 × 12 = 195 フレーム |
本稿で整理した計算例。容量 30 は MOTIP の 30 フレームと同じで、サンプリング間隔 12 は仮定の値。
メモリに保存するのは検出器が最後に出力したクエリで、すでに 3D の情報を含んでいるので、この延びたメモリは立体の手がかりもまとめて保存している。この変更に追加の訓練時間は要らない。
議論
各設計の寄与
| 設定 | HOTA | AssA | DetA | IDF1 |
|---|---|---|---|---|
| MOTIP ベースライン | 63.0 | 53.2 | 75.0 | 66.6 |
| +幾何クエリリフティング | 64.0 | 54.3 | 75.9 | 67.6 |
| +アンカーつき 3D 位置推定 | 64.4 | 54.9 | 76.1 | 67.8 |
| +二重解像度メモリ | 65.6 | 56.9 | 76.1 | 70.3 |
原論文 Table 1 をもとに整理。各設定を 5 回訓練した平均。
幾何クエリリフティングは検出と関連付けの両方を改善し、DetA と AssA がそれぞれ約 1 ポイント増える。アンカーつき 3D 位置推定はおもに関連付けを助け、AssA は 0.6 増えるが、DetA は 0.2 しか増えない。二重解像度メモリは完全に関連付けに効き、DetA は動かず、AssA が 2 ポイント、IDF1 が 2.5 増える。
著者らはメモリと 3D の相互作用も調べている。同じく二重解像度メモリを加えても、2D だけのモデルでは IDF1 が 1.5 増えるのに対し、3D を持つモデルでは 2.5 増える。立体の手がかりは比較的安定しているので、長く覚えているほど役に立つ。
3D をどう入れるか
| やり方 | HOTA | AssA | IDF1 |
|---|---|---|---|
| MOTIP ベースライン | 63.0 | 53.2 | 66.6 |
| Depth Anything 3 の特徴を直接融合 | 63.1 | 53.1 | 66.6 |
| 世界に接地したクエリ | 64.4 | 54.9 | 67.8 |
原論文 Table 4 をもとに整理。
最も素直なやり方は、3D 基盤モデルの特徴をそのままトラッカーにつなぐことだ。結果はほとんど役に立たず、HOTA は 0.1 増えるだけで、AssA と IDF1 は改善しない。その特徴は幾何を推定するために訓練されたもので、トラッカーにはどう使えばいいかわからない。
もう一組の比較は 3D の位置推定にある。同じ 3D の教師信号で、3D 予測ヘッドに独立して学んだ 3D 参照点を使わせると、HOTA はかえって 64.0 から 63.8 に落ちる。2D 参照点にアンカーしてはじめて、64.4 に上がる。
3D の情報そのものは役に立つ。ただし、クエリができる時点ではっきりした置き場所を与え、訓練の目標の中ではっきりした役割を与えてはじめて、トラッカーはそれを使えるようになる。
三つのデータセット
| データセット | MOTIP | PLANET | AssA:MOTIP → PLANET |
|---|---|---|---|
| DanceTrack | 69.6 | 72.1 | 60.4 → 63.9 |
| SportsMOT | 72.6 | 73.7 | 63.2 → 63.2 |
| BFT | 70.5 | 72.6 | 71.8 → 73.9 |
HOTA。DanceTrack は原論文 Table 5、SportsMOT は原論文 Table 6、BFT は原論文 Table 7 をもとに整理。いずれもテストセット。
三つのデータセットすべてで一位で、しかも各データセットで自分の訓練データだけを使い、CrowdHuman のような追加データは使っていない。比較表の中には追加データを使った手法もある。
伸びが最も大きいのは DanceTrack で、関連付けの AssA が 3.5 増え、IDF1 は 74.7 から 78.0 になる。ダンサーは同じ服を着て絶えず交差するので、平面の上では最も取り違えやすい場面だ。SportsMOT では AssA は MOTIP と同じ 63.2 で、伸びはすべて検出にある。DetA は 83.5 から 86.0 に、MOTA は 92.4 から 95.2 になる。
同じ著者陣が一年前に出した NOOUGAT は、DanceTrack でのオフライン版の HOTA が 68.4 だが、この論文の比較表には入っていない。両者の路線は違う。NOOUGAT は既製の検出器を使って関連付けの学習に専念する。PLANET はエンドツーエンドで、検出と関連付けがそろって 3D の恩恵を受ける。
まだ説明されていないこと
これは arXiv に出たばかりの論文で、まだ発表先はなく、コードと 3D 化したデータセットは論文が採択されてから公開するとしている。
論文には限界の章がなく、読者が知りたくなりそうなことがいくつかある。推論時、PLANET には各フレームの点群マップが必要で、つまり先に Depth Anything 3 を一度走らせなければならない。論文が報告する速度は FP32 で毎秒 12 フレーム、FP16 で毎秒 20 フレームと MOTIP 並みだが、このステップの時間を含むかどうかは説明していない。3D 疑似ラベルの質も幾何モデルしだいで、論文は不確かなラベルをどう取り除くかは説明しているが、そのラベルがどれほど正確かは評価していない。さらに、アブレーション実験にどのデータセットのどの分割を使ったのかも、論文ははっきり書いていない。
結論
ふつうの動画からシーンの立体構造を推定できるようになったのだから、PLANET はそれをトラッカーに入れてみた。
やり方には三つの要点がある。まず既存の 2D データセットを 3D に持ち上げ、点群マップと各ボックスの 3D 中心を得る。次に、クエリができる時点で 3D の情報を取り込み、2D 参照点にアンカーした補助タスクで、物体の立体的な位置をクエリに覚え込ませる。最後に二重解像度メモリで、同じ容量のまま振り返れる時間を約 200 フレームまで延ばす。
アブレーションで最も面白い比較は、3D 基盤モデルの特徴をそのままつないでもほとんど役に立たなかったことだ。3D の情報は、トラッカーが本当に使う場所に置いてはじめて力を発揮する。