原論文
Multiple Object Tracking as ID Prediction
- 発表先
- CVPR 2025国際会議
- arXiv への初回投稿
- arXiv:2403.16848
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingmotip2024,
  title = {{Multiple Object Tracking as ID Prediction}},
  author = {Ruopeng Gao and Ji Qi and Limin Wang},
  year = {2024},
  eprint = {2403.16848},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2403.16848}
}
ここまでで、トラッカーの大きな系統を二つ見てきた。
一つは検出してから関連付ける方式だ。検出は専用の検出器に任せ、関連付けは人が設計したルールに頼る。カルマンフィルタで位置を予測し、IoU や外観の距離でコストを計算し、ハンガリアン法でマッチングして、さらにしきい値をいくつも重ねる。こうしたルールは歩行者にはよく効くが、新しい状況に出会うたびに、誰かが分析し、手を加え、パラメータを調整し直さなければならない。SORT から Deep OC-SORT へ、さらに C-BIoU、UCMCTrack へと、みなこの道を歩いてきた。
もう一つはエンドツーエンドの MOTR 系列で、トラッククエリをフレームからフレームへ受け渡し、検出と追跡をデコーダの中でまとめて行う。関連付けはもう人が書いたルールに頼らないが、二種類のクエリが同じデコーダに押し込まれると互いに干渉し、そのせいで検出が割を食うことが多い。MOTRv2 はいっそ検出を YOLOX に任せ直した。
南京大学の Ruopeng Gao と王利民(Limin Wang)、そして中国移動(蘇州)ソフトウェア技術会社の Ji Qi は、「検出してから関連付ける」という分業は残したまま、関連付けを丸ごとモデルに学ばせられないかを知りたかった。
彼らの答えが MOTIP だ。Ruopeng Gao にとって MeMOTR に続く次の論文で、手法は拍子抜けするほど単純だ。
問題の定義
関連付けは分類問題にとてもよく似て見える。訓練データでは、どの軌跡にも ID が一つある。検出ボックスが与えられて、それがどの軌跡に属するかを判断するのは、その ID を予測することにほかならないのでは?
問題は推論にある。テスト動画に現れるのは見たことのない人ばかりで、ID も新しい。訓練中に一度も出てこなかったクラスに人を分類することは、モデルにはできない。
だから FairMOT のような手法は、訓練では分類の損失で外観特徴を学ぶのに、推論では別のやり方に切り替えなければならない。特徴を取り出してコサイン類似度を計算し、人が書いたルールでマッチングするのだ。訓練と推論で、実は別々のことをしている。
著者らは、行き詰まりの原因は、追跡の ID と一般的な分類のラベルが本質的に違うことにあると考えた。
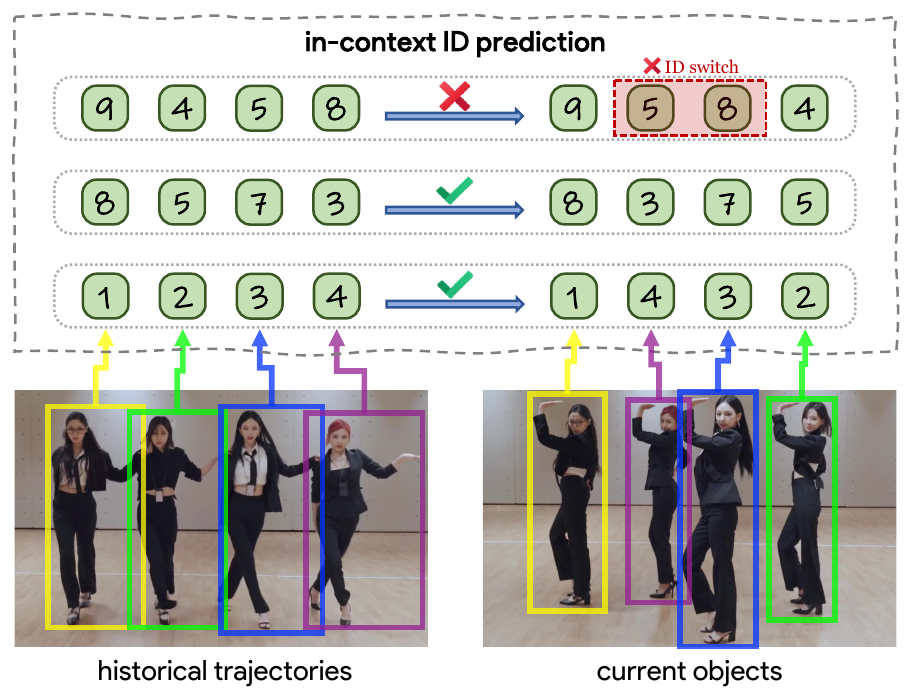
一般的な分類の「猫」はあくまで猫で、ラベルには意味がある。追跡の ID にはそれがない。正解ファイルで 1、2、3、4 と書かれた四人は、8、5、7、3 に変えてもまったくかまわない。一人ひとりが最初から最後まで同じ番号を使ってさえいればいい。ID はただの番号札だ。「これらのボックスは同じ人だ」と示しているだけで、番号そのものがいくつかは重要ではない。
問題を解く
インコンテキスト ID 予測
番号そのものが重要でないなら、モデルに「過去の軌跡に掛かっている番号札」を見せて、新しい検出がどの札を取るべきかを予測させればいい。
具体的には、過去の各軌跡 に番号 をランダムに配る。 だ。新しいフレームが来て、ある検出が 番目の軌跡に属するなら、正解は になる。
番号は軌跡に配られるヒントなので、著者らはこれをインコンテキスト ID 予測(in-context ID prediction)と呼ぶ。こうすれば、テストでいくら新しい顔に出会っても、予測すべきなのはつねに 1 から までの番号で、どれも訓練した範囲に収まる。番号はどう配ってもよく、予測が過去と食い違わなければ正解になる。Figure 1 の三段が示しているのはこのことだ。
三つの部品
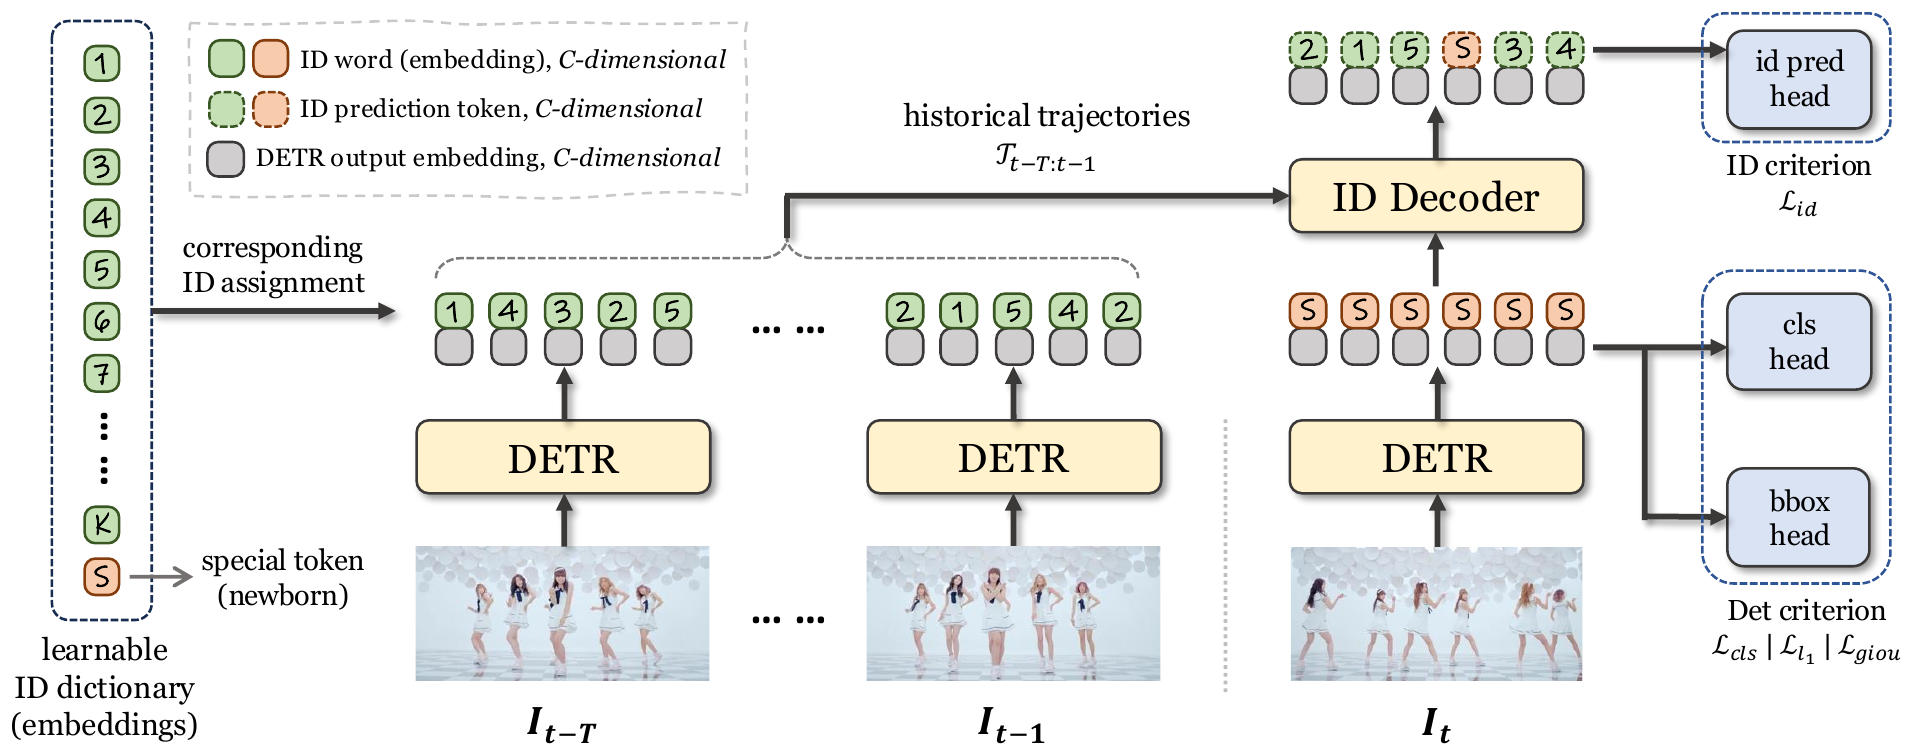
構成全体には部品が三つしかない。
DETR 検出器。 ResNet-50 をバックボーンとする Deformable DETR を使う。利点は、デコーダの出力埋め込みがそのまま物体の特徴として使えることで、別途ボックスを切り出したり RoI プーリングをしたりする必要がない。物体ごとに 256 次元の特徴 が得られる。
ID 辞書。 個の学習可能な 256 次元の埋め込みの集まりだ。
最初の 個はふつうの番号を表し、最後の は「新しい物体」を表す。著者らが one-hot 符号化を使わなかった理由は、訓練に不利で、しかも番号の上限がベクトルの次元に縛られてしまうからだ。デフォルトは で、一フレームに出てくる物体の最大数を下回らなければそれでいい。
ID デコーダ。 標準的な Transformer デコーダで、自己注意とクロスアテンションが交互に並び、最後に線形の分類ヘッドがつながって、 クラスの確率を出力する。
一つの物体がどうやって一つの token になるか
一本の軌跡に沿って、ひと通りたどってみよう。
すでに追跡中の軌跡には番号 が配られている。その軌跡の過去 フレームのボックスには、どれも DETR の特徴 がある。特徴と番号の埋め込みをそのまま連結する。
どの token も 512 次元で、前半は「どんな見た目か」、後半は「何番の札を掛けているか」だ。この軌跡の過去 フレームのすべての token が、その履歴になる。 は DanceTrack では 29 フレーム、SportsMOT では 59 フレームだ。
現在のフレームの検出は、まだ誰なのかわからないので、一律に新しい物体の記号をつなげる。
続いて、現在の検出をクエリ、過去のすべての token をキーとバリューとして、ID デコーダに送り込む。デコーダの中のクロスアテンションでは、各検出が履歴の中から「いちばん見た目が似ている token の列が何番を掛けているか」を探す。自己注意では、同じフレームの検出どうしが情報を交換し、よく似た二人が同じ番号を奪い合わないようにする。最後に分類ヘッドが、各検出が各番号に属する確率を出力する。
検出が 番目の軌跡に属するなら、答えは だ。新しく現れた人なら、答えは新しい物体のクラスになる。こうして関連付けは クラスの分類問題になり、交差エントロピーでそのまま訓練でき、DETR の検出損失と足し合わせられる。
四つの重みはそれぞれ 2、5、2、1 だ。
推論:番号札の配り方と回収のしかた
推論の流れはごく素直だ。
- 番号は 1 から まで順に、重複しないように軌跡に配る。軌跡が終わったら、その番号は回収して新しい軌跡に回す。だから動画がどれほど長く、現れる人がどれほど多くても、同時に追跡している軌跡が 本を超えなければそれでいい。
- DETR の出力は、まず信頼度 0.3 でふるいにかける。
- 残った検出を ID デコーダに送り込み、それぞれ確率が最も高く、しかも 0.2 を超える番号を選ぶ。
- 同じフレームで二つの検出が同じ番号を選んだら、信頼度の高いほうだけを残す。
- 番号をもらえず、しかも検出の信頼度が 0.6 を超えるものは、新しい物体として新しい番号札を配る。
デフォルトではハンガリアン法を使わない。著者らは、もっと複雑な割り当て戦略を使えばもう少し伸びるかもしれないが、自分たちが検証したいのはモデルそのものの能力だと考えている。
著者らの集計では、ほとんどの場合、番号の使用率は 40% に満たない。本当にひどく混雑した場面に出会ったら、 を大きくすればいい。DETR がデフォルトで 300 個のクエリを使うのと同じことだ。
訓練では、わざと誤りを作る
訓練では、過去の軌跡は正解データから組み立てるので、どれもきれいなものだ。推論ではそうはいかない。人は隠れるし、モデルも番号を配り間違え、その誤りはその後の履歴にも書き込まれる。
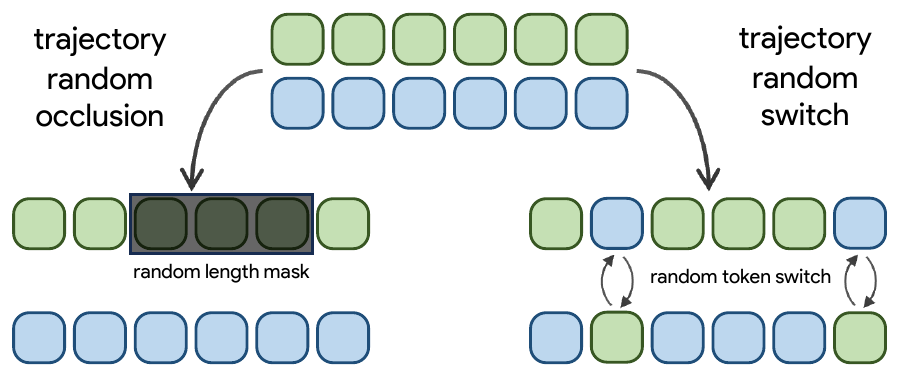
モデルを不完全な履歴に慣れさせるため、著者らは二種類の軌跡拡張を加えた。
- ランダムな遮蔽: 確率 で、軌跡の途中の一区間の token を取り除き、人が隠れる状況を模擬する。
- ランダムな交換: 確率 で、同じフレームの二本の軌跡の番号を入れ替え、モデルが似た人を取り違える状況を模擬する。
どちらも 0.5 に設定する。
さらに、検出と関連付けは別々の二つのモジュールなので、訓練は並列に処理できる。毎回 フレームのクリップを取り、各フレームの DETR は同時に順伝播を計算でき、ID デコーダはアテンションマスクで未来を見られないようにする。逆伝播が必要なのは、そのうち 4 フレームの DETR だけだ。著者らは RTX 4090 を 8 枚使い、DanceTrack での訓練は一日もかからなかった。
議論
著者らは比較の条件を意図的にそろえていて、主な結果はどれも Deformable DETR に ResNet-50 を組み合わせ、追加の検出データセットも使わない。彼らは、CrowdHuman のような静止画を平行移動させて疑似動画にして訓練するのは、エンドツーエンドの手法、とくに長い時間のモデリングが要る手法には良くないと考えている。
DanceTrack
| 手法 | HOTA | DetA | AssA | IDF1 |
|---|---|---|---|---|
| OC-SORT | 55.1 | 80.3 | 38.3 | 54.6 |
| C-BIoU | 60.6 | 81.3 | 45.4 | 61.6 |
| DiffMOT | 62.3 | 82.5 | 47.2 | 63.0 |
| MeMOTR | 63.4 | 77.0 | 52.3 | 65.5 |
| CO-MOT | 65.3 | 80.1 | 53.5 | 66.5 |
| MOTIP | 69.6 | 80.4 | 60.4 | 74.7 |
| MOTRv2(追加データ) | 69.9 | 83.0 | 59.0 | 71.7 |
| MOTIP(追加データ) | 72.0 | 81.8 | 63.5 | 76.8 |
原論文 Table 1 をもとに整理。DanceTrack テストセット。
MOTIP は追加データなしで 69.6 を出し、同じく Deformable DETR を使う CO-MOT より 4.3 ポイント、AssA で 6.9 ポイント高く、IDF1 では 8 ポイント以上も上回る。追加データを使ったバージョンは 72.0 に達し、MOTRv2 を超える。
表の MeMOTR の 63.4 は、標準の Deformable DETR に置き換えたバージョンで、MeMOTR の論文のメインの表で DAB-Deformable-DETR を使って報告しているのは 68.5 だ。68.5 と比べても MOTIP はまだ一段上だが、両者の検出のフレームワークは同じではない。
SportsMOT と鳥の群れ
SportsMOT で訓練セットだけを使った場合、MOTIP の HOTA は 72.6、AssA は 63.2 で、同じ条件の OC-SORT(68.1)や MeMOTR の Deformable DETR 版(68.8)より高く、追加データを使った DiffMOT(72.1)よりも高い。
ただし、SportsMOT で最も成績が良いのは Deep-EIoU の系統のやり方だ。YOLOX の検出器を訓練セットと検証セットで訓練し、さらに ReID モデルを加えて、HOTA は 77.2 になる。両者は訓練データも検出器も違うので直接は比べられないが、スポーツの場面では、強い検出器に単純なルールを組み合わせたものが今でも十分に競争力を持つことを思い出させてくれる。
著者らはさらに、鳥の追跡データセット BFT でも試した。22 種の鳥、106 本の動画からなる。鳥は三次元の空間を飛ぶので、動きは地上の人よりも不規則で、見分けるための服もない。MOTIP の HOTA は 70.5、OC-SORT は 66.8、ByteTrack は 62.5 だ。
自己注意とハンガリアン法
アブレーションは DanceTrack の検証セットで行う。
| 自己注意 | ハンガリアン | 軌跡拡張 | HOTA | AssA |
|---|---|---|---|---|
| 57.7 | 43.9 | |||
| ✓ | 59.7 | 47.2 | ||
| ✓ | 59.5 | 47.2 | ||
| ✓ | ✓ | 59.9 | 47.9 | |
| ✓ | ✓ | 62.2 | 51.5 | |
| ✓ | ✓ | ✓ | 62.2 | 51.8 |
原論文 Table 4 をもとに整理。DanceTrack 検証セット。
- 自己注意がないときは、ハンガリアン法が役に立つ。 57.7 から 59.7 に上がる。自己注意がないと、各検出はそれぞれ勝手に番号を選び、相手が何を選んだかを知らないので、衝突を避けるには全体での割り当てが必要になる。
- 自己注意があると、ハンガリアン法はほとんど役に立たなくなる。 0.4 ポイント増えるだけで、軌跡拡張を加えるとまったく同じになる。著者らの説明では、自己注意によって同じフレームの検出がデコードの段階で互いに身元の情報を交換していて、モデルは全体での割り当てを自分で学んでいる。
- 軌跡拡張で 2.7 ポイント上がる。 59.5 から 62.2 へ、この表で最も大きな一歩だ。
軌跡拡張の割合にも加減が要る。ランダムな遮蔽だけを加える場合は 0.5 が最も良く(60.7)、1.0 まで遮るとかえって 58.6 に下がる。遮蔽 0.5 を土台にランダムな交換を加える場合は 0.5 が最も良く(62.2)、0.8 では 59.8 に落ちる。
ReID との比較
MOTIP も物体の特徴で追跡するので、ReID の手法の一種のように見える。著者らはこれを、よくある二種類の ReID の訓練方法と比べた。一つは FairMOT の分類式、もう一つは対照学習式で、推論ではどちらもコサイン類似度を使う。
DETR を凍結し、関連付けの部分だけを訓練する設定では、FairMOT 式の HOTA はわずか 29.4、対照学習式は 41.0、MOTIP の ID 予測は 55.4 だった。すべてのパラメータをまとめて訓練する場合、ReID の手法は、ハンガリアン法を加え、さらに ID デコーダと同じ構造の軌跡強化モジュールを加えても、最高で 54.5 にとどまり、MOTIP は 59.5 だった。
同じ特徴でも、訓練のしかたを「文脈を見ながら番号を予測する」ものに変えるだけで、5 ポイント以上の差がつく。著者らの考えでは、ReID の手法は人が書いたルールで履歴の情報をまとめ、それぞれ別々に類似度を計算するので、モデルの柔軟性が制限される。MOTIP は、過去の軌跡をどう見るかをモデル自身に決めさせる。
限界
MOT17 では、MOTIP の HOTA は 59.3 で、エンドツーエンドの手法の中では CO-MOT(60.1)や MOTRv3(60.2)と同程度だが、ByteTrack(63.1)のようなヒューリスティックな手法には明らかに後れを取っている。著者らの説明では、MOT17 には訓練動画が 7 本しかなく、データから学ぶ必要がある手法には少なすぎる。一方、ヒューリスティックな手法は、歩行者の線形な運動に合わせて十年近く磨き上げられてきた。
速度の面では、RTX A5000 一枚で、MOTIP は FP32 で毎秒 12.7 フレームと、MOTR の 13.1 とほぼ同じで、FP16 にすれば 22.8 フレームまで出る。
著者らはまた、この設計は意図的に単純にしてあり、目的は「追跡を ID 予測として扱う」という考えが成り立つことを検証することで、運動や深度といったほかの手がかりを加える余地はまだ大きいとも述べている。
結論
MOTIP は、複数物体追跡の関連付けを、インコンテキスト ID 予測の問題として書き直した。番号は過去の軌跡にランダムに配られ、モデルはその番号を見ながら、新しい検出がどの札を取るべきかを予測するだけだ。モデル全体は DETR、ID 辞書一冊、標準的な Transformer デコーダ一つだけで、カルマンフィルタもコスト行列もなく、ハンガリアン法すら要らないのに、DanceTrack、SportsMOT、鳥の追跡のいずれでも従来の手法を上回った。
アブレーションで最も面白いのは、ハンガリアン法が効かなくなったことだ。SORT からずっと居座ってきたこの部品が、MOTIP では一層の自己注意に取って代わられた。
振り返ってみれば、評価指標はとうの昔からこういうふうに ID を見ていた。CLEAR MOT はフレームごとに対応を作り、IDF1 は動画全体で真の身元と計算上の身元を一対一で対応付ける。どちらも、トラッカーが付けたのが 3 番か 87 番かは気にせず、同じ人がずっと同じ番号札を持ち続けているかどうかだけを気にしている。MOTIP は、モデルにも同じやり方で ID を理解させたにすぎない。