原論文
Occlusion-Aware SORT: Observing Occlusion for Robust Multi-Object Tracking
- 発表先
- CVPR 2026国際会議
- arXiv への初回投稿
- arXiv:2603.06034
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingoasort2026,
  title = {{Occlusion-Aware SORT: Observing Occlusion for Robust Multi-Object Tracking}},
  author = {Chunjiang Li and Jianbo Ma and Li Shen and Yanru Chen and Liangyin Chen},
  year = {2026},
  eprint = {2603.06034},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2603.06034}
}
体格の似た二人が前後に並んで通り過ぎ、後ろの人は大部分が隠れてしまう。このとき検出器が出すボックスは、後ろの人の見えている一部しか囲んでいなかったり、いっそ前の人のほうへずれて囲んでいたりすることが多い。
カルマンフィルタは続いてこうした不正確なボックスで自分を更新し、予測もそれにつられてずれる。マッチングの段になると、前の人の検出ボックスと後ろの人の予測ボックスの IoU が、前の人自身の予測ボックスとの IoU より高くなることがある。ハンガリアン法はコストしか見ないので、二人の身元はこうして入れ替わる。
四川大学の Chunjiang Li、Yanru Chen らは、この現象をコストの混同と呼んだ。彼らはまず「誰が誰を、どれだけ隠しているか」を計算し、それを使ってマッチングとカルマンフィルタを補正する。手法全体に訓練は要らず、既存のトラッカーにそのまま組み込める。
問題の定義
位置による関連付けには三つの部品がある。カルマンフィルタが位置を予測し、IoU が検出ボックスと予測ボックスの一致具合を測り、ハンガリアン法がコストの最も低い組み合わせを探す。
著者らは検出ボックスも予測ボックスも「本当の位置に誤差を足したもの」として書く。
部分的に遮蔽されると、物体の見た目が一部欠けるので検出誤差 が大きくなり、IoU が一、二フレームのうちに急に跳ねることがある。遮蔽が続くと、不正確な検出が繰り返しカルマンフィルタの更新に使われ、予測誤差 も積み重なっていく。二種類の誤差が重なると、コスト行列はもう誰と誰が同一人物かを安定して表せなくなる。
多くのトラッカーは、外観特徴、運動方向、検出の信頼度で補おうとする。ところがこうした手がかりも遮蔽のときには同じく当てにならない。隠れている人から取り出した外観特徴には前の人の姿が混ざり、検出の信頼度も押し下げられる。そこで著者らは位置そのものに立ち返り、遮蔽を直接扱うことにした。
問題を解く
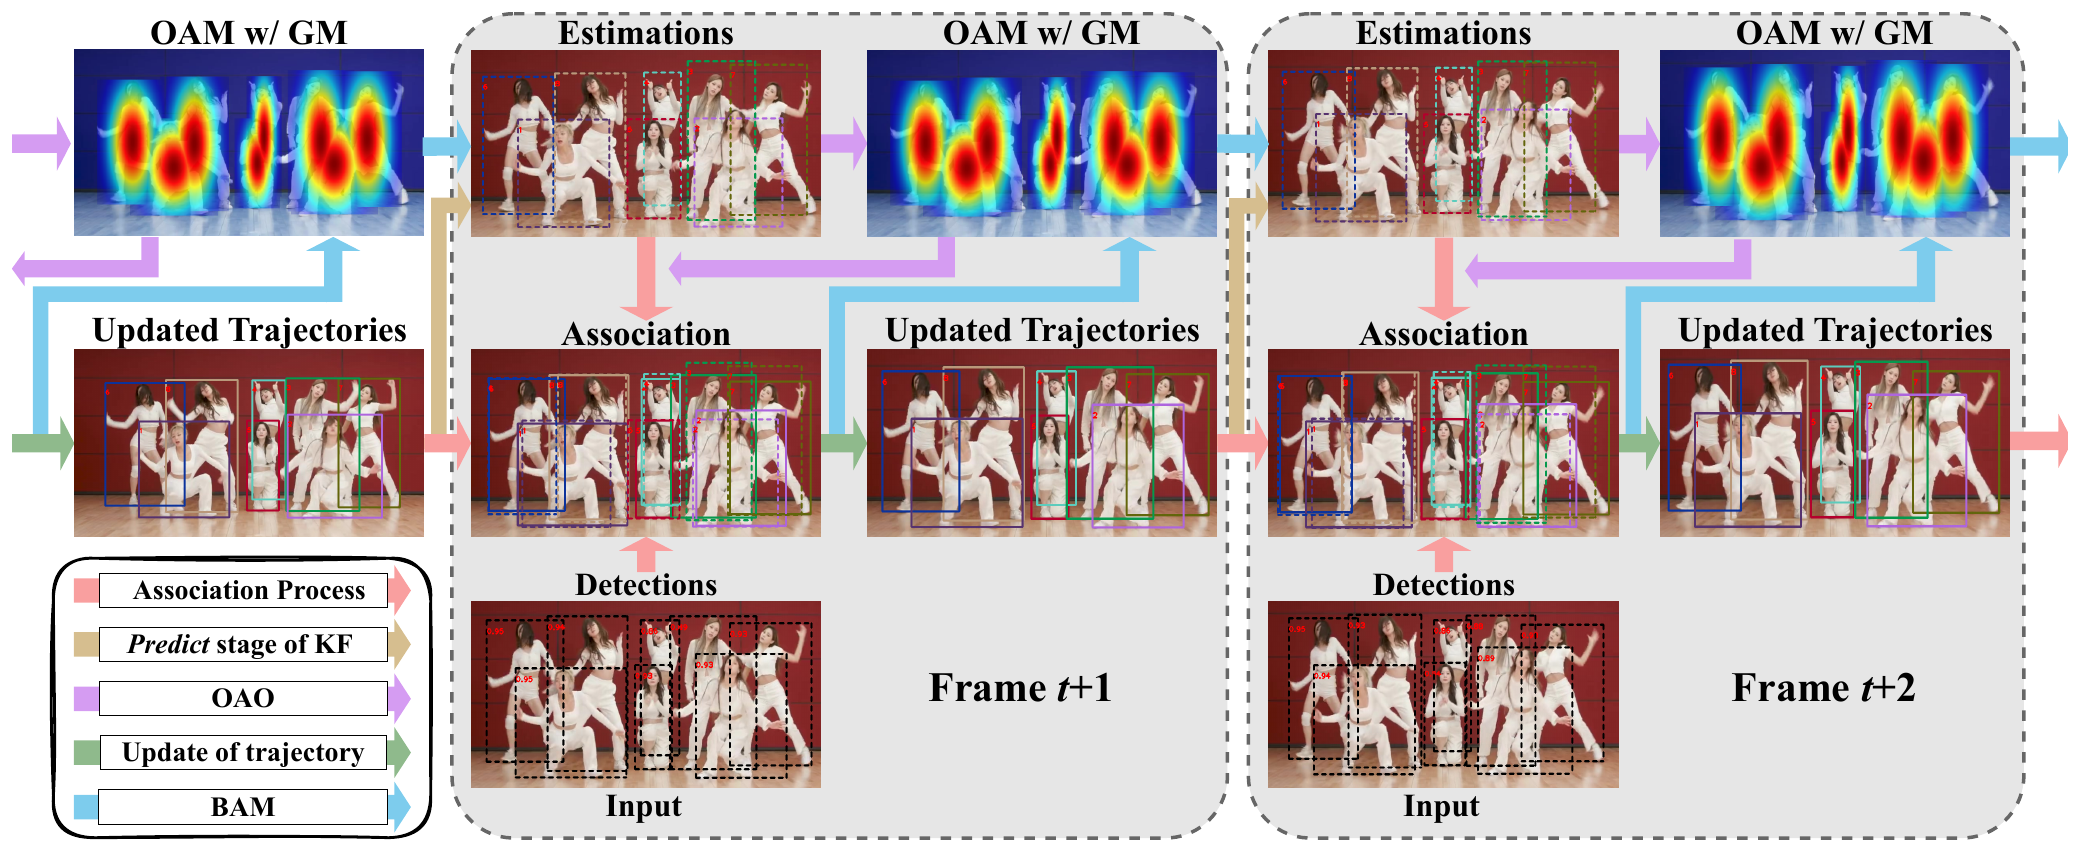
OA-SORT は三つの部品からなる。OAM が遮蔽の度合いを推定し、OAO がそれをマッチングに使い、BAM がそれをカルマンフィルタの更新に使う。
OAM:誰が前にいて、どれだけ隠しているか
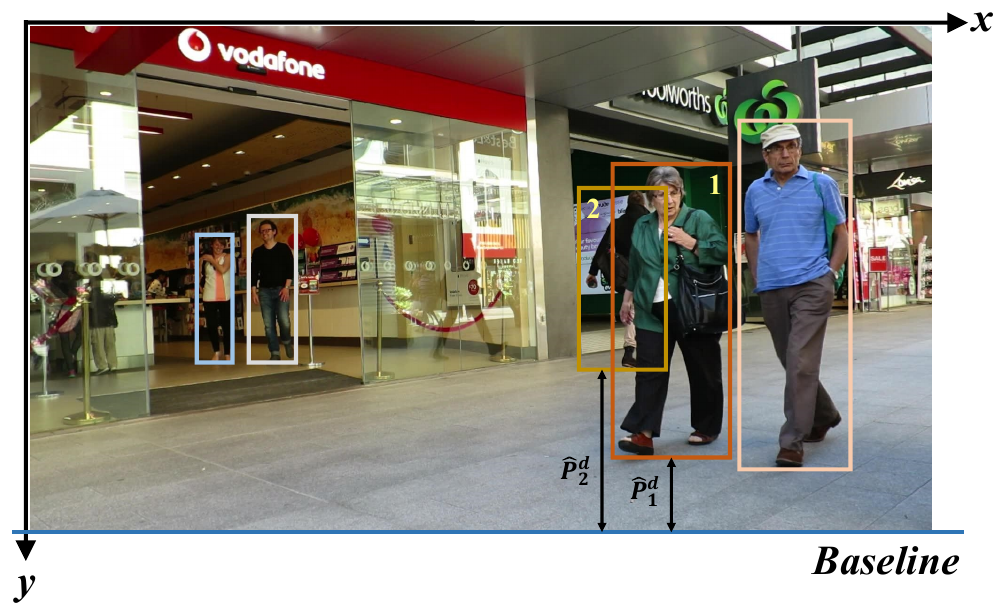
誰が誰を隠しているかを知るには、まず誰が前にいるかを知る必要がある。一般的な監視カメラは斜め上から見下ろして撮るので、地面に立っている人は、足が画面の下端に近いほどカメラに近い。だから二つのボックスの底辺を比べるだけで、前後の順番がつけられる。ボックスの揺れによる誤判定を避けるため、底辺が少なくとも 5 ピクセル違わなければ数えない。
前後がわかれば、隠されている割合は「前にあるすべてのボックスとの共通部分の面積」を「自分自身の面積」で割ったものになる。
ただ、ボックスの中は人だけではない。ダンサーが腕を広げたり大きく踏み出したりすると、ボックスの縁はほとんどが背景で、縁が隠れてもたいした問題ではない。著者らはガウスマップを一枚加え、各ピクセルにボックスの中心からの距離に応じた重みを与えた。中心が 1 で、外に行くほど小さくなる。隠された面積は重みつきの合計に置き換える。
減衰の速さはデータセットに応じて調整する。DanceTrack の設定では、ボックスの左右の縁の重みはわずか だ。同じ幅の帯が隠れても、縁で隠れたものは中央で隠れたもののおよそ十分の一にしか数えない。
OAO:隠されている側は、マッチングで一歩譲る
OAO は遮蔽の度合いをマッチングのスコアに加える。
ここでの遮蔽の度合いは、検出ボックスではなく、カルマンフィルタの予測ボックス に対して計算する。隠された検出ボックスの底辺はよく跳ね回るので、かえって前後関係を正しく判断できない。予測ボックスのほうが滑らかだ。
ひどく隠されている軌跡ほど、すべての検出ボックスに対するスコアが少しずつ割り引かれる。二本の軌跡が同じ検出ボックスを奪い合うとき、前に立っていて隠されていないほうが有利になる。
例で見てみよう。ダンサー j が前に立ち、ダンサー i が後ろで六割隠れている。このフレームの j の検出ボックスは で、i の予測ボックスとの IoU は 0.70、j 自身の予測ボックスとはわずか 0.65 だ。j の予測は、すでに前の数フレームの誤差で引きずられているからだ。 は DanceTrack の 0.15 を取る。
| 予測ボックス | 遮蔽の度合い | IoU | IoU のみ | 遮蔽を加えたスコア |
|---|---|---|---|---|
| 後ろの i | 0.6 | 0.70 | 0.70 | 0.15 × 0.4 + 0.85 × 0.70 = 0.655 |
| 前の j | 0 | 0.65 | 0.65 | 0.15 × 1 + 0.85 × 0.65 ≈ 0.703 |
本稿で整理した計算例。
IoU だけを見ると、 は後ろの i に割り当てられ、二人の身元が入れ替わる。遮蔽の度合いを加えると、 は j のもとに戻る。
OAO を使うのは第一段階、つまり高スコアの検出ボックスのマッチングだけだ。
BAM:当てにならない観測は、話半分に聞く
隠されている人は検出スコアがたいてい低めで、第二段階になってからマッチングされる。こうした低スコアのボックスはあまり正確ではなく、カルマンフィルタがそれを鵜呑みにすると、速度の推定が引きずられ、次のフレームの予測もつられて外れる。
BAM は更新の前に、観測を予測のほうへいくらか引き戻す。
観測と予測の差が大きいほど、あるいはこの軌跡が前回ひどく隠されていたほど、BAM は小さくなり、更新のときに予測をより信じる。著者らは付録で、これはカルマンゲインに BAM を掛けるのと等価で、遮蔽下のノイズの共分散を別に推定する必要がないと指摘している。
たとえば予測の 座標が 100、低スコアの検出ボックスが 120、両者の IoU が 0.5 で、この軌跡は前回六割隠されていたとする。BAM は で、更新に使う観測は になる。
議論
各部品の寄与
| 設定 | HOTA | AssA | IDF1 | 時間/フレーム |
|---|---|---|---|---|
| Hybrid-SORT | 59.4 | 44.9 | 60.7 | 9.57 ms |
| +OAO | 59.9 | 45.6 | 60.9 | +1.96 ms |
| +OAO、ガウスマップ | 60.6 | 46.7 | 62.0 | +9.25 ms |
| +OAO、BAM | 60.5 | 46.5 | 62.2 | +3.81 ms |
| すべて | 61.5 | 48.0 | 63.7 | +14.99 ms |
原論文 Table 4 をもとに整理。DanceTrack 検証セット。時間は検出を含まない。
三つの部品を合わせると、HOTA は 2.1 増える。ガウスマップの影響は小さくない。OAO にこれを加えると、HOTA は 59.9 から 60.6 になる。コストもおもにここにかかり、ピクセル単位の計算で 1 フレームあたりの追跡時間は 9.57 ミリ秒から 24.56 ミリ秒に増えるが、それでもリアルタイムで動く。
BAM の中の IoU の項にも効果がある。これを固定の定数に替えると、最良の 0.4 のときで HOTA 61.26、IoU を使うと 61.49 だ。
ほかのトラッカーに組み込む
| トラッカー | 元の HOTA | 遮蔽認識付き | 元の IDF1 | 遮蔽認識付き |
|---|---|---|---|---|
| ByteTrack | 47.1 | 49.0 | 51.9 | 55.9 |
| OC-SORT | 54.6 | 56.5 | 54.6 | 57.6 |
| SparseTrack | 55.5 | 57.8 | 58.3 | 60.2 |
| PD-SORT | 58.2 | 60.4 | 57.5 | 60.8 |
| Hybrid-SORT | 62.2 | 63.1 | 63.0 | 64.2 |
原論文 Table 1 をもとに整理。DanceTrack テストセット、OC-SORT の検出結果を使用。
土台以外の四つのトラッカーでは、HOTA が平均 2.08、IDF1 が平均 3.05 増える。SparseTrack と PD-SORT はもともとボックスの底辺から推定した「疑似深度」を使っているが、遮蔽認識を加えてもやはり改善する。土台にした Hybrid-SORT は改善が最も小さく、もともと運動方向で遮蔽に対処しているので、0.9 増えるだけだ。
検証セットでは、著者らは TrackTrack にも組み込んでみていて、HOTA は 59.3 から 59.9 に、IDF1 は 61.1 から 62.0 になった。TrackTrack のマッチングのやり方はハンガリアン法ではなく、NMS で削除されたボックスも使っているが、OA-SORT は同じように上に重ねられる。
ほかのデータセット
SportsMOT では、検出器を訓練セットだけで訓練した設定で、HOTA が 73.0 から 73.4 に、IDF1 が 73.3 から 74.1 になり、しかもカメラ運動補償は一切使っていない。著者らの説明では、遮蔽関係は物体同士の相対的な位置なので、カメラが回っても成り立つ。
MOT17 では、HOTA が 63.6 から 64.2 に、IDF1 が 78.4 から 79.1 になり、ReID を加えた Hybrid-SORT よりわずかに高いほどだ。ただし MOTA は 80.6 から 79.6 に落ちる。
どんなときに効かなくなるか
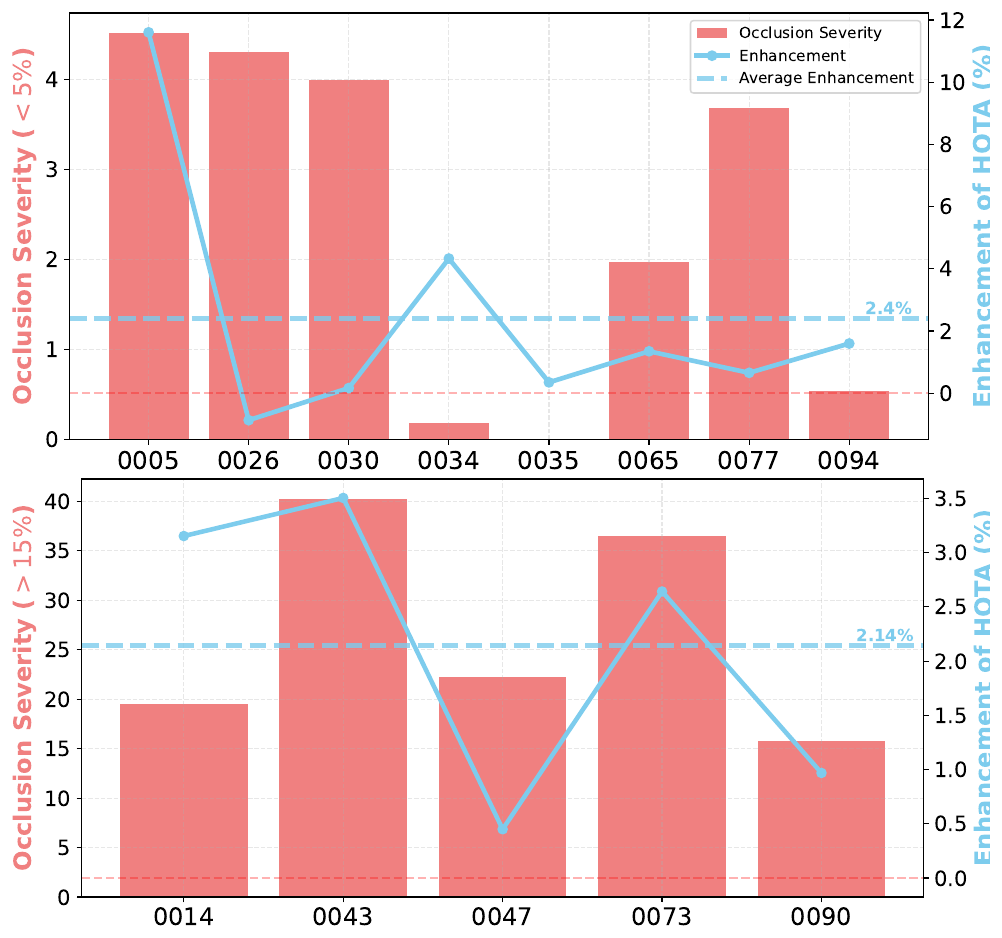
ほとんどの動画で改善しているが、上の図の 0026 はマイナスだ。著者らは限界として、手法全体がボックスの底辺で前後を判断しているので、人の下半身が隠れたり、ダンサーが跳び上がって両足が地面を離れたりすると、底辺がもうその人の立ち位置を表さなくなり、前後関係を誤ると述べている。
さらに、遮蔽の度合いはそのフレームだけを見ていて、遮蔽の時間的な変化はモデル化していないので、長時間の遮蔽ではやはり関連付けが不安定になる。
結論
遮蔽は位置による関連付けが誤る主な原因で、OA-SORT はまず遮蔽の度合いを計算するところから始める。ボックスの底辺で前後を並べ、共通部分の面積とガウスの重みでどれだけ隠されているかを計算し、その数字をマッチングのスコアとカルマンフィルタの更新にそれぞれ組み込む。
訓練も外観特徴も要らず、五種類の異なるトラッカーに組み込んで、HOTA も IDF1 も改善した。代償は「足が地面についている」ことで成り立つ仮定一つだ。舞台のダンサーが跳び上がったとたん、この仮定は通用しなくなる。