原論文
MOT20: A benchmark for multi object tracking in crowded scenes
- 発表先
- 正式な発表先は未確認
- arXiv への初回投稿
- arXiv:2003.09003
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingmot202020,
  title = {{MOT20: A benchmark for multi object tracking in crowded scenes}},
  author = {Patrick Dendorfer and Hamid Rezatofighi and Anton Milan and Javen Shi and Daniel Cremers and Ian Reid and Stefan Roth and Konrad Schindler and Laura Leal-Taixé},
  year = {2020},
  eprint = {2003.09003},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2003.09003}
}
ByteTrack、OC-SORT、StrongSORT のメインの表を読んだことがあれば、MOT20 の列を見たことがあるはずだ。たいてい MOT17 のすぐ後ろにあって、数字は全体に低く、速度もずっと遅い。
MOT20 の論文自体はわずか 7 ページで、紙幅の大半はアノテーションのルールと評価方法の説明に割かれていて、四年前の MOT16 とほとんど同じだ。本当に新しいのは、極端に混雑した 8 本の動画だ。
著者らは MOTChallenge の運営チームで、ミュンヘン工科大学、アデレード大学、チューリッヒ工科大学、ダルムシュタット工科大学に所属している。論文の集計によると、MOTChallenge は 2014 年の公開以来 1,000 人を超える利用者を集め、5 つのチャレンジで合わせて 44 本の動画、270 万個のボックスを使ってきた。MOT20 の動画はまず 2019 年にワークショップのチャレンジで使われ、この論文はあとから出された完全な説明だ。
問題の定義
MOT15 から MOT17 までで、複数物体追跡はきれいなデータと統一された評価を手に入れた。しかし著者らの経験では、ほとんどの手法は特定のデータセットに過剰に調整されている可能性があり、まったく違う状況に移ると、パラメータを大きく変えたり、ときにはモデルを替えたりしないと対応できない。
混雑は、まだきちんと試されていない状況の一つだ。人が増えるとボックスは小さくなり、互いに遮蔽し合い、検出器は人を見落とし始める。トラッカーは、似たようなボックスの大群の中で誰が誰かを見分けなければならない。著者らが欲しかったのは、手法を「限界まで追い込める」動画の一式だ。
問題を解く
8 本の動画、3 つの場面
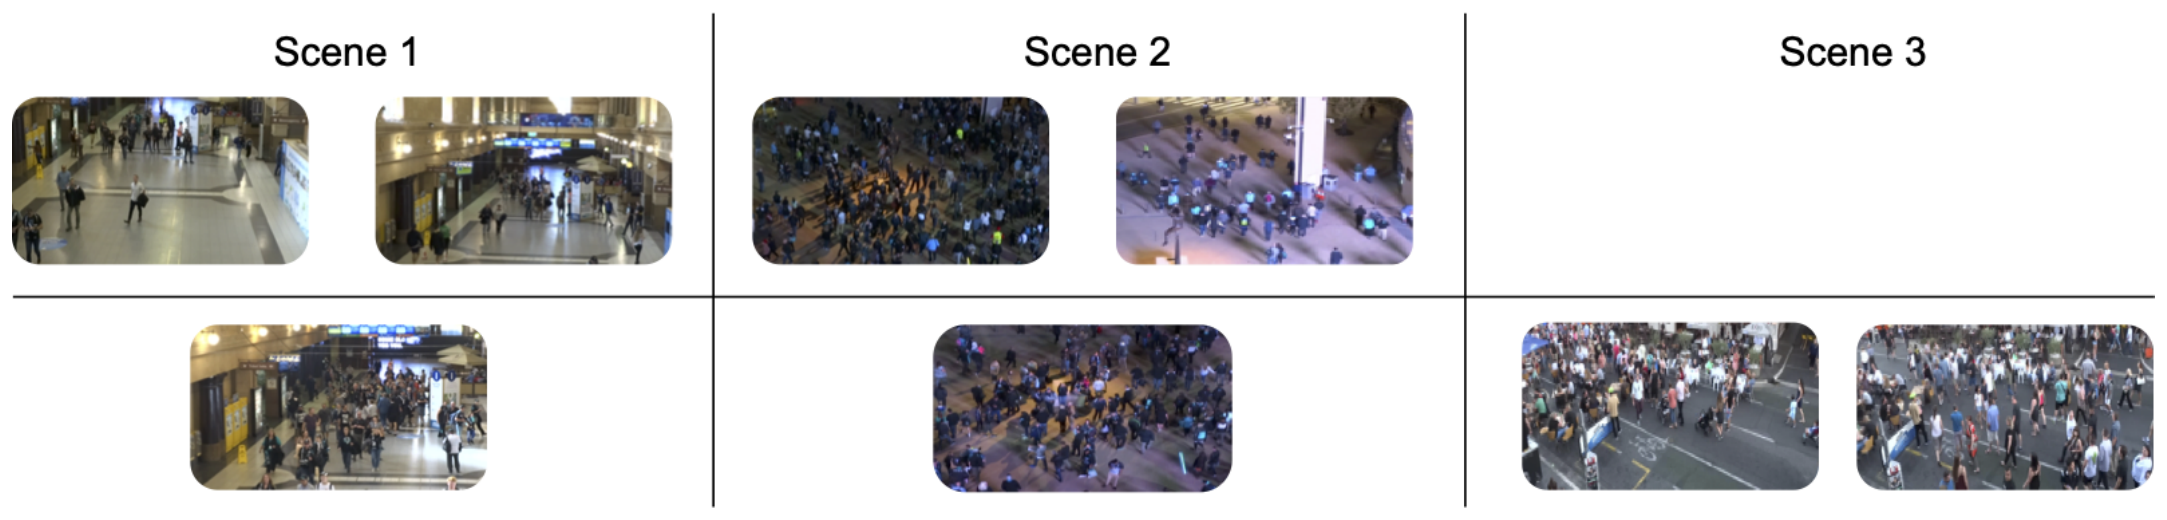
8 本の動画は 3 つの場面で撮られ、訓練用とテスト用が 4 本ずつで、すべて高い位置から見下ろして撮影されている。場面 1 と場面 2 は訓練とテストの両方にあり、場面 3 はテストにしか現れない。著者らはわざと未知の場面を一つ残し、手法が新しい環境に汎化できるかを試せるようにした。テストのアノテーションは公開せず、手法が特定の動画に過剰に合わせ込まれるのを防いでいる。
各動画の統計は次のとおりだ。
| 動画 | 場面 | 解像度 | フレーム数 | 軌跡 | 歩行者ボックス | 人数/フレーム |
|---|---|---|---|---|---|---|
| 01 | 屋内 | 1920×1080 | 429 | 74 | 19,870 | 46.3 |
| 02 | 屋内 | 1920×1080 | 2,782 | 270 | 154,742 | 55.6 |
| 03 | 屋外・夜 | 1173×880 | 2,405 | 702 | 313,658 | 130.4 |
| 05 | 屋外・夜 | 1654×1080 | 3,315 | 1,169 | 646,344 | 195.0 |
| 04 | 屋外・夜 | 1545×1080 | 2,080 | 669 | 274,084 | 131.8 |
| 06 | 屋外・昼 | 1920×734 | 1,008 | 271 | 132,757 | 131.7 |
| 07 | 屋内 | 1920×1080 | 585 | 111 | 33,101 | 56.6 |
| 08 | 屋外・昼 | 1920×734 | 806 | 191 | 77,484 | 96.1 |
原論文 Table 1 をもとに整理。太字はテスト用の動画。すべての動画は毎秒 25 フレーム。
この表には、もう一度よく見ておきたいところがいくつかある。
第一に、動画が短い。訓練用の動画は合わせても 6 分に満たず、テスト用は 3 分に満たないが、訓練セットには歩行者ボックスが 113 万個あり、テストセットにも 52 万個ある。
第二に、データセットはごく少数の動画に支配されている。MOT20-05 だけで 64.6 万個のボックスがあり、訓練セット全体の 57% を占める。テストセットでは MOT20-04 が 53% を占める。MOTChallenge はすべてのテスト動画をつなげて一つの MOTA を計算するので、MOT20-04 という夜の広場の一本での性能が、テストのスコアをほぼ決めてしまう。MOT16 のノートで触れた MOT16-03 にも同じ事情がある。
第三に、未知の場面 3(MOT20-06、08)は解像度が 1920×734 で、ほかのどの動画とも縦横比が違う。
1 フレームに平均何人?
「どれくらい混んでいるか」について、論文とその後の引用はいくつもの数字を挙げている。論文の本文は密度が 1 フレームあたり 246 人に達しうると言い、ByteTrack の論文はテストセットに平均で画像一枚あたり 170 人いると書いている。上の表のテストセットの平均は 1 フレームあたり 115.5 人だ。
これらの数字の違いは、何を数えたかにある。MOT20 は歩行者だけでなく、次のようなクラスにもアノテーションをつけている。
| クラス | 数 |
|---|---|
| 歩行者 | 1,652,040 |
| 静止している人 | 335,891 |
| 地面上の遮蔽物 | 87,786 |
| 非動力車両 | 22,365 |
| 群衆 | 4,303 |
| 合計 | 2,102,385 |
原論文 Table 2 をもとに整理。
テストセットのすべてのクラスのアノテーションを合計すると 765,465 件で、4,479 フレームで割ると 1 フレームあたり約 170.9 件になる。これがよく引用される 170 だ。実際に評価に使われるのは歩行者だけで、1 フレームあたり 115.5 人だ。
246 については、本文が一か所でこれを平均密度と呼んでいるものの、計算方法は説明していない。表で各動画の平均が最も高いのは MOT20-05 の 195 人なので、246 はおそらく単一フレームでの最大値だろう。どの数字をとるにしても、MOT20 は MOT17 よりはるかに混雑している。
アノテーションのルール
アノテーションは MOT16 のルールを引き継ぎ、画面の中のものを三つのグループに分ける。
- 移動中の歩行者。 歩行者だと見てとれる、移動しているすべての人。ちょっとかがんで物を拾ったり、しゃがんで子どもと話したりしていても、やはりこのグループに入る。トラッカーが追うべきなのはこのグループだ。
- 分類があいまいな人の形。 座っている人、横たわっている人、動画のあいだずっとその場に立って動かない人、そして人を人工的に表したもの(ポスターに写った人など)。評価では、これらを追跡しても加点されず、追跡しなくても減点されない。
- 車両と遮蔽物。 評価には使われず、利用者の訓練用に提供されるか、歩行者が遮蔽されている度合いの計算に使われる。止まっている車や自転車は、歩行者を遮っているときにだけアノテーションされる。
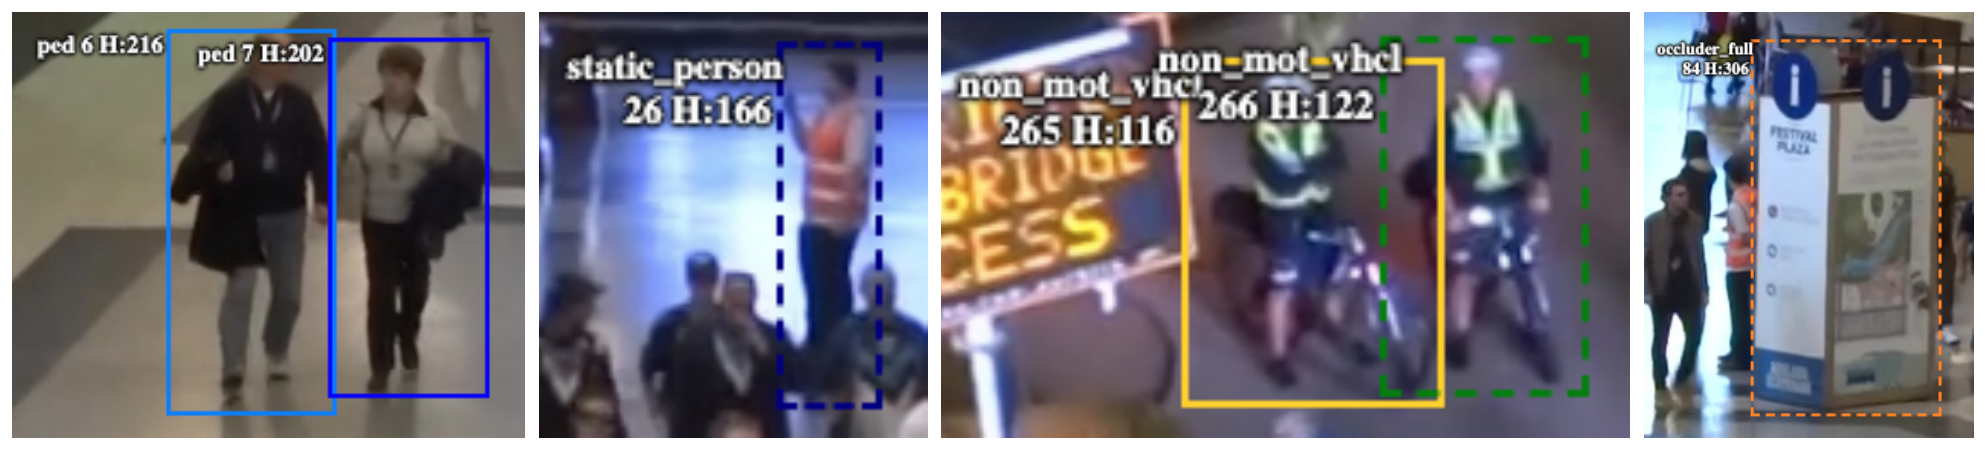
「罰しも報いもしない」このグループは、MOT20 では特に重要だ。静止している人は全部で 33.6 万件あり、歩行者ボックスの五分の一にあたる。テスト動画 MOT20-08 では、静止している人が 52,998 件、歩行者が 77,484 件ある。つまり画面の中のおよそ 10 人に 4 人は評価の対象外だ。
検出器はもちろん、人が歩いているかどうかなど気にしない。検出に頼るトラッカーは、こうした立ち止まっている人もしっかり追跡してしまうかもしれない。それを誤検出と数えたら、トラッカーにとっては濡れ衣だ。逆に、運動の手がかりに頼るトラッカーが座っている人を追わなかったからといって、検出漏れで罰せられるべきでもない。
また、追跡対象の定義もとても具体的だ。視線に沿ってそのまま歩いて行ける、間に物理的な仕切りのない、直立した歩行者である。映り込み、ガラスの向こうの人、自転車に乗っている人や車に乗っている人は、どれも含まれない。
公開検出
MOT17 と同じく、MOT20 も公開検出の一式を提供し、誰もが同じ入力で追跡アルゴリズムを比べられるようにしている。今回使われたのは ResNet-101 をバックボーンとする Faster R-CNN で、MOT20 の訓練用動画で訓練されている。MOT20 のチャレンジは当初、公開検出を使った結果しか受け付けなかった。その後、常時投稿を受け付けるようになってから、独自検出の結果も受け付けるようになった。
この検出器のテスト動画での性能を見ると、著者らがなぜ未知の場面を残したのかがよくわかる。
| 動画 | 場面 | AP | 再現率 | 適合率 | 誤検出/フレーム |
|---|---|---|---|---|---|
| 04 | 夜の広場(既知) | 0.63 | 69.7 | 98.0 | 1.55 |
| 07 | 屋内(既知) | 0.78 | 83.6 | 92.5 | 1.89 |
| 06 | 昼の通り(未知) | 0.43 | 57.9 | 74.4 | 12.64 |
| 08 | 昼の通り(未知) | 0.38 | 55.2 | 61.6 | 13.93 |
原論文 Table 6 をもとに整理。テスト用の動画。
既知の場面では、適合率はどれも九割を超え、1 フレームあたりの誤検出は 2 個に満たない。未知の昼の通りに移ると、適合率は六、七割に落ち、1 フレームあたりの誤検出は 12 から 14 個に急増し、AP も 0.4 前後しか残らない。
この公開検出は、汎化の失敗をそのままトラッカーに引き渡しているようなものだ。公開検出を使うトラッカーは、MOT20-06 と 08 では最初から大量の偽のボックスを処理しなければならない。
検出の統計からは、ボックスがどれだけ小さいかもわかる。四本のテスト動画では、最も低い検出ボックスの高さはわずか 21 から 37 ピクセルで、訓練用の動画 MOT20-03 には高さ 16 ピクセルしかないボックスまである。
ファイル形式と評価
MOT20 のファイルは単純な CSV で、1 行に 1 つの物体が書かれ、9 つのフィールドは順にフレーム番号、ID、ボックスの左上隅の x と y、幅、高さ、信頼度スコア、クラス、可視度だ。検出ファイルの ID には −1 を入れる。正解ファイルでは信頼度スコアの欄をフラグとして使い、0 ならその行は評価に含めない。座標は 1 から数える。
評価も MOT16 を引き継いでいる。IoU が 0.5 以上でなければ対応とはみなさず、指標は CLEAR MOT と、Wu と Nevatia による軌跡の品質指標(MT、ML、FM)だ。著者らはわざわざ、ここでの ID スイッチの定義は元の CLEAR MOT より厳しいと断っている。ある真のターゲットが今回対応した軌跡が前回の対応と違えば、それだけで一回と数える。すべてのテスト動画はつなげて計算し、動画ごとの平均はとらない。
混雑した場面に合わせて、MOT20 には MOT17 にないルールがもう一つ加わった。結果のボックスが、静止している人、映り込み、乗り物に乗っている人、紛らわしい物体といったクラスと 75% を超えて重なれば、結果から取り除く。論文はこのルールを検出チャレンジの評価手順の中に書いている。
MOTA は相変わらず主要な指標で、著者らはここでもお決まりの一言を添えている。この数字を単独で唯一の性能指標とすることは「大いに議論の余地がある」と。手法が特定の数本の動画にだけ合うように調整されていないかを見るため、リーダーボードには動画ごとの MOTA の標準偏差も載せる。
論文自体にはトラッカーの結果が一つもなく、あるのは上の検出器の性能だけだ。トラッカーが MOT20 でどう振る舞うかは、のちの論文とリーダーボードを見るしかない。
議論
本サイトのノートで MOT20 が出てきた箇所をつなげてみると、この動画群が試しているものはおおよそ四つある。
混雑は、外観特徴を必要とする手法を遅くする。 FairMOT は MOT20 では 13.2 FPS しか出ず、StrongSORT はわずか 1.5 FPS だ。1 フレームに百人以上いて、一人ひとりについて外観特徴を一回抽出し、すべての軌跡と一回ずつ比べなければならない。
混雑は、運動モデルの誤差の蓄積を目立たせる。 OC-SORT が MOT20 で ByteTrack につけた差は、MOT17 でつけた差より大きい。遮蔽が多く、いったん遮られると何フレームも続くので、カルマンフィルタは観測による補正ができず、誤差がどんどん積み重なる。
固定カメラ。 MOT20 の動画はどれも固定カメラで撮られているので、カメラ運動補償はここでは役に立たない。Deep OC-SORT のアブレーションでも、カメラ運動補償を加えると MOT17 でははっきり向上したが、MOT20 ではそうならなかった。
混雑と見分けにくさは別の話だ。 DanceTrack の著者らがわざわざ指摘しているように、MOT20 は人こそ多いものの、歩行者の動きはとても規則的で、互いの相対位置や遮蔽される領域はほとんど変わらない。こういう混雑は、外観による照合の妨げにはならない。そこで DanceTrack は別の方向から問題を出した。人は少ないが、見た目がそっくりで、動きもでたらめだ。
結論
MOT20 は MOTChallenge の既存のルールはそのままに、極端に混雑した 8 本の動画を据えた。1 フレームに平均百人以上の歩行者がいて、最も小さいボックスはわずか十数ピクセル、さらにテストにだけ現れる昼の通りを一つ残してある。論文自体は短く、手法も追跡結果もないが、「混雑」を、その後のあらゆる追跡論文が報告しなければならない一列に変えた。
その数字を読むときは、二つのことを覚えておくといい。テストのスコアの大半は MOT20-04 という夜の広場の一本で決まること。よく耳にする「1 フレームに 170 人」には評価に使われないクラスが含まれていて、実際に評価される歩行者は 1 フレームあたり 115.5 人であること。