原始論文
MOT20: A benchmark for multi object tracking in crowded scenes
- 發表版本
- 正式發表資訊尚未核實
- arXiv 首次提交
- arXiv:2003.09003
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{multiobjecttrackingmot202020,
  title = {{MOT20: A benchmark for multi object tracking in crowded scenes}},
  author = {Patrick Dendorfer and Hamid Rezatofighi and Anton Milan and Javen Shi and Daniel Cremers and Ian Reid and Stefan Roth and Konrad Schindler and Laura Leal-Taixé},
  year = {2020},
  eprint = {2003.09003},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2003.09003}
}
讀過 ByteTrack、OC-SORT、StrongSORT 的主表,你一定看過 MOT20 這一欄。它通常緊跟在 MOT17 後面,數字普遍比較低,速度也慢得多。
MOT20 的論文本身只有 7 頁,大半篇幅在說明標註規則和評估方式,和四年前的 MOT16 幾乎一樣。真正新的東西,是 8 段極度擁擠的影片。
作者群是 MOTChallenge 的維護團隊,來自慕尼黑工業大學、阿德雷德大學、蘇黎世聯邦理工學院和達姆施塔特工業大學。根據論文的統計,MOTChallenge 從 2014 年上線以來,已有超過 1,000 名使用者,5 個挑戰共用了 44 段影片、270 萬個框。MOT20 的影片在 2019 年先用來辦了一場研討會挑戰賽,這篇論文是之後補上的完整說明。
定義問題
MOT15 到 MOT17 讓多目標追蹤有了乾淨的資料和一致的評估。但作者的經驗是,大多數方法都可能被過度調整到某一個資料集上,換一個完全不同的情境,不大改參數、甚至不換模型,就應付不來。
擁擠是其中一個還沒被好好測試的情境。人一多,框變小、互相遮擋,偵測器開始漏人,追蹤器要在一大群長得差不多的框裡分辨誰是誰。作者想要一組能把方法「推到極限」的影片。
解決問題
8 段影片,3 個場景
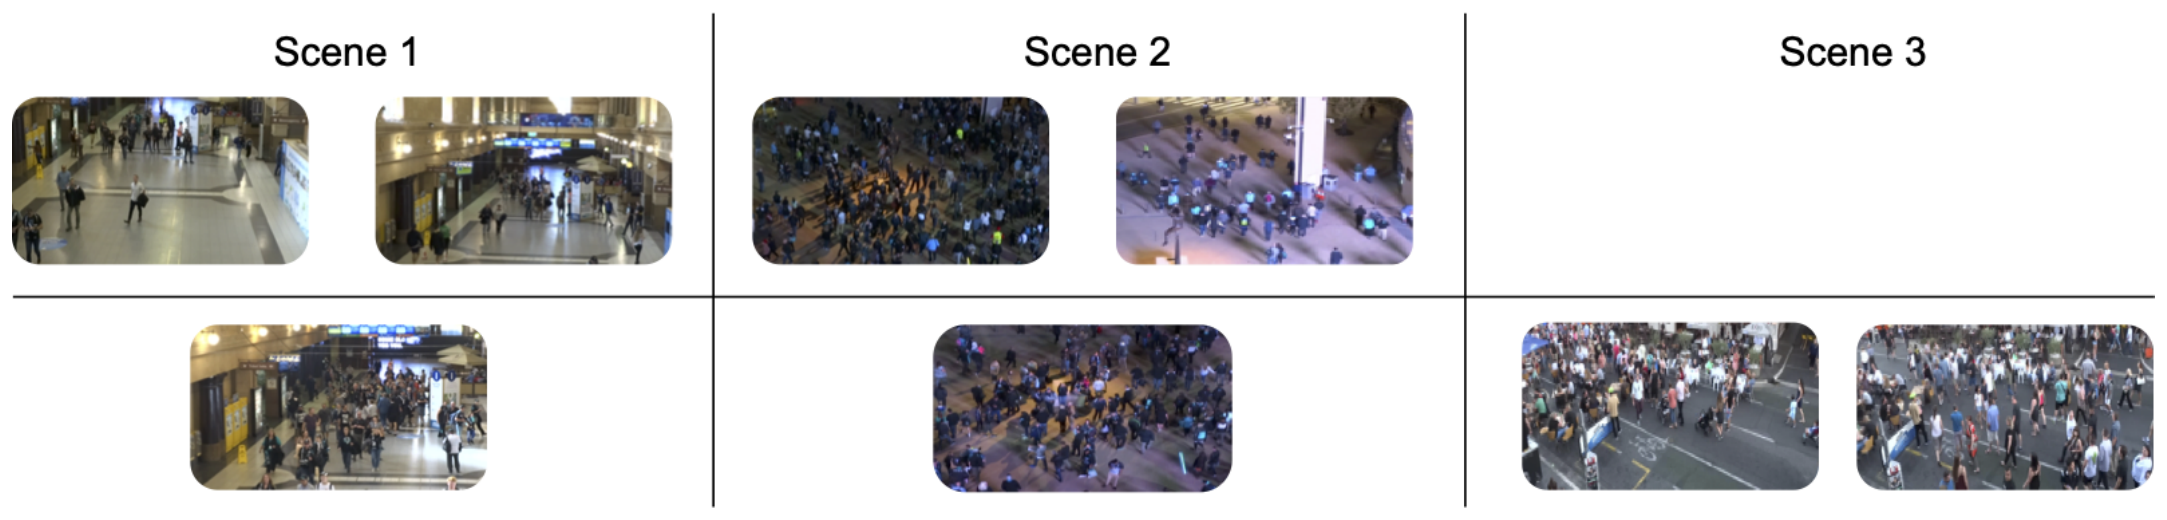
8 段影片拍自 3 個場景,訓練和測試各 4 段,全部從高處俯拍。場景 1 和場景 2 在訓練和測試都有,場景 3 只出現在測試。作者刻意留一個沒看過的場景,用來測試方法能不能類推到新環境。測試的標註不公開,避免方法被調到過度貼合特定影片。
各段影片的統計如下:
| 影片 | 場景 | 解析度 | 長度(幀) | 軌跡 | 行人框 | 每幀人數 |
|---|---|---|---|---|---|---|
| 01 | 室內 | 1920×1080 | 429 | 74 | 19,870 | 46.3 |
| 02 | 室內 | 1920×1080 | 2,782 | 270 | 154,742 | 55.6 |
| 03 | 戶外、夜 | 1173×880 | 2,405 | 702 | 313,658 | 130.4 |
| 05 | 戶外、夜 | 1654×1080 | 3,315 | 1,169 | 646,344 | 195.0 |
| 04 | 戶外、夜 | 1545×1080 | 2,080 | 669 | 274,084 | 131.8 |
| 06 | 戶外、日 | 1920×734 | 1,008 | 271 | 132,757 | 131.7 |
| 07 | 室內 | 1920×1080 | 585 | 111 | 33,101 | 56.6 |
| 08 | 戶外、日 | 1920×734 | 806 | 191 | 77,484 | 96.1 |
整理自原論文 Table 1;粗體是測試影片。全部影片都是每秒 25 幀。
這張表有幾個地方值得多看一眼。
第一,影片很短。訓練影片加起來不到 6 分鐘,測試不到 3 分鐘,但訓練集有 113 萬個行人框,測試集也有 52 萬個。
第二,資料集被少數幾段影片主導。光是 MOT20-05 就有 64.6 萬個框,占整個訓練集的 57%;測試集裡的 MOT20-04 占了 53%。MOTChallenge 是把所有測試影片串在一起算一個 MOTA,所以 MOT20-04 這一段夜間廣場的表現,大致就決定了測試分數。MOT16 筆記裡提過 MOT16-03 也有同樣的情況。
第三,沒看過的場景 3(MOT20-06、08),解析度是 1920×734,和其他影片的比例都不同。
平均每幀幾個人?
論文和後來的引用,對「多擠」給過好幾個數字。論文正文說密度可以達到每幀 246 人;ByteTrack 的論文寫測試集平均每張影像 170 人;上表的測試集平均則是每幀 115.5 人。
這些數字的差別,在於算了哪些東西。MOT20 不只標行人,還標了下面這些類別:
| 類別 | 數量 |
|---|---|
| 行人 | 1,652,040 |
| 靜止的人 | 335,891 |
| 地上的遮擋物 | 87,786 |
| 非機動車輛 | 22,365 |
| 人群 | 4,303 |
| 合計 | 2,102,385 |
整理自原論文 Table 2。
把測試集所有類別的標註加起來,共 765,465 筆,除以 4,479 幀,大約是每幀 170.9 筆,這就是常被引用的 170。真正會被拿來評估的只有行人,每幀 115.5 人。
至於 246,正文有一處稱它是平均密度,但沒有說明怎麼算;表上各段影片的平均最高是 MOT20-05 的 195 人,所以 246 比較可能是單一幀的最大值。不管用哪個數字,MOT20 都遠比 MOT17 擁擠。
標註規則
標註沿用 MOT16 的規則,把畫面裡的東西分成三組:
- 移動中的行人。 所有看得出是行人、正在移動的人。短暫彎腰撿東西、蹲下跟小孩說話,仍然算在這一類。追蹤器要追的就是這一組。
- 分類模稜兩可的人形。 坐著、躺著、整段影片站在原地不動的人,以及人的人工表示(像海報上的人)。評估時,追到這些人不加分,沒追到也不扣分。
- 車輛和遮擋物。 不參與評估,提供給使用者訓練,或用來計算行人被遮擋的程度。停著的車和腳踏車,只有在擋住行人時才會標。
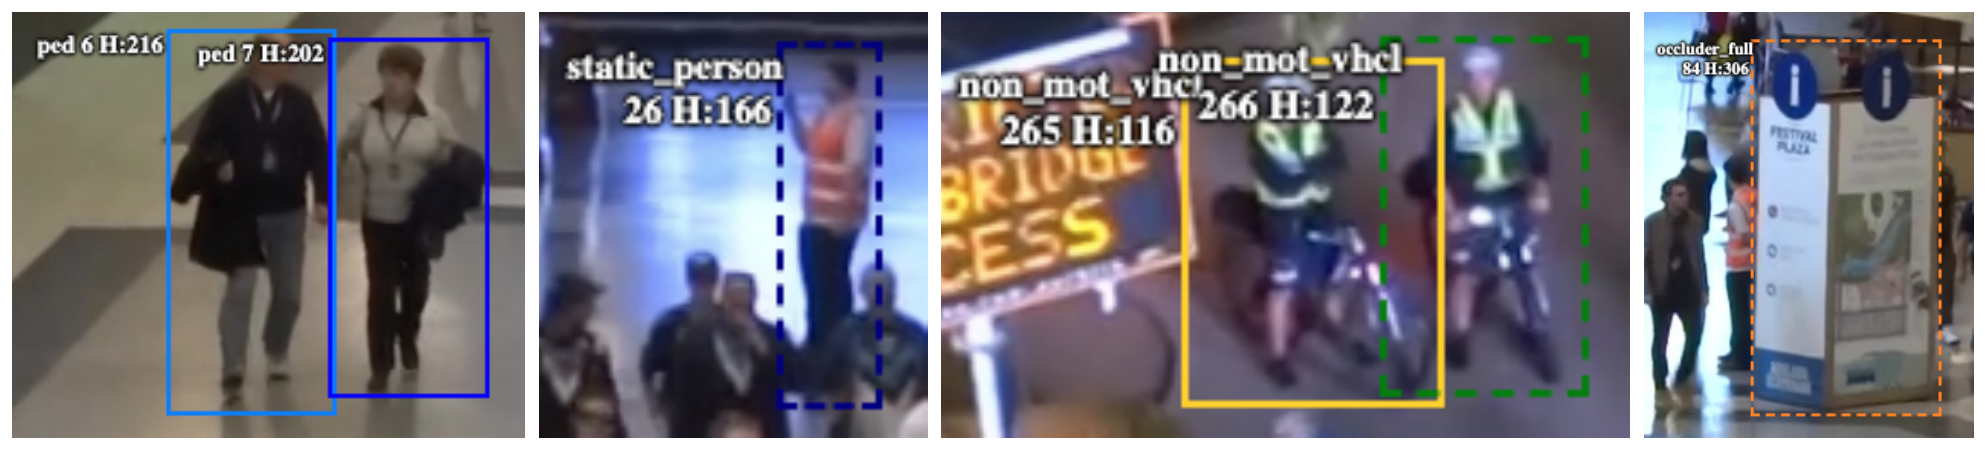
「不罰也不獎」這一組在 MOT20 特別重要。靜止的人一共有 33.6 萬筆,是行人框的五分之一。在測試影片 MOT20-08 裡,靜止的人有 52,998 筆,行人是 77,484 筆;換句話說,畫面裡大約每 10 個人就有 4 個不在評估範圍內。
偵測器當然不會管一個人有沒有在走路。一個依賴偵測的追蹤器,很可能會把這些站著不動的人也追得好好的;要是這些人算誤報,追蹤器就會被冤枉。反過來,一個靠運動線索的追蹤器沒追坐著的人,也不該被罰漏檢。
另外,追蹤目標的定義也很具體:沿著視線可以直接走到、中間沒有實體阻隔的直立行人。倒影、玻璃後面的人、騎腳踏車或坐在車上的人,都不算。
公開偵測
和 MOT17 一樣,MOT20 提供一組公開偵測,讓大家在同樣的輸入上比較追蹤演算法。這次用的是以 ResNet-101 為骨幹的 Faster R-CNN,在 MOT20 的訓練影片上訓練。MOT20 挑戰一開始只接受用公開偵測的結果;之後開放常態投稿時,才同時接受自己的偵測器。
這個偵測器在測試影片上的表現,正好說明了作者為什麼要留一個沒看過的場景:
| 影片 | 場景 | AP | 召回率 | 精確率 | 每幀誤報 |
|---|---|---|---|---|---|
| 04 | 夜間廣場(看過) | 0.63 | 69.7 | 98.0 | 1.55 |
| 07 | 室內(看過) | 0.78 | 83.6 | 92.5 | 1.89 |
| 06 | 白天街道(沒看過) | 0.43 | 57.9 | 74.4 | 12.64 |
| 08 | 白天街道(沒看過) | 0.38 | 55.2 | 61.6 | 13.93 |
整理自原論文 Table 6,測試影片。
在看過的場景,精確率都在九成以上,每幀誤報不到 2 個。換到沒看過的白天街道,精確率掉到六、七成,每幀誤報暴增到 12 到 14 個,AP 也剩 0.4 左右。
這組公開偵測,等於把類推失敗直接交給了追蹤器。用公開偵測的追蹤器,在 MOT20-06 和 08 上一開始就得處理大量的假框。
偵測統計也顯示框有多小。四段測試影片裡,偵測框最矮的只有 21 到 37 像素;訓練影片 MOT20-03 更有矮到 16 像素的框。
檔案格式和評估
MOT20 的檔案是簡單的 CSV,每一行一個物體,9 個欄位依序為幀號、ID、框的左上角 x 和 y、寬、高、信心分數、類別、可見度。偵測檔的 ID 填 −1;真值檔的信心分數欄改當旗標用,0 表示這一筆不列入評估。座標從 1 開始算。
評估也沿用 MOT16:IoU 至少 0.5 才算配上,指標是 CLEAR MOT 和 Wu 與 Nevatia 的軌跡品質指標(MT、ML、FM)。作者特別說明,這裡的 ID 切換定義比原始的 CLEAR MOT 嚴格:一個真實目標這一次配到的軌跡,只要和它上一次的配對不同,就算一次。所有測試影片串在一起計算,而不是各段平均。
針對擁擠場景,MOT20 還加了一條 MOT17 沒有的規則。結果框和靜止的人、倒影、騎車的人、干擾物這些類別重疊超過 75%,就從結果中拿掉,論文把這一條寫在偵測挑戰的評估步驟裡。
MOTA 仍是主要指標,作者照樣補了一句,這個數字能不能單獨當作唯一的表現指標「非常值得爭論」。為了看出方法有沒有被調到只適合某幾段影片,排行榜也會列出各段影片 MOTA 的標準差。
論文本身沒有任何追蹤器的結果,只有上面的偵測器表現。追蹤器怎麼在 MOT20 上表現,要到之後的論文和排行榜去看。
討論
把站內筆記裡 MOT20 出現過的地方串起來,這組影片考的東西大致有四項。
擁擠拖慢了需要外觀特徵的方法。 FairMOT 在 MOT20 上只剩 13.2 FPS,StrongSORT 只有 1.5 FPS。每一幀上百個人,每個人都要抽一次外觀特徵、和每條軌跡比一次。
擁擠讓運動模型的誤差累積更明顯。 OC-SORT 在 MOT20 上和 ByteTrack 拉開的差距,比在 MOT17 上大。遮擋多、一被擋住就是好幾幀,卡爾曼濾波沒有觀測可以修正,誤差就一路累積。
固定鏡頭。 MOT20 的影片都是固定的攝影機,所以相機運動補償在這裡沒有用處。Deep OC-SORT 的消融就顯示,加上相機運動補償後,MOT17 有明顯提升,MOT20 則沒有。
擁擠和難認是兩回事。 DanceTrack 的作者特別指出,MOT20 雖然人很多,但行人移動很規律,彼此的相對位置和遮擋區域幾乎不變,這樣的擁擠對外觀比對並不構成障礙。DanceTrack 於是改從另一個方向出題,人很少,但長得一樣、動作又亂。
結論
MOT20 在 MOTChallenge 既有的規則上,換上 8 段極度擁擠的影片:每幀平均一百多個行人、最小的框只有十幾個像素,還留了一個只在測試出現的白天街道。論文本身很短,沒有方法,也沒有追蹤結果,但它把「擁擠」變成了之後每一篇追蹤論文都得交代的一欄。
讀它的數字時,有兩件事可以記著:測試分數大半由 MOT20-04 一段夜間廣場決定;常聽到的「每幀 170 人」包含了不參與評估的類別,真正被評估的行人是每幀 115.5 人。