原論文
MeMOTR: Long-Term Memory-Augmented Transformer for Multi-Object Tracking
- 発表先
- ICCV 2023国際会議
- arXiv への初回投稿
- arXiv:2307.15700
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingmemotr2023,
  title = {{MeMOTR: Long-Term Memory-Augmented Transformer for Multi-Object Tracking}},
  author = {Ruopeng Gao and Limin Wang},
  year = {2023},
  eprint = {2307.15700},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2307.15700}
}
MOTR は一本の軌跡を一つのトラッククエリで表す。このクエリは各フレームでデコーダを通って更新され、次のフレームへ渡される。物体が誰なのかは、この一連の受け渡しによって保たれる。
問題は、各フレームのクエリが前のフレームしか見られないことだ。ダンサーが数フレーム遮られたり、くるりと回ったり、同じ服を着た人とすれ違ったりすると、そのフレームの出力は当てにならなくなりかねない。そして次のフレームのクエリは、その当てにならない出力から作られる。
南京大学の Ruopeng Gao と王利民(Limin Wang、SportsMOT の責任著者でもある)は、トラッククエリに過去をもう少し覚えさせたいと考えた。二人は軌跡一本ごとにゆっくり更新される長期記憶を加え、それでトラッククエリを安定させた。これが MeMOTR だ。
問題の定義
著者らは、MOTR のようなクエリで追跡する手法には二つの問題があると指摘する。
隣り合う二フレームしか使っていない。 クエリを融合するにせよ特徴を融合するにせよ、ほとんどの手法が明示的に使っているのは隣り合う二フレームの情報だけだ。トラッククエリは更新され続けるものの、安定した長期的な表現を持たない。同じ人のクエリが数フレームの間に大きく変わりすぎると、関連付けで間違えやすくなる。先行する MeMOT は大きなメモリバンクに過去の特徴を蓄えたが、保存のコストが高い。
検出クエリとトラッククエリが同じ水準にない。 DETR の学習可能な物体クエリは、どちらかといえば学習可能なアンカーボックスのような働きをしていて、それ自体にはあまり意味的な情報がない。トラッククエリは前のフレームの出力から来ているので、自分がどのクラスで、どの位置を表しているかをすでに知っている。この二種類のクエリを最初から一緒に同じデコーダに放り込むと、両者の間に意味的なずれが生じる。
問題を解く
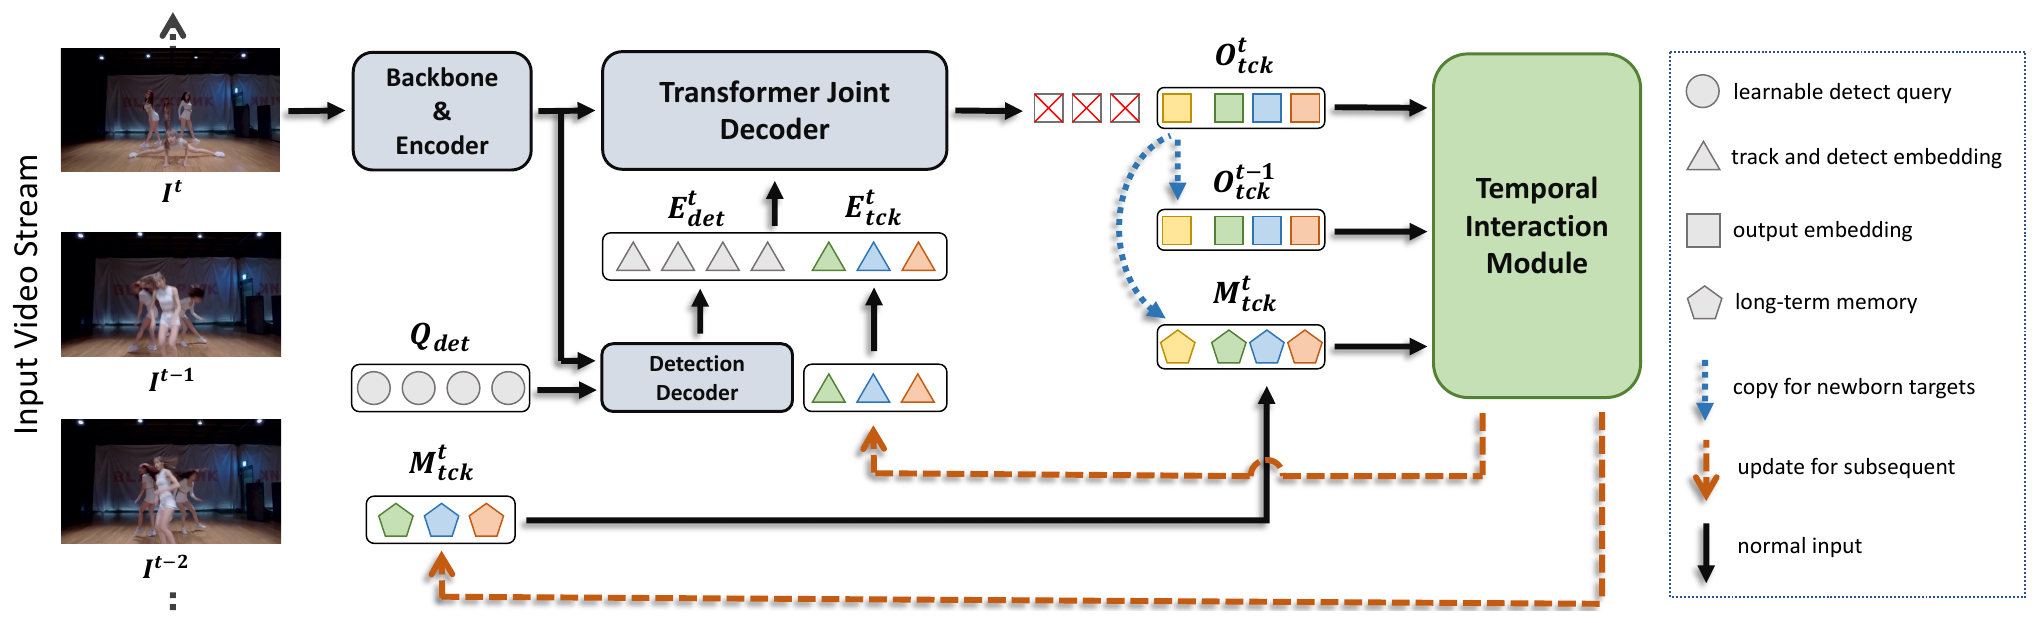
全体の構成は MOTR によく似ていて、ResNet-50 のバックボーンと Transformer エンコーダで画像特徴を抽出し、デコーダが検出と追跡を同時に扱う。違いは三つある。デコーダを二段に分けたこと、軌跡ごとに長期記憶を一つ持たせたこと、そして次のフレームのトラック埋め込みを作る時間相互作用モジュールだ。検出の枠組みには DAB-Deformable-DETR を使っており、MOTR と公平に比べられるよう、標準の Deformable-DETR の版も用意している。
まず検出クエリに見当をつけさせる
元のデコーダは 6 層ある。MeMOTR はその第 1 層を取り出して検出デコーダとし、検出クエリだけを処理させる。検出クエリはこの層を通って物体の位置とクラスにおおよその見当をつけ、意味的な情報を帯びた検出埋め込み になる。
続いて検出埋め込みとトラック埋め込み を連結し、残りの 5 層からなる統合デコーダに送る。このとき二種類のクエリはどちらもすでに「自分が何を探しているか」を知っていて、出発点がそろっている。
長期記憶
新しく現れた軌跡は、そのときの出力で長期記憶 を初期化する。その後は各フレームで次のように更新する。
はこの軌跡の第 フレームでのデコーダ出力だ。これは指数移動平均で、 だ。
0.01 はとても小さな数字だ。著者らの仮定では、物体は連続する数フレームの間にわずかに形を変えて動くだけなので、意味的な特徴はゆっくりとしか変わらないはずで、記憶も穏やかに更新されるべきだ。
この記憶がどれくらい長く覚えているか計算してみよう。あるフレームの出力が記憶に入るときの重みは で、その後は 1 フレームたつごとに 0.99 が掛けられる。 なので、およそ 69 フレーム後には、そのフレームの影響は半分になる。DanceTrack の動画は毎秒 20 フレームなので、3 秒半ほどだ。全体として見れば、この記憶はおおよそ直近 100 フレーム、5 秒間の平均にあたる。
ダンサーがくるりと回ったり、二、三秒遮られたりしても、この記憶がその数フレームのノイズに引きずられることはほとんどない。
時間相互作用モジュール
長期記憶を次のフレームの追跡にどう使うのか? それを担うのが時間相互作用モジュールだ。
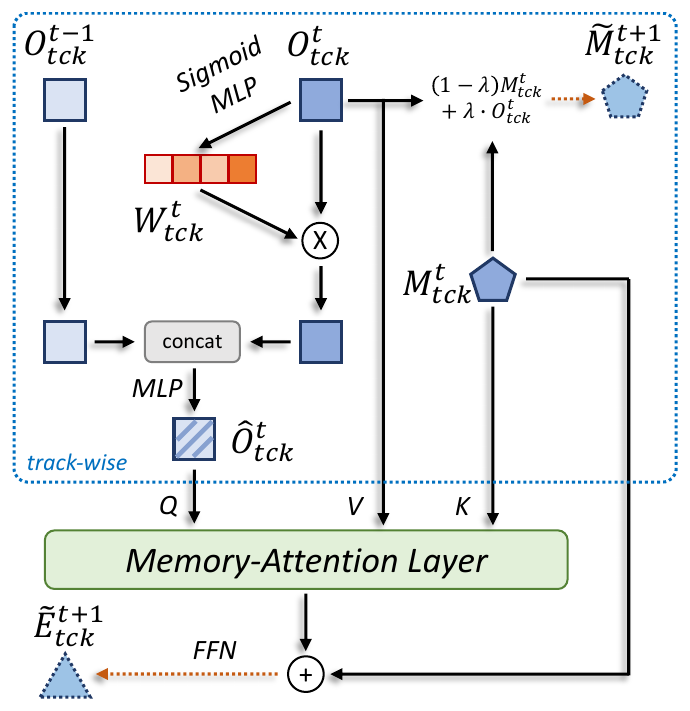
処理は二段階に分かれる。
第一段階では、隣り合う二フレームを融合する。 このフレームの出力は遮蔽やぼやけのせいで当てにならないかもしれないので、まず小さなネットワークでチャネルごとの重みを作る。
この重みをこのフレームの出力に掛け、前のフレームの出力 と連結して二層の MLP に通すと、融合後の が得られる。前のフレームの出力に重みを掛けないのは、それが残っているということは信頼度スコアがすでにしきい値を超えたということで、比較的当てになるからだ。
第二段階では、軌跡どうしを比べ合わせる。 同じフレームに見た目のよく似た人が何人もいるので、著者らは各軌跡の表現がほかの軌跡からもっとはっきり離れるようにしたいと考えた。そこでマルチヘッドアテンションを使い、これをメモリアテンション層と呼んで、すべての軌跡を相互作用させる。クエリ(Q)は融合後の 、キー(K)は長期記憶 、値(V)はこのフレームの出力 だ。
アテンションの出力に長期記憶を加え、フィードフォワードネットワークに通したものが、次のフレームのトラック埋め込み になる。ゆっくりとしか変わらない長期記憶が加わっているので、トラック埋め込みも隣り合う二フレームの間で急に変わりにくい。
いつ更新するか
推論時には三つのしきい値があり、どれも 0.5 に設定されている。
- 検出の信頼度が を超えれば、新しい軌跡になる。
- 追跡中の物体の信頼度が を下回っても、すぐには削除せず、一時的に見失った状態にする。 フレーム続けて見つからなかったときにはじめて削除する。 は DanceTrack では 30 フレーム、MOT17 では 15 フレームだ。
- 信頼度 が を超えたときだけ、時間相互作用モジュールの出力 、 でトラック埋め込みと長期記憶を更新する。そうでなければ古い 、 をそのまま使う。
ある人が遮られて信頼度が下がっている数フレームの間は、その人の記憶をひとまず凍結し、当てにならない出力を書き込ませない。
訓練では、動画のクリップを一度に入力する MOTR のやり方を引き継ぎ、クリップを段階的に長くしていく。DanceTrack では 18 epoch 訓練し、クリップは 2 フレームから始めて、第 6、10、14 epoch でそれぞれ 3、4、5 フレームに延ばす。
議論
DanceTrack
著者らは主に DanceTrack で評価している。関連付けの問題が最も難しいからだ。
| 手法 | HOTA | DetA | AssA | IDF1 |
|---|---|---|---|---|
| ByteTrack | 47.7 | 71.0 | 32.1 | 53.9 |
| MOTR | 54.2 | 73.5 | 40.2 | 51.5 |
| OC-SORT | 55.1 | 80.3 | 38.3 | 54.6 |
| C-BIoU | 60.6 | 81.3 | 45.4 | 61.6 |
| MeMOTR(Deformable-DETR) | 63.4 | 77.0 | 52.3 | 65.5 |
| MeMOTR | 68.5 | 80.5 | 58.4 | 71.2 |
| MOTRv2(追加データ) | 69.9 | 83.0 | 59.0 | 71.7 |
原論文 Table 1 をもとに整理。DanceTrack テストセット。
MeMOTR の HOTA は、それまで追加データを使わない手法で最も良かった C-BIoU より 7.9 ポイント、AssA は 13.0 ポイント高い。MOTR と同じ標準の Deformable-DETR に戻しても HOTA は 63.4 あり、MOTR より 9 ポイント以上高い。
追加データを使い、さらに YOLOX の検出結果も借りた MOTRv2 は、それでもわずかに上だ。ただし MeMOTR の AssA の差は 0.6 しかなく、差は主に検出にある。
MOTR から一歩ずつ MeMOTR へ
著者らは付録で、各段階の変更を一つの表にまとめ、MOTR から順に積み上げている。
| 段階 | 検証セット HOTA | テストセット HOTA |
|---|---|---|
| MOTR | 51.7 | 54.2 |
| +長期記憶と時間相互作用モジュール | 56.5 | 62.5 |
| +検出デコーダ(1 層+5 層) | 61.0 | 63.4 |
| DAB-Deformable-DETR に変更(デコーダは分けない) | 62.1 | 65.9 |
| +検出デコーダ(1 層+5 層) | 63.9 | 68.5 |
| +YOLOX の候補ボックス | 66.8 | 70.0 |
原論文 Table 8 をもとに整理。DanceTrack。一行目の MOTR 以外は、MOTR の二つの訓練上の工夫(トラッククエリのランダムな削除、誤検出クエリの挿入)を外している。
最も大きいのは最初の一歩だ。長期記憶と時間相互作用モジュールを加えただけで、テストセットの HOTA は 54.2 から 62.5 へ 8.3 ポイント跳ね上がる。DAB-Deformable-DETR への切り替えも大いに効いている。著者らの考えでは、アンカーボックスに基づく位置の事前情報が、時間的になめらかに動く軌跡のボックスによく合う。最後の行は MOTRv2 にならって YOLOX の候補ボックスを加え、HOTA は 70.0 に達するが、そうなると完全なエンドツーエンドの手法ではなくなる。
部品ごとのアブレーション
アブレーションはすべて DanceTrack の検証セットで行っている。訓練データが MOT17 の約 10 倍あり、過学習しにくいからだ。
- 検出デコーダは 1 層が最も良い。 分けない場合は 62.1、1 層を切り出すと 63.9 で、AssA は 52.2 から 55.0 に上がる。2 層を切り出すとかえって 63.2 に下がる。統合デコーダが一層減り、トラック埋め込みを補正する回数も減るからだ。
- 隣り合う二フレームの融合は、二つを一緒に使う必要がある。 チャネルごとの重みだけ、あるいは前のフレームの出力だけを加えても、HOTA は 0.1 から 0.4 しか増えない。両方を使ってはじめて 63.9 に達し、どちらも使わない場合より 1.6 高い。著者らの説明では、当てにならないチャネルを抑えるだけで、前のフレームから情報を補わなければ、情報を捨てているにすぎない。
- メモリアテンション層には長期記憶が必要だ。 長期記憶がないと、メモリアテンション層を加えるとかえって悪くなり、AssA は 52.1 から 50.7 に落ちる。長期記憶があれば、アテンション層を加えると AssA は 52.9 から 55.0 に上がる。著者らの考えでは、記憶のないトラック埋め込みはそれ自体が不安定なので、互いに比べ合わせてもノイズを増幅するだけだ。
- が最も良い。 0.005、0.02、0.04 の HOTA はそれぞれ 62.6、63.2、63.5 だ。著者らは、 はデータセットに応じて調整が必要かもしれないとも注意している。たとえば物体の変形が大きい場面では、もう少し速く更新する必要があるかもしれない。
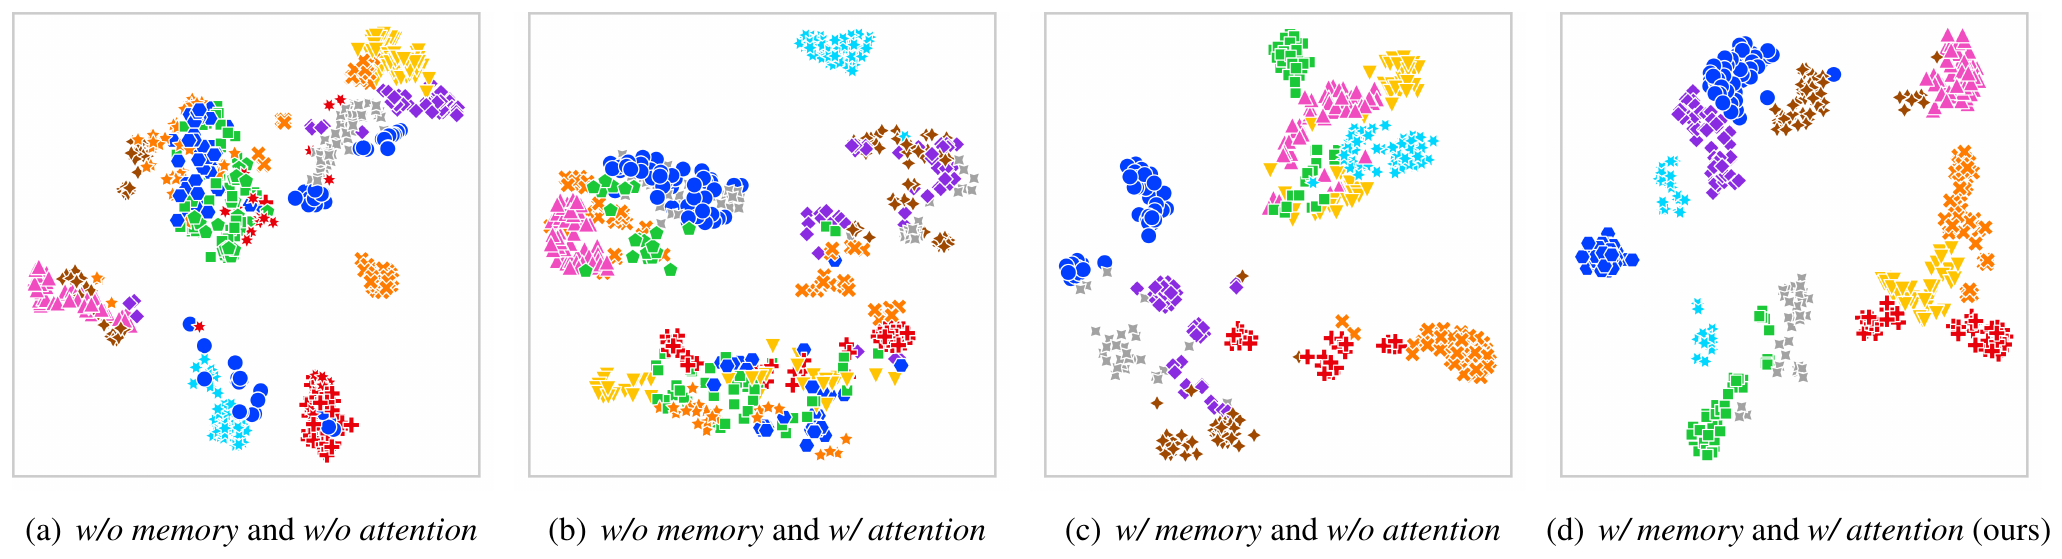
この図は 3 点目を絵にしたものだ。(b) アテンションだけを加えると、異なる軌跡の点は (a) よりもさらに入り乱れる。(d) 記憶とアテンションの両方があると、各軌跡の 50 フレーム分の埋め込みがひとかたまりに集まり、互いに最もよく離れる。
いちばん難しい数本
著者らは、DanceTrack 検証セットで MOTR の AssA が最も低かった 8 本の動画を選び出し、それだけで比較した。この 8 本での MOTR の平均 AssA は 23.6 しかなく、MeMOTR はそれを 35.5 に上げた。
進歩ははっきりしているが、MeMOTR 全体の 58.4 と比べるとまだまだ遠い。著者らも、関連付けの問題は解決にはほど遠いと認めている。
MOT17 とその他のデータセット
MOT17 では、MeMOTR の HOTA は 58.8 で、Transformer 系の手法の中では最も高く、AssA 58.4、IDF1 71.5 はどちらも先行する MeMOT より良い。しかし検出を測る DetA は 59.6 しかなく、YOLOX を使う ByteTrack(64.5)をはるかに下回り、HOTA も ByteTrack の 63.1 に及ばない。
著者らは理由を二つ挙げている。一つは、MOT17 の歩行者は小さくて密集しているので、DETR 系の検出はもともと苦戦するうえに、自己アテンションの中で検出クエリがトラッククエリに押さえ込まれてしまうこと。もう一つは、MOT17 の訓練セットが約 5,000 フレームしかないことだ。CrowdHuman から作った疑似動画を加えても、モデルの HOTA は訓練セットで約 90 なのにテストセットでは 58.8 しかなく、過学習がとてもひどい。
複数クラスの BDD100K 検証セットでは、TETA 指標で測ると MeMOTR は 53.6 で、TETer の 50.8、MOTR の 50.7 を上回る。
v3 版では、SportsMOT の結果も追加されている。SportsMOT の訓練セットだけを使って、MeMOTR の HOTA は 70.0、AssA は 59.1 で、同じく訓練セットだけを使い公式コードで再実行した OC-SORT(68.1)を上回る。著者らがあえて追加データを使わなかった理由は、SportsMOT の訓練セットにはすでに 2 万 5 千フレーム以上あること、そして静止画を平行移動させて作った偽の動画は現実の追跡の状況からかけ離れていて、データから直接学ぶエンドツーエンドの手法にはよくないことだ。
結論
MeMOTR は軌跡一本ごとにゆっくり更新される長期記憶を加え、時間相互作用モジュールでそれを次のフレームのトラック埋め込みに注ぎ込み、さらに検出デコーダを一層切り出して、検出クエリとトラッククエリを同じ出発点に立たせた。付録の積み上げの表によれば、最も大きな一歩は長期記憶そのもので、これだけで MOTR は DanceTrack のテストセットで一気に 8 ポイント以上伸びた。
弱点も MOTR からそのまま受け継いでいる。検出は相変わらず苦手で、混雑した MOT17 では YOLOX を使う手法に負け、小さなデータセットでは過学習しやすい。著者らは、今後は合成データを試してみるとよいと提案している。
このチームの次の一手は、2024 年の MOTIP で、ID の関連付けを分類問題として書き直すことだった。
1 フレームに 1% しか変わらない記憶は、いかにも鈍く聞こえる。だが同じ服を着たダンサーの群れの中で誰が誰かを見分けるのに頼りになるのは、まさにこの鈍さなのだ。